

AI引用シェア率をBingが公開、llms.txtの効果に疑問符
AI検索の可視性をどう測るか、そして構造化データファイルにどこまで期待すべきか。この一週間でその答えに直結する動きが複数出てきた。
MicrosoftがAI引用のシェア率を計測する新機能を公開し、GoogleとAhrefsのデータはllms.txtの効果に冷や水を浴びせた。さらにAIエージェント向けの新仕様が2つ登場するなど、情報が一気に動いている。英国CMAによる公正ランキング命令も含め、今週のトップ4ニュースを実務視点で整理する。
BingがAI引用シェア率を公開。競合との差が初めて数値化された
MicrosoftはBing Webmaster ToolsのAIパフォーマンスダッシュボードに、新たな4機能をプレビュー公開した。追加されたのは「Citation Share(引用シェア率)」「Intents(検索意図別グループ)」「Topics(トピック別グループ)」「Compare(期間比較)」だ。いずれも現在はプレビュー段階でグローバルに順次ロールアウトされている。
このCitation Shareによって、AI検索結果における自サイトの存在感が、競合との比較で初めて把握できるようになる。ただしこのデータはBing独自であり、CopilotやBingの回答を対象とする。Google検索側では検索コンソールにこれに相当する引用カウント機能は提供されていない。
SEO担当者の受け止めと実務への示唆
ILoveSEO.netの創業者Gianluca Fiorelli氏はLinkedInで「Bing Webmaster Toolsこそ、我々がGoogleサーチコンソールに望んでいた姿だ」と評価した。AI可視性を測る新しい物差しが登場したことは、今後の施策優先度をデータドリブンに決める上で大きい。
現時点ではBingに限られた指標だが、AI検索のトラフィックが今後さらに一般化すれば、Googleも類似の指標を導入せざるを得なくなる可能性がある。先行してBing側でのデータ取得と分析のノウハウを積んでおくことは、将来のAI検索対策で優位に立つ一手になる。
llms.txtへの期待に新データが疑問符。97%がアクセスゼロ
llms.txtは、大規模言語モデル(LLM)向けにサイト情報を構造化して提供するテキストファイルだ。AIがサイト内容を理解しやすくする目的で提唱され、導入が進んでいる。しかし今週、その効果に疑念を投げかける材料が二つ重なった。
Mueller氏は「Search Off the Record」ポッドキャストで、llms.txtが自己申告型のファイルである以上、LLMがサイトを発見したり他サイトと比較して評価したりする用途には使えないと明言した。本質的に重要なのは従来のHTMLと内部リンク構造だという立場だ。
Ahrefsのデータも同じ方向を指している。13万7000ドメインのうち、97%のllms.txtファイルには一度もボットからのアクセスがなかった。さらにアクセスが確認されたケースでも、ChatGPTやPerplexityといった引用生成ボットからのリクエストは全体の1%に過ぎない。この結果は、数ヶ月前にSE Rankingが30万ドメインを調査して導いた「llms.txtはAI引用に明確な効果を示さない」という結論とも整合する。
SEO専門家の見解と実務上の落とし所
Clio Websitesの創業者Nat Miletic氏はLinkedInで「llms.txtは公開コストが低いので置いておくのは構わない。ただしそれでAI可視性が上がるとは今は期待しないほうがいい」と総括した。コーディングエージェントや学習用クローラー向けに一部で参照されているため維持コストに見合う面はあるが、AI検索結果への表示を目的とした投資としては優先度を下げる判断が妥当だ。
AIエージェント向け新仕様が2つ登場。OKFとARDの注目点
Google Cloudは「OKF(Open Knowledge Format)」を公開した。組織内の知識(データセット、メトリクス、運用手順書など)をAIエージェントが読めるマークダウン形式でパッケージングする仕様だ。ほぼ同時期に、GoogleやMicrosoft、GitHub、Hugging Faceを含む連合が「ARD(Agentic Resource Discovery)」の草案を発表した。こちらはAIエージェントがツールやスキル、他のエージェントを発見・検証するためのプロトコルを定義する。
両仕様とも現時点で即時の対応を求めるものではない。OKFはバージョン0.1、ARDは0.9と初期段階だ。Harton Worksの創業者Martin Jeffrey氏はARDを「ページではなく機能のためのサイトマップが再来したようなものだ」と表現した。Snippet Digitalの共同創業者Suganthan Mohanadasan氏は「魔法のキノコではない。これで一夜にしてAI可視性が上がるわけではない」と期待値を引き締めている。
実務的には、どのフォーマットが実際に普及するかを見極める観察期間に入る。llms.txtの事例が示すように、仕様の存在と実際の効果は別問題だ。導入判断は普及の兆候を確認してからでも遅くない。
英国CMAがGoogleに公正ランキングを命令。事前通知義務が実務に波及
英国の競争市場庁(CMA)がGoogle検索に対し、新たなルールを設定した。オーガニック検索結果のランキングに客観的かつ非差別的な基準を使うこと、そして大規模な変更の際には事前通知を行うことを義務づける内容だ。
このルールの適用範囲は英国のオーガニック検索結果で、AI Overviewsも対象に含まれる(広告は除く)。Googleは「現行のランキングはすでに公正かつ透明だ」と反論しているが、CMAは6月初旬にもAI検索機能からのオプトアウトを認めるよう命令しており、規制圧力は強まっている。
SEO専門家の反応から読む今後の展開
Searchpediaの創業者Laura Iancu氏はLinkedInで「もうこれで『コアアップデートを突然リリースしました』なんてことはできなくなる」と単刀直入に表現した。Blue Arrayの戦略SEO責任者Chloe Smith氏は「Googleは何らかの回避策を探るだろう」と予測しつつも、事前通知と異議申し立ての枠組みができたこと自体に意味があると見ている。
現状では英国限定の措置だが、EUや他の地域にも波及する可能性は否定できない。特に、大規模アップデートの事前通知が実務化すれば、SEO施策の計画立案や緊急対応のあり方そのものが変わる。今後のGoogleの実装方法を注視する必要がある。
構造化ファイルを置くだけでは済まない。AI可視性の本質に立ち返る
今週のニュースを横断して浮かび上がるテーマは、「構造化ファイルを自ドメインに置いておけばAIに見つけてもらえる」という発想への再考だ。llms.txtはその教訓をすでに示している。ファイルを公開しても、Googleはサイト差別化に寄与しないと断言し、データは大半のファイルが読まれていない事実を突きつけた。
OKFやARDが登場したことで、構造化ファイルへの要求はこれからも繰り返されるだろう。しかし破綻しているのは「ファイルを置けば報われる」という期待のほうだ。BingのCitation Shareは、そうした取り組みが実際に引用に結びついているかを数値で示してくれる、貴重なフィードバックループになり得る。
AI検索時代の可視性は、小手先のファイル配置ではなく、コンテンツそのものの強さと、信頼される情報源としてサイト全体を設計し続ける積み重ねで決まる。今週のデータと専門家の声は、その原則を改めて強調する結果になった。
この記事のポイント
- Bing Webmaster Toolsの新機能「AI Citation Share」で、AI検索での競合とのシェア比較が初めて可能になった。Googleにはまだ同等機能はない
- llms.txtは97%がアクセスゼロ。AI検索可視性への効果はデータで否定され、自己申告ファイルの限界が明確になった
- OKFとARDという新たなAIエージェント向け仕様が登場したが、普及は未知数。llms.txtの教訓を踏まえ導入判断は慎重に行うべきだ
- 英国CMAがGoogleに対し、検索順位の公正化と大規模変更前の事前通知を義務づけた。SEO施策の計画立案に影響する可能性がある
- 結局、AI可視性の本質は構造化ファイルではなく、通常のHTMLコンテンツの品質と情報設計にある

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Microsoft Web IQでAIエージェントがBing検索を利用可能に。SEOへの影響を考察
Microsoftが2026年6月2日、AIエージェント向けの検索基盤「Web IQ」を発表した。Bingの検索インデックスに蓄積された情報を、AIシステムが推論やタスク実行に直接利用できるようにするAPI群である。
従来のBingが人間にウェブページを提供するのに対し、Web IQはAIに「パッセージ」と呼ばれる情報の断片を返す。この違いがAI時代のコンテンツ最適化とSEO戦略に大きな影響を与える可能性がある。
この記事では、Web IQの技術的な仕組み、従来の検索エンジンとの違い、パフォーマンス、そしてパブリッシャーにとっての意味を詳しく解説する。
Web IQの基本構造 〜AIエージェントが必要とする情報だけを届ける〜
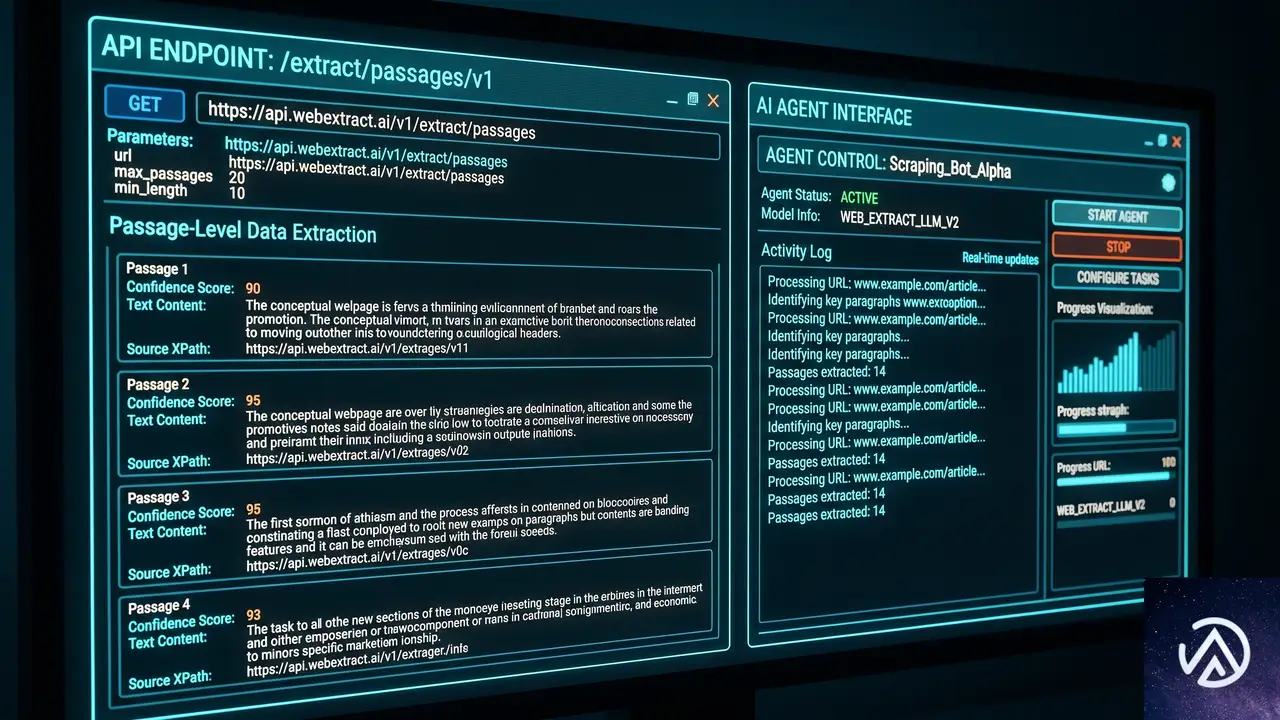
Web IQの中核にあるのは、Bingのインデックスを土台に再構築された検索スタックだ。コンテンツのインデックス化、ランキング、選択の仕組みがAIエージェントの利用を前提に設計し直されている。AIエージェントはタスクの複数ステップにわたって厳しい時間制約の中で繰り返し検索を行うため、その動作特性に合わせた設計が求められた。
パッセージ単位の情報提供
Web IQが返すのは、ウェブページ全体ではない。「パッセージ」と「構造化されたエビデンスオブジェクト」だ。ページ中からAIにとって有用な部分だけを切り出して渡す。
AIモデルが処理するトークン(テキストの最小単位)にはコストがかかり、レイテンシ(応答遅延)にも直結する。Microsoftによれば、「少ないトークンでより良い回答を、1回の呼び出しあたりのコストを抑える」という三拍子を実現するのがWeb IQの設計思想だ。
このアプローチは、SEOの世界で徐々に広がっている「パッセージベースの検索」という概念とも整合する。Googleが2020年に導入したPassage Ranking(パッセージランキング)は、ページ全体ではなくその一部を検索クエリに最も関連する情報として抽出する技術だ。Web IQはこの考え方をAIエージェント向けに特化させたものと見ることができる。
従来の検索エンジンとは何が違うのか 〜ランキングと評価基準の再設計〜
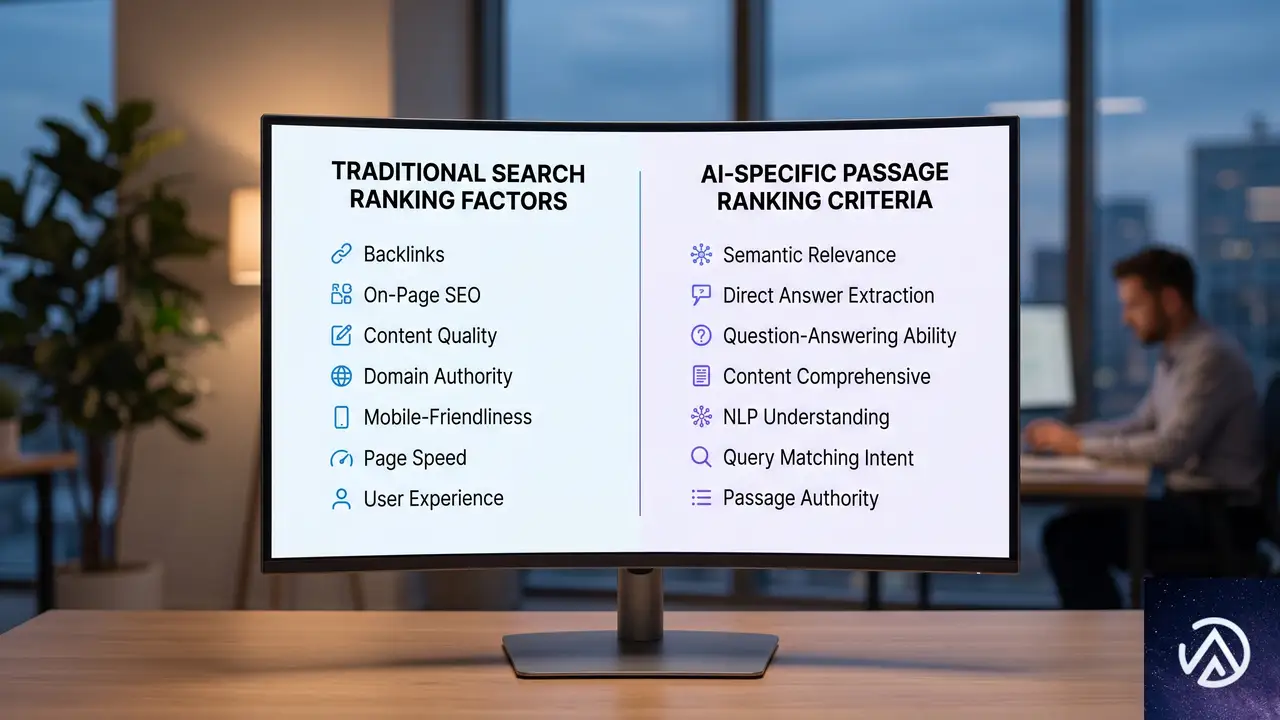
MicrosoftがWeb IQの品質評価に使う指標は「GDSAT(Grounding Satisfaction / グラウンディング満足度)」と呼ばれる。情報の新鮮さと信頼性を測定するために設計された指標で、3,000件のサンプルクエリを用いたテストでは競合他社より高いスコアを記録したと発表している。
応答速度についても具体的な数字が示された。5つのデータセンターにまたがるテストで、P95(リクエストの95%がこの時間内に完了する値)で165ミリ秒未満を達成。競合と比較して約2.5倍高速だとしている。
ここで重要なのは、Web IQが従来の検索エンジンとまったく異なる評価軸で動いている点だ。人間向けの検索では、ページ全体の権威性や被リンクプロファイル、滞在時間など多面的なシグナルが使われる。一方、Web IQでは「AIエージェントがその情報を使ってどれだけ正確にタスクを遂行できるか」という一点が重視される。
全文からパッセージへの転換が意味すること
Search Engine Journalの記事で、Microsoftの発表を引用する形で指摘されているのは「従来の検索で上位表示されるページの特徴と、AIのグラウンディングに有用なパッセージの特徴は必ずしも重ならない」という点だ。同社が2026年前半に公開したグラウンディングフレームワークの記事でも、検索インデックスとグラウンディングの違いが詳述されている。
たとえば、あるページが検索キーワードに対して高い順位を得ていても、そのページ内のどの部分がAIにとって最も価値があるかは別問題だ。見出し構造、段落のまとまり、事実と意見の明確な区別など、AIが情報を抽出しやすい構造になっているかどうかが新たな評価ポイントになる可能性が高い。
検索体験からAI体験へ 〜パブリッシャーが知っておくべき変化〜
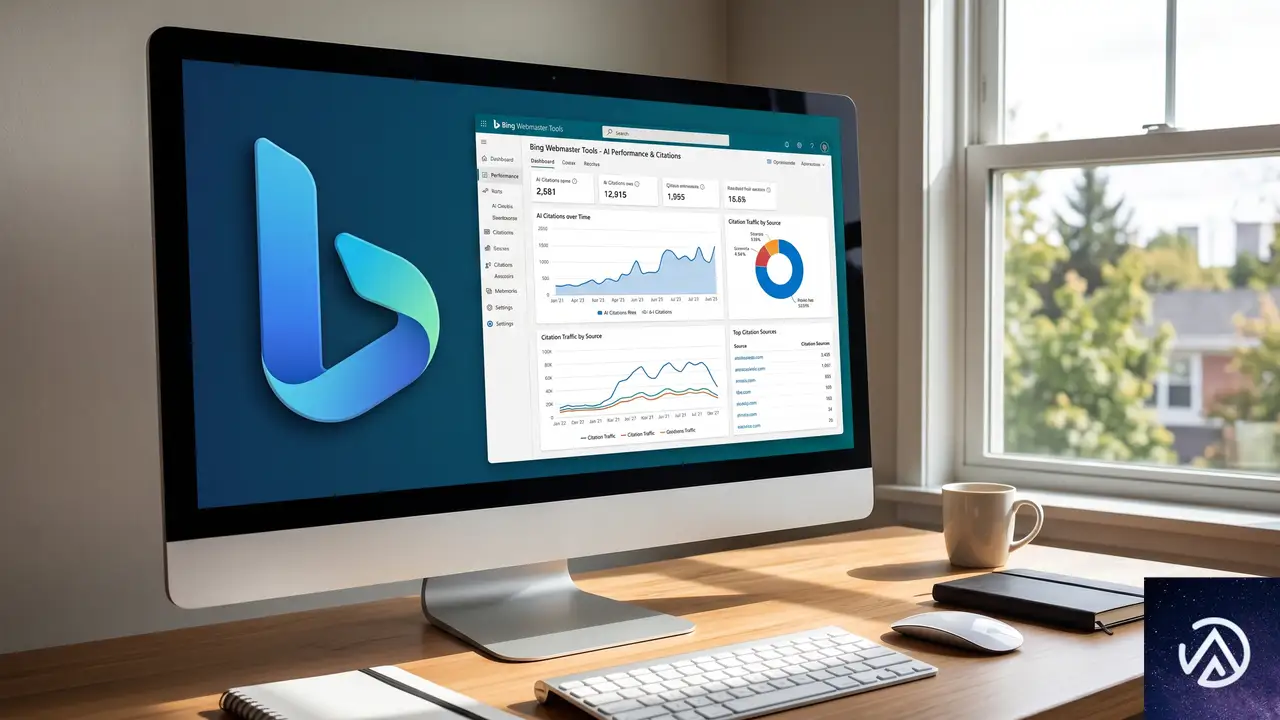
Bing Webmaster Toolsとの連携
Web IQは突然現れたわけではない。Microsoftは2026年に入って、段階的にAI向け検索の基盤整備を進めてきた。
- 2月、Bing Webmaster ToolsにAI引用データ(AI Citation Data)機能を追加
- 3月、グラウンディングクエリと引用ページを関連付けるAIダッシュボードを公開
- SEO Week期間中、Citation Share(AI向け引用シェア)のプレビューを発表
これらはいずれも、パブリッシャーが自分のコンテンツがAIにどのように使われているかを把握するためのツールだ。Web IQは、その裏側でAIがコンテンツを取得する仕組みに当たる。表と裏の関係にある。
つまり、Web IQの登場は「AI検索時代のSEO指標」が具体的な形を取り始めたことを意味する。従来の検索順位チェックに加えて、AIによる引用回数やパッセージ採用率といった新しいKPIが重要になる展開が予想される。
パッセージ最適化という新しい考え方
Web IQがパッセージ単位で情報を返す以上、パブリッシャー側もパッセージ単位でコンテンツを最適化する必要性が出てくる。具体的には以下のような施策が考えられる。
- 見出しと本文の関係を明確にし、各セクションが独立して意味を持つように書く
- 箇条書きや表組みを使って、AIが情報を構造的に読み取りやすくする
- 事実情報と意見・解釈を明確に分け、どちらを参照しているかAIが判断しやすくする
- 更新日を明示し、情報の鮮度をAIが評価できるようにする
これらの手法は、従来のSEOで言われてきた「E-E-A-T(経験・専門性・権威性・信頼性)」の強化とも多くの部分で重なる。違いは、AIが評価する点まで意識するかどうかだ。たとえば、ページの末尾にある免責事項や、サイドバーの関連記事リンクは従来の検索評価には影響しても、AIのパッセージ抽出ではノイズとして無視される可能性が高い。
技術面の詳細 〜オープンソース埋め込みモデルと高速検索〜
Web IQの検索パイプラインは3つの主要コンポーネントで構成される。埋め込みモデル、高速検索エンジン、そしてパッセージ選定モデルだ。
埋め込みモデルとDiskANN
Microsoftは2026年4月に、業界トップクラスの埋め込みモデル(Embedding Model)をオープンソース化した。テキストをベクトル(数値列)に変換し、意味の近さを計算できるようにする技術だ。Web IQはこのモデルを使って関連コンテンツを特定する。
大規模なインデックスを高速に検索するために使われるのが「DiskANN」という技術だ。これは全データをメモリに読み込まずに、ディスク上で効率的に類似検索を行うための仕組みだ。膨大なBingインデックスを対象に、165ミリ秒未満の応答を実現する鍵がここにある。
特筆すべきは、これらのモデルが単体のベンチマークスコアではなく、AI推論の中で実際に使われる状況を想定して訓練されている点だ。実用性を重視した設計と言える。
パブリッシャーコントロールと業界標準化
Web IQは、Bingがすでに準拠しているrobots.txtやメタタグによるクロール制御ルールを継承する。パブリッシャーが「AIにコンテンツを使われたくない」と設定していれば、Web IQもその指示に従う。
MicrosoftはIETF(インターネット技術標準化委員会)や他の業界団体とも協力し、AIシステムがウェブコンテンツにアクセスする際の標準ルール策定にも参加している。この動きは、Googleが進める「AIモード」や、その他のAI検索プロダクトとの間で、コンテンツ利用に関する共通ルールが形成されつつある兆候だ。
今後の展望と未解決の課題
現時点でWeb IQは「関心表明」を受け付けている段階であり、一般提供開始時期や価格、どのAIプラットフォームが採用するかは発表されていない。Microsoftの既存製品であるCopilotやBing Chatのグラウンディング機能がWeb IQを使っているのか、それとも別系統なのかも明らかにされていない。
とはいえ、Web IQの登場はAI検索時代の本格的な到来を示すマイルストーンだ。パブリッシャーは従来の検索エンジン最適化に加えて、「AIエージェントにどう使われるか」という視点でのコンテンツ設計を求められる局面に入ったと言える。
Bing Webmaster Toolsが提供を始めたAI引用データやCitation Shareは、そのための具体的な指標になる。まだ試験段階の数値ではあるが、早期にこれらのデータを確認し、自社コンテンツがAIにどう評価されているかを把握しておくことが競争優位につながるだろう。
この記事のポイント
- Web IQはAIエージェント向けのBing検索基盤APIであり、全文ではなくパッセージ単位で情報を返す
- 従来の検索評価とAI向け評価は異なる基準で動くため、SEO戦略の再考が必要になる
- Bing Webmaster ToolsのAI引用データやCitation Shareを使えば、AIからの評価を可視化できる
- パッセージ単位の情報設計が、今後のコンテンツ最適化の鍵になる
- 一般提供の時期や価格、対応AIプラットフォームは未発表だが、早期の動向把握が競争力を左右する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験