

Redditが生成AIの表示順位を左右する。実データが示す影響力と企業が取るべき対策
生成AIが回答の情報源として最も参照するプラットフォームがRedditだ。SEO対策から「AI最適化」へと重心が移りつつある今、Redditでの立ち振る舞いを無視することはビジネス上のリスクになりつつある。
AI最適化プラットフォームProfoundが2026年5月に公開した分析によれば、ChatGPTがユーザーの質問に回答する際、訓練データとリアルタイム検索の双方でRedditの情報を最大の情報源として利用しているという。Redditはもはや単なる掲示板ではない。大規模言語モデル(LLM)があなたのブランドについて「知っていること」そのものを形成する場になっている。
この記事では、Redditの投稿がどのように生成AIの回答を左右するのか、その具体的なデータを示すとともに、企業が取るべき具体的な対策を解説する。
ChatGPTがRedditを最重要視する理由
実務者の間では「Redditの影響力が増している」という肌感覚が広がっていた。だが、AIリサーチ企業Profoundの分析は、それを単なるトレンドではなく確固たるデータとして裏付けた。同社が2026年1月から5月にかけてChatGPTの引用と「ファンアウト」データを解析した結果、Redditは引用回数でトップに立った。
ファンアウトとは、AIが1つの質問に対してどれだけ多角的に情報源を展開したかを示す指標だ。Redditはこのファンアウト数においても他を圧倒していた。つまり、ChatGPTは単にRedditを引用するだけでなく、1つのスレッドから複数の関連情報を芋づる式に収集し、回答の骨格を作っている。
検索クエリへの「reddit」自動付与
この解析で興味深いのは、ChatGPTがリアルタイム検索を実行する際、クエリの末尾に「reddit」というキーワードを自発的に追加する挙動が確認された点だ。人間が「商品名 レビュー Reddit」と検索するのと同じ行動を、AIが自律的に行っている。生成AIが「実体験に基づく生の声」を求めている証左といえる。
従来の検索エンジン最適化が「アルゴリズムに評価される公式情報」を重視していたのに対し、AI最適化では「訓練データとライブ検索の両方で参照される草の根の評判」が問われる。Redditがその中心にある。
安易な口コミ操作が通用しない構造的理由
ここで多くの企業が「ならばRedditに肯定的な投稿を大量にすればいい」と短絡的に考える。だが、生成AI時代のReddit戦略は、そうした「やらせレビュー」的な手法とは根本的に相性が悪い。構造的な理由が2つある。
訓練データに刻まれたネガティブ情報は消せない
1つ目は、LLMの訓練データの問題だ。仮にReddit上の自社に不都合なスレッドをModeratorに削除してもらえたとしても、その情報はすでにGPT-4やClaudeといったモデルの訓練データに組み込まれている。モデルの重みの中にネガティブな文脈が残り続けるため、単純な「投稿削除」ではAIの感情分析(センチメント)を覆せない。
Redditのコミュニティは作為を見抜く
2つ目は、サブレディット(コミュニティ単位の掲示板)の自主管理能力の高さだ。各サブレディットには人間のModeratorが存在し、不自然なプロモーション投稿や作為的なポジティブレビューは極めて高い精度で検知される。露骨なステマが削除されるだけでなく、アカウントがスパム判定を受ければドメイン単位でブランドの信用が失墜するリスクもある。
重要なのは、AIは情報の「出所」よりも「文脈」と「一貫性」を評価する傾向がある点だ。作為的なポジティブキャンペーンは、むしろAIによる評価を歪ませ、長期的にはブランド毀損につながりかねない。
RedditでAI表示を味方につける3段階のプロセス
では、企業は具体的に何をすればいいのか。短期的なハックではなく、AIとアルゴリズムの両方に評価される正攻法のプロセスを3段階に分けて解説する。
STEP 1. 観察に徹してコミュニティの文法を学ぶ
Redditビジネスアカウントを作成したら、すぐに投稿やコメントを始めてはいけない。少なくとも数週間は「ROM(Read Only Member)」として、ターゲットとするサブレディットの文化を観察する期間を設ける。
各サブレディットには明文化されたルールに加え、暗黙の行動規範がある。企業アカウントがそれを無視して宣伝めいた投稿をすれば、即座にアカウント停止(BAN)の対象となる。Redditのアカウント停止は異議申し立てが極めて困難なことで知られており、一度BANされるとブランド名で再登録すること自体が難しくなる。
STEP 2. Reddit Proで自社の立ち位置を可視化する
観察期間と並行して、Reddit Pro(無料のビジネス向け分析ツール)の導入をお勧めする。このツールを使うと、以下の情報がダッシュボードで把握できる。
- ユーザーが自社ブランドについてどのような文脈で言及しているか
- 競合ブランドと比較した際のセンチメント(肯定的・否定的感情)の差異
- 自社の製品カテゴリに関連して今活発に議論されているスレッド
闇雲に投稿する前に、データに基づいて「どのサブレディットで、どんなトピックなら、企業として価値を提供できるか」を特定することが先決だ。
STEP 3. ブランド認知より「権威構築」を優先する
初期の投稿やコメントでは、自社製品の宣伝を一切排除し、純粋に専門知識を提供することに集中する。たとえば、ECプラットフォームを提供する企業なら「物流のボトルネックを解消するパッキングの工夫」、マーケティングツール企業なら「GA4で離脱率を下げるレポートの読み方」といった具合だ。
この段階でブランド名を出すことは、コミュニティから「売り込み」と見なされるリスクが高い。まずは個人としての信頼を積み上げ、その後に「そういえば、この分野のプロダクトを開発している」と自然に言及できる流れを作る。
ブランド専用サブレディットという選択肢
自社ブランドへの言及が一定数を超えてきた段階で、ブランド専用のサブレディットを開設することも有効な一手だ。すでに多くのテック企業がこの手法を取り入れている。
専用サブレディットの利点は、分散していた自社関連の会話を一箇所に集約できる点にある。ユーザー同士のQAやトラブルシューティングが活発になれば、それはそのままLLMが参照する「構造化されたナレッジベース」として機能する。サポートコストの削減とAI表示の最適化を同時に実現できるわけだ。
ただし、ここでも運営姿勢が問われる。企業が一方的に情報を発信する場ではなく、ユーザーが自由に意見を交わせる「公共広場」としての設計が不可欠だ。Moderatorが批判的な投稿を削除するような運営は、Reddit全体からの強い反発を招く。
この記事のポイント
- RedditはChatGPTが回答を生成する際の最重要情報源であり、訓練データとリアルタイム検索の双方で参照される
- ネガティブスレッドの削除や偽のポジティブ投稿は、LLMの訓練データに残る情報を覆せず、コミュニティからも排除されるリスクが高い
- アカウント作成後はまず観察に徹し、Reddit Proでデータを分析した上で、ブランド宣伝ではなく専門知識の提供による権威構築を優先する
- 長期的な視点でコミュニティに貢献し、AIに「信頼できる情報源」として学習させることが、生成AI時代のブランド防衛につながる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPTメモリがDreamingで進化、長期記憶と時間経過を自動反映
OpenAIが2026年6月4日、ChatGPTのメモリ機能を抜本的に改良したと発表した。新たに「Dreaming V3」というシステムを導入し、大規模なユーザー数と長期間の利用を想定したメモリ管理を実現する。
従来の「保存メモリ」は、明示的な指示がなければ情報を覚えられず、時間とともに内容が陳腐化する課題を抱えていた。今回のアップデートで、ChatGPTはバックグラウンドで会話履歴を分析し、自動的にメモリを最新化する。Plus・Proユーザーは同日より利用可能で、FreeユーザーとGoユーザーへの展開も数週間以内に開始される。
メモリ機能「Dreaming」の仕組み
Dreamingは、ChatGPTがあなたとのあらゆる会話から学習し、メモリを合成するバックグラウンド処理だ。従来の「ノートを取ってくれるが、書かなかったことは忘れる同僚」のような挙動から、「会話の文脈全体を理解し、常に最新情報を反映するパートナー」への変化と言える。
なぜDreamingが必要になったのか
ChatGPTのメモリ機能は2024年4月に初登場した。これは「保存メモリ」と呼ばれ、ユーザーが「覚えておいて」と指示した情報だけを保存する仕組みだった。しかし実際の会話では、明示的に指示されない暗黙の好みや状況が大量に存在する。保存メモリだけでは、数カ月前の旅行計画が終了しても「まだ旅行中」と誤認識するなど、情報の鮮度が落ちる問題が避けられなかった。
2025年4月にDreamingの初期バージョンが導入され、保存メモリを補完する形で改善が図られた。しかし当時はまだ、単独のメモリシステムとして十分に機能する段階にはなかった。今回のDreaming V3は、この補助的な役割を超え、完全なメモリ管理システムとして再設計されている。
Dreaming V3が実現する3つの目標
OpenAIは「優れたメモリ」を定義する3つの柱を提示している。過去の会話から有用な文脈を引き継ぐこと、ユーザーの好みや制約に従うこと、そして時間経過を考慮して情報を最新に保つことだ。Dreaming V3の評価結果は、この3軸すべてで大幅な改善を示している。
文脈の引き継ぎ:過去の自分を忘れない
新しいチャットを始めるたびに自己紹介からやり直す必要がなくなる。たとえば、過去にカメラ機材について相談していれば、ChatGPTは「私の撮影構成に合うもの」という曖昧な質問にも、過去の会話を踏まえた的確な製品を提案できる。これは、長期間にわたる複雑なプロジェクトで特に威力を発揮する。
好みと制約の反映:暗黙のルールを理解する
ユーザーの好みには、明示的な指示(「スタンの話はもう出さないで」)から、個人の制約(「私はベジタリアンです」)、そして地理情報のような暗黙の好み(「サンフランシスコ近郊に住んでいる」から現地情報を優先する)まで様々な形がある。Dreaming V3は、これらの情報を会話の流れから自然に拾い上げ、矛盾のない応答を継続的に生成する。
OpenAIの評価では、「ベジタリアン」と伝えたユーザーが後日食事の提案を求めた際、Dreamingが自動的に菜食対応の選択肢を提示するかがテストされた。結果は、従来の保存メモリ単体に比べて大幅な正答率の向上を示したという。
時間経過への対応:記憶を自動で更新する
従来の最大の弱点は、時間の経過によるメモリの陳腐化だった。Dreamingはここで真価を発揮する。たとえば「7月にシンガポール旅行」という記憶は、旅行が終われば自動的に「2026年7月にシンガポールに行った」という過去の出来事に書き換えられる。ChatGPTはその後、自宅近辺の情報を優先して提供するようになる。
OpenAIの評価では、時間経過が正しい回答に影響を与えるシナリオで、Dreamingが顕著な改善を達成したと報告されている。これは、単なる事実記憶ではなく、時間的文脈を理解した応答が可能になったことを意味する。
計算効率の改善と無料ユーザーへの展開
Dreaming V3のもう一つの重要な進化は、計算効率だ。OpenAIによれば、今回の改良によりDreamingを無料ユーザーに提供するために必要な計算リソースが約5分の1に削減された。これは、大規模なユーザーベースに対して実用的なメモリシステムを展開する上で決定的なブレイクスルーである。
以前は、Dreamingの処理負荷が高く、Freeユーザーに品質基準を満たしたメモリ機能を提供することが難しかった。今回の効率化により、数週間以内にFreeユーザーとGoユーザーへの段階的なロールアウトが開始される。同時に、Plus・Proユーザーのメモリ容量も拡張される予定だ。
この効率化は、単にユーザー数を増やすためだけではない。OpenAIの長期的なビジョンである「全ユーザーに共有メモリ基盤を提供する」という目標に向けた、アーキテクチャ上の重要なマイルストーンでもある。
メモリの透明性とユーザーコントロール
Dreamingが自動で合成したメモリは、すべてメモリサマリーページで確認できる。このページでは、ChatGPTがあなたについて把握しているハイライトを一目で把握し、必要に応じて情報の追加や更新、特定の話題に関する指示を与えることが可能だ。さらに詳細を知りたい場合は、チャットを通じて深掘りすることもできる。
これは、AIのパーソナライズ機能において重要なバランスだ。高い利便性を提供しつつ、ユーザーが自分のデータの全体像を把握し、コントロールできる状態を維持している。自動化と透明性の両立が、Dreamingの設計思想に組み込まれている。
Dreamingがもたらす実務への影響と今後の展望
Dreaming V3の登場は、ChatGPTを単発の質問応答ツールから、長期的なパートナーへと進化させる転換点だ。特に、プロジェクト管理や継続的な学習相談、ビジネス上の意思決定支援など、時間をかけて関係性を構築するユースケースで真価を発揮する。
OpenAIはこのアップデートを「これまでで最も高性能なメモリシステム」と位置づけており、今後も改良を続けるとしている。Dreamingは、将来的により高度なエージェント機能や、複数のChatGPTセッションを横断したタスク実行の基盤となる可能性が高い。
一方で、バックグラウンドで常に会話履歴を分析することへのプライバシー感度は、ユーザーによって異なるだろう。OpenAIはメモリの確認・削除を容易にするインターフェースを提供しているが、AIの記憶が深まるにつれて、データ管理の重要性も比例して高まる。このバランスが、今後の普及速度を左右する要素の一つになる。
このデモは、DreamingがChatGPTの役割を根本から変えることを示している。もはや「賢い検索エンジン」ではなく、あなたの文脈を理解し続ける存在になる。
この記事のポイント
- Dreaming V3は、バックグラウンドで全チャット履歴から自動的にメモリを合成する
- 「文脈引き継ぎ」「好みの反映」「時間経過対応」の3軸で大幅な改善を達成
- 計算効率が約5倍向上し、Free・Goユーザーへの展開が開始される
- メモリサマリーページで、ChatGPTの把握内容を常に確認・編集可能
- 長期的なプロジェクト支援やパーソナライズの質が飛躍的に向上する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがTanStack npm攻撃に対応、Macユーザーは6月12日までにアプリ更新を
広く利用されるオープンソースライブラリ「TanStack」のnpmパッケージが悪意ある第三者によって改ざんされた「Mini Shai-Hulud」と呼ばれるサプライチェーン攻撃。この影響はOpenAIにも及び、同社は2026年5月13日に公式な対応報告を公開した。
OpenAIの調査によると、ユーザーデータや本番システム、知的財産への不正アクセスは確認されていない。しかし、同社のコード署名証明書が一時的に影響下にあったことから、予防的な措置としてMacユーザーを対象に全アプリケーションの更新を2026年6月12日までに完了するよう呼びかけている。
今回の記事では、攻撃の具体的な影響範囲、OpenAIが講じたセキュリティ対策、なぜMacだけが更新対象なのか、そして実務者が理解すべきサプライチェーンリスクの本質を解説する。
TanStackを狙ったサプライチェーン攻撃とは
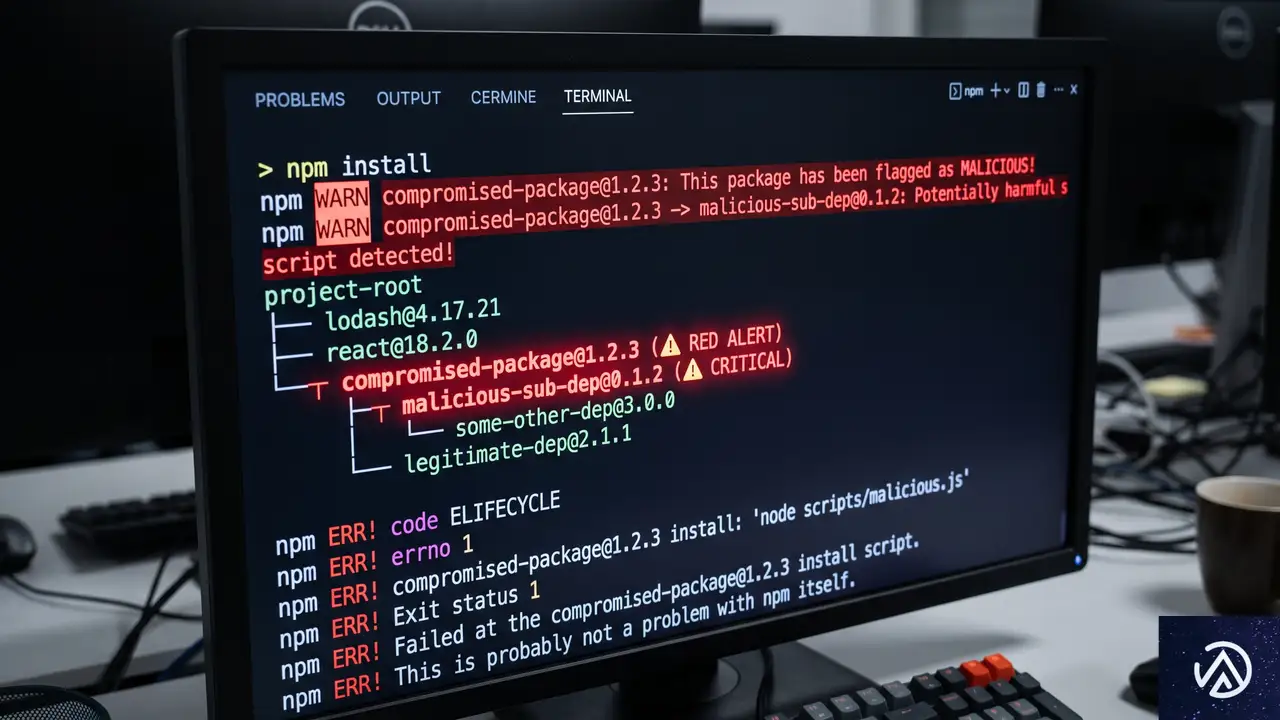
2026年5月11日(UTC)、フロントエンド開発で広く使われるJavaScriptライブラリ群「TanStack」のnpmパッケージが、攻撃グループによって改ざんされた。この攻撃は「Mini Shai-Hulud」と名付けられ、ソフトウェアサプライチェーンの弱点を突く大規模なキャンペーンの一環だ。
サプライチェーン攻撃とは、正規のソフトウェアやライブラリを踏み台にし、その利用者にマルウェアを拡散する手法を指す。開発者が信頼して導入するパッケージマネージャー(npm、PyPI、RubyGemsなど)を通じて感染が広がるため、一企業だけでなく、エコシステム全体に被害が連鎖する点が最大の脅威だ。
今回の攻撃では、改ざんされたパッケージをインストールした開発者の端末から認証情報が引き出される挙動が確認されている。OpenAIの事例でも、このメカニズムにより2台の社内端末が侵害を受けた。
攻撃の構造とマルウェアの挙動
Socket.devの分析によれば、Mini Shai-Huludは主に認証情報(トークン、APIキー、セッション情報など)の窃取を目的としている。感染後の典型的な挙動は、開発者端末に保存されたGit認証情報や環境変数への不正アクセス、そして一部の内部コードリポジトリへの侵入だ。
OpenAIが委託した第三者デジタルフォレンジック企業の調査では、影響を受けた2名の社員がアクセス可能だった一部の内部ソースコードリポジトリで、認証情報の引き出しが成功した形跡が確認された。ただし、コードそのものや他の情報が流出した証拠はない。
OpenAIの初動対応と封じ込め
OpenAIは悪意ある活動を検知した直後、以下の封じ込め措置を即座に実行した。
- 影響を受けた端末とIDの隔離
- 全ユーザーセッションの強制無効化
- 影響リポジトリに関連する全認証情報のローテーション(再発行)
- コードデプロイワークフローの一時的制限
- ユーザーおよび認証情報の挙動調査の徹底
これらの対応により、攻撃者による追跡アクセスや窃取された認証情報の悪用は確認されていない。また、顧客データやOpenAIの知的財産への影響は一切なかったと報告されている。
Macユーザーに更新が必要な理由
一見すると「社内端末2台の侵害だけなら、なぜエンドユーザーが対応するのか」と疑問に思うかもしれない。この背景には、コードサイニング証明書(コード署名証明書)の重要性がある。
コードサイニング証明書とは、ソフトウェアの開発元を電子的に証明する仕組みだ。macOSやWindows、iOSといったプラットフォームは、この証明書を確認することで「正規の開発者がリリースしたアプリかどうか」を判定している。
OpenAIの内部リポジトリには、iOS、macOS、Windows、Android向けのコードサイニング証明書が保管されていた。この証明書自体が直接流出したわけではないが、アクセス可能な状態にあったことから、OpenAIは予防的措置としてすべての証明書を新しいものに置き換える判断を下した。
証明書失効のタイムラインと影響
2026年6月12日をもって、旧証明書は完全に失効する。これ以降、旧証明書で署名されたmacOSアプリは、Appleのセキュリティ保護機能(Gatekeeper)によって新規ダウンロードや初回起動がブロックされる。
WindowsやiOS、Androidのアプリについても新しい証明書で再署名されるため、将来的なアップデートは必要になる。ただ、これらのプラットフォームでは即時のユーザー操作は不要とされている。
Macだけが個別アクションを求められる理由は、Appleのセキュリティモデルが証明書の有効性を厳格に検証する設計になっているためだ。更新を怠ると、以下のアプリが正常に動作しなくなる可能性がある。
- ChatGPT Desktop(バージョン 1.2026.125 以前)
- Codex App(バージョン 26.506.31421 以前)
- Codex CLI(バージョン 0.130.0 以前)
- Atlas(バージョン 1.2026.119.1 以前)
なぜ即時の証明書失効ではないのか
OpenAIはすでにプラットフォーム事業者と連携し、旧証明書を用いた新規の公証(ノータリゼーション)を全面的にブロックしている。公証とは、Appleがアプリをスキャンして悪意あるコードが含まれていないことを確認するプロセスだ。
仮に攻撃者が旧証明書を使って偽のOpenAIアプリを作成したとしても、公証を受けられないため、デフォルトのmacOSセキュリティ設定では実行が阻止される。この防御策が機能している間に、ユーザーがスムーズに公式アプリへ移行できるよう約1か月の猶予期間が設けられた。
この猶予期間中に、アプリ内アップデートまたは公式サイトからの再インストールを通じて、最新バージョンへの切り替えを済ませておくことが推奨される。
攻撃が浮き彫りにした開発エコシステムの脆弱性
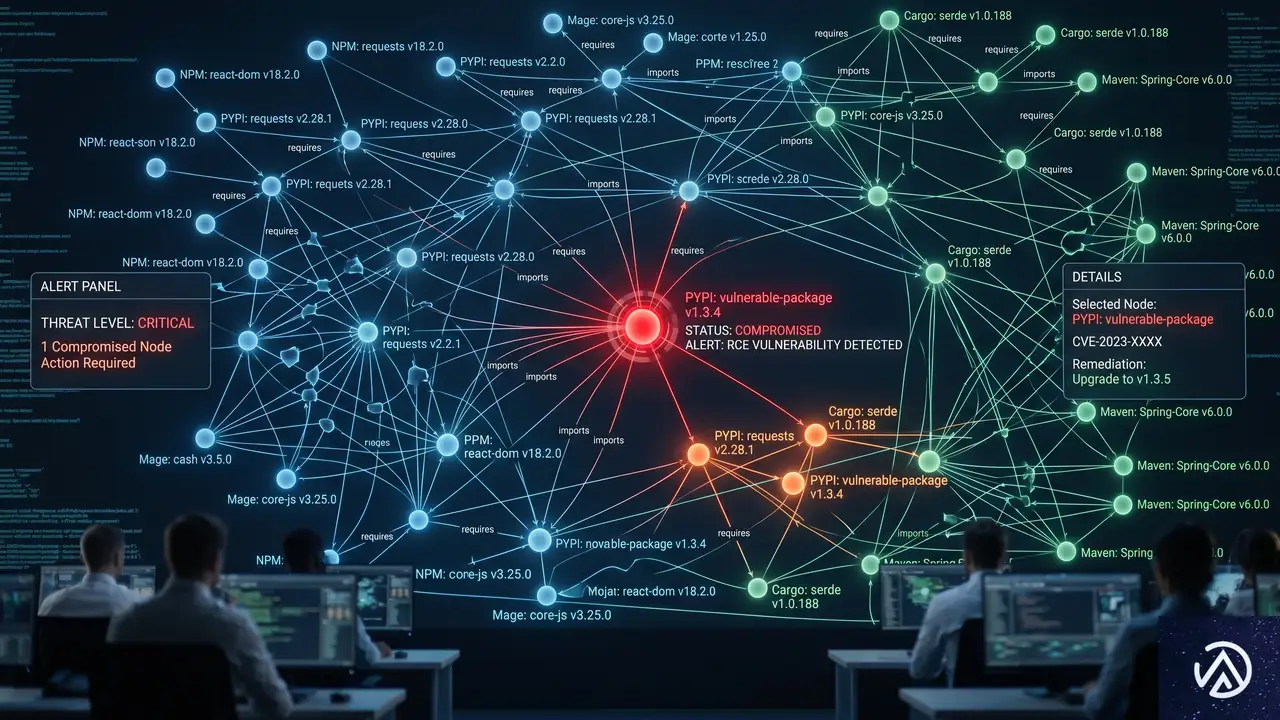
今回の事案は、特定企業を標的とした攻撃というよりも、オープンソースエコシステム全体の構造的な弱点を突いたものと言える。攻撃者は個別の企業ではなく、広く使われる共有ライブラリを侵害することで、一度に多数の組織へ侵入できる。
現代のソフトウェア開発は、npm、PyPI、Maven Centralといったパッケージレジストリに大きく依存している。1つのパッケージが侵害されれば、依存関係の連鎖によって数百、数千のプロジェクトが影響を受ける。実際、TanStackのパッケージを依存関係に持つプロジェクトは膨大だ。
OpenAIが進めるサプライチェーン防御
OpenAIは2025年末に発生したAxios開発者ツールの侵害を受け、すでにサプライチェーン攻撃への防御を段階的に強化していた。具体的には以下の対策が進められていた。
- CI/CDパイプラインで扱う機密度の高い認証情報の追加保護
minimumReleaseAgeなどの設定を用いたパッケージマネージャーの制御導入- 新規パッケージの信頼性を検証する追加セキュリティソフトウェアの展開
minimumReleaseAge とは、パッケージがレジストリに公開されてから一定時間(例:3日間)経過しないとインストールを許可しない設定だ。これにより、公開直後の悪意あるパッケージを誤って取り込むリスクを低減できる。
しかし、これらの対策が全社的に展開される途中の段階で、今回のインシデントは発生した。侵害を受けた2台の端末には、新たな制御設定がまだ適用されていなかったのである。
実務者が今すぐ取るべき対策
OpenAIの事例から学べる教訓は、単一の企業だけに留まらない。自社の開発環境においても、以下の対策を早急に検討すべきだ。
- パッケージマネージャーのロックファイル(package-lock.jsonなど)を定期的に監査する。 意図しないバージョン変更や新規依存関係が混入していないか、CI環境で自動チェックする仕組みを作る。
- サプライチェーンセキュリティツールの導入。 Socket.dev、Snyk、GitHub Dependabotなどを使い、脆弱性や悪意あるパッケージを早期に検出する。
- コードサイニング証明書の厳格な管理。 CI/CD環境とは完全に切り離し、必要最小限の担当者のみがアクセスできる保管場所を確保する。
- 依存パッケージの更新を自動化しすぎない。 パッチバージョンであっても、公開直後の即時適用は避け、一定の猶予を設ける。
このような防御策は、自社の開発文化や速度とバランスを取りながら段階的に導入していくのが現実的だ。しかし、攻撃の連鎖速度は日に日に速まっている。放置するリスクの方がはるかに大きいことは、今回の事例が明確に示している。
ユーザーが取るべき具体的なアクション
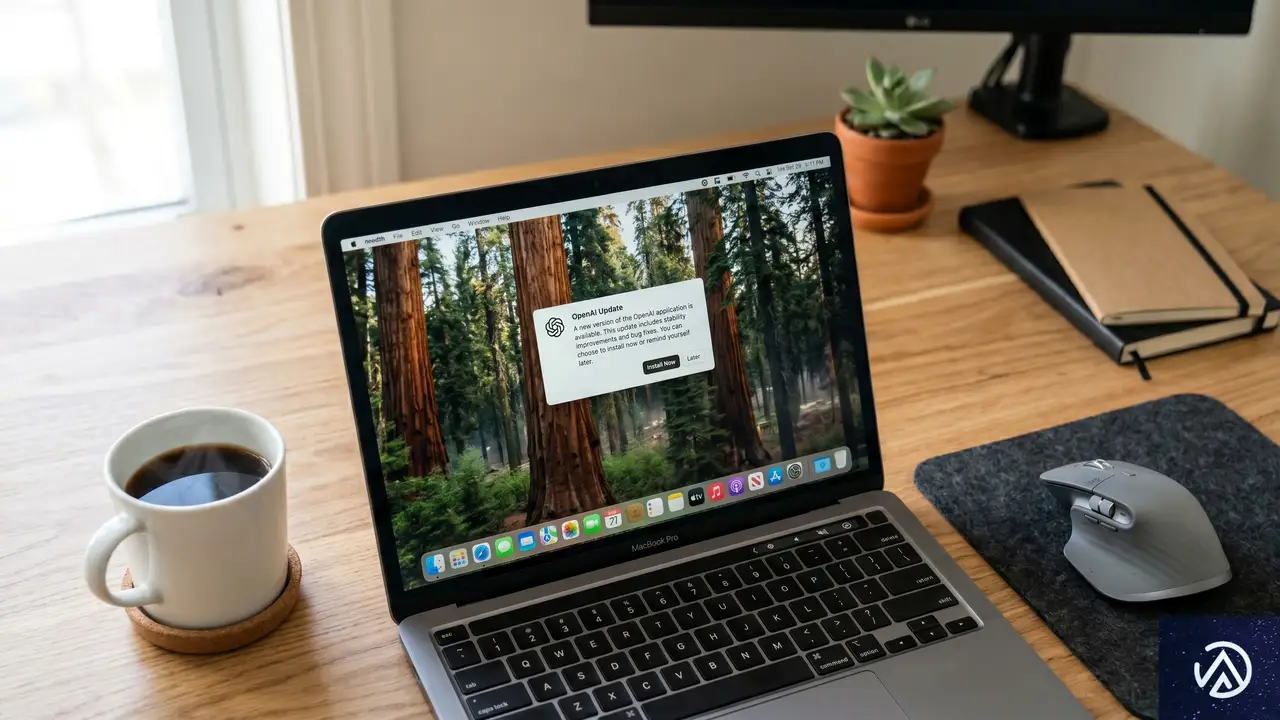
OpenAIのアプリをMacで利用している個人および企業は、以下の手順を確実に実施してほしい。
- 公式の更新経路のみを使用する。 アプリ内のアップデート通知、またはOpenAI公式ウェブサイト(openai.com)からダウンロードする。メール、メッセージ、広告、ファイル共有リンク経由の「ChatGPT」「Codex」インストーラーには絶対に手を出さない。
- 6月12日までに更新を完了する。 期限を過ぎると、旧証明書で署名されたアプリはmacOSによってブロックされる。業務で利用している企業は、社内のIT管理者が一括アップデートを計画すべきだ。
- パスワード変更は不要。 OpenAIは公式に、顧客のパスワードやAPIキーが影響を受けていないと明言している。無用なパスワード変更はフィッシングのリスクを高めるだけだ。
企業のIT管理者向け追加ガイダンス
組織内でOpenAIアプリを管理している場合、6月12日の証明書失効までにMDM(モバイルデバイス管理)やソフトウェア配布ツールを通じて、全Mac端末のアプリを最新バージョンに更新する計画を立てる必要がある。
更新対象となるアプリと、失効する旧バージョンの一覧は以下の通りだ。
- ChatGPT Desktop(旧バージョン 1.2026.125)
- Codex App(旧バージョン 26.506.31421)
- Codex CLI(旧バージョン 0.130.0)
- Atlas(旧バージョン 1.2026.119.1)
これらのバージョンが社内で稼働している場合、速やかに更新手続きを進めることが求められる。
この記事のポイント
- OpenAIはTanStack npmパッケージへのサプライチェーン攻撃により社内端末2台が侵害されたが、ユーザーデータや本番システムへの影響はなかった。
- 予防措置としてコードサイニング証明書を全面的にローテーション。Macユーザーは6月12日までにアプリを更新する必要がある。
- 旧証明書を用いた新規の公証はすでにブロック済みのため、偽アプリがmacOSで実行されるリスクは低い。
- 攻撃の本質はオープンソースエコシステムの脆弱性を突いたものであり、全開発組織がパッケージ管理の防御策強化を求められている。
- パッケージの即時自動更新を避け、minimumReleaseAgeの設定や監査プロセスの導入が有効な対策となる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
SupabaseがChatGPT公式アプリに。データベースとEdge Functionsを自然言語で操作可能に
SupabaseがChatGPTの公式アプリとして提供を開始した。これにより、ChatGPTの対話画面から直接Supabaseプロジェクトのデータベース管理やEdge Functionsのデプロイが可能になる。コードを書かずに自然言語でインフラを操作できる時代が一歩進んだ形だ。
今回の連携では、全部で29種類のツールが提供される。SQLクエリの実行、テーブルスキーマの設計変更、セキュリティアドバイザーの確認と修正、開発用ブランチの作成とマージなど、データベース運用に必要なほぼすべての操作をカバーしている。対象は全Supabaseプランと、ChatGPTの有料プラン(Plus / Pro / Team / Enterprise)だ。
この記事では、Supabase ChatGPTアプリで実現できること、導入方法、技術的な仕組み、そして国産の類似サービスと比較した実務的な評価を解説する。データベース管理の自動化に興味がある開発者や、Supabaseを使ったプロダクト開発の効率化を目指すチームにとって役立つ情報をまとめた。
ChatGPT側からSupabaseを直接操作できるようになった背景
これまでSupabaseの管理は、公式ダッシュボードやCLI(コマンドラインインターフェース)から手動で行うのが一般的だった。開発者であればSQLクライアントを起動し、APIキーを確認し、適切なエンドポイントを叩く。これらの手順に慣れている人にとっては日常的な作業だが、チームに非エンジニアが加わったり、素早いプロトタイピングが求められる場面では操作のハードルが高かった。
一方でChatGPTは、2025年以降、外部アプリとの連携機能を急速に拡充してきた。単なるテキスト生成AIから、実際のサービスを操作する「AIエージェント」としての側面を強めている。この流れの中で、SupabaseがChatGPTの公式アプリとして認定されたのは、両者の方向性が一致した自然な結果といえる。
この連携を支える技術が、MCP(Model Context Protocol / モデルコンテキストプロトコル)だ。MCPは、AIモデルが外部のツールやサービスと安全にやり取りするための標準プロトコルである。ChatGPTはこのMCPを通じてSupabaseのAPIを呼び出し、ユーザーの自然言語による指示を実際のデータベース操作に変換している。
従来のデータベース管理とChatGPT連携の比較
従来のSupabase管理(Before)
※非エンジニアが操作できない。ツールの切り替えが発生
ChatGPTアプリ連携後(After)
※対話の中でデータベース操作が完結。非エンジニアも参加可能
この仕組みは、単に検索して情報を得るだけの従来のAIアシスタントとは一線を画す。ChatGPTはSupabaseのAPIを通じて実際にテーブルを作成し、SQLを実行し、Edge Functionsをデプロイする。つまり「調べるAI」から「実行するAI」への進化を象徴する連携だ。
実務におけるインパクト
開発現場では、ちょっとしたデータ確認のためにSQLクライアントを起動する手間が意外に大きい。ChatGPT上で「先週登録したユーザーの数を教えて」と入力するだけで結果が返ってくれば、コンテキストスイッチ(作業の切り替えにかかる認知的負荷)が大幅に減る。また、セキュリティアドバイザーの指摘に対して「修正して」と指示するだけで実際の設定変更が行われる点は、運用負荷の軽減に直結する。
Supabaseの記事によれば、ChatGPTの「プロジェクト」機能と組み合わせることで、特定のSupabaseプロジェクトに会話のスコープを固定することもできる。プロジェクトの参照IDを一度設定しておけば、その後の会話では自動的に正しいデータベースに接続される仕組みだ。
ChatGPTアプリが提供する29種類の操作ツール
Supabase ChatGPTアプリには、以下の5カテゴリにわたる29種類のツールが実装されている。いずれも自然言語での指示をChatGPTが解釈し、適切なAPI呼び出しに変換して実行する形式だ。
データベース管理(Database Management)
Postgresデータベースに対するSQLクエリの実行、テーブルスキーマの設計と変更、テーブルや拡張機能の一覧表示、セキュリティに関する推奨事項の取得が含まれる。たとえば「usersテーブルに最終ログイン日時のカラムを追加して」と依頼すれば、ChatGPTが適切なALTER TABLE文を生成し、実行する。
セキュリティアドバイザーの確認機能はとくに実用的だ。RLS(Row Level Security / 行レベルセキュリティ)の設定漏れや、公開すべきでないAPIエンドポイントの検出など、見落としがちな設定項目を自動でチェックし、必要に応じて修正まで行える。
プロジェクト運用(Project Operations)
プロジェクトの作成と一覧表示、コスト見積もりの取得、プロジェクトの一時停止と再開、リアルタイムログへのアクセスといった運用系の操作をカバーする。開発用に一時的なプロジェクトを作成して使い終わったら停止する、といったライフサイクル管理をChatGPT上で完結できる。
ブランチとマイグレーション(Branching and Migrations)
データベースの開発用ブランチ作成、変更のマージ、リベースやリセット、マイグレーションの一覧表示と適用が可能だ。Supabaseのブランチ機能は、Gitを使ったコード管理と同様の考え方をデータベースに適用したもので、スキーマ変更を安全にテストしてから本番環境に反映できる。ChatGPT経由で「開発ブランチを作って、そこに新しいインデックスを追加して」と指示するだけで、一連の作業が実行される。
Edge Functions(エッジファンクション)
サーバーレス関数の一覧表示、デプロイ、管理を行う。Edge Functionsとは、ユーザーに近い地理的に分散したサーバー上で実行される軽量なサーバーレス関数のことで、低レイテンシでの処理が求められるAPIエンドポイントやWebhook処理に適している。ChatGPTに「新規ユーザー登録時にウェルカムメールを送信するEdge Functionを作ってデプロイして」と指示すれば、コードの生成からデプロイまでを自動で処理する。
ドキュメント検索(Documentation)
ChatGPTから直接Supabaseの公式ドキュメントを検索できる。コーディング中に詰まったとき、別タブでドキュメントを開かずに会話の流れの中で解決策を見つけられるのは、開発スピードの向上に寄与する。
29ツールのカテゴリ構成
データベース管理
■ SQL実行 ■ スキーマ設計 ■ テーブル一覧 ■ セキュリティ推奨
プロジェクト運用
■ プロジェクト作成・一覧 ■ コスト見積もり ■ 一時停止・再開 ■ リアルタイムログ
ブランチとマイグレーション
■ 開発ブランチ作成 ■ マージ ■ リベース ■ マイグレーション適用
Edge Functions
■ 一覧表示 ■ デプロイ ■ 関数管理
ドキュメント検索
■ Supabase Docsの直接検索
※各カテゴリのツール数はSupabase公式ブログの発表に基づく(2026年5月8日時点)
これらのツールは単独でも有用だが、組み合わせることで真価を発揮する。たとえば「セキュリティアドバイザーを実行して、問題があれば修正用のブランチを作成し、修正後に本番へマージして」という一連の指示を自然言語で伝えられる。従来であれば複数の画面とCLI操作を往復する必要があったフローが、1つの会話で完結する。
利用開始手順と対応プラン
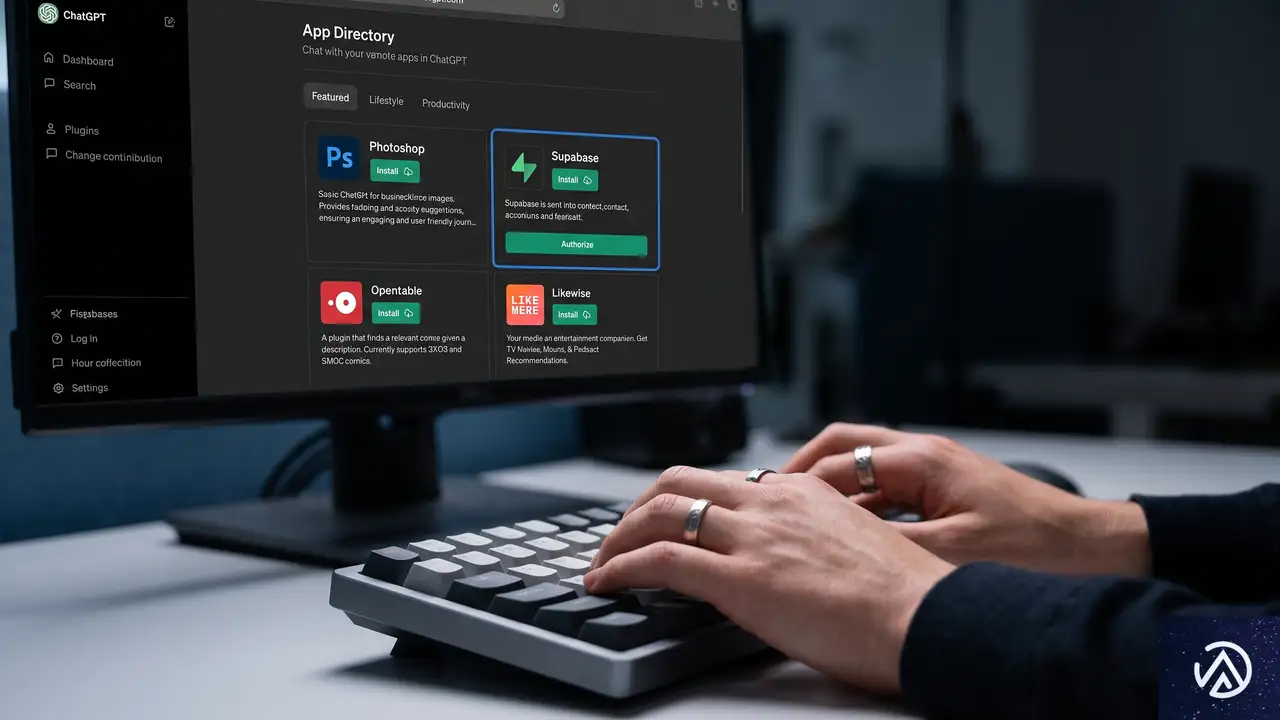
利用開始はシンプルだ。ChatGPTのアプリディレクトリで「Supabase」を検索するか、直接Supabaseのアプリページにアクセスして認証を行う。ChatGPTにSupabase組織へのアクセスを許可すれば、すぐに使い始められる。
対応しているのは全Supabaseプラン(無料プランを含む)と、ChatGPTの有料プランだ。ChatGPT側はPlus、Pro、Team、Enterpriseのいずれかの契約が必要になる。無料のChatGPTアカウントではこのアプリを利用できない点に注意したい。Supabase側に有料プランの制限はなく、無料枠のプロジェクトでも問題なく連携できる。
Supabaseアカウントをまだ持っていない場合は、supabase.comから無料でプロジェクトを開始できる。作成後、ChatGPTに接続して自然言語での管理を始める流れになる。認証にはSupabaseのアクセストークンが使用され、ChatGPTがユーザーに代わってAPIを呼び出す際の権限管理はこのトークンを通じて行われる。
ChatGPTプロジェクトとの連携で効率をさらに上げる
OpenAIが提供する「ChatGPT Projects」機能を使えば、会話のスコープを特定のSupabaseプロジェクトに固定できる。プロジェクトの参照IDをプロジェクト指示に一度設定しておくと、そのプロジェクト内のすべての会話が自動的に正しいデータベースを参照する。複数のSupabaseプロジェクトを抱えるチームでは、この設定で誤操作を防ぎつつ作業効率を高められる。
技術的な仕組みとMCPプロトコル
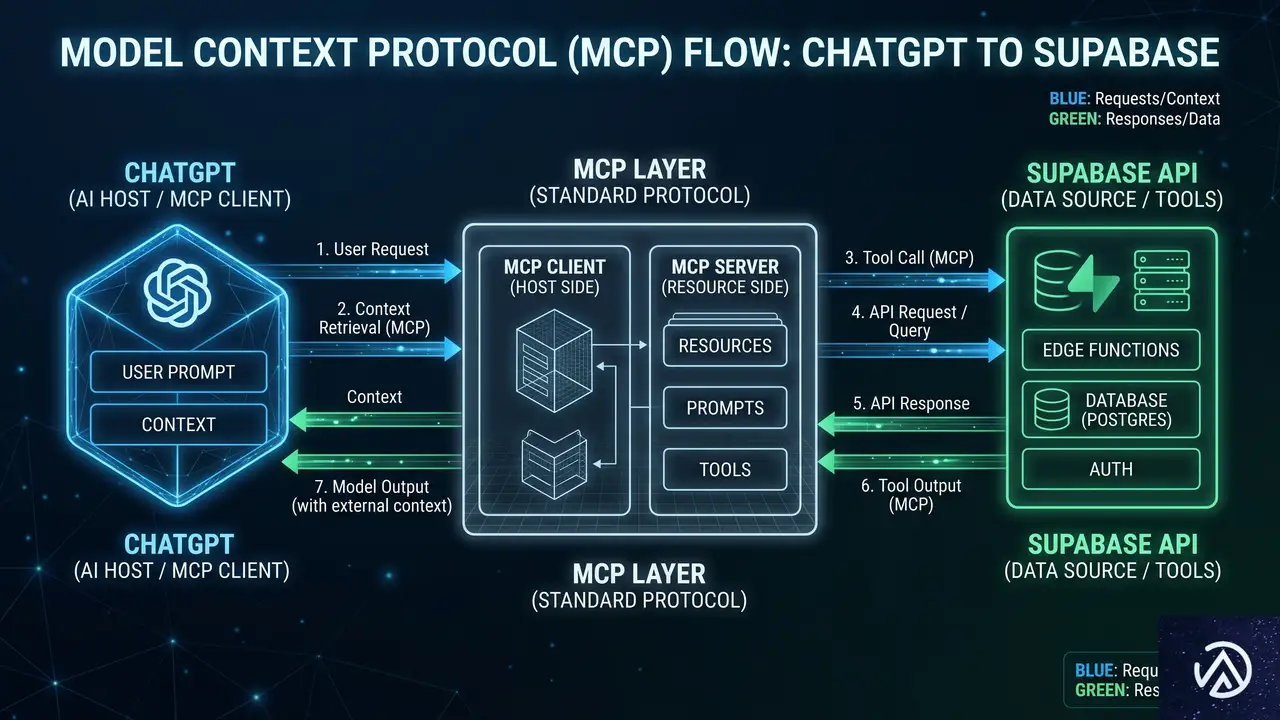
この連携の技術基盤となっているのが、MCP(Model Context Protocol)だ。MCPは2024年にAnthropicが提唱し、現在ではOpenAIを含む複数のAIプラットフォームで採用が進んでいるオープンプロトコルである。AIモデルが外部ツールやデータソースとやり取りするための共通言語のような役割を果たす。
MCPの仕組みを簡単に説明すると、AIモデルに対して「このツールはこういう機能を持っていて、こういう引数を受け取る」という定義(ツールディスクリプション)を提供する。ユーザーが自然言語で指示を出すと、AIはその定義を参照して適切なツールを選択し、必要なパラメータを推論して実行する。Supabaseの29ツールも、このMCPの枠組みに沿ってChatGPTに公開されている。
認証にはOAuth 2.0が使われており、ChatGPTがユーザーのSupabaseアカウントに代わってAPIを呼び出す際の権限は、ユーザーが許可した範囲に制限される。すべての操作はユーザーの認可の下で実行され、ChatGPTが勝手にデータベースを変更することはない。また、実行前にはChatGPTが「これからこういう操作をしますがよろしいですか」と確認を求める設計になっており、安全性にも配慮されている。
MCPによるSupabase操作の流れ
例「先月の売上を商品カテゴリ別に集計して」
「execute_sql_query」ツールを呼び出し、適切なSQLを生成
OAuth認証を通じてユーザーの権限でPostgresにクエリを発行
クエリ結果を要約してチャットで表示。必要に応じてグラフ化も提案
※実際の処理では、破壊的操作の前にChatGPTが確認を求める安全機構が働く
特筆すべきは、この仕組みが単なる「自然言語からSQLへの変換」にとどまらない点だ。ChatGPTはSupabaseから返ってきたデータを解釈し、必要に応じて追加の質問をしたり、結果をわかりやすく要約したりする。エラーが発生した場合も、ログを解析して原因を特定し、修正案を提示できる。
セキュリティと権限管理
AIにデータベースの操作権限を与えることに対する懸念は当然ある。SupabaseのChatGPTアプリでは、以下の3層の安全機構が実装されている。1つ目はOAuth 2.0によるスコープ制限で、ChatGPTがアクセスできる操作はユーザーが明示的に許可した範囲に限定される。2つ目は破壊的操作(DROP、DELETE、スキーマ変更など)の実行前確認だ。3つ目は、すべての操作がSupabaseの監査ログに記録される点で、事後的な追跡と検証が可能になっている。
国産データベースサービスとの比較と実務評価
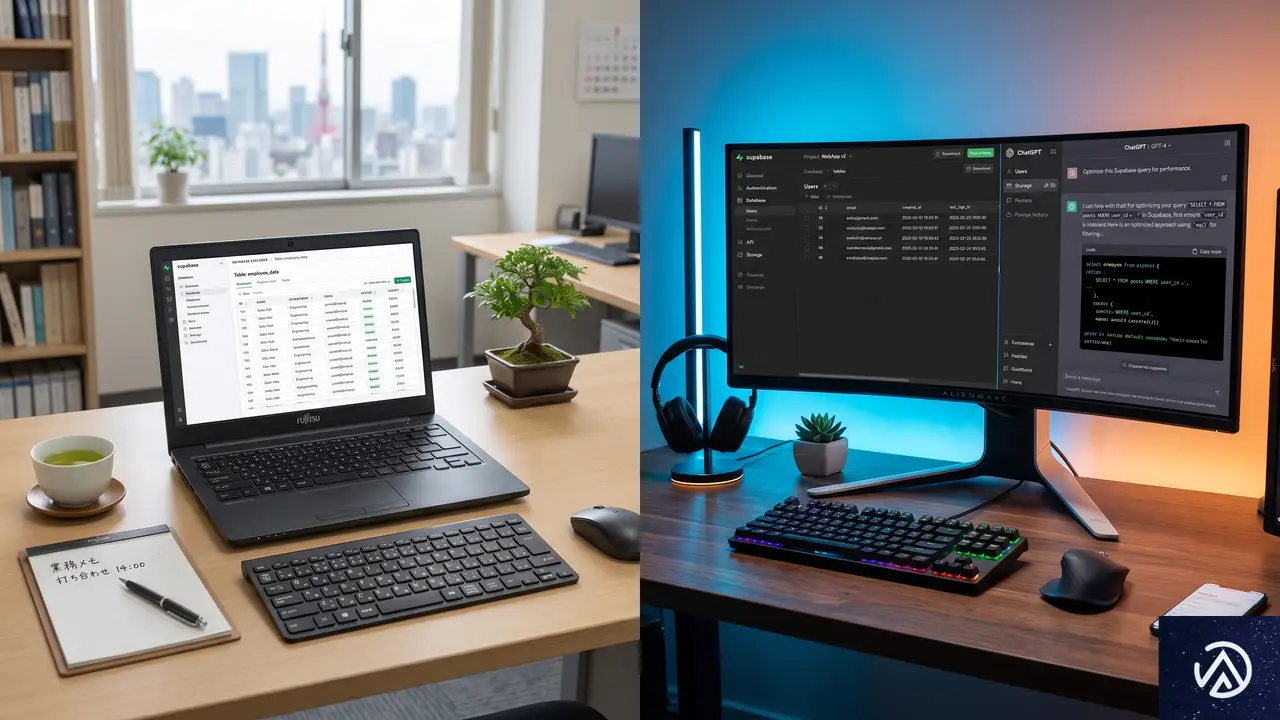
SupabaseとChatGPTの連携は、BaaS(Backend as a Service / バックエンドをサービスとして提供する形態)市場全体に波及効果をもたらす可能性がある。現時点で国内の類似サービスには、このレベルのAI連携を実装しているものは見当たらない。国産BaaSの多くは管理画面のUI/UX改善に注力しており、自然言語による操作という発想自体がまだ新しい。
ただし、実務に導入する際にはいくつかの注意点がある。第一に、ChatGPTが生成するSQLが常に最適とは限らない点だ。複雑なJOINやサブクエリを含むクエリでは、パフォーマンスの観点から人手によるレビューが推奨される。第二に、ChatGPTの有料プランが必要なため、チーム全体で利用する場合はコストの試算が欠かせない。第三に、プロダクション環境での破壊的操作をAIに委ねることのリスクは依然として存在する。スキーマ変更やデータ削除を伴う操作は、ステージング環境でのテストを挟む運用ルールを設けるのが現実的だ。
一方で、この連携が真価を発揮するのはプロトタイピングとトラブルシューティングの場面だ。アイデアを素早く形にしたいとき、あるいは深夜の障害対応で素早く原因を特定したいときに、ChatGPT上でSupabaseを直接操作できる利便性は大きい。とくにスタートアップや少人数チームでは、開発リソースの制約を補う手段として有効に機能するだろう。
今後の展望
SupabaseがChatGPT公式アプリとなったことで、他のBaaSやクラウドサービスにもAI連携の波が広がるのはほぼ確実だ。すでにVercelやCloudflareもAIエージェントとの統合を進めており、2026年後半には「ChatGPTから操作できるクラウドサービス」が標準的な提供形態になっていく可能性がある。
開発者にとっては、コーディングの効率化だけでなく、インフラ管理や運用監視といった領域までAIがカバーする時代が目前に迫っている。Supabaseの今回の発表は、その転換点を象徴する出来事といえる。
この記事のポイント
- SupabaseがChatGPT公式アプリとして提供開始。チャットからデータベース管理が可能になった
- SQL実行、スキーマ変更、Edge Functionsのデプロイなど29種類のツールを搭載
- 全SupabaseプランとChatGPT有料プランで利用可能。無料枠のプロジェクトでも連携できる
- 技術基盤はMCP(Model Context Protocol)。OAuth 2.0による権限制御で安全性を確保
- 実務導入ではSQLの最適性確認や本番操作の運用ルール整備が推奨される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPTに広告が登場。OpenAIがテスト運用を発表、日本への展開も明らかに
OpenAIは2026年2月、ChatGPTの無料プランとGoプランにおいて広告のテストを開始した。回答の内容に広告が影響することはなく、会話データは広告主に対して非公開に保たれる。すでに米国でのテストを経て、カナダや豪州への拡大が始まっている。
5月7日のアップデートでは、日本、英国、メキシコ、ブラジル、韓国の5カ国にもパイロットを拡大する計画が発表された。このテストはAIモデルの開発コストを一部カバーし、無料での利用を継続可能にする目的がある。実際に広告がどう表示されるのか、具体的な仕組みを見ていく。
ChatGPTで始まった広告テストの実態
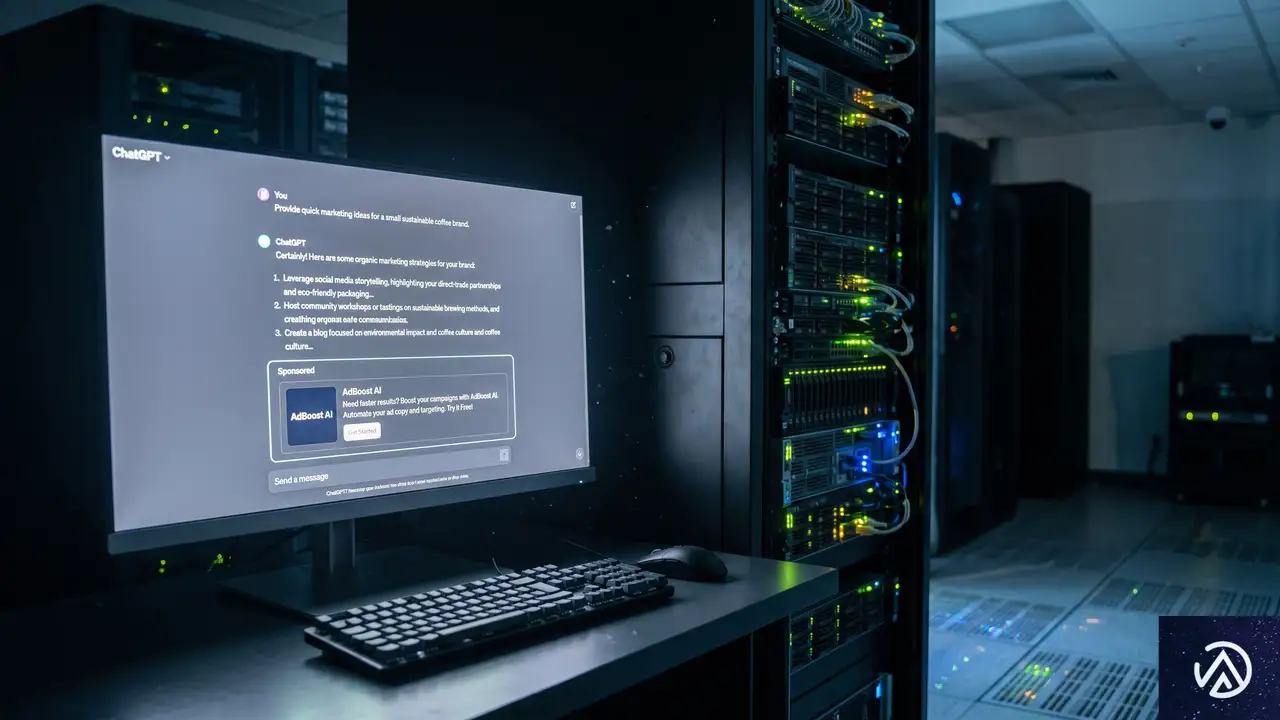
今回のテストは、ChatGPTのログイン済み成人ユーザーのうち、無料プランとGoプランを対象とする。月額20ドルのPlusや200ドルのPro、契約型のBusinessやEnterprise、Educationの各プランには広告が表示されない。OpenAIの公式ブログでの発表によれば、目的は「より多くの人が強力なChatGPTの機能にアクセスできるようにする」ことだ。
無料層を支えるインフラと広告の役割
ChatGPTは数億人のユーザーが学習や日常の判断に使うサービスである。無料プランとGoプランを高速かつ安定して提供し続けるには、大規模な計算基盤と継続的な投資が欠かせない。広告収入はその運用費を補填し、無料層や低価格帯の品質を落とさずにAIの能力を向上させるための資金源と位置づけられている。
実際にどの程度のリクエスト数がさばかれているかというと、SimilarWebの推計では2026年3月時点でChatGPTの月間訪問数は約50億回に達している。これだけのアクセスをリアルタイムで処理するためのGPUクラスタの電気代だけでも、月あたり数十億円規模と試算するエンジニアもいる。
広告の表示要件
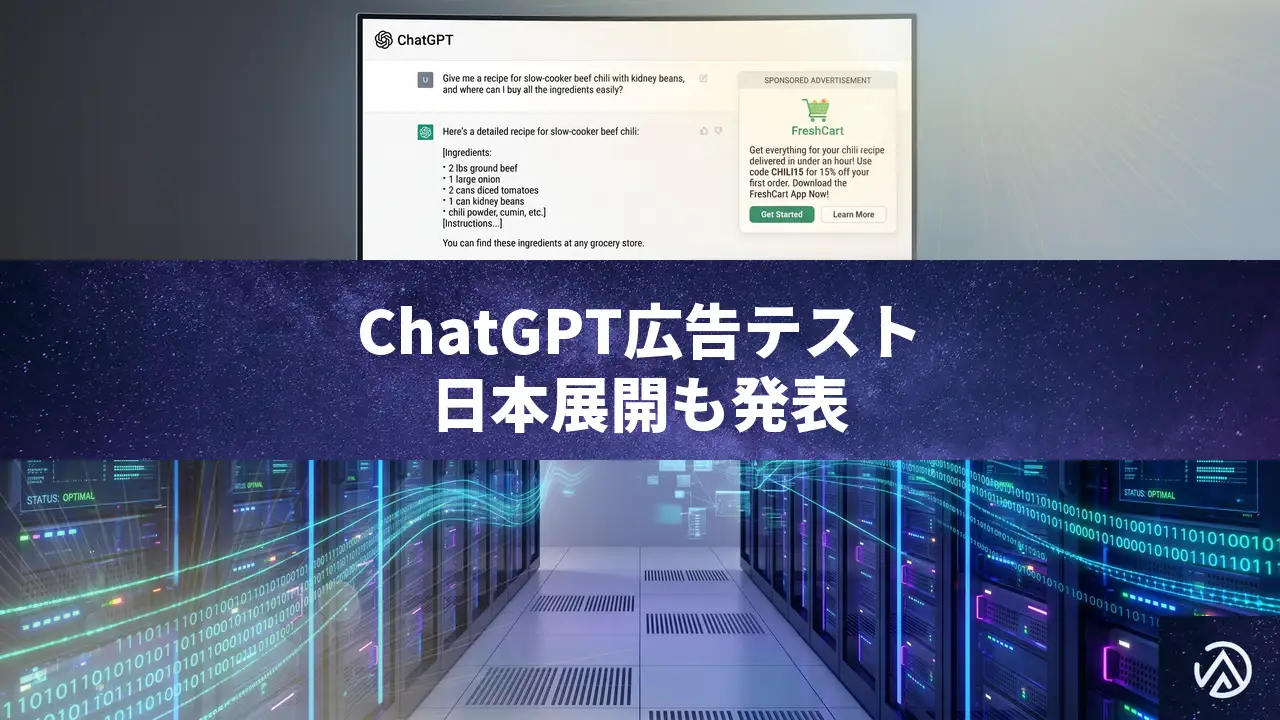
テスト段階では、会話の話題とユーザーの過去のチャット履歴、過去の広告とのインタラクションに基づいて表示する広告が選ばれる。たとえば料理のレシピを検索しているときには、食材キットや食料品の宅配サービスといった関連性の高い広告が出る仕組みだ。
自然検索結果はスクロールが必要
食材キットの広告が1件だけ表示
このデモでは、従来の検索エンジン型の広告表示と、ChatGPTの会話型広告表示の違いを示している。検索エンジンでは広告が検索結果の上位を占めることが多いが、ChatGPTでは回答と明確に分離され、会話の流れを妨げない形で1件の関連広告が表示される。
広告が回答内容に与えない影響とプライバシー設計
OpenAIは今回のテストに際して、「広告はChatGPTの回答に一切影響を与えない」という基本方針を明示している。回答はユーザーにとって最も役立つ内容に最適化され、広告は常に「スポンサー」ラベル付きで回答とは視覚的に分離される。
会話データは広告主に渡らない
プライバシー面では、広告主がユーザーのチャット内容やチャット履歴、メモリ機能に保存された情報、個人の詳細にアクセスすることはできない。広告主に提供されるのは、自社の広告が何回表示され何回クリックされたかといった集計データのみである。
これは、Cookieやデバイスフィンガープリントで個人を追跡する従来の行動ターゲティング広告とは根本的に異なるアプローチだ。OpenAIは「狭いターゲティングを防ぐためのガードレール」を設け、詐欺広告や有害・誤解を招く広告のリスクを減らす保護策も組み込んでいる。
18歳未満とセンシティブな話題では表示しない
テスト期間中、18歳未満と判明しているまたは予測されるアカウントには広告が表示されない。また、健康やメンタルヘルス、政治といったセンシティブまたは規制対象の話題の近くにも広告は表示されない設計である。これは、広告がユーザーの信頼を損なわないようにするための重要な仕組みだ。
ユーザーに提供される広告管理の選択肢
ChatGPTでは、広告に対してユーザーが細かく制御できる仕組みが用意されている。広告を見たくない場合は、PlusまたはProプランにアップグレードする方法と、無料プランのまま1日の無料メッセージ数を減らす代わりに広告を非表示にする方法の2つが提供される。
広告コントロールパネルの機能
設定画面からは次の操作が可能である。広告を閉じる、フィードバックを送信する、なぜその広告が表示されたのか理由を確認する、ワンタップで広告データを削除する、広告のパーソナライズ設定を管理する。
● インタレスト(推定される興味関心の確認)
● 広告データの削除(ワンタップで全消去)
● パーソナライズ設定(オン / オフ切替)
● 過去のチャットとメモリの使用(許可 / 不許可)
このパネルはChatGPTの設定内に組み込まれており、数タップで広告の表示有無やパーソナライズのオンオフを切り替えられる。一般的なSNS広告の設定画面よりも項目が整理されており、非エンジニアでも迷わず操作できる設計だ。
地域拡大のロードマップと日本市場への示唆
OpenAIは段階的にテスト地域を拡大している。2026年2月の米国を皮切りに、3月にはカナダ、豪州、ニュージーランドでのパイロットが開始された。そして5月の発表で、英国、メキシコ、ブラジル、日本、韓国の5カ国に拡大する計画が明らかになった。
地域ごとに異なる広告体験を学習する狙い
OpenAIの発表によれば、このパイロットの目的は「地域ごとに何が効果的かを理解し、拡大にあわせて体験を継続的に改善すること」にある。つまり単なる広告枠の販売ではなく、文化や商習慣の違いが広告の受け入れられ方にどう影響するかを検証する意図がある。
日本市場においては、LINEやYahoo! JAPANなどが提供するAIアシスタントとの競合が意識される局面でもある。ChatGPT上での広告が日本のユーザーにどのように受け止められるかは、国内でのサービス定着を左右する要素のひとつになるだろう。
広告主にとっての意味
OpenAIは企業向けに広告プログラムへの参加登録ページを公開している。現在は限定的だが、将来的には広告フォーマットの拡張や、目的別の広告購入モデルの追加が検討されている。とくにChatGPTの会話型インターフェースでは、ユーザーが「探している」タイミングで広告が表示されるため、検索広告とは異なる高いコンバージョン率が期待できると見られている。
対話型AIにおける広告の可能性と課題
OpenAIは今回のテストを「学習」の機会と位置づけている。広告が「役に立つ」と感じられ、ChatGPTの体験に自然に溶け込むかどうかを注意深く観察するとしている。初期の結果では、消費者の信頼指標に悪影響は見られず、広告の非表示率は低く、関連性は改善を続けているという。
会話型インターフェースならではの広告価値
ChatGPTのユーザーは、何かを積極的に調べたりアイデアを比較したり、意思決定に向けて動いている最中であることが多い。そうしたタイミングで表示される広告は、ユーザーが求める商品やサービスとの出会いを支援する可能性を持つ。OpenAIは「会話型インターフェースでは、広告がより関連性が高く有用になり、人々を新しい商品やサービスに自然な形でつなげられる」と述べている。
広告の独立性与信頼性の維持
ただし、AIアシスタントに広告を組み込むことへの懸念も根強い。ユーザーが「AIは中立的であるべき」と考える傾向があるためだ。OpenAIは「ChatGPTの回答は独立しており偏りがなく、会話は非公開に保たれ、人々は自分の体験を意味のある形で制御し続ける」という基本原則を、広告プログラムが拡大しても変えないと明言している。
この原則が実際に守られるかどうかは、今後の第三者監査やユーザーからのフィードバックの蓄積によって検証されていくことになるだろう。少なくともテスト段階では、広告が回答内容に干渉しないという設計は一貫している。
この記事のポイント
- ChatGPTの無料層で広告テストが始まり、日本を含む6カ国に拡大予定である
- 広告は回答内容に影響せず、会話データは広告主に非公開。プライバシー設計が明確だ
- ユーザーは広告の非表示やパーソナライズ設定の管理が可能である
- 対話型AIならではの広告価値が期待される一方、信頼性維持が最大の課題となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.5 Instant 登場。回答精度とパーソナライズ性能が大幅に向上
OpenAIがChatGPTのデフォルトモデルを「GPT-5.5 Instant」に更新した。これまで標準搭載されていたGPT-5.3 Instantを置き換える形で、全ユーザーに順次提供が開始されている。
今回のアップデートの核心は3つだ。事実誤認の大幅な減少、回答の簡潔さの向上、そして過去のチャット履歴や接続アプリを活用した高度なパーソナライズ機能の追加である。内部評価では、医療や法律、金融といった高精度が求められる分野でのハルシネーション(もっともらしい嘘)が52.5%も削減された。
何億人ものユーザーが日常的に利用するデフォルトモデルだからこそ、小さな改善の積み重ねが実用面では大きな差を生む。本記事ではGPT-5.5 Instantの具体的な進化点と、それが実際の利用体験にどう影響するのかを掘り下げていく。
事実誤認を半減させた精度向上の仕組み
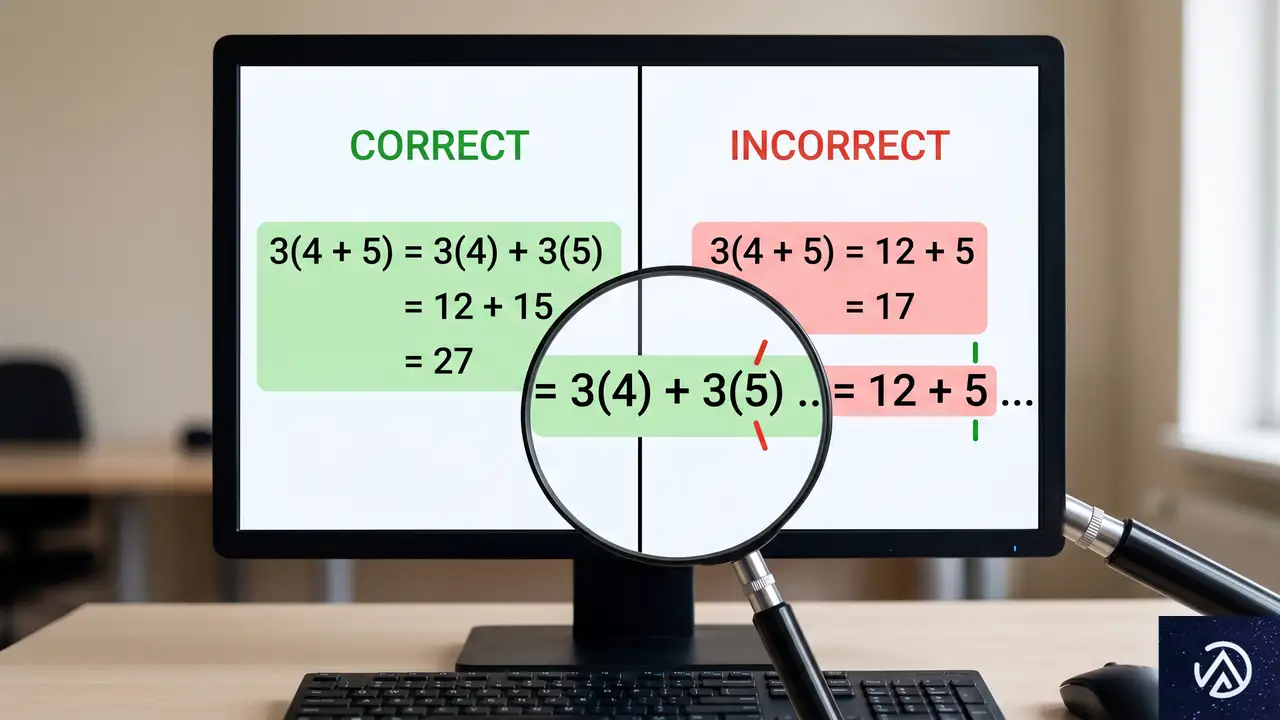
GPT-5.5 Instantにおける最大の改善点は、事実誤認(ハルシネーション)の劇的な減少だ。特に医療、法律、金融といった「間違いが許されない領域」で顕著な成果が出ている。
なぜここまでの改善が実現できたのか
OpenAIの公式ブログによると、GPT-5.5 Instantは高精度が求められるプロンプトにおいて、GPT-5.3 Instantと比較してハルシネーション(幻覚)を52.5%削減した。さらに、ユーザーが事実誤認を指摘したチャレンジングな会話においても、不正確な回答を37.3%減らしている。
この改善は単なる「よくわからないときは正直にわからないと言う」といった表面的な振る舞いの調整ではない。モデル自身が回答の妥当性を検証する能力が底上げされており、途中で誤りに気づいた際には自律的に修正できるようになった点が本質的な進化だ。
具体的な改善例から見えるもの
OpenAIが公開した比較例では、GPT-5.5 Instantは数学の問題に対して最初に不正確な解法を提示してしまった場合でも、代入チェックによって誤りを検出し、二次方程式の正しい解へと自力で修正している。一方でGPT-5.3 Instantは誤りに気づいてはいるものの、「解がない」と早々に結論づけてしまい、問題の本質に迫れなかった。
日常生活で使うAIアシスタントにとって、この「自己修正能力」は極めて重要だ。最初の回答が100%正しい必要はないが、誤りに気づいて軌道修正できるかどうかが実用性を大きく左右する。GPT-5.5 Instantのこの特性は、ビジネス文書の作成やデータ分析など、正確性が求められるシーンで特に頼りになるだろう。
冗長な表現を30.2%削減、それでも情報量は落とさない
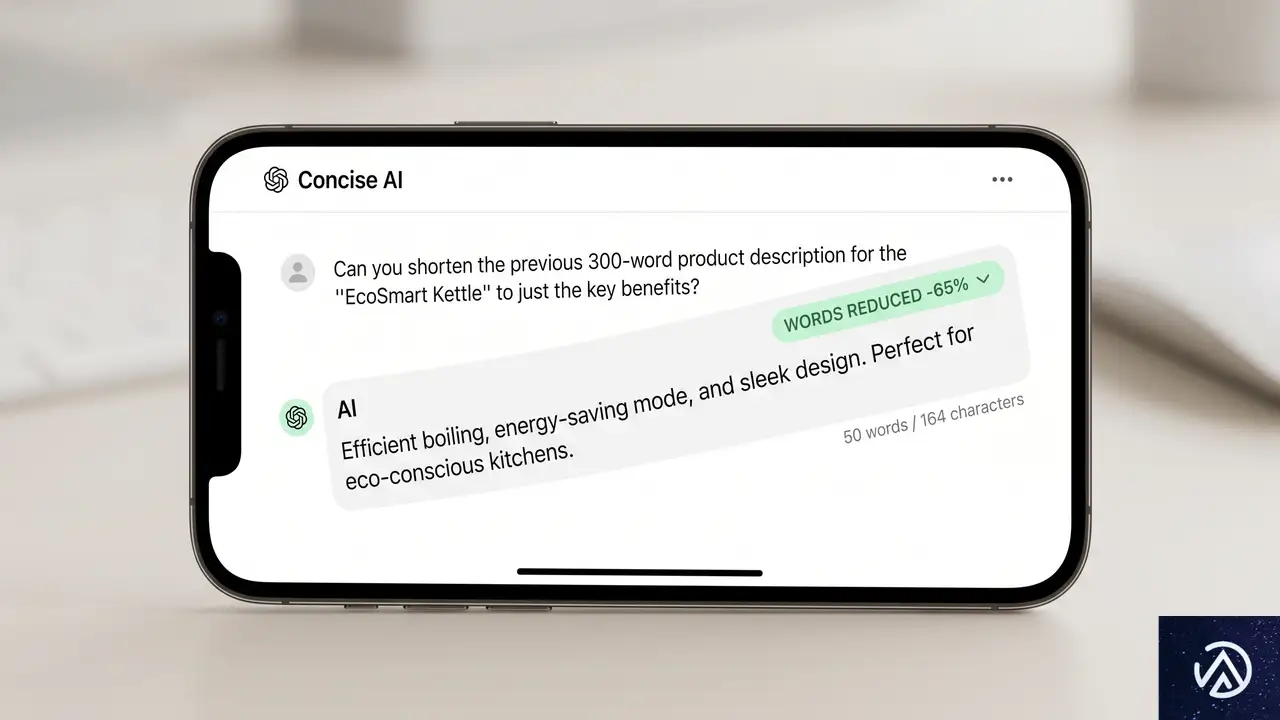
行数:基準値
過剰な絵文字:あり
行数:29.2%削減
不要な装飾:ほぼなし
GPT-5.5 Instantの回答は、前世代モデルと比較して単語数が30.2%、行数が29.2%も削減されている。この数字だけ見ると「情報量が減ったのでは」と心配になるが、実際は逆だ。余計な説明や過剰なフォーマットを省くことで、本当に必要な情報が見つけやすくなっている。
減ったのは「無駄」であって「中身」ではない
OpenAIの説明によると、新モデルは同じ情報をより少ない言葉で届けつつ、むしろ実用性は向上しているという。たとえば職場の人間関係に関するアドバイスを求めるプロンプトでは、GPT-5.3 Instantが「してはいけないこと」を含めた完全なフォーマットで回答するのに対し、GPT-5.5 Instantは状況に応じた実践的な言い回し例を提示し、問題を相手の人格ではなく「境界線」の問題として捉え直す視点を提供している。
ビジネスシーンで重要なのは、この「トーンの適切さ」だ。カジュアルな質問に過剰にフォーマルな回答が返ってくると、むしろ使う側のストレスになる。GPT-5.5 Instantは、状況に応じてフォーマル度を調整できるようになった点で、より人間らしい対話が可能になっている。
チャット履歴や接続アプリを活用した高度なパーソナライズ
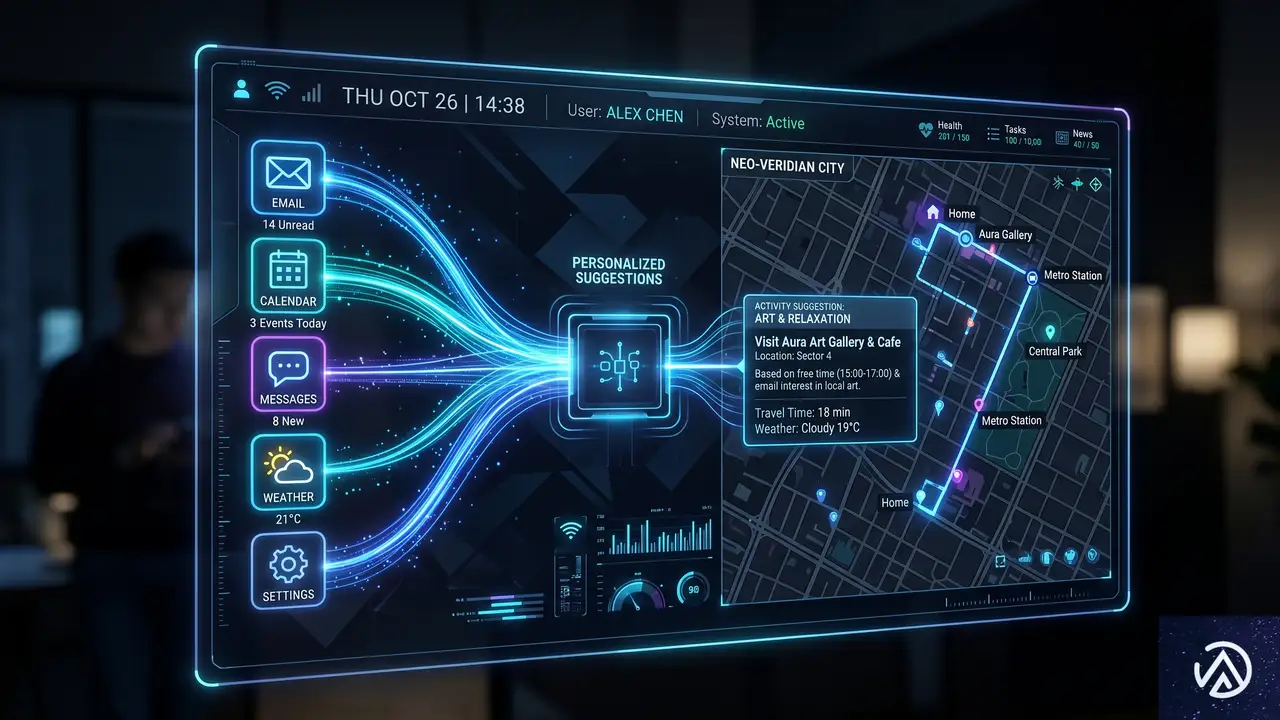
会話の開始 → 過去履歴を検索 → 関連コンテキストを取得 → カスタマイズされた回答を生成
GPT-5.5 Instantのもう一つの大きな進化が、パーソナライズ機能だ。過去のチャット履歴やアップロードしたファイル、さらに接続を許可したGmailの情報などを横断的に参照し、より個人に最適化された回答を提供できるようになった。
「メモリーソース」で見える化されたパーソナライズ
今回のアップデートで特筆すべきは「メモリーソース(Memory Sources)」という新機能の導入だ。これは、AIがどの情報を根拠にパーソナライズされた回答を生成したのかを明示する仕組みである。保存されたメモリーや過去のチャットのうち、回答に使用されたものをユーザーが直接確認でき、不要になった情報は削除や修正ができる。
OpenAIのブログ記事では、サンフランシスコ在住のユーザーに対するレストラン提案の比較例が紹介されている。GPT-5.3 Instantが居住地を考慮した一般的な提案にとどまるのに対し、GPT-5.5 Instantは過去の好みや予定をふまえた、より洗練された個別提案を行っている。この差は日常的な使い勝手に直結するだろう。
プライバシーはユーザーが制御できる設計
パーソナライズが強化されると、当然「どこまで自分の情報が使われるのか」という懸念が出てくる。この点についてOpenAIは、メモリーソースはチャットを共有しても他の人には表示されないこと、不要なチャットは削除できること、一時的なチャット(Temporary Chat)を使えばメモリーが使用も更新もされないことを明記している。
また個人情報の扱いについては、企業や教育機関向けプラン(Business、Enterprise、Edu)では、ユーザーデータがモデル学習に使用されない設定がデフォルトで適用される。個人利用でも、設定からデータ提供の可否を切り替えられる。
APIとロールアウトのスケジュール
GPT-5.5 InstantはChatGPTの全ユーザー向けに5月5日から順次提供が開始されている。APIではchat-latestとして利用可能だ。有料ユーザー向けには、旧モデルのGPT-5.3 Instantも3ヶ月間はモデル設定から選択できる形で残される。
パーソナライズ機能の強化は、まずPlusおよびProユーザー向けにWeb版で展開され、モバイル版にもまもなく対応する予定だ。その後、数週間以内にFree、Go、Business、Enterpriseプランにも拡大される。メモリーソース機能はすべてのコンシューマープランでWeb版から提供開始され、モバイル版も順次対応する。
この記事のポイント
- GPT-5.5 Instantは医療や法律など高精度が求められる分野でハルシネーションを52.5%削減した
- 回答の単語数が30.2%削減され、より簡潔で実践的なアドバイスが得られるようになった
- 過去のチャット履歴やGmailなどの接続アプリを活用したパーソナライズ機能が大幅に強化された
- メモリーソースにより、AIが参照した情報をユーザー自身が確認・管理できるようになった
- 全ユーザー向けに順次提供開始、旧モデルは有料プランで3ヶ月間利用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIが高度なアカウント保護機能を発表、パスワードレス認証を標準化
OpenAIは2026年4月30日、ChatGPTアカウントのための新たな保護オプション「Advanced Account Security(高度なアカウントセキュリティ)」の提供を開始した。ChatGPTとCodexの両方に適用される、フィッシング耐性を備えた認証手段を標準化する設定だ。特にジャーナリストや研究者、政治家など、高度な標的型攻撃のリスクに晒されるユーザーを主な対象としている。
この設定を有効にすると、パスワードによるログインが無効化され、パスキーまたは物理セキュリティキーが必須になる。同時に、メールやSMSによるアカウント復旧も停止される。OpenAIのサポートチームでさえ、この設定を有効にしたアカウントの復旧支援はできない仕様だ。セキュリティと引き換えに自己責任の範囲が拡大する点が特徴といえる。
Advanced Account Securityとは何か、そしてなぜ今必要なのか
ChatGPTは個人の相談事から業務の自動化まで利用範囲が急拡大している。アカウントには長期間にわたる会話履歴、個人情報、接続された外部ツールの認証情報などが蓄積される。OpenAIのブログ記事では「時間の経過とともに、ChatGPTアカウントは機密性の高い個人情報や業務コンテキストを保持し、接続されたツールやワークフローの中心に位置するようになる」と指摘されている。
フィッシング攻撃やセッション乗っ取りによってAIアカウントが侵害された場合、単なるパスワード漏洩以上の被害が想定される。過去の会話から企業秘密が推測されたり、APIキーや連携ツール経由で二次被害が広がるリスクがある。この新機能は、そうしたアカウント乗っ取り(Account Takeover)の脅威に対抗するための総合的な防御策だ。
上記の比較で示したように、認証手段と復旧フローの両面で防御が強化される。重要なのは、この設定がOpenAIの「Cybersecurity Action Plan(サイバーセキュリティ行動計画)」の一環であることだ。同社は国家安全保障や重要システムの保護に貢献する技術へのアクセス拡大を掲げており、本機能の提供はその具体的な施策にあたる。
標的になりやすいユーザー層とは
OpenAIのブログ記事では、ジャーナリスト、選挙で選ばれた公職者、政治的反体制活動家、研究者、そして「特にセキュリティ意識の高い人々」が具体的な対象として挙げられている。こうした層は国家支援のハッキンググループや高度なソーシャルエンジニアリング攻撃の標的になりやすく、標準的なパスワード認証やSMS認証では防御が不十分だ。
フィッシング攻撃では、精巧な偽ログインページでパスワードやワンタイムコードを入力させ、その情報を攻撃者がリアルタイムで転送する手法(中間者攻撃)が多用される。こうした攻撃に対し、FIDO(Fast IDentity Online)規格に準拠したパスキーや物理セキュリティキーは、ドメイン名と秘密鍵が数学的に結びつく仕組みで偽サイトへの認証情報入力を根本的に阻止する。
4つの柱で構成される保護メカニズム
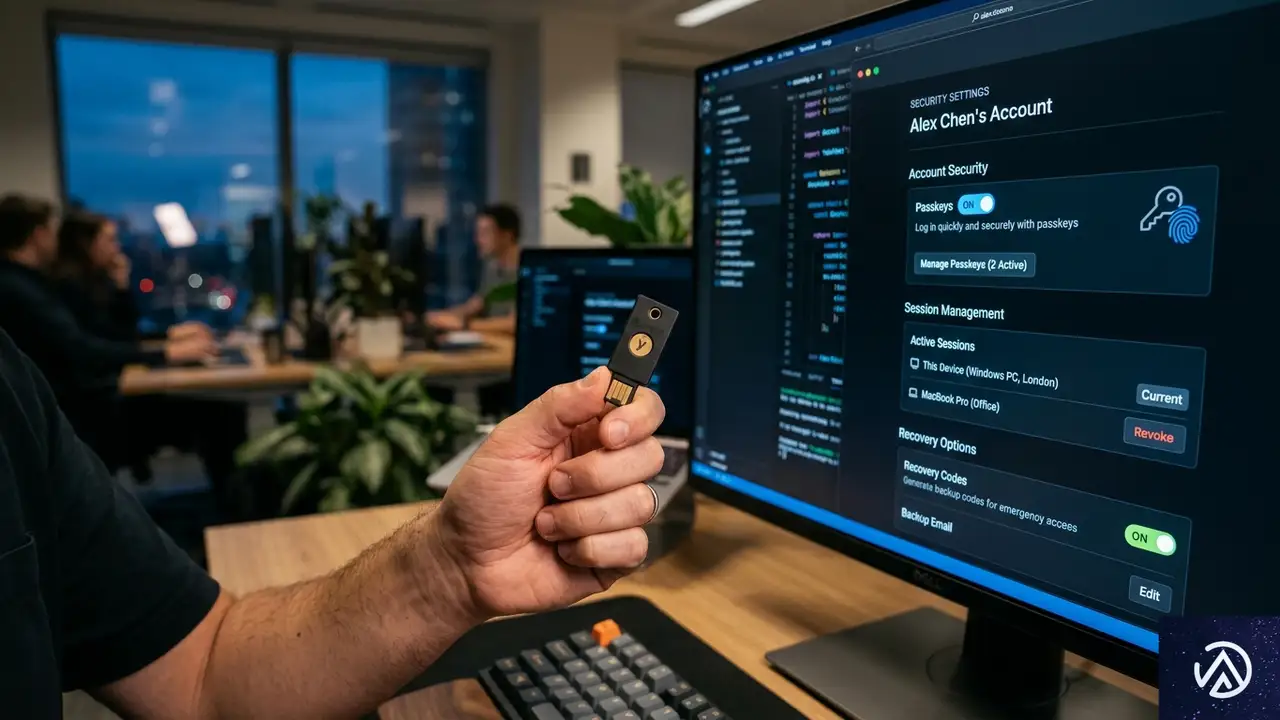
Advanced Account Securityは単一の機能ではなく、認証から復旧、セッション管理、プライバシー設定に至るまで、4つの独立したセキュリティ強化策を一括で適用するパッケージだ。ここでは各要素を詳しく解説する。
1. パスワードレス認証の強制
この設定を有効にすると、パスワードによるログインが完全に無効化される。以降はパスキー(生体認証やデバイスPINを利用したFIDO認証情報)か、YubiKeyのような物理セキュリティキーのいずれかでしかログインできなくなる。これにより、フィッシングに強い認証がデフォルトになるわけだ。
パスキーとは、公開鍵暗号方式を応用した新しい認証技術である。簡単に説明すると、ユーザーのデバイス内に秘密鍵が安全に保管され、サービス側に公開鍵が登録される仕組みだ。ログイン時には生体認証やデバイスロック解除で本人確認が行われ、偽サイトでは秘密鍵が応答しないためフィッシングが成立しない。パスワード管理の手間もなくなる点が実務上の利点として大きい。
2. アカウント復旧手段の厳格化
通常のChatGPTアカウントでは、メールアドレスや電話番号を使ってパスワードをリセットし、アカウントへのアクセスを復旧できる。しかし攻撃者がメールアカウントを侵害したり、SIMスワップ(携帯電話番号の乗っ取り)を行った場合、この復旧経路自体が弱点になりうる。
Advanced Account Securityを有効にすると、メールとSMSによる復旧が無効化される。代わりにバックアップ用のパスキー、セキュリティキー、またはリカバリーキー(事前に発行される使い切りの文字列)のいずれかでしか復旧できなくなる。OpenAIのブログ記事では「復旧がこれらのより安全な手段に制限されるため、OpenAIサポートは本機能を有効化したユーザーのアカウント復旧を支援できない」と明記されている。利便性と引き換えに、復旧は完全に自己責任になる点を理解しておく必要がある。
3. セッション管理と通知
サインイン後のセッション有効期間が短縮される。これはデバイスの紛失や盗難、あるいは社内システム上でセッションが残ったままになるリスクを低減する狙いがある。仮にアクティブなセッションが侵害されたとしても、攻撃者が悪用できる時間枠が狭まる。
加えて、アカウントに新しいログインが発生するたびに警告通知が届くようになる。ユーザーは自身のアカウントにサインインしている全デバイスのアクティブセッションを一覧表示し、不要なセッションを手動で終了させることも可能だ。これにより、異常なログインを早期に検知し対処できる。
4. モデル学習データからの自動除外
機密性の高い情報を扱うユーザーの中には、自身の会話がAIモデルの学習に使われることを望まないケースがある。Advanced Account Securityを有効にすると、この設定が自動的に適用され、該当アカウントの会話データはOpenAIのモデル訓練に使用されなくなる。通常は手動でオプトアウト設定を行う必要があるが、セキュリティ強化機能を有効にすることで同時にプライバシー保護も担保される設計だ。
Yubicoとの提携と物理セキュリティキーの提供
OpenAIはハードウェア認証のリーディングカンパニーであるYubicoと提携し、Advanced Account Securityの利用者向けに割引価格のセキュリティキーバンドルを提供する。具体的には、ノートPCに挿しっぱなしで日常的な認証に使う「YubiKey C Nano」と、バックアップおよびスマートフォン認証用の「YubiKey C NFC」の2本セットだ。
物理セキュリティキーは、フィッシング攻撃に対する最も強力な防御手段のひとつとされる。偽のログインページでは正しい認証応答を生成できず、仮にユーザーが騙されて違うサイトでキーをタッチしても、認証情報が盗まれることはない。OpenAIのブログ記事では、この割引バンドルを「Advanced Account Securityの利用者向け」としながらも、すべての対象ユーザーがウェブ版ChatGPTのセキュリティ設定から購入できるとも述べている。FIDO準拠の他社製セキュリティキーや、ソフトウェアベースのパスキーも併用可能だ。
Codexおよびエンタープライズ利用への影響
今回の機能はChatGPTだけでなく、Codexアカウントにも保護を適用する。Codexは自然言語からコードを生成する開発者向けツールで、APIキーや本番環境の設定情報など、侵害された場合の影響が極めて大きい情報を扱う。OpenAIはCodexについて「開発者がアイデアを動作するソフトウェアに変える方法を変革している」と位置づけており、そのアカウント保護は開発者コミュニティ全体のセキュリティに直結する。
さらにOpenAIは、サイバーセキュリティ分野の検証済み防御者に対して最も高度なモデルへのアクセスを提供する「Trusted Access for Cyber」プログラムを展開している。2026年6月1日以降、このプログラムに参加する個人メンバーはAdvanced Account Securityの有効化が必須になる。組織向けには、シングルサインオンのワークフローにフィッシング耐性のある認証が組み込まれていることを証明する代替手段も用意される。
OpenAIのブログ記事では「ChatGPTの広範な消費者リーチは、職場への強力な流通チャネルを生み出している。需要は基本的なモデルアクセスから、ビジネス運営を再構築するインテリジェントシステムへと急速に移行している」と述べられており、個人利用から業務利用への広がりを背景に、エンタープライズ環境へのセキュリティ対策拡大も示唆されている。
任意でのオプトイン。セキュリティ設定画面から有効化。
同一ログインで保護が適用される。APIキーやコード資産も防御対象。
2026年6月1日から有効化が必須。個人は強制、組織は代替証明も可。
この記事のポイント
- OpenAIがChatGPTとCodex向けに「Advanced Account Security」を提供開始。アカウント乗っ取り対策を強化するオプトイン設定だ
- パスワードログインを無効化し、パスキーまたは物理セキュリティキーを必須にする。フィッシング耐性が飛躍的に向上する
- SMSやメールによるアカウント復旧を停止。復旧はバックアップキーでのみ可能で、サポートによる復旧支援も受けられなくなる
- Yubicoと提携し、2本組のセキュリティキーバンドルを割引価格で提供。FIDO準拠の他社製品も利用可能だ
- Trusted Access for Cyber参加者は2026年6月1日以降、本機能の有効化が必須となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索エンジンの引用傾向比較、ブランド戦略に示唆
主要なAI検索エンジン5つを比較した調査で、引用されるウェブサイトの種類に大きな差があることがわかった。一方で、特定の製品やサービスと結びついたブランド名は、どのAIでも共通して引用されやすい傾向にある。
この記事では、BrightEdge社の調査データを基に、ChatGPTやGoogle AI Overviews、Gemini、PerplexityといったAIが「何を情報源として選ぶのか」を分析する。AI時代のSEO対策として、自社サイトの情報設計やブランディングにどう活かすべきか、具体的な論点を提示する。
5つのAIサーチエンジンが示す、引用ソースの「分散」と「集中」
今回の調査は、2026年4月にBrightEdge社が実施したものだ。ChatGPT、Google AI Overviews、Google AI Mode、Google Gemini、Perplexityの5つについて、生成された回答の中でどのようなサイトが引用されているかを分析している。
まず注目されたのは、各AIエンジンが引用する上位サイトの重なり具合、つまり「ソース重複率」だ。最も重複が少なかった組み合わせでは、わずか16%の一致率にとどまった。対照的に、最も高い組み合わせでは59%のサイトが重複していた。
この数字が意味するのは、AIによって情報源の選び方が全く異なり得るという事実だ。あるAIで引用されるからといって、別のAIでも同様に扱われる保証はない。複数のAI検索エンジンでの露出を狙うなら、それぞれの特性を踏まえた対策が必要になる。
ブランド名の一致率は相対的に高い
ソース重複率とは対照的に、回答内で言及される「ブランド名」に関しては、AI間でより高い一致が見られた。最も低い組み合わせでも36%、高い組み合わせでは最大55%のブランド名重複率が記録されている。
つまり、各AIは異なるウェブサイトを参照しているにもかかわらず、結果として同じブランド名にたどり着く傾向がある。これは、製品やサービスと強く結びついたブランドが、業界全体で広く認知されていることの反映だ。信頼できるウェブサイトから繰り返し言及されるブランドは、AIの学習や検索プロセスでも再現性が高まる。
Search Engine Journalの著者Roger Montti氏は、この点について「消費者の頭の中でブランドと製品・サービスを結びつけることが、ブランド検索の増加につながる」と指摘している。Googleが2004年頃からNavboostと呼ばれる仕組みでユーザー行動シグナルをランキングに活用してきたことや、ブランドナビゲーションに関する特許を取得している事実も、この考えを裏付けている。
信頼されるサイトの種類はAIごとに大きく異なる
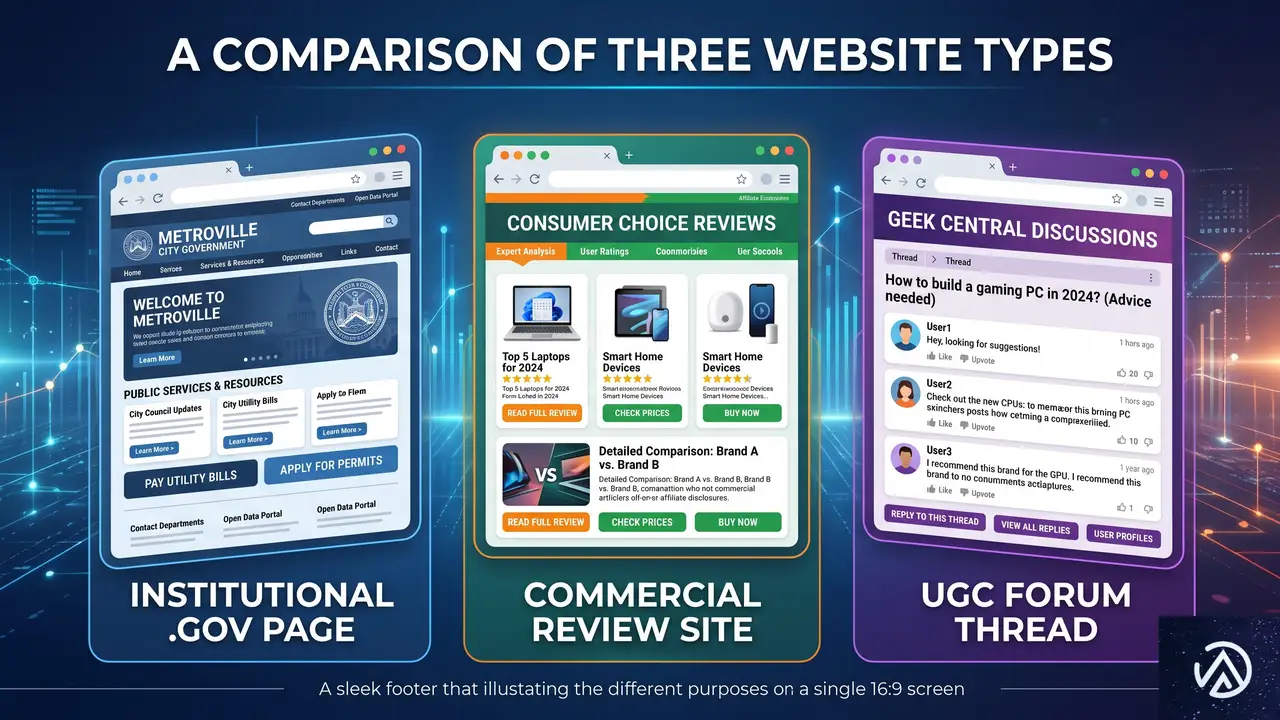
BrightEdgeは引用されたサイトを3つのカテゴリに分類した。政府や教育機関、大企業のサイトを含む「機関系サイト」、メディアやレビューサイト、リスティングを含む「商業・編集系サイト」、そしてフォーラムや動画プラットフォームなどの「UGC(User Generated Content / ユーザー生成コンテンツ)」だ。
分析の結果、すべてのAIエンジンがこれら3つを情報源として使っているが、そのバランスには大きな差があることが判明した。機関系サイトの引用率は低いエンジンで10%、高いエンジンで26%。UGCの引用率に至っては、わずか0.2%から18%まで開いている。
最も引用率が高いのは商業・編集系サイトで、AI Overviewsが51%、Geminiでも37%と、どのエンジンでも大きな割合を占める。BrightEdgeはこの結果を受け、「レビューサイト、比較コンテンツ、業界メディア、小売のリスティング、財務データがAIに最もよく参照される」とまとめている。企業はパブリックリレーションズ(PR)活動、業界メディアへの露出、カテゴリ比較コンテンツへの投資が、単独のエンジンだけでなく全てのAI検索エンジンでの可視性向上につながると考えるべきだ。
GeminiとAI Overviewsで異なる「信頼のベクトル」
同じGoogleが提供するAIサービスでも、GeminiとAI Overviewsの間には明確な傾向の違いがある。Geminiは機関系サイトの引用率が26%と突出して高く、UGCは0.2%と極端に低い。つまり、権威ある公式情報を優先する「保守的なAI」といえる。.govドメインの引用率は13%、.orgは23%にのぼる。
一方、AI OverviewsはUGCの引用率が18%と5つのAIの中で最も高い。機関系サイトは10%と相対的に低く、コミュニティの声を積極的に拾う姿勢が見える。この違いは、AI Overviewsの基盤に「FastSearch」と呼ばれる速度優先の仕組みが使われている可能性を示唆するが、Googleから公式な説明はない。
実際の使用感を調べるため、Roger Montti氏が非公式な実験として、特定の電子部品(オペアンプ)の使用感を両方のAIに質問したところ、Geminiはメーカー公式サイトのみを引用したのに対し、AI Overviewsは公式情報に加えて複数のUGCを引用した。UGCには実際のユーザーによる測定データや比較情報が含まれており、質問の文脈によっては非常に有益だ。このことから、質問の種類やユーザーの目的によって、最適な情報源の組み合わせが変わるといえる。
ChatGPTとPerplexity、それぞれの選び方
ChatGPTは他のAIと比較して、引用ソースの多様性が最も高いというデータが出ている。上位10サイトが総引用に占める割合はわずか18.5%で、特定のサイトへの依存度が低い。対照的にPerplexityは26.7%、Geminiは26.3%と、ChatGPTの約1.5倍の集中度だ。
Perplexityは機関系サイトの引用率が22%と高く、.eduドメインも3.2%と他のAIより多く引用している。BrightEdgeのレポートによれば、Perplexityの引用の約30%は医療機関、政府、百科事典、医学出版社のサイトで占められている。つまり、Perplexityは「権威性」を重視するエンジンと位置づけられる。
興味深いのは、.eduドメイン(教育機関のサイト)の扱いだ。SEOコミュニティでは長らく「.eduサイトは権威性が高い」という信念があったが、今回の調査では、いずれのAIも.eduサイトをさほど引用していない。最も高いPerplexityですら3.2%に過ぎず、ユーザーがAIに尋ねる多くの質問において、.eduサイトは権威ある情報源として選ばれにくい現実が明らかになった。
同じGoogleでも異なるAI、3系統の使い分け
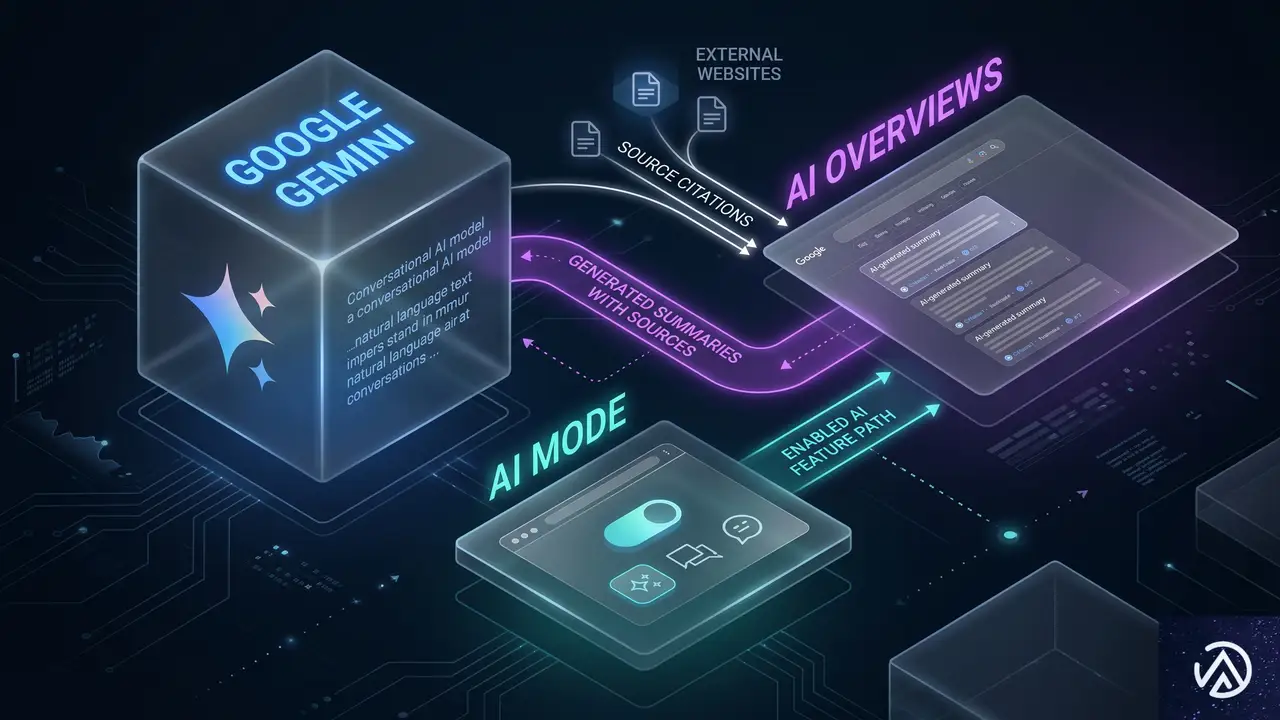
GoogleにはGemini、AI Overviews、AI Modeという3つのAI検索サービスが存在するが、これらは同じ会社のプロダクトでありながら、引用傾向は一様ではない。最もサイト重複率が高いAI OverviewsとAI Modeですら一致率は59%で、GeminiとなるとAI Overviewsとの重複率は34%、AI Modeとは27%まで下がる。
このデータから、「Google AIは単一のシステムではない」という現実が浮かび上がる。各サービスは異なるアルゴリズムやデータセットに基づいて情報を選択しており、同じ質問でも表示される情報源が大きく変わる可能性がある。ウェブサイト運営者にとっては、「Google対策」という単一の施策ではなく、どのAI検索面をターゲットにするかを明確にした戦略立案が求められる。
AIエンジンに選ばれるサイトになるための実践論点
今回の調査データを踏まえると、AI検索エンジンでの可視性を高めるための方針が見えてくる。すべてのエンジンに共通して効くのは、製品やサービスとブランドの結びつきを強化することだ。具体的には、業界メディアやレビューサイトでの記事露出、比較コンテンツへの掲載、プレスリリースの配信などが有効な手段になる。
一方で、AIごとの特性に合わせた対策も検討すべきだ。GeminiやPerplexityでの露出を狙うなら、公的機関や業界団体との協業、公式データの公開、学術的な裏付けの提示といった「権威性」の構築が重要になる。AI Overviewsを意識するなら、フォーラムやコミュニティでの自然な言及、ユーザーレビューの充実といったUGCの活性化も効果が見込める。
また、AI検索は信頼できるウェブサイトに掲載されたスポンサード記事(広告であることが明示された記事)も情報源として引用する。FTC(米国連邦取引委員会)のネイティブ広告ガイドラインや、Googleのスポンサード投稿ポリシーに準拠した形でブランドを訴求する手法も、引き続き検討に値する。
重要なのは、どのAIに最適化するかではなく、自社のブランドがどのカテゴリの情報として認識されるかを設計することだ。AIに「選ばれる」サイトになるには、単なるSEOテクニックではなく、実体のあるブランド価値の醸成と、それを多様なメディアに拡散させる情報戦略が欠かせない。
この記事のポイント
- AI検索エンジン5つのソース重複率は最低16%から最高59%で、引用傾向に大きな差がある
- ブランド名の重複率は最低36%と、製品・サービスに結びついたブランドは横断的に強い
- 商業・編集系サイトが最も多く引用され、PRや比較コンテンツの重要性が高まっている
- Geminiは権威性重視、AI OverviewsはUGC重視と、同じGoogle内でも戦略が異なる
- AI時代のSEOでは、個別のエンジン対策よりブランド価値の醸成と多面的な情報発信が鍵を握る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

ChatGPTでWooCommerce商品を販売する方法!最新のショッピング機能を導入する全手順
ChatGPTのチャット画面の中で、ユーザーが直接商品を探して購入できる機能が注目を集めている。ユーザーが「4,000円以下の青いヨガマットが欲しい」と入力すると、ChatGPTが登録された店舗から実際の商品を提案し、価格や在庫状況まで表示する仕組みだ。
これは「Agentic Commerce(エージェンティック・コマース)」と呼ばれる新しい販売チャネルだが、多くのWooCommerce運営者は自分の商品をどうやって掲載すればよいか分からずにいる。OpenAIは2025年後半にマーチャントプログラムを開始しており、先行して対応することで競合に差をつけることが可能だ。
この記事では、WooCommerceの商品をChatGPTの検索結果に表示させるための具体的な手順を解説する。OpenAIへのマーチャント登録から、AIが読み取りやすい商品フィードの作成、そして承認を得るためのポイントまでを詳しく見ていこう。
ChatGPT Agentic Commerceとは何か

ChatGPT Agentic Commerce(またはChatGPT Shopping)は、ユーザーがChatGPTとの会話を通じて商品を発見し、そのまま販売元のショップへ移動して購入できる機能だ。従来の検索エンジンとは異なり、AIがユーザーの意図を深く理解した上で、最適な商品を「推薦」してくれるのが特徴である。
この仕組みを支えているのが、ACP(Agentic Commerce Protocol)というプロトコルだ。これはWooCommerceなどのECサイトとChatGPTのショッピング層を接続するための規格である。ChatGPTはこのプロトコルを通じてショップの商品フィードを読み取り、内容を理解して会話の中に反映させる。
上記のように、AIがコンシェルジュのように振る舞うことで、購入意欲の高いユーザーを直接ショップへ誘導できる。ユーザーはショップの決済画面で最終的な購入手続きを行うため、顧客データやブランドのつながりはショップ側が保持し続けられる点も大きなメリットだ。
なぜChatGPTで販売すべきなのか
最大の理由は、購買意欲が非常に高いタイミングでユーザーに接触できることだ。特定の悩みや要望をAIに相談しているユーザーに対し、解決策として自社商品を提示できるため、成約率が高まりやすい。また、AI向けに整理されたデータ(構造化データ)を提供することは、将来的なAI検索最適化(AEO)にもつながる。
さらに、ChatGPTから直接自社サイトへ送客されるため、メールマガジンの登録を促したり、関連商品をアップセルしたりといった従来のマーケティング施策もそのまま活用できる。プラットフォームに完全に依存するのではなく、集客の入り口としてAIを活用する形になるからだ。
準備すべきものと商品識別コードの重要性

ChatGPTに商品を掲載するためには、正確な商品データが必要不可欠だ。特に多くのWooCommerce運営者がつまずきやすいのが、GTIN(国際取引商品番号)やMPN(製造者パーツ番号)といった識別コードの設定である。OpenAIは、フィード内の各商品にこれらの一意の識別子が含まれていることを求めている。
GTINには、バーコードでおなじみのJANコード(日本)やEANコード、書籍に使われるISBNなどが含まれる。他社ブランドの商品を転売している場合は、パッケージやメーカーサイトでこれらの番号を確認できる。自社製品の場合は、独自に管理番号(MPN)を割り当てる必要がある。
世界共通のバーコード番号。転売品や一般流通品に必須。
製造者が独自に付ける型番。自社製品やハンドメイド品で使用。
書籍専用の国際標準図書番号。
WooCommerceの標準機能では、SKU(在庫管理単位)を入力する欄はあるが、GTIN専用の入力欄が不足している場合がある。その場合は、プラグインを使用して項目を追加するか、SKU欄をMPNとして代用することになる。商品数が多い場合は、CSVファイルで一括エクスポートし、表計算ソフトで番号を入力してから再インポートする方法が効率的だ。
ハンドメイドや一点物の扱いはどうなるか
独自の商品を作っている場合、GTINを持っていないことも多いだろう。その場合は、自分たちで一貫したフォーマットのMPNを作成すればよい。例えば「SHOPNAME-ITEM-001」のような形式で、重複しない番号を各商品に割り当てる。これにより、AIはそれぞれのアイテムを個別の商品として認識できるようになる。
ChatGPT向け商品フィードの作成手順

OpenAIの仕様に適合した商品フィードを作成するには、専用のプラグインを活用するのが最も確実だ。WP Beginnerの著者によれば、この用途で特に実績があるのは「Product Feed Pro by AdTribes」だという。このプラグインはOpenAI専用の出力フォーマットをサポートしており、設定が容易だ。
まず、プラグインをインストールして有効化したら、ライセンスキーを入力する。その後、管理画面の「Create Feed」から新しいフィードの作成を開始する。ここで、チャンネルの選択肢から「OpenAI Product Feed」を選ぶのがポイントだ。
出力形式とフィールドマッピングの設定
ファイル形式については、OpenAIが推奨している「JSONL(JSON Lines)」を選択しよう。これは各行が独立したJSONオブジェクトになっている形式で、大量のデータを効率的に処理できる特徴がある。次に、フィールドマッピングの画面で、WooCommerceの各項目がOpenAIの属性と正しく結びついているか確認する。
通常、商品名や説明文、価格などは自動で紐付けられるが、先ほど準備したGTINやMPNが正しくマッピングされているかは入念にチェックすべきだ。もし独自のカスタムフィールドを使っている場合は、手動でマッピングを追加することも可能である。設定が完了したら「Generate Product Feed」をクリックしてフィードを生成する。
トラッキング設定で効果を測定する
フィードを生成する際、GoogleアナリティクスのUTMパラメータを有効にしておくことをおすすめする。これにより、ChatGPT経由でどれくらいのユーザーが流入し、実際に購入に至ったかを正確に把握できるようになる。AIチャネルがどれだけ利益に貢献しているかを可視化することは、今後の戦略立案において非常に重要だ。
OpenAIへの申請とフィードの送信

フィードの準備ができたら、OpenAIのマーチャントポータルから登録申請を行う。ビジネスの詳細や販売している商品のカテゴリー、対象地域などを入力して送信する。申請後、OpenAIによる審査が行われるが、この期間は数日から数週間かかる場合があると言われている。現在は米国から順次拡大中だが、早めに列に並んでおくことが得策だ。
審査を通過すると、商品フィードのURLを提出するための案内が届く。WooCommerceの管理画面からコピーしたフィードのURLを送信すると、自動検証プロセスが開始される。通常、24時間から48時間以内に検証結果が判明し、問題がなければChatGPTの検索結果に商品が表示され始める仕組みだ。
よくあるエラーと解決策
フィードの検証でエラーが出る場合、その原因の多くはデータの不備にある。WP Beginnerの記事では、よくある問題として「GTINの欠落」「価格フォーマットの誤り(通貨コードが含まれていないなど)」「商品画像が小さすぎる、またはサポートされていない形式である」といった点が挙げられている。
検証ツールが指摘した箇所を修正し、プラグインでフィードを再生成してから再提出しよう。特に画像については、AIが視覚的に商品を理解するためにも、高解像度でクリアなものを用意することが推奨される。一度承認されれば、あとは商品の在庫状況や価格変更が自動的にフィードに反映され、ChatGPT側の情報も更新されるようになる。
独自の分析:AI検索時代のEC戦略

今回のChatGPT連携は、単なる「新しい広告枠」以上の意味を持っている。これまでのSEO(検索エンジン最適化)が「キーワード」を重視していたのに対し、Agentic Commerceでは「データの構造化」と「文脈の理解」が鍵となる。AIが商品を正しく理解できるように情報を提供することは、もはやオプションではなく必須のスキルになりつつある。
また、この変化は中小規模のショップにとって大きなチャンスだ。巨大なモールの中で価格競争に巻き込まれるのではなく、AIが「このユーザーの悩みを解決するには、このショップのこの商品がベストだ」と判断してくれれば、ブランドの知名度が低くても選ばれる可能性があるからだ。そのためには、商品タイトルや説明文を、人間だけでなくAIにとっても分かりやすく、詳細に記述する努力が求められる。
今後はChatGPTだけでなく、Googleの「AI Overviews」や他のAIエージェントも同様の仕組みを取り入れていくだろう。今のうちにWooCommerceで商品データを整理し、外部プラットフォームへ高品質なフィードを提供できる体制を整えておくことは、数年後のショップの生存を左右する重要な投資になるはずだ。
この記事のポイント
- ChatGPT Agentic Commerceにより、チャット内での商品検索と提案が可能になった
- 掲載にはOpenAIのマーチャント登録と、GTIN/MPNを含む正確な商品データが必要である
- 専用プラグインを使用して、OpenAI推奨のJSONL形式で商品フィードを作成する
- フィードURLを提出し、自動検証をパスすることでChatGPTに商品が表示されるようになる
- AI向けにデータを最適化することは、将来的なAI検索(AEO)対策としても非常に有効である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
検索エンジンシェア2026:Google一強の変容とAI検索が変えるSEOの未来
検索エンジンの世界で、10年以上にわたり不動の地位を築いてきたGoogleのシェアに変化の兆しが見えている。2026年3月時点のデータによれば、Googleの世界シェアは90.01%となり、一時期は90%の大台を割り込む場面もあった。長らく「SEO=Google対策」という図式が続いてきたが、その前提が揺らぎ始めている。
この変化の背景には、ChatGPTやPerplexityといったAI検索ツールの急成長がある。さらに、商品の検索はAmazon、若年層のトレンド検索はTikTokといったように、特定の目的を持った検索行動が専門プラットフォームへ分散している点も見逃せない。従来の検索エンジンという枠組みを超えた、新しい集客戦略が求められている。
本記事では、2026年最新の検索エンジンシェアを紐解き、AI検索の台頭がSEOの実務にどのような影響を与えるのかを解説する。ウェブ担当者や制作エンジニアが、今後どのプラットフォームにリソースを割くべきかの判断材料として役立ててほしい。
Googleの現状:AI Overview(SGE)による検索体験の変容
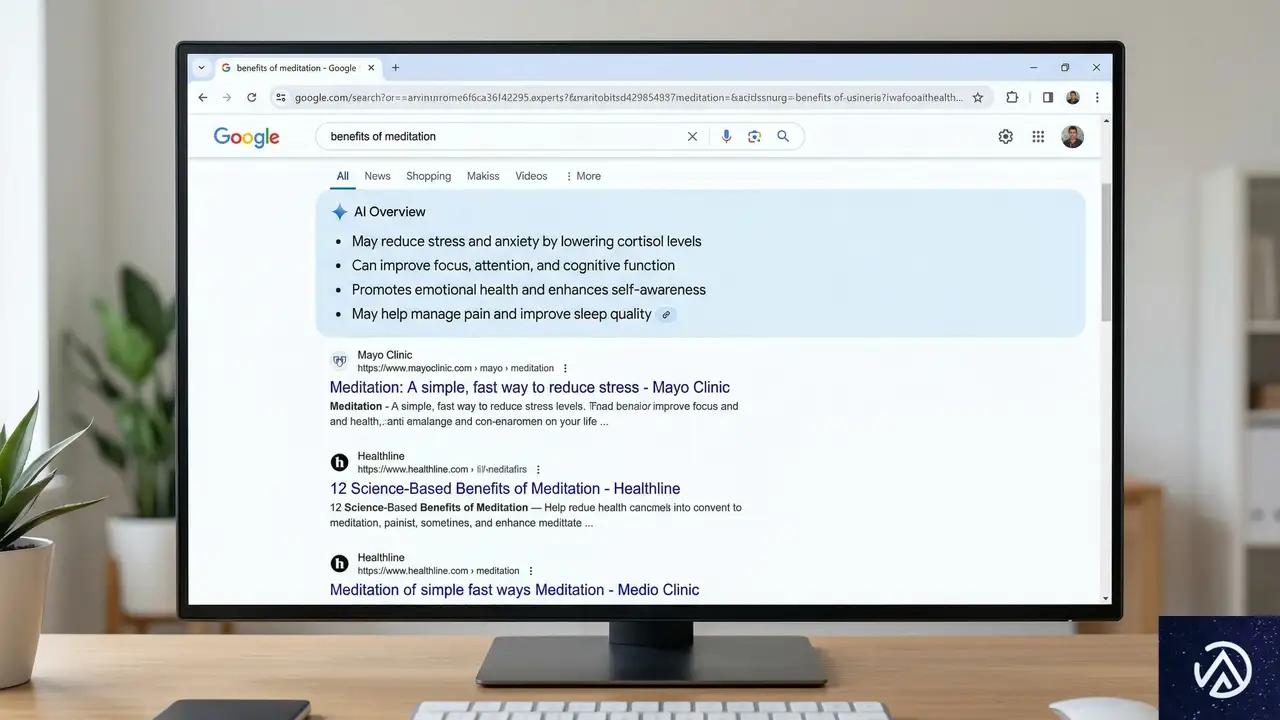
Googleは依然として検索市場の9割を支配するリーダーだ。StatCounterのデータによると、全世界の検索の10回に9回はGoogleで行われている。しかし、その内部構造はここ1年で劇的に変化した。最も大きな要因は、AI Overviews(AIによる概要回答)の全面的な展開である。
シェアの推移とデバイス別の特徴
Googleのシェアは2015年以降、約89%から93%の間で推移してきた。2024年末には3ヶ月連続で90%を下回り、2026年2月にも再び90%を切るなど、わずかながら低下傾向にある。特にデスクトップ市場ではGoogleのシェアは約82%まで下がり、代わりにMicrosoftのBingが10%を超えるシェアを獲得している。一方で、モバイル市場では94%以上という圧倒的な強さを維持しているのが特徴だ。
「ゼロクリック検索」への対策
AI Overviewsの普及により、ユーザーが検索結果画面(SERP)だけで疑問を解決し、外部サイトをクリックしない「ゼロクリック検索」が増加している。SERP(Search Engine Results Page)とは、検索ボタンを押した後に表示される結果一覧ページのことだ。従来の検索では1位のサイトをクリックするのが一般的だったが、現在はAIの回答や強調スニペット、ローカルパックなどが画面上部を占拠している。これにより、検索順位が上位であっても、必ずしもトラフィック(流入数)に結びつかないケースが増えている。
Bingと第2グループ:AI連携で存在感を増す競合たち
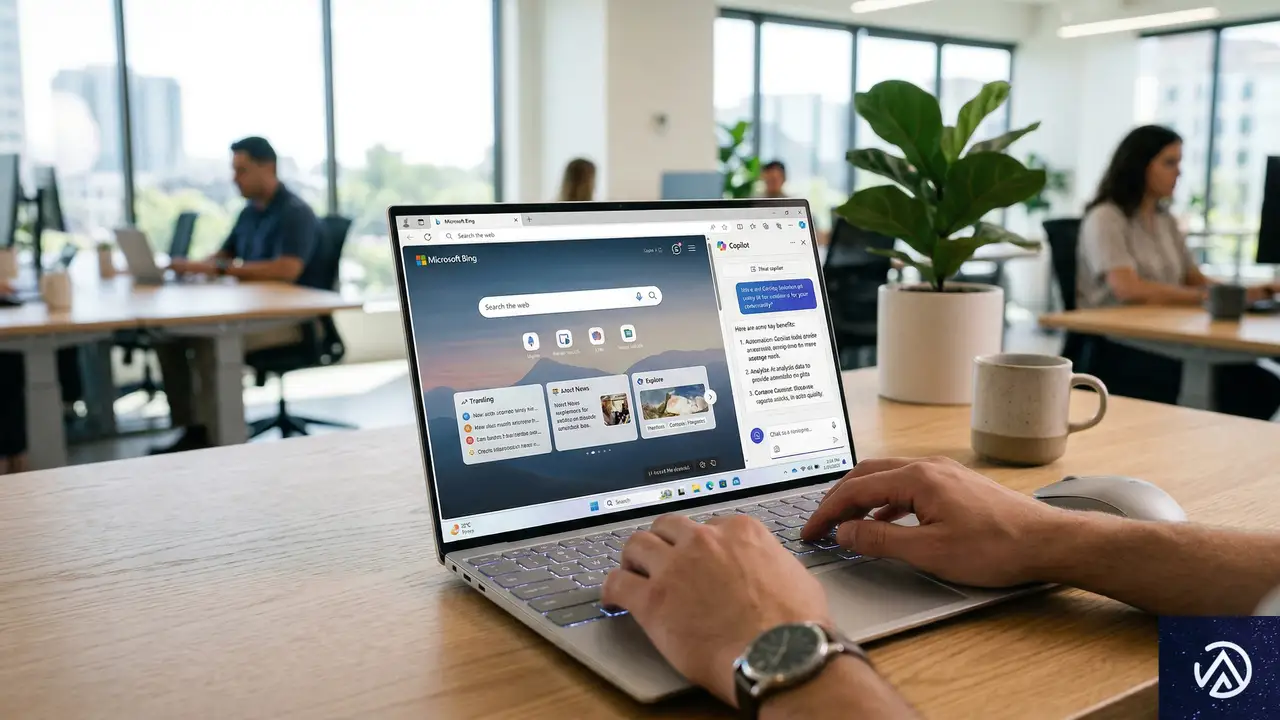
Googleの背後で、MicrosoftのBingが着実に存在感を高めている。グローバルシェアは5.01%と数字上は小さく見えるが、米国市場では10%を超え、デスクトップ環境では無視できない勢力となっている。
Bing:ChatGPTとの連携がもたらすメリット
Bingの成長を支えているのは、AIチャット機能「Copilot」の統合だ。戦略的に重要なのは、ChatGPTの検索機能がウェブ情報の取得にBingのインデックス(索引データ)を利用している点である。つまり、Bingでの評価を高めることは、ChatGPT経由での露出を増やすことにも直結する。競合がGoogle対策に集中している今、Bingへの最適化は比較的少ないコストで成果を出せる「穴場」の戦略と言える。
YahooとDuckDuckGo:特定の層に刺さるプラットフォーム
Yahooのグローバルシェアは1.39%だが、米国では2.86%を保持している。Yahooの検索エンジンはBingの技術を採用しているため、Bing向けの対策を行えば自動的にYahooユーザーにもリーチできる。一方、DuckDuckGoはシェア0.76%ながら、プライバシーを重視する層から根強い支持を得ている。ユーザーの行動を追跡しないという独自性が、GDPR(欧州一般データ保護規則)などのプライバシー規制が厳しい地域で評価されている。
AI検索エンジンの急成長:ChatGPTとPerplexityの影響
従来の検索エンジンシェアの数字には現れないが、ユーザーの検索行動を最も大きく変えているのがAI検索エンジンだ。OpenAIの報告によれば、ChatGPTの週間アクティブユーザー数は2026年2月時点で9億人に達した。これは2025年10月の8億人から数ヶ月で1億人増加した計算になる。
従来の検索と何が違うのか
AI検索の最大の特徴は、複数のリンクを提示するのではなく、情報を統合して「回答」を生成する点にある。ユーザーは対話を通じて情報を深掘りしたり、要約を求めたりできる。Perplexity(パープレキシティ)などのサービスも急成長しており、2025年5月には月間7億8,000万件のクエリ(検索要求)を処理している。これは前年同期の2億3,000万件から3倍以上の成長だ。
新たな手法「GEO(生成エンジン最適化)」の考え方
AI検索の台頭に伴い、SEO業界では「GEO(Generative Engine Optimization:生成エンジン最適化)」という新しい概念が登場している。これは、AIが回答を生成する際の「引用元」として選ばれるための施策だ。Conductorの調査によれば、ウェブ全体のトラフィックのうちAI経由の流入はまだ1.08%程度だが、その伸び率は極めて高い。正確なデータ構造、権威性のあるコンテンツ、そしてAIが理解しやすい論理的な文章構成が、今後の評価を左右することになる。
特定領域でGoogleを凌駕する「垂直検索」の勢力
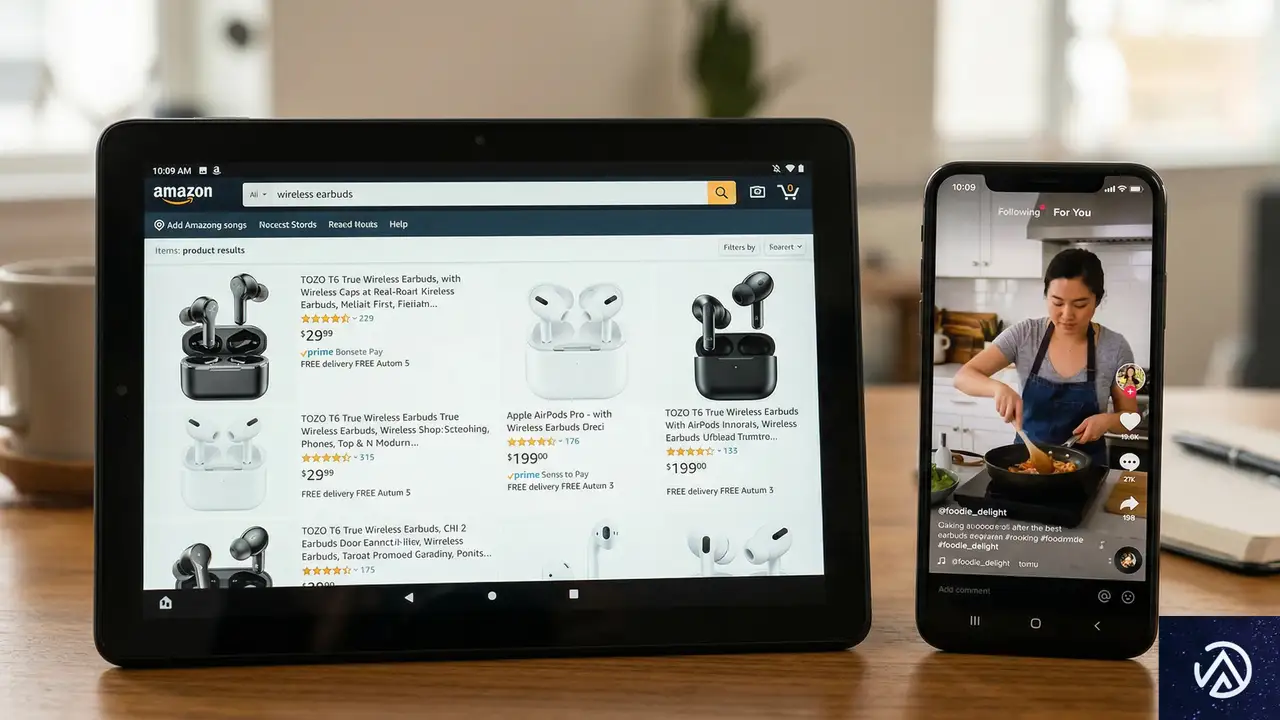
「何かを探す」という行為は、もはや汎用的な検索エンジンだけで完結しない。特定の目的に特化した「垂直検索」のプラットフォームが、Googleのシェアを実質的に削っている。
Amazon:EC検索の入り口としての地位
Jungle Scoutの調査によると、オンラインでの商品検索の56%は、GoogleではなくAmazonから直接始まっている。Amazonの検索アルゴリズム(A10と呼ばれることもある)は、購入意向の強さを重視する。商品の販売実績やレビュー、在庫状況がランキングに大きく影響するため、物販を行う企業にとってAmazon内でのSEOは、Google対策と同等かそれ以上に重要だ。
TikTok:若年層の「発見」を支えるアルゴリズム
若年層にとって、TikTokは検索ツールとしての役割を強めている。飲食店や旅行先、コスメのレビューなどを探す際、テキストではなく動画での「リアルな体験」を求める傾向がある。TikTokの検索はキーワードの一致よりも、ユーザーのエンゲージメント(反応)を重視する。従来のSEOが「答え」を提示するものだったのに対し、TikTokでの最適化は「発見」されるためのフック(引き)を作ることが中心となる。
2026年以降のSEO戦略:分散投資とAI対応の最適解
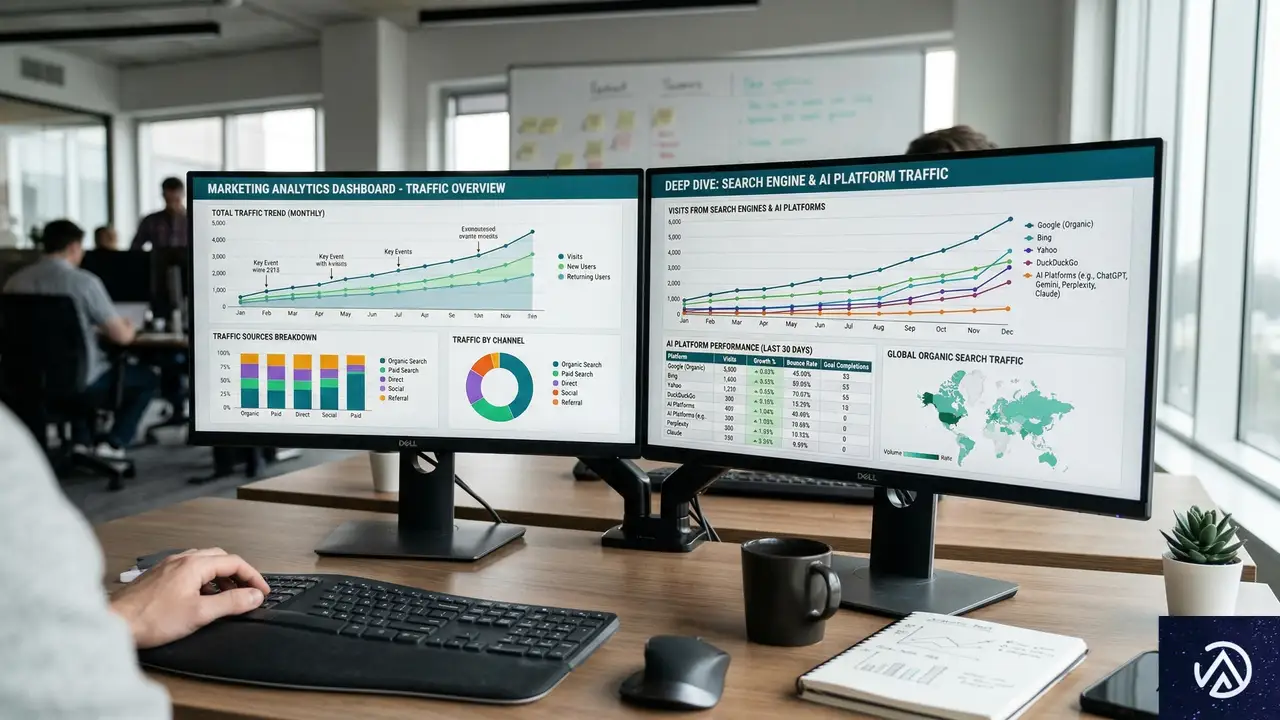
Search Engine Journalの記事が指摘するように、単一の検索エンジンだけに依存する時代は終わった。これからのSEO戦略には、以下の3つの視点が必要だ。
第一に、Google内での「AI露出」を狙うことだ。AI Overviewsに引用されるためには、単なるキーワード対策ではなく、トピックに対する網羅的で信頼性の高い回答を提示しなければならない。第二に、BingやChatGPTといったAIプラットフォームへの最適化だ。Bing Webmaster Toolsを活用し、サイトが正しくインデックスされているかを確認するだけでも、競合との差別化になる。
第三に、プラットフォームの使い分けだ。商品ならAmazon、ブランド認知ならTikTok、信頼性の構築なら自社ブログ(Google)というように、目的に応じてリソースを配分する必要がある。検索市場の変化は、ユーザーがより「自分に合った回答」を求めている証拠でもある。技術的なハックに頼るのではなく、ユーザーの検索意図に最も誠実に答えるコンテンツ作りが、結局はどのエンジンでも評価される近道だ。
この記事のポイント
- Googleのシェアは90.01%と依然として高いが、デスクトップでは低下傾向にある
- AI Overviewsの普及により、クリックを伴わない「ゼロクリック検索」への対策が急務となっている
- BingはChatGPTとの連携により、AI検索時代における重要なプラットフォームに浮上した
- ChatGPTやPerplexityなどのAI検索に対応する「GEO」という新しい最適化手法が注目されている
- AmazonやTikTokなど、検索エンジン以外のプラットフォームへの検索分散が進んでいる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験