

CloudflareがAI決済2製品をベータ公開、サイト運営者が知るべき課金モデルとは
CloudflareがAI決済分野で動きを加速させている。9月30日に2つの製品をベータへ移行した。Monetization GatewayとPay Per Useだ。いずれもサイト運営者がAIエージェントやAI企業から収益を得るための仕組みである。
Monetization GatewayはAIエージェントからのリクエスト単位で課金する。Pay Per UseはAI企業がコンテンツを使用した際にパブリッシャーへ支払う。どちらも現在は米国拠点の利用者に限定したクローズドベータだ。
AI検索の普及でコンテンツの無断利用が問題視される中、この発表はサイト運営者にとって新たな収益化の選択肢となる。本記事では仕組みと実務への影響を解説する。
CloudflareがAI決済製品をベータ公開、収益化の選択肢が拡大
この比較図は3つの支払いモデルの課金タイミングを示している。縦に並んだ各モデルは、それぞれ異なる課金ポイントを持つ。
Cloudflareは7月1日にMonetization Gatewayを発表し、順番待ちリストを開設していた。今回のベータ移行で実際の利用が始まった形だ。Pay Per Useも同じくベータ段階に入っている。
3つの支払いモデルが揃った
Cloudflareが提供するAI関連の支払いモデルはこれで3つになった。既存のPay Per Crawlに加え、今回の2製品が加わった。それぞれ課金のタイミングと主体が異なる。
- Pay Per Crawlはクローラーがアクセスした時点でサイト所有者が設定した料金を支払う
- Monetization GatewayはAIエージェントからのリクエストごとに売り手が設定した料金を請求する
- Pay Per UseはAI企業がコンテンツを使用したと報告した時点でAI企業が設定した料金をパブリッシャーに支払う
この3モデルを理解すると、AI時代のコンテンツ課金の全体像が見えてくる。
Monetization Gatewayの仕組み
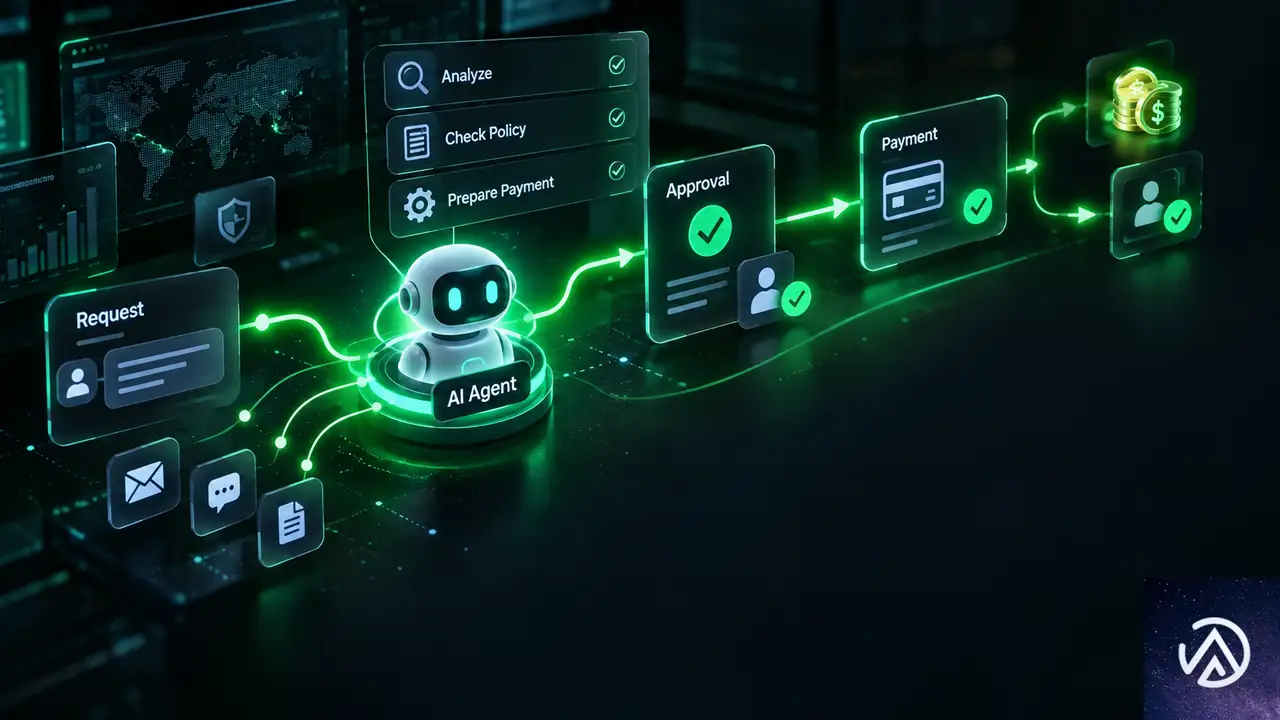
このフロー図はMonetization Gatewayの処理手順を示している。支払いが完了するまでコンテンツは提供されない。
Monetization GatewayはAIエージェントに対してリクエスト単位で課金する仕組みだ。API、MCPツール、データセット、サイトなど、リクエストがあるたびに使用が発生するリソース向けに設計されている。MCPツールとは、AIアシスタントが外部の機能を呼び出すための標準規格Model Context Protocolに対応したツールを指す。
リクエスト単位の課金フロー
このゲートウェイはx402プロトコルとHTTP 402 Payment Requiredステータスコードを使用する。x402プロトコルは、HTTP 402を利用した機械支払いのための規約だ。人間の介入なしにAIエージェント同士が支払いを処理できるよう設計されている。
HTTP 402は「支払いが必要」という意味のレスポンスコードだ。AIエージェントが保護されたリソースへアクセスすると、まず支払い条件を受け取り、支払い承認に署名してから再試行する。支払いはこのリクエスト内で処理され、売り手のサーバーが応答する前に検証される。つまり、支払いが確認できなければコンテンツは提供されない仕組みだ。
料金設定は固定と変動の2種類から選べる。固定価格は入力が同じなら常に同じ料金になる。変動価格は上限額を設定し、実際の使用量に応じて売り手側が請求額を報告する。決済は1回0.001ドルから100ドルまで対応する。
支払い処理にはUSDCステーブルコインを採用した。Baseブロックチェーン上でCoinbaseのx402 Facilitatorを経由する。将来的には他の支払い方法も追加する予定だ。
導入に必要な条件
現在はクローズドベータのため、利用するには条件がある。売り手と買い手の双方が米国に拠点を置く必要がある。売り手側はクレジットカードの登録、確認済みメールアドレス、開設から60日以上経過したアカウントが求められる。
さらにサイトがCloudflare経由でプロキシされており、作成から30日以上経過していること、ゾーンのセキュリティチェックを通過することが条件だ。アクセス申請はダッシュボードから行う。
4つのライブ実装も公表されている。Ceramic.aiはエージェント向けのWeb検索APIを固定価格で提供する。AI Gatewayは4つのオープンモデルで推論リクエストごとの支払いを受け付ける。Stocktwitsは市場シグナルをリクエスト単位で課金する。API2PDFはリクエストの計算量と帯域幅に基づく変動価格でPDF生成APIを提供する。
API2PDFの事例は示唆的だ。初月無料の後にクレジットカードを要求すると変換率が50%以上低下したという。AIエージェント向けの決済はスムーズさが重要だと示している。
Pay Per Useの仕組み
このフロー図はPay Per Useの役割分担を示している。AI企業が使用を報告し、Cloudflareが照合してパブリッシャーへ支払う流れだ。
Pay Per Useは別のアプローチを取る。パブリッシャーがコンテンツを提供し、AI企業がそのコンテンツを使用したと報告した場合に、AI企業からパブリッシャーへ支払いが発生する。
使用報告の流れ
役割分担は明確だ。AI企業が支払う用途と価格を定義する。パブリッシャーは提示されたオファーを承認するか拒否するかを決める。承認後は自分のコンテンツがどれだけ使われ、いくら稼いだかを確認できる。Cloudflareは登録、使用記録、請求、支払いを担当する。
使用の記録はAI企業側が自己申告する。タイムスタンプ、ソースURL、イベントIDを報告し、Cloudflareが各使用報告が登録済みパブリッシャーのものか照合する。そこから買い手に請求し、毎月パブリッシャーへ支払う流れだ。
ベータ期間中、Cloudflareは個々の買い手および参加を選択したパブリッシャーと直接連携している。買い手の企業名はまだ公表されていない。
パブリッシャーが注意すべき点
Pay Per UseではAI企業が使用用途と価格を設定する。パブリッシャーはオファーを承認するか否かの判断のみで、価格交渉はできない。また、使用データは買い手の報告に依存するため、実際の使用頻度との乖離があり得る。
各プログラムの規約には、AI企業がコンテンツをどう扱えるか、学習用途の制限なども含まれる。参加前に規約を確認する必要がある。
サイト運営者への実務的な影響
これら2製品は、AIエージェントの台頭でコンテンツ収益が脅かされているサイト運営者に新たな選択肢をもたらす。特にMonetization GatewayはAPIやデータセットを提供する事業者との相性が良い。Pay Per Useはコンテンツメディア向けだ。
SEO観点での評価
SEO対策の観点では、AI検索エンジンがコンテンツを読み取る動きが加速する中、その利用に対して対価を求める仕組みが整ってきた点が重要だ。これまで無断でクロールされ、引用される一方だったパブリッシャーに交渉の余地が生まれる。
ただし現段階では取引件数や支払い実績は公表されていない。収益化の効果を実証するデータはまだない。ベータ期間中の成果報告が待たれる。
導入を検討する際のチェックポイント
現時点で導入できるのは米国拠点の事業者に限られる。日本からはまだ利用できない。地理的な拡大は予告されているが、時期は明らかではない。まずは動向を追い、仕組みを理解しておくことが現実的だ。
- 自社コンテンツがAIエージェントに利用される頻度を把握する
- Pay Per Crawl、Gateway、Pay Per Useの違いを理解する
- Cloudflareを利用しているか、利用予定があるか確認する
- ベータが日本に開放された際にすぐ試せるよう準備する
今後の展開と注目ポイント
CloudflareはPay Per Useのベータで、パブリッシャーが買い手の提示価格に対抗してカウンターオファーを出したり、用途別に異なる料金を設定したりする方法を模索している。
また、Pay Per Useで購入するAI企業の社名が公表されるかも注目点だ。Gatewayについては新たな地域への対応が予告されている。日本からの利用開始時期も気になるところだ。
AIエージェント経済のインフラが整いつつある。サイト運営者はこの変化を収益化のチャンスと捉え、早期に情報をキャッチアップしておくべきだ。
この記事のポイント
- Cloudflareが2つのAI決済製品をベータ公開した
- Monetization Gatewayはリクエスト単位でAIエージェントに課金する
- Pay Per UseはAI企業の使用報告に基づきパブリッシャーへ支払う
- どちらも現段階では米国拠点の限定ベータである
- AI時代のコンテンツ収益化に新たな選択肢が加わった

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareがrobots.txtを自動生成するBot Preference Syncの仕組みと検証
Cloudflareが2026年8月21日、サイトのrobots.txtを自動生成する新機能「Bot Preference Sync」を発表した。Search、Agent、Trainingの3つのカテゴリ設定から、Cloudflareがrobots.txtの該当部分を自動的に書き換える仕組みだ。robots.txtとエッジ強制設定の矛盾を解消すると期待される。
この機能は無料プランから利用でき、新規顧客にはデフォルトでオンになる予定だ。一方でカテゴリ単位の設定には粗さがあり、個別クローラー単位のビジネス判断を表現できないという課題もある。本記事では機能の仕組みと限界、サイト運営者が取るべき対応を検証する。
robots.txtとエッジ強制の矛盾が生んだ新機能
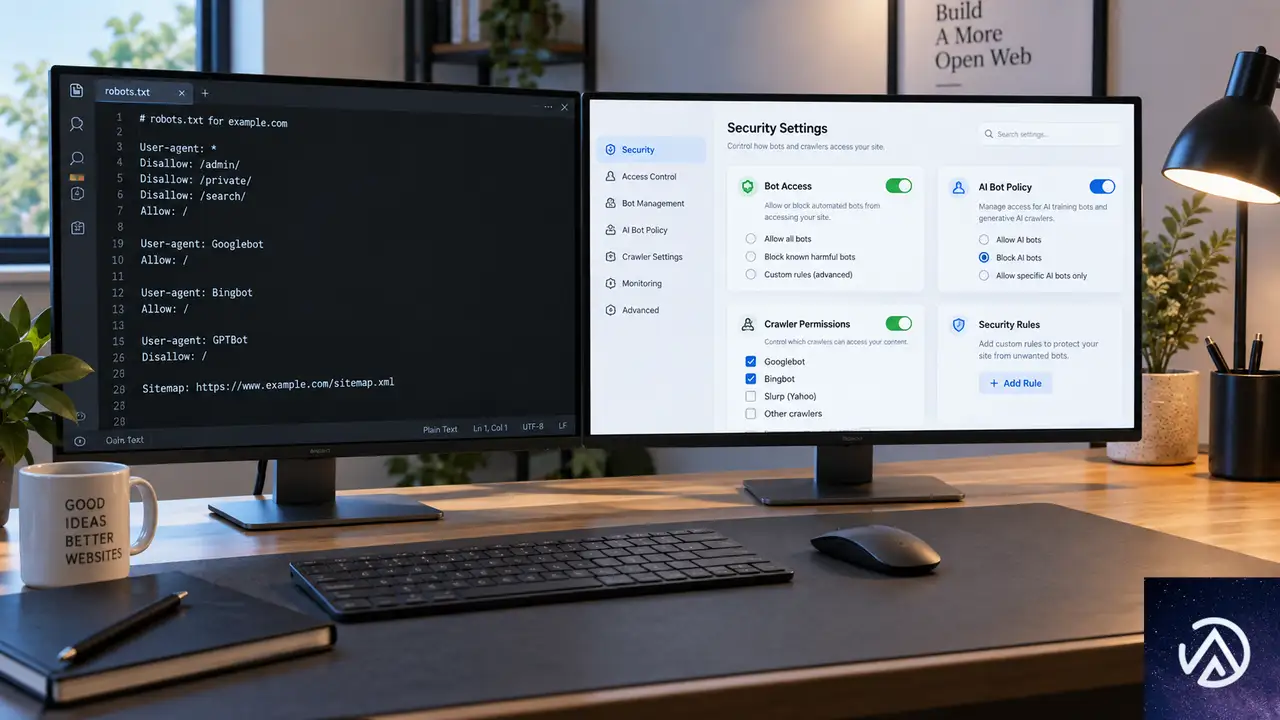
Webサイトのクローラーポリシーは2つの場所で管理される。1つはrobots.txtファイル、もう1つはWAFやCDNのエッジ側で動作するブロック設定だ。robots.txtはテキストファイルであり、クローラーへのリクエスト(お願い)を記述する。エッジ強制設定はダッシュボードで操作し、実際にHTTPリクエストを拒否する。
この2つは別々の場所で管理されるため、時間とともに矛盾が生じやすい。robots.txtは一度作成すると放置されがちで、エッジ設定は後から変更されることが多い。No Hacksの記事は、運営者自身のサイトでこの問題が発生していた例を報告している。robots.txtではBytespiderを許可する記述が数ヶ月間残っており、意図しないクローラーを歓迎する状態だったという。
CloudflareのBot Preference Syncは、この矛盾を自動的に解消する。ダッシュボードで設定したAIボットポリシーをrobots.txtに反映し、エッジ強制設定との乖離を防ぐ。Cloudflareがrobots.txtを書くという行為は、サイト運営者の代わりにポリシーを文書化することでもある。
Bot Preference Syncの仕組みと3つのカテゴリ設定
Bot Preference Syncは、セキュリティ設定の「AIボットポリシー」で設定した内容をrobots.txtに変換する。設定項目はSearch(検索)、Agent(エージェント)、Training(トレーニング)の3カテゴリだ。各カテゴリには「全ページでブロック」「広告表示ページのみブロック」「許可」の選択肢がある。
生成されたrobots.txtには、Cloudflare Bot Preference Syncの開始マーカーと終了マーカーが付与される。既存のrobots.txtコンテンツはその下に保持される。つまりCloudflareが書き込むのはマーカーの間の部分だけで、サイト運営者が手動で書いた部分は残る仕組みだ。
Bot Preference Syncは設定をrobots.txtへ反映する一連の流れを自動化する。
Cloudflareの発表によると、この機能は無料プランから利用可能で、新規顧客にはデフォルトでオンになる。ただし2026年9月13日時点では、Bot Preference Syncの公式Changelogへの記載がなく、Cloudflareのボットドキュメントにも言及がない。また一部のサイトではrobots.txtに生成ブロックがまだ現れていない。本記事は発表内容に基づく検証となる。
カテゴリ単位の設定では表現できない個別ポリシー
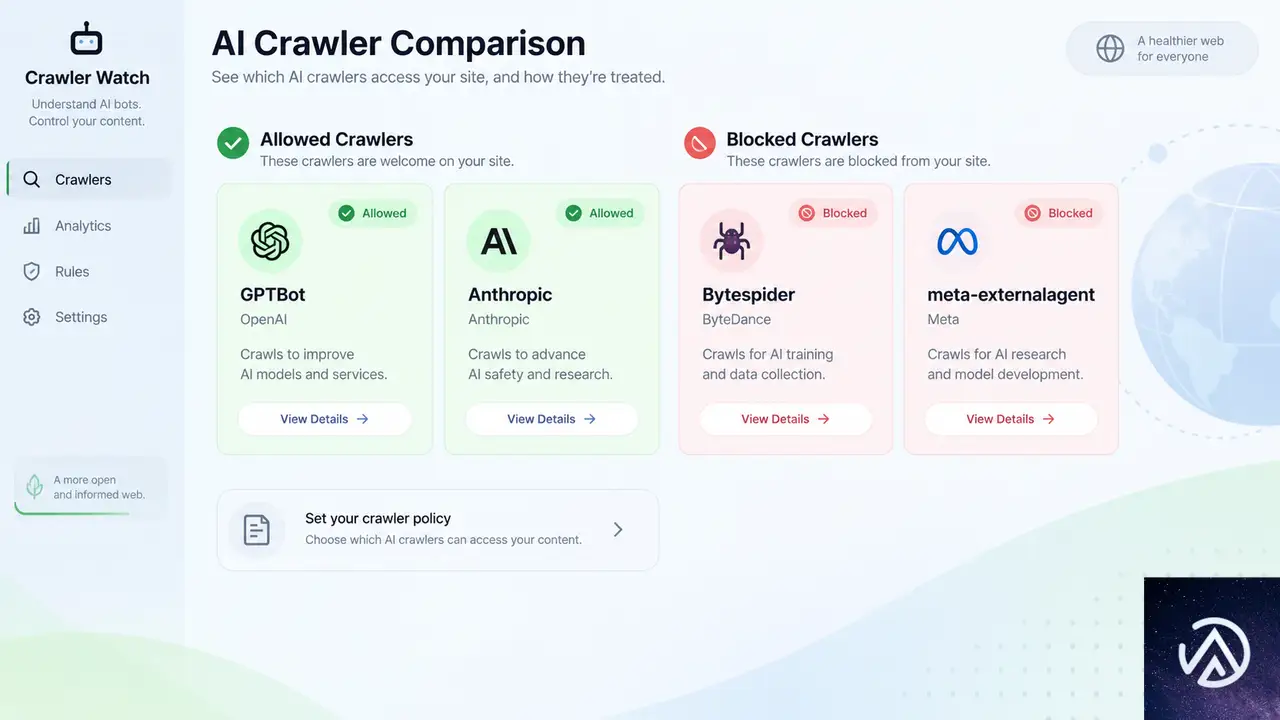
Bot Preference Syncの3カテゴリ設定は、サイト運営者のビジネス判断を必ずしも表現できない。No Hacksの記事の運営者は、OpenAIのGPTBot、Anthropicのクローラー、PerplexityBotを許可し、Bytespiderとmeta-externalagentをブロックしている。この判断は企業ごとの見返りに基づく。前者は自社ページをアシスタントの回答に表示してくれるが、後者は何も返さない、という理由だ。
このポリシーを3カテゴリ設定で表現しようとすると、矛盾が生じる。Trainingをブロックに設定すれば、許可したいGPTBotまでブロックされる。Trainingを許可に設定すれば、ブロックしたいBytespiderまで許可される。個別クローラー単位のビジネス上の決定は、カテゴリ単位の設定では表現できない。
個別クローラー単位のポリシーは3カテゴリ設定では表現できない。許可したいクローラーの扱いが、設定次第で逆転してしまう。
Cloudflareは、より細かい制御が必要な場合の対応策として、同期機能をオフにして手動でrobots.txtを管理することを挙げている。これはBot Preference Syncが万人向けではなく、カテゴリ単位の粗さを受け入れられるサイトに向けた機能だということを示している。
独自の見解として、日本のサイト運営者にもこの課題は当てはまる。コンテンツをAIトレーニングに提供する見返りを個別に評価している企業は、3カテゴリの設定では対応できない。Bot Preference Syncはあくまで「全許可」か「全拒否」に近いポリシーを持つサイト向けの省力化ツールと捉えるべきだ。
Cloudflareが公開した4つの開示条件とブロッキング
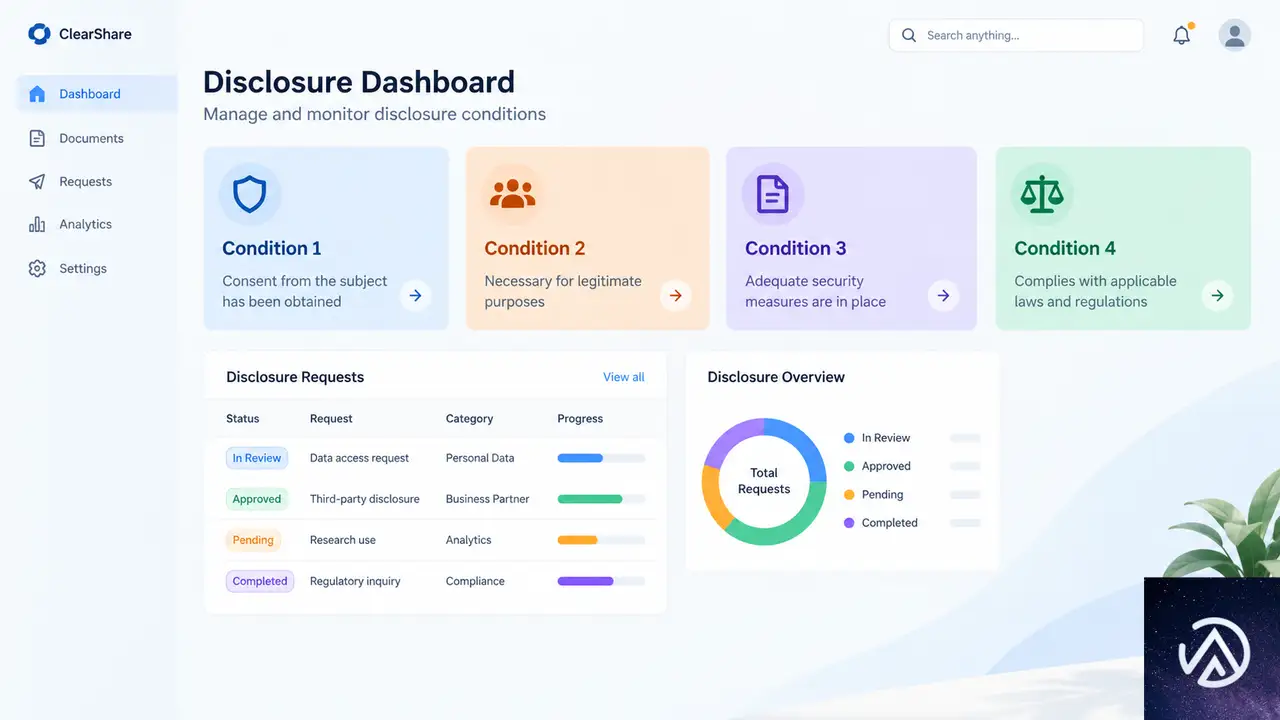
TrainingをDisallowに設定すると、robots.txtにno-training行が書き込まれる。同時に、Cloudflareが「不透明」と判断したAIクローラーがブロックされる。Cloudflareはこのブロックを回避するために、クローラーが満たすべき4つの条件を公開している。
4つの条件を満たさないクローラーは不透明とみなされ、TrainingをDisallowに設定したサイトではブロック対象となる。
条件2と条件4はGoogleを記述している。条件4についてGoogleはすでに満たしている。Googleのクローラードキュメントは、Google-ExtendedがGeminiモデルのトレーニングを制御し、検索結果への掲載やランキングシグナルには影響しないと明記している。これは条件4が求める公開声明に該当する。
一方で条件2はGoogleが答えを持っていない。条件2はAIサマリーからオプトアウトする方法を求めている。GoogleのAI機能のドキュメントによると、AI概要から除外するにはnosnippet、data-nosnippet、max-snippet、noindexのいずれかを使うことになる。しかし、これらはすべて通常の検索表示にも影響する。AI概要だけから外れて通常の検索スニペットは残す、という設定は存在しない。
Microsoftは2023年9月に条件2への回答を示している。NOARCHIVEタグを付けたコンテンツはBing Chatの回答に含まれないが、検索結果には引き続き表示される。検索インデックスから除外せず、チャットの回答からだけ除外できる仕組みだ。Cloudflareは2026年7月の記事で、BingBotとGooglebotを混合用途クローラーとしてこの条件の対象に挙げている。
CloudflareがAI企業への開示要求を明文化した点は評価できる。ただし、その条件を書いたのも執行するのもCloudflareという単一ベンダーだ。条件を読まずにダッシュボードのトグルをクリックしたサイト運営者も多い。パブリッシャーがAI企業に求めてきた説明責任は、いまやCloudflareにも向けられている。
新規顧客にデフォルト適用される意味とリスク
2026年9月15日から、Cloudflareは新規ドメインのデフォルト設定を変更する。広告を表示するページではTrainingとAgentがブロックされ、Searchは許可される。オンボーディング時に「広告付きページで収益化している」を選択すると、TrainingがDisallowに自動設定される。
これはビジネスモデルに関する質問であり、その回答がrobots.txt上のAIトレーニングに関する公開ポジションになる。広告収益に依存するサイトは、AIトレーニングを拒否する立場を自動的に表明することになる。サイト運営者がこの設定を認識していなければ、意図しないポジションが公開され続ける。
リスクが大きいのは、robots.txtを二度と開かず、自分の代わりに書かれたポジションを読まないサイトだ。Cloudflareはすでにアナリティクススクリプトを無料プランのサイトにデフォルトで書き込んでいる。同じオンデフォルトのパターンがrobots.txtにも及ぶ。サイト運営者が設定を確認しなければ、AIトレーニングに関する自社の立場を外部ベンダーに委ねることになる。
SEO担当者の観点では、このデフォルト変更を黙認してはいけない。自社サイトがAIトレーニングを拒否しているのか許可しているのかは、AI時代の検索戦略を左右する。デフォルト設定のまま放置するのではなく、自社のビジネスモデルに合わせて意図的に選択することが重要だ。
robots.txtが守れる範囲と守れない範囲
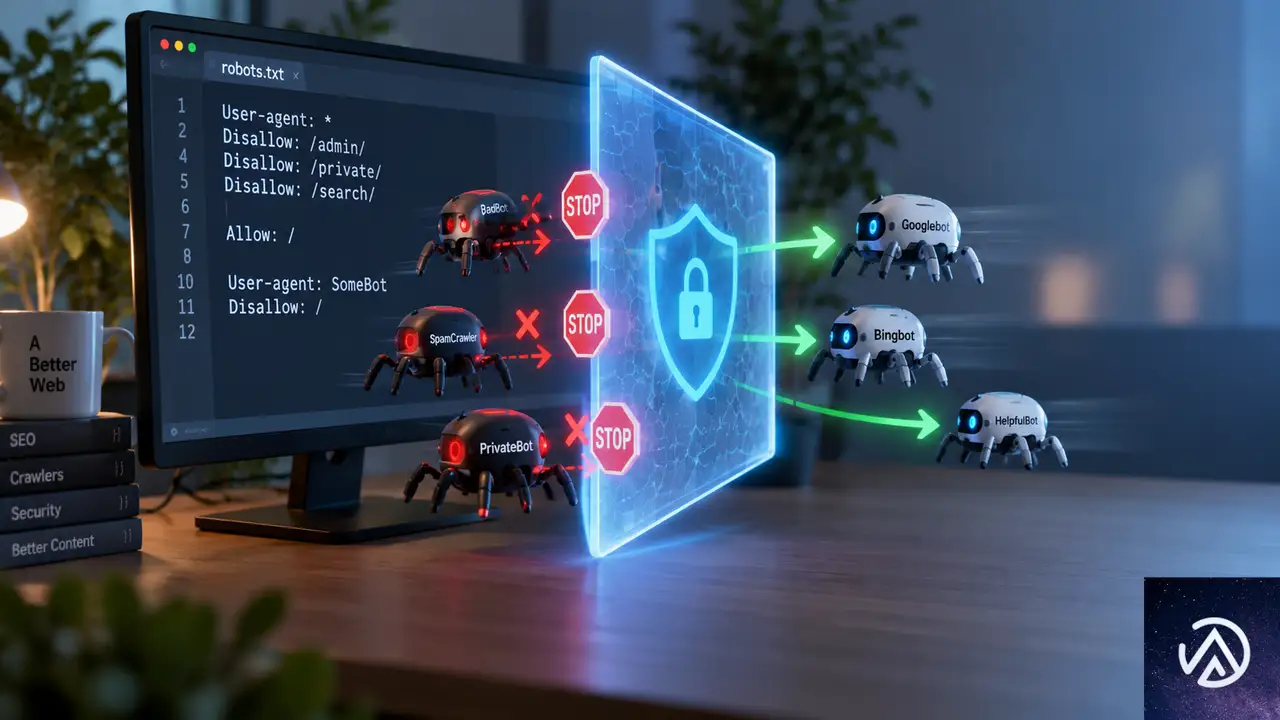
robots.txtのルールは、停止することを選ぶクローラーを停止させるだけだ。ルールを無視するクローラーには何も影響しない。No Hacksの記事は、同サイトのログで最大のAIクローラーが認証情報を探していたと報告している。非営利研究アーカイブの名前を使い、/.envやSSHキーを要求するクローラーがいたという。テキストファイルのルールはそのようなクローラーを不便にさせることすらできない。
それでもBot Preference Syncは有用だ。インターネットの誠実な側、つまりルールを守るクローラーに対しては機能する。エッジでの強制が実際の防御であり、robots.txtは意図の文書化として、後から紛争になった時に意味を持つ。リクエストが到着した瞬間の防御にはならないが、自社のポリシーを明確に残しておく価値はある。
最終的には、robots.txtとCloudflareのAIボットポリシーを突き合わせて確認する作業が欠かせない。Bot Preference Syncが自サイトに到達したら、書かれた内容を必ず確認すること。読んでいないポリシーファイルは、他人が自分の代わりに表明した立場になる。
この記事のポイント
- CloudflareのBot Preference Syncはrobots.txtとエッジ強制設定の矛盾を解消する自動化機能である
- Search、Agent、Trainingの3カテゴリ設定では個別クローラー単位のビジネス判断を表現できない
- Cloudflareは4つの開示条件を公開し、不透明なクローラーをブロック対象にした
- 新規顧客にはデフォルトでオンになり、広告収益化サイトではTrainingがブロックされる
- robots.txtは誠実なクローラーにしか効かないため、エッジ強制が依然として重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleのAIコンテンツ支払い、CloudflareとMicrosoftが示す3つの設計思想
Google、Cloudflare、Microsoftの3社がAIによるコンテンツ利用への対価支払いモデルをそれぞれ試験している。支払いの発生条件、価格設定の主導権、運営者に返るレポートの中身は3社で大きく異なる。
Googleは「重要な貢献」と判定した場合のみ支払う招待制パイロットだ。Cloudflareはクロール1回ごとに課金する独自モデルを持つ。Microsoftはライセンス型マーケットプレイスを2月に発表した。
この違いが、サイト運営者がAIにコンテンツを提供する際の収益性とリスクを左右する。本記事では3モデルの設計思想とSEOへの影響を整理する。
3社のAIコンテンツ支払いモデルの全容
Google、Cloudflare、Microsoftは2026年に入り、AIがウェブサイトのコンテンツを利用する際の対価支払いモデルをそれぞれ提示した。3社のアプローチは課金の単位、価格設定の主導権、レポートの粒度で根本から異なる。
3社のモデルは支払い方式とコントロール権限のバランスで大きく異なる。
Googleは「貢献度」判定、Cloudflareは「取得単位」課金
Googleのパイロットプログラムは、Gemini、AI Overviews、AI Modeのいずれかで、サイトのコンテンツがAI生成応答に「重要な貢献をした」と判断された場合に支払いが発生する。回答生成後のリンク表示や確認だけでは条件を満たさない。Googleは6月18日の公式投稿で、AI回答の根拠となる情報を提供するウェブサイト向けの新モデルを試験する方針を示した。
一方、CloudflareのPay Per Crawlは2025年から非公開ベータとして提供されてきた。クローラーがコンテンツを正常に取得するたびに課金が発生する仕組みで、サイト運営者はクロール1回あたりの価格を設定できる。最低価格は0.001ドルだ。価格に同意したクローラーには正常応答コードでページが返る。
Microsoftはライセンス型マーケットプレイス
Microsoftは2月3日にPublisher Content Marketplaceを発表した。Copilotの回答を支えるためのプレミアムコンテンツのライセンスを提供する仕組みで、パブリッシャーは提供価値に基づいて支払いを受ける。利用条件とライセンス条件はパブリッシャーが定義し、利用ベースのレポートも提供される。Copilotが最初の需要パートナーとなり、Yahooも導入を進めている。
関連する動きとして、Ceramic.aiは自社の検索結果にサイトのコンテンツが表示された際に参加サイトへ支払うモデルを採用している。You.comは特定のプレミアムコンテンツをオンデマンドで利用した時点で支払う仕組みだ。
支払いトリガーを決めるのは誰か
各モデルは支払い発生のイベント定義が異なる。ここが運営者の収益予測を難しくする根本原因だ。Googleは「重要な貢献」という質的基準、Cloudflareは「取得成功」という機械的基準、Microsoftは「提供価値」という経済的基準を採用している。
判定者が誰かによって、収益予測の立てやすさが変わる。
Googleの「重要な貢献」はブラックボックス
Digidayの報道によれば、Googleのパイロットでは支払いがコンテンツの使用量ではなく価値に基づくとされている。Googleが自社で「意味のある貢献だったか」を判断する仕組みで、プログラムに詳しい企業幹部はDigidayの取材に対し「かなりブラックボックスだ」と述べている。Googleは判定基準を公表していない。
サイト運営者から見れば、この構造は収益の予測可能性を著しく下げる。何が支払いにつながるかの明確な基準が分からない状態で、コンテンツ戦略の投資判断を下すのは難しい。
Cloudflareは機械的なイベント、Microsoftは定義自体が不明
Pay Per Crawlのイベントは機械的だ。価格に同意したクローラーへの正常応答が課金の条件と明確に定義されている。ただしCloudflareの7月1日の投稿は、クロール回数が価値の粗い指標であると自認している。1回だけクロールされたページが何千もの回答に引用されることもあれば、何度もクロールされながら一度も使われないページもある。
Microsoftは支払い単位を公開していない。提供価値に基づくと説明するが、具体的な計算式や契約上の定義は明らかにされていない。価格設定もパブリッシャーとの共同設計の対象とされるが、誰が最終決定するかは公開情報では分からない。
サイト運営者がコントロールできる範囲
3社のモデルはサイト運営者がどのような条件を設定できるかも異なる。価格を自分で決められるのか、参加の是非だけなのか、利用条件まで定義できるのか。この差は収益性と交渉力に直結する。
Googleは参加の是非のみ、条件交渉の余地なし
Googleのパイロットは招待制だ。参加者はSearch Consoleからいつでもオプトアウトできるが、参加するかどうか以外の条件交渉の余地は公開情報から見えてこない。Digidayによれば、ある企業幹部は提示された金額が低すぎてオプトインしなかったと述べ、Googleとの交渉は継続中だという。
この点は小規模なサイト運営者ほど不利になる。招待を受けるか、提示された条件で飲むか。その二択しか選べない状況では、交渉力のある大手メディアと中小サイトの間に収益格差が生まれやすい。
Cloudflareは価格を運営者が設定、Microsoftは利用条件を定義
Pay Per Crawlでは、サイト運営者がドメインごとの価格を設定できる。パス単位で価格を変える動的プライシングにも対応し、クローラーごとに課金、許可、ブロックを選べる。Pay Per Useでは、サイト運営者はパートナーのプログラムに参加する形で、パートナーによって支払い条件が変わる。
Microsoftのマーケットプレイスは加入が任意で、パブリッシャーはコンテンツの所有権と編集の独立性を保持する。ただし、ライセンス条件と利用条件の具体的な内容は公開されていない。価格決定者も不明のままだ。
レポートで見える情報と見えない情報
収益化の判断には、どれだけの情報が返ってくるかが重要だ。3社のレポート粒度と透明性にも明確な差がある。
Googleの月次収益表示と計算式の非公開
Googleの参加者はSearch ConsoleのAI貢献パネルで月次収益額と履歴を確認できる。しかしDigidayは、支払い計算の詳細は提供されないと報じている。Googleは一部のパートナーと週次会議も行っている。パブリッシャー連合SpurのDavid Buttle氏は、第一歩として「パブリッシャーが自分のコンテンツが回答に影響したことを知る権利がある」という前例を作ることだと述べた。
月次収益という数字は見えるが、その数字がどう算出されたかは見えない。この非対称性は、運営者が支払い額の妥当性を検証できないことを意味する。
Cloudflareの残高非表示とCeramicの詳細レポート
Pay Per Crawlでは、課金イベント発生時に記録が残る。ダッシュボードにはどのクローラーがアクセスしたか、課金が何回発生したかが表示される。ただし獲得残高はダッシュボードに表示されず、Cloudflareチームへの問い合わせが必要だ。
Pay Per Useでは、Ceramicプログラムに参加するサイトが、コンテンツが表示された検索クエリ、該当ページ、スニペット、検索結果内の平均順位まで含むレポートを受け取れる。こちらの方が実務的には使える情報が多い設計だ。
Microsoftの利用ベースレポートは中身が非公開
Microsoftは「コンテンツがどのように評価され、どこでさらに価値を提供できるか」を確認できる利用ベースのレポートを約束している。ただし、レポートに含まれる具体的な項目は公開されていない。参加者がレポート内容について説明した記録も見つからない。
Googlebotへの従量課金が招くSEOリスク
CloudflareのPay Per Crawlは、ディレクトリに登録されたあらゆるクローラーに従量課金を設定できる。Googlebotも対象だ。ここにSEO上の大きな落とし穴がある。
CloudflareのBlock設定をGooglebotに適用すると、検索インデックスからの削除リスクが連鎖的に発生する。
Googleのクローラードキュメントによれば、4xxステータスコードを返すURLのコンテンツは使用されない。402 Payment Requiredも4xxに該当するため、Googlebotに課金を設定して402を返すと、時間の経過とともに検索インデックスから削除される可能性がある。
Cloudflareが9月15日に公開した新設定はこの状況を変えるものではない。Disallow AI Training設定はrobots.txtに学習拒否の意思を公開し、GoogleとAppleはこれを尊重しつつ検索クローリングは続ける。一方、BlockオプションはGooglebotを含むクローラーを完全に停止する。
つまり、Googlebotに対して「学習は拒否したいが検索クロールは許可したい」場合は、BlockではなくDisallow AI Trainingを選ぶ必要がある。Cloudflareの報告では、検索ボットをブロックしているサイトは1%未満、何らかの学習ブロックを使っているサイトは17%に上る。
また、Googleは数週間以内にGoogle-Extendedに関連するURL単位の透明性ツールを提供する予定だとCloudflareは伝えている。これはパイロットの貢献レポートとは別のものだ。
サイト運営者が今取るべき行動
3社のモデルは完成形ではなく、すべて試験段階にある。運営者が今できるのは、自社のコンテンツの性質とリスク許容度に合わせて選択肢を評価することだ。
Cloudflare設定の見直しが最優先
すでにCloudflareを利用しているサイトは、現在の設定状態を確認すべきだ。従来の設定が移行されている可能性があり、Googlebotに対して意図しないBlockがかかっていないかを確認する必要がある。学習拒否と検索継続を両立するには、Training controlをDisallow AI Trainingに設定する。Blockにしてしまうと検索クロールも停止する。
この設定の分岐は、サイト運営者にとって「収益化のチャンス」と「検索順位のリスク」を同時に含む。学習を拒否するか、検索クロールを維持するか、あるいは課金対象としてGooglebotに支払いを求めるか。それぞれの選択肢の帰結を理解した上で決める必要がある。
契約前に確認すべき情報
Googleのパイロット招待を受けた場合、オプトイン前に「重要な貢献」の定義、計算方法、Search Consoleの生成AIコントロールとの関連性についてGoogleに確認するべきだ。Microsoftのマーケットプレイスを検討する場合は、誰が価格を決定するのか、レポートに何が含まれるのかを契約前に明確にする必要がある。公開情報だけではこれらの質問に答えられない。
3社のモデルは「支払いの透明性」に対するアプローチが根本から異なる。Googleは判定をブラックボックスにすることで柔軟性を確保し、Cloudflareは機械的なイベントで透明性を確保し、Microsoftはパブリッシャーに条件定義を委ねる。いずれもまだ実験段階であり、最終的な設計が現在の形のまま展開されるとは限らない。
特に重要なのは、Cloudflareが自ら「クロール回数は価値の粗い指標」と認めた点だ。同じコンテンツでも1回のクロールで何千回も引用される場合と、何度もクロールされながら全く利用されない場合がある。この非対称性は、現在のすべての支払いモデルが「価値の正確な測定」にまだ到達していないことを示している。
サイト運営者は、今後のレポート精度の向上と透明性ツールの展開を注視しつつ、自社のコンテンツがAI応答にどう使われているかを定期的に確認する姿勢が求められる。
この記事のポイント
- Googleは招待制で「重要な貢献」と判定した場合のみ支払う。判定基準は非公開
- Cloudflareはクロール取得単位の課金とパートナー主導の利用課金の2軸で展開
- Microsoftはライセンス型で利用条件はパブリッシャーが定義するが価格決定者は不明
- Googlebotを含むクローラーにBlock設定を適用するとSEOリスクが連鎖する
- 3社とも試験段階で、価値測定の正確性が今後の焦点となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
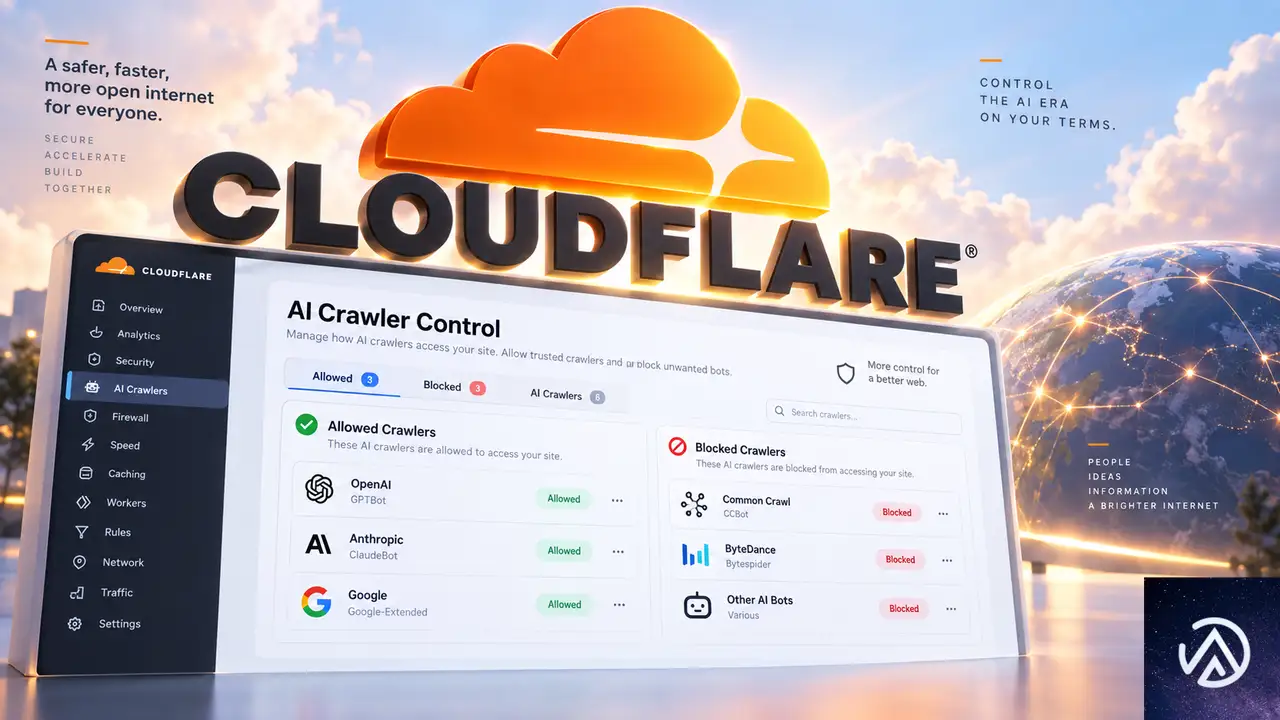
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
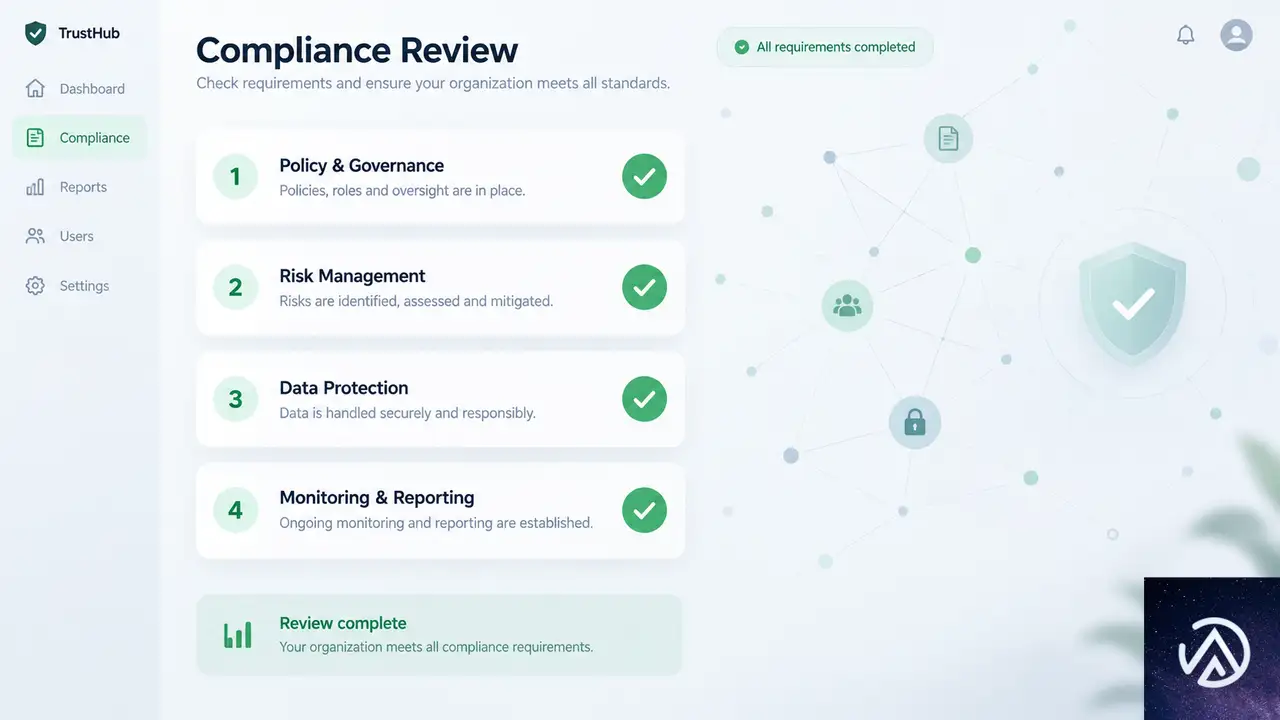
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
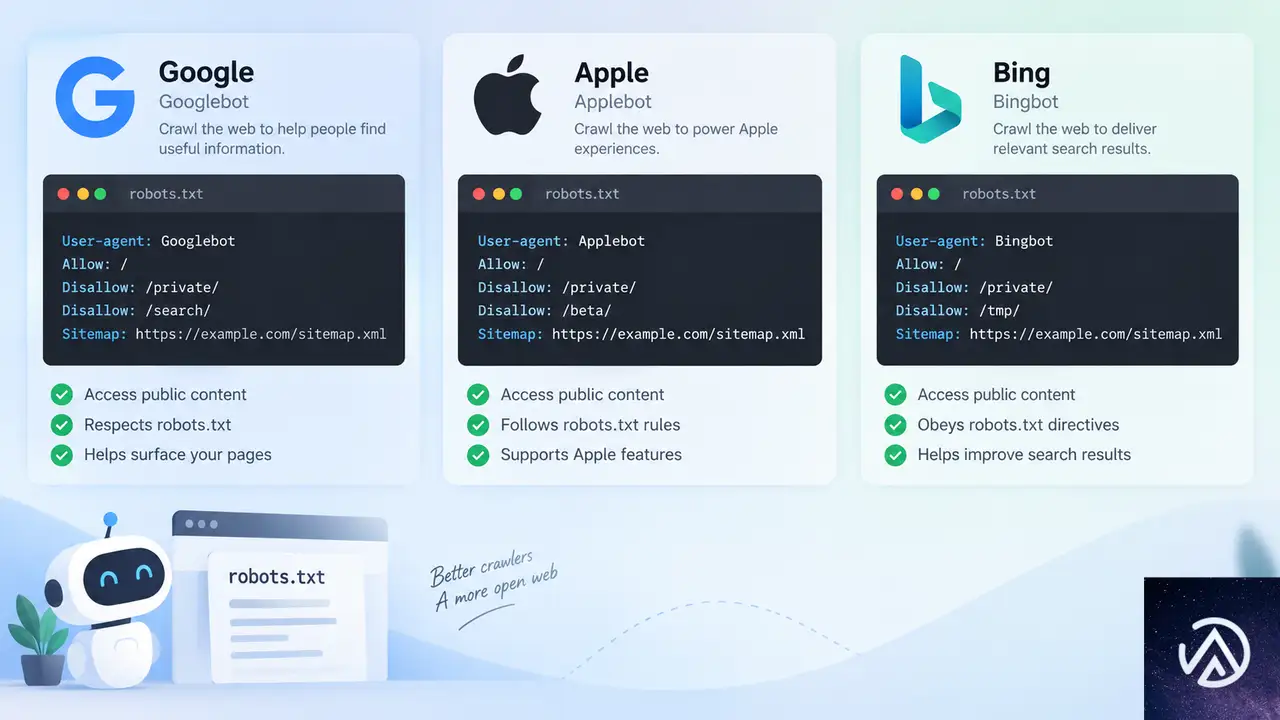
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare DDoS脅威レポート2026年上半期、1Tbps攻撃が935件に急増
Cloudflareが2026年8月11日、DDoS脅威レポートの2026年上半期版を公開した。今回で通算25回目の発行となる。四半期ごとの発表を統合し、1月から6月までを単一のレポートにまとめた形式だ。
レポートによれば、Cloudflareは上半期で2,320万件のネットワーク層DDoS攻撃と29兆6,400億件のHTTP DDoSリクエストを軽減した。1時間あたり約5,343件、1日あたり約12万8,000件の攻撃に相当する。
なかでも1Tbps(テラビット毎秒)を超える超大規模攻撃の急増が目を引く。攻撃ベクトルはボットネット直撃型から反射・増幅型へ移行しつつあり、防御側の自動化がこれまで以上に重要になっている。
2026年上半期のDDoS攻撃概況
4月にピーク、国際摘発作戦で減少へ
4月は攻撃のピーク月だった。攻撃リクエストは6兆4,600億件、通信量は165PB(ペタバイト)に達した。この量は大手動画プラットフォームが1日で処理するデータ量に匹敵する規模だ。
その後、攻撃件数と通信量は減少に転じた。同時期に実施された国際法執行作戦「Operation PowerOFF」が影響したとみられる。21カ国が参加し、DDoS攻撃代行サービスの利用者7万5,000人超を標的に、53のドメインを停止、25件の家宅捜索、4人の逮捕という成果を上げた。
法執行の直接的な抑止効果は計測しにくい。ただし摘発の直後に攻撃数が減少した事実は、DDoS攻撃代行サービス(いわゆるブートストレスサービス)の利用層がインターネット全体の攻撃量に与える影響の大きさを示している。個人が安価に攻撃を「注文」できる構造が、この規模の攻撃増加を支えている構図だ。
1Tbps超の攻撃が6倍以上に急増
1Tbps超の超大規模攻撃は第2四半期だけで805件に達した。前期比で6倍以上の増加だ。上半期全体では935件の1Tbps超ネットワーク層攻撃を軽減している。
DDoS対策の世界では「ハイパーボリュメトリック攻撃」という分類がある。1Tbps以上、または毎秒10億パケット(Bpps)以上、または毎秒100万リクエスト(Mrps)以上のいずれかを満たす攻撃だ。2026年はこの分類に入る攻撃が順調に増えている。
ただし攻撃の中央値は小規模だ。ネットワーク層攻撃の96.62%が500Mbps未満、90.60%が10分未満で終了している。「小規模」といっても相対的な話だ。100Mbpsの攻撃だけで一般的なサーバーやWebサイトは十分にダウンし得る。100Gbpsなら無保護のデータセンターを停止させる威力がある。
攻撃者は帯域とパケットレートの組み合わせも工夫する。高パケットレート(Mpps単位)と低帯域幅(Gbps単位)を組み合わせ、ネットワーク機器の処理限界と回線容量の限界という異なる弱点を同時に狙う手口が観測されている。
攻撃ベクトルの変化とCLDAP急増
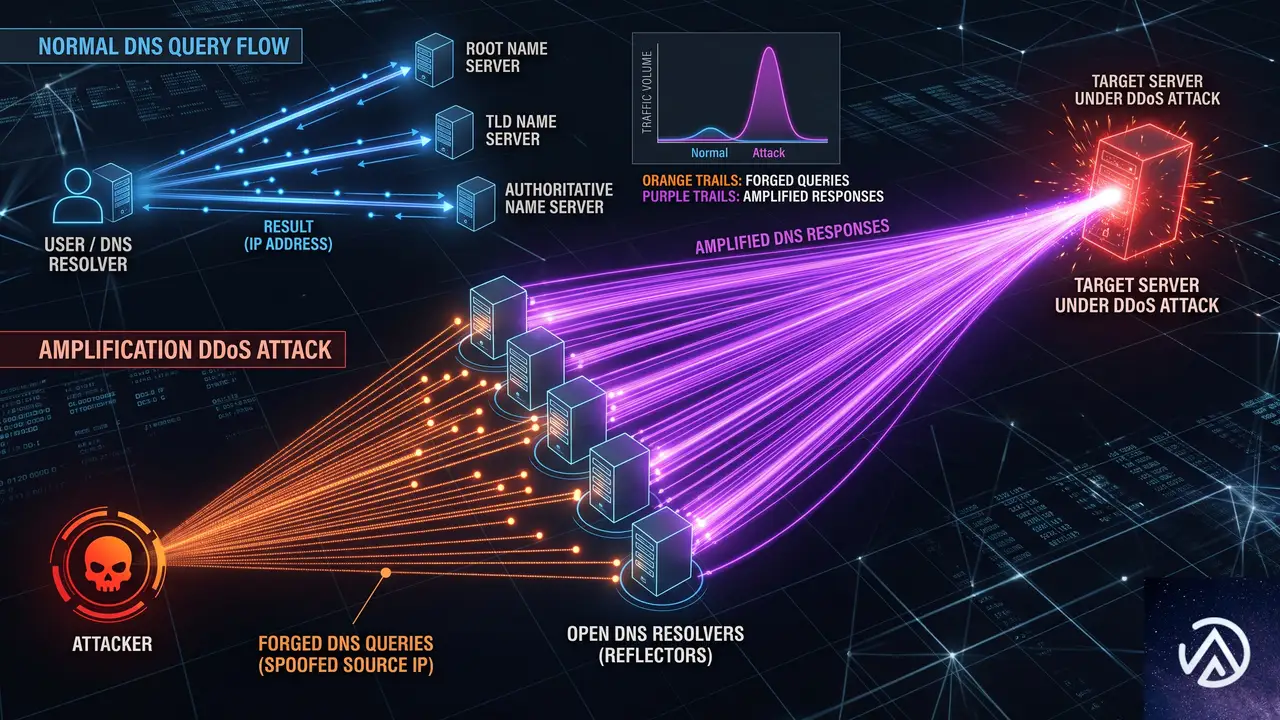
DNS系攻撃がネットワーク層の3分の1を占める
攻撃の中心はボットネット直撃型から反射・増幅型へ移っている。DNS系攻撃が上半期のネットワーク層攻撃全体の34.3%を占めた。第2四半期にはDNSフラッドの割合が25.7%から40.0%へ急拡大している。
DNSフラッドは、ボットネットが被害者の権威DNSサーバーへ大量のクエリを直接送りつける攻撃だ。このドメインの「電話帳」に当たるDNSサーバーが応答不能になると、そのドメインに依存するサービスはすべて機能を失う。
DNSアンプリフィケーションは別の仕組みだ。攻撃者は送信元IPを偽装した小さなクエリを公開DNSリゾルバへ送る。リゾルバは元のクエリよりはるかに大きな応答を、偽装されたIP(つまり被害者)へ返す。少ない帯域で大きな攻撃を生み出せるため、攻撃者にとって効率がよい。
上の図は3つの攻撃ベクトルの違いを整理したものだ。直撃型は攻撃者自身の帯域がそのまま攻撃力になる。反射・増幅型は第三者のサーバーを踏み台にするため、攻撃者側の帯域が少なくても大きな打撃を与えられる。
CLDAPフラッドが580%増
CLDAPフラッドの伸びは顕著だ。前期比580%増となり、第2四半期だけで第3位の攻撃ベクトルに浮上した。
CLDAP(Connectionless Lightweight Directory Access Protocol)はLDAPのUDP版だ。UDPはTCPと違いハンドシェイクが不要で、送信元IPの偽装が容易になる。攻撃者はUDPポート389で公開されたドメインコントローラーへ偽装クエリを送り、元の数十倍から数百倍の応答を被害者へ反射させる。
CLDAPの急増が示すのは、公開されたUDPサービスの危険性だ。ポート389が外部に開いている組織は、自覚のないまま攻撃者の踏み台にされている可能性がある。インフラ管理者にとっての実務的な教訓は「UDPポートの露出を監査し、不要なら閉じる」という基本対策の重要性が再確認されたことにある。
標的産業と地域の動向
メディア産業が最大の標的に
メディア・制作・出版産業が両四半期で最も攻撃された産業になった。全HTTP DDoSリクエストの14.2%を占め、2位の約4倍に相当する。イランとウクライナの戦況報道、そしてワールドカップ関連の報道が攻撃対象になったとみられる。
報道機関へのDDoS攻撃は、単なる金銭目的や愉快犯ではなく、情報の流れを止める意図を持つことが多い。特定の報道を続けるメディアのサイトを落とすことで、世論に影響を与えようとする動機が背景にある。
この図が示すように、標的と攻撃元の分布は対称ではない。標的は中国・米国など経済規模の大きい国に集中し、攻撃元はブラジル・インドネシアなどボットネット感染端末が多いとされる国に偏る。
政府部門が29位から9位へ急浮上
政府部門の動きは今年最大のトピックだ。2026年2月28日にイスラエルと米国が「Operation Epic Fury」を開始。その72時間以内に、16カ国110組織に対する149件のハクティビストDDoS攻撃が記録された。標的組織の47.8%が政府部門だった。
この結果、政府部門のシェアは第1四半期の29位から第2四半期には9位へ急上昇した。単一セクターの移動幅としては2026年最大だ。地政学的な緊張がDDoS攻撃の規模と方向性に直接影響を与える構図が、データとして明確に現れた。
国別では中国が最多の標的になった。第2四半期に全世界のHTTP DDoSリクエストの22.4%を吸収した。米国は18.8%で2位を維持している。トルコは攻撃シェアが倍増し、第3位に浮上した。6月から7月にかけてのアンカラNATOサミット準備期間中、治安当局が209人以上を逮捕する大規模な事前摘発を行った時期と重なる。
攻撃元の国ではブラジルが米国を逆転して1位になった。上半期のシェアはブラジル14.9%に対して米国13.4%だ。ブラジルは第2四半期に21.4%まで急伸した。インドネシアは両四半期とも3位を維持し、複数四半期連続で上位3カ国に入る常連になっている。
短時間攻撃と自動防御の重要性
90%以上が10分未満で終了
DDoS攻撃の大半は驚くほど短い。上位の超大規模攻撃ですら秒単位で終了する。過去には開始から終了までわずか35秒という記録的な攻撃も観測されている。
攻撃が30秒でも10分でも、人間が介入する実質的な時間窓は存在しない。セキュリティ担当者にアラートが届いた時点で、攻撃はすでに完了しているからだ。手動での軽減策やオンデマンド型の防御はこの現実に対して遅すぎる。
この図のとおり、攻撃の持続時間と人手による対応時間は圧倒的に乖離している。従来型の「監視して手動で対応する」運用モデルは、DDoS対策においては成立しない。
自動防御が唯一の実効策
さらに、短い攻撃の余波は長引く。ルーティングの不安定化、TCP再送、アプリケーションのタイムアウト、下流サービスの劣化などが数時間から数日続くことがある。サービス停止や品質低下は攻撃の終了後も継続するのだ。
この環境では、常時稼働する自動防御が「あったほうがよい」ものではなく必須の要件になる。Cloudflareは330以上の都市に分散したネットワーク全体で、人間の介入なしに攻撃を検知・軽減する仕組みを運用している。ネットワーク容量は500Tbps規模だ。
同社はさらに、DDoS攻撃を仕掛けるIPアドレスやアカウントを特定する無料のフィードをホスティング事業者やISP向けに提供している。世界800以上のネットワークが登録しており、ボットネットノードの撤去に一定の成果を上げている。
日本の事業者にとっての示唆は明確だ。自社サイトが直接の標的でなくても、反射型攻撃の踏み台にされたり、同じホスティング上の他サイトへの攻撃に巻き込まれたりするリスクは常にある。小規模サイトでも「攻撃を受けたら止まる」前提ではなく、自動防御を標準装備する発想が必要になる。
この記事のポイント
- 1Tbps超のネットワーク層DDoS攻撃が上半期で935件に達した
- DNS系攻撃がネットワーク層全体の34.3%を占め、反射・増幅型への移行が進む
- CLDAPフラッドが前期比580%増で第3位の攻撃ベクトルに浮上
- メディア・制作・出版が最も攻撃され、政府部門は29位から9位へ急上昇
- 攻撃の90.60%が10分未満で終了し、自動防御が実質唯一の対策になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
admin-ajax.phpへのボット大量アクセスでCPUが100%になる時の遮断と対策
admin-ajax.php へのボットの大量リクエストでサーバーの CPU 使用率が 100% に張り付く場合は、一括遮断ではなく攻撃対象の AJAX アクションをログから特定し、不要な処理を止めた上で正規アクセスを通すレート制限を導入するのが現実的な対策だ。
なぜボットは admin-ajax.php を集中的に叩くのか
admin-ajax.php は WordPress が全 AJAX リクエストを受け付ける入口にあたるファイルだ。フォーム送信、商品カートの更新、ハートビート API による自動保存など、フロントエンドと管理画面の両方で使われている。
ボットがここを狙う理由は、ログイン不要でアクセスできる公開エンドポイントでありながら、リクエストごとに WordPress 全体を読み込んで PHP を実行するため、少ないリクエスト数でもサーバー負荷を大きくできる点にある。
URL に action パラメータを付けて呼び出す構造になっており、たとえば問い合わせフォームの送信処理、EC サイトのカート更新、管理画面の自動保存など、あらゆる AJAX 処理がここを通る。ボットはこれを悪用し、処理の重い action を何度も叩いてサーバーを圧迫する。
攻撃対象の AJAX アクションをログから特定する
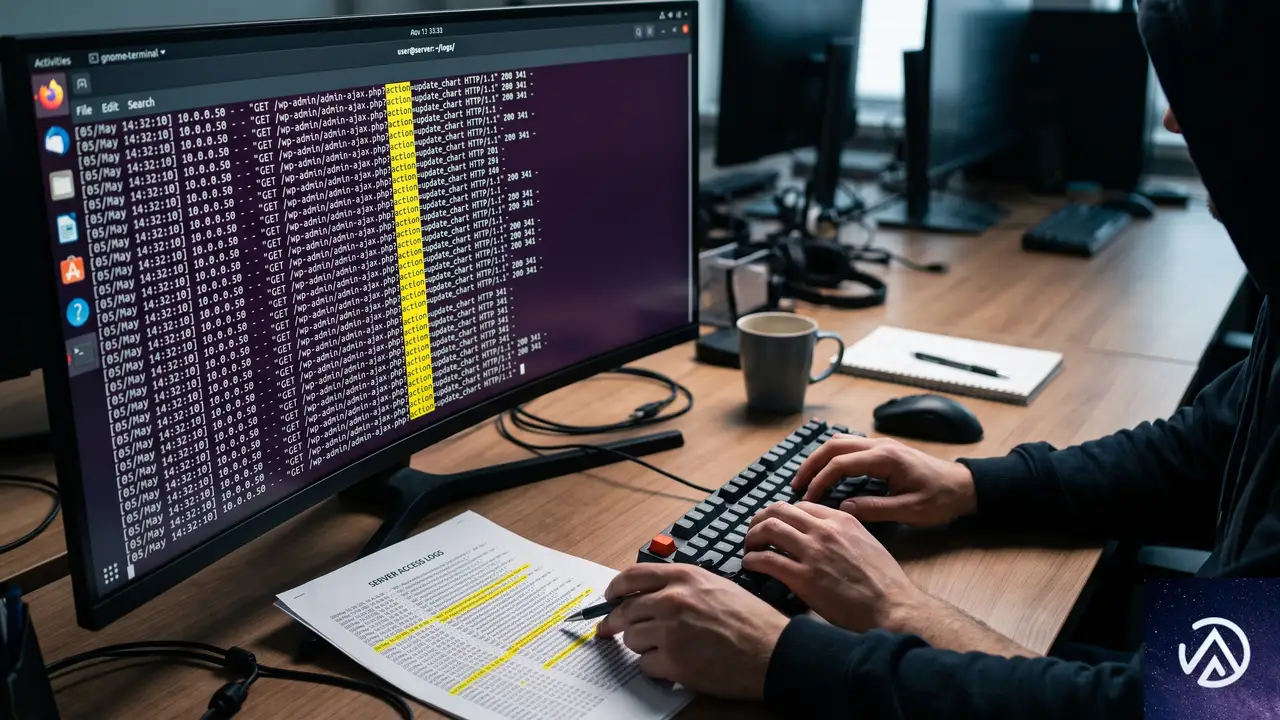
対策の最初の一歩は、どの action が攻撃されているのかをアクセスログで確認することだ。闇雲に遮断ルールを増やしても、正規のフォームを巻き込むだけで根本解決にはならない。
アクセスログで action パラメータを調べる
Apache なら /var/log/apache2/access.log、nginx なら /var/log/nginx/access.log にリクエスト履歴が残っている。admin-ajax.php を含む行を抽出し、action= の後ろに続く値を集計すると、攻撃対象が見えてくる。
サーバー管理画面からログをダウンロードできる場合も多い。Cloudflare を利用しているなら、分析画面のセキュリティイベントから admin-ajax.php 宛てのリクエストを絞り込み、クエリ文字列を確認する手もある。
攻撃対象を特定せずに全リクエストを遮断すると、問い合わせフォームが動かなくなる原因になる。必ずログ調査から始めるのが安全だ。
代表的な攻撃対象を把握しておく
攻撃対象になりやすいのは、外部から呼び出せる未ログインユーザー向けの AJAX アクションだ。問い合わせフォームの送信処理、ハートビート API の更新処理、EC サイトのカート更新などが代表例になる。自分のサイトに不要なプラグインが残した action がしばしば悪用される。
正規のフォームを壊さずにレート制限する
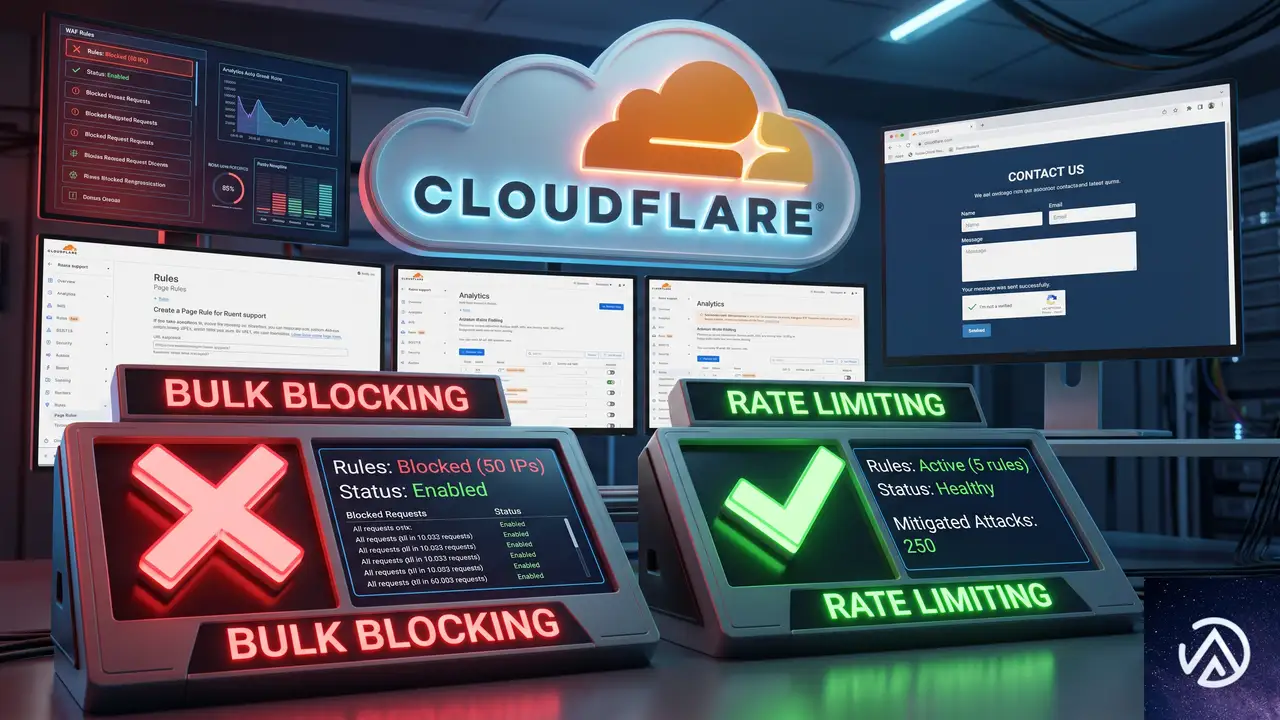
すべての admin-ajax.php リクエストにチャレンジ(CAPTCHA や JS チャレンジ)を適用すると、ブラウザ内の JavaScript が裏で送る AJAX リクエストまで巻き込まれ、フォームが正常に動作しなくなる。これが一括チャレンジ方式が失敗する理由だ。
有効なのは、攻撃対象の action だけを条件にしたレート制限だ。単位時間あたりのリクエスト数を IP アドレスごとに制限し、上限を超えたら一時的にブロックする。正規ユーザーのフォーム送信は頻度が低いため、まず引っかからない。
レート制限の閾値は、通常のフォーム送信頻度を大きく上回る値に設定する。たとえば同一 IP から 1 分間に 30 回を超える admin-ajax.php へのリクエストを制限する場合、正規ユーザーが 30 回もフォームを送ることはない。
WordPress側で不要な AJAX アクションを無効化する
攻撃対象のアクションが自分のサイトで使われていないなら、WordPress のフックを使ってそのアクション自体を止めてしまうのが最も確実だ。リクエストが届いても処理が実行されず、サーバー負荷は大きく下がる。
未ログインユーザー向けのアクションを止める
wp_ajax_nopriv_ から始まるフックは未ログインの訪問者からの AJAX 処理を担当する。使っていない action を特定したら、テーマの functions.php に下のコードを追加して 403 を返すようにする。
add_action('admin_init', function() {
    if (defined('DOING_AJAX') && DOING_AJAX) {
        $action = isset($_REQUEST['action']) ? $_REQUEST['action'] : '';
        if (in_array($action, array('unused_action_1', 'unused_action_2'), true)) {
            wp_die('403 Forbidden', 'Forbidden', array('response' => 403));
        }
    }
}, 1);
action 名はログで特定した値に置き換える。これで、その action へのリクエストは WordPress の初期化直後に拒否され、プラグインのコードが呼ばれる前に処理が終わる。
ハートビート API の負荷を下げる
管理画面や投稿編集画面で自動保存・ロック通知のために heartbeat が一定間隔で動く。編集画面を開きっぱなしにするボットがいると負荷がかさむ。管理画面を普段使わないサイトなら、heartbeat の頻度を下げるか停止する手もある。
add_filter('heartbeat_settings', function($settings) {
    $settings['interval'] = 300;
    return $settings;
});
interval の単位は秒だ。300 にすると編集画面の自動保存間隔が 5 分になり、サーバーへの負荷が大きく減る。完全に止めるのは編集画面のロック機能に影響するため、まず間隔を延ばすところから始めるとよい。
サーバー設定でボットを直接遮断する
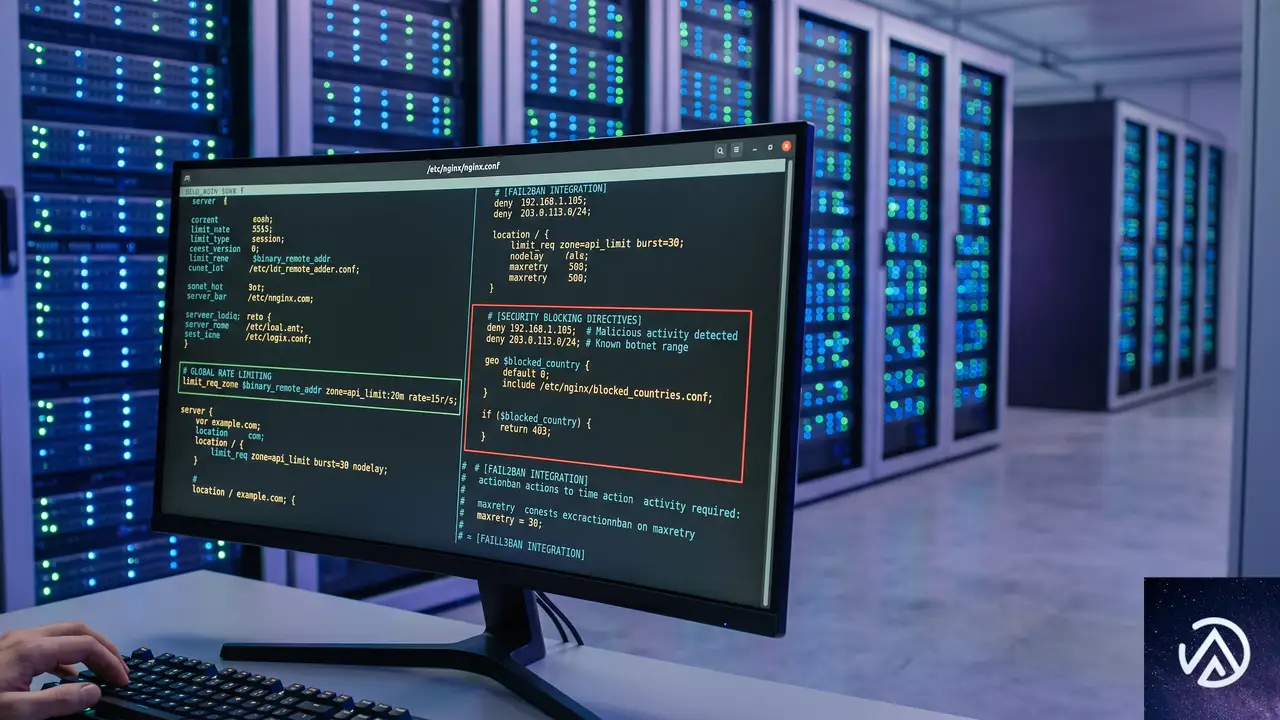
Cloudflare やサーバーレベルの設定でも、条件付きの遮断やレート制限を入れられる。正規のフォームを止めずにボットだけを弾くには、リファラー情報やリクエスト頻度を条件に使うのがポイントだ。
リファラーを条件に弾く
正規の AJAX リクエストは、自分のサイトのページから送られるため Referer ヘッダーに自ドメインが入る。一方、ボットは Referer なしや偽装した値で送ることが多い。Apache なら .htaccess で Referer を条件に遮断できる。
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} /wp-admin/admin-ajax.php
RewriteCond %{HTTP_REFERER} !^https?://example.com/ [NC]
RewriteRule ^ - [F,L]
</IfModule>
これは自ドメイン以外からの Referer を持つ admin-ajax.php リクエストを 403 で拒否する設定だ。example.com の部分は自分のドメインに置き換える。ただし一部のブラウザ設定で Referer が送られないケースもあるため、完全な遮断には向かない。あくまで補助的な対策として使う。
nginx でレート制限する
nginx を使っているなら limit_req ディレクティブで admin-ajax.php 専用のレート制限を定義できる。サーバーブロックに以下の設定を追加する。
limit_req_zone $binary_remote_addr zone=ajax:10m rate=1r/s;

location = /wp-admin/admin-ajax.php {
    limit_req zone=ajax burst=20 nodelay;
    limit_req_status 429;
    fastcgi_pass unix:/var/run/php/php8.2-fpm.sock;
    include fastcgi_params;
}
この設定では、同一 IP から 1 秒あたり 1 リクエストを超えると、バースト(突発的な超過)が 20 回まで許容される。超過分は 429(Too Many Requests)で拒否される。正規ユーザーのフォーム送信はこの制限内に収まるが、ボットの連打はすぐに上限を超える。
よくある質問
すべての admin-ajax.php リクエストを遮断してもよいか
やめておいたほうがよい。問い合わせフォーム、カート更新、検索機能など、多くのサイトで admin-ajax.php が使われている。全遮断すると重要な機能が動作しなくなる。
Cloudflare の Bot Fight Mode だけでは不十分なのか
Bot Fight Mode は既知のボットを自動判定して弾く基本的な防御で、未知のボットや単純なスクリプトには効果が薄い。特定のエンドポイントを狙う攻撃には、レート制限やアクション単位の対策を組み合わせる必要がある。
アクセスログの場所がわからない場合はどうするか
レンタルサーバーの管理画面にアクセスログの閲覧機能があることが多い。わからなければサーバー会社のサポートに問い合わせるか、Cloudflare の分析画面でリクエスト履歴を確認するとよい。
ボット対策プラグインだけでも解決できるか
Wordfence や Limit Login Attempts Reloaded のようなセキュリティプラグインは総合的な保護を提供するが、admin-ajax.php への大量アクセスには専用のレート制限やサーバー設定のほうが効果的な場合が多い。プラグインとサーバー設定の併用が望ましい。
この記事のポイント
- admin-ajax.php は公開エンドポイントで、ボットが少ないリクエスト数でも負荷をかける
- まずアクセスログで action パラメータを集計し、攻撃対象を特定する
- 一括チャレンジは正規フォームを壊すため、action 単位のレート制限を使う
- 使っていない AJAX アクションは functions.php から 403 で拒否する
- サーバー設定(.htaccess や nginx)でも Referer 条件や limit_req で守れる

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
Cloudflare AI Searchがエージェント検索を簡素化、公開エンドポイントと価格プレビュー発表
Cloudflareは2026年8月6日、AI Searchに大規模な機能拡張を発表した。従来はWorkers AIやVectorize、R2、Browser Runといった複数のプリミティブを組み合わせて独自の検索パイプラインを構築する必要があった。今回のアップデートによりAI Searchがこれらの処理を自動化し、開発者やエージェントが、まるで自前の検索エンジンを持っているかのような感覚で扱えるようになった。
新機能として、複数のWebサイトやファイルを横断して検索できる公開エンドポイントの提供、サイトマップ不要のクロール機能、カスタムドメインによるブランディング、EmDash CMS向けの検索プラグインなどが追加された。さらにプレビュー価格モデルも発表され、デフォルトの埋め込み・リランキングモデルを利用すれば、これらの処理が無料になる予測可能な料金体系が示されている。エージェントが信頼できる情報源から回答を引き出せるインフラが、これまでより格段に手軽になった。
AI Searchの主な機能強化点

AI Searchを導入する前は、ベクトル化したデータの格納先やクローリングの仕組み、リランキングのパイプラインなどを開発者が自前で組み上げる必要があった。しかし今回の強化により、それらの低レベルなサービスを意識せずに済む。結果としてエージェントが信頼できる最新情報を引き出せるインフラが、数分で立ち上がるようになった。
インデックス作成の簡素化
これまでAI SearchでWebサイトをインデックスに追加する際は、サイトマップが必須だった。しかし新たに追加された「Discover」パースオプションを使えば、サイトマップがなくてもページ内のリンクを辿って自動的にコンテンツを収集できる。Cloudflareアカウントに登録されたゾーンであれば、特定のページから始まる全サイトデータを取り込めるようになった。
さらに、HTMLやPDFなどの非構造化データから構造化データまで、幅広いファイル形式に対応した取り込みが可能になった。これにより社内Wikiや製品マニュアルといった多様なデータソースをエージェントの検索対象に加えやすくなっている。
公開検索/MCPエンドポイント
ネームスペースに対して公開URLを有効化すると、/search と /mcp のエンドポイントが即座に利用できるようになる。/search は通常のREST APIとして、/mcp はモデルコンテキストプロトコル(MCP)に対応した形で提供される。どちらも認証不要で、複数のインスタンスにまたがる横断検索を1つのリクエストで実行できる。
外部のエージェントやアプリケーションに検索機能を提供したい場合、このエンドポイントをそのまま公開するだけで済む。Cloudflare以外の顧客に自社データへアクセスしてもらうシナリオでも、認証が不要で、URLを渡すだけのシンプルな共有が可能になっている。
EmDashとの統合とbotポリシー
Cloudflareが公開しているOSSのCMS「EmDash」向けに、AI Searchプラグインが提供された。これを導入すると、EmDashで構築したサイト内にセマンティック検索を組み込める。実際にCloudflare BlogやDeveloper Docsもこの仕組みで動いている。
また、AI Searchのクローラは独自のユーザーエージェント「Cloudflare-AI-Search」を使い、各サイトのrobots.txtに従う。ブラウザベースのクローリング機能を使う場合でも、このポリシーは変わらない。サイト運営者がクロールを拒否すれば収集が停止されるため、著作権や利用規約上の配慮が十分になされている。
Cloudflare Dev Stack MCPの実装事例
Cloudflare自身がAI Searchをどう活用しているかを示す好例が、新しく公開された「Cloudflare Dev Stack MCP」だ。これはCloudflareのエコシステム全体(ドキュメント、ブログ、APIリファレンス、コミュニティなど)を横断検索し、コーディングエージェントへ最新の引用付き回答を返す仕組みである。古いトレーニングデータではなく、常にフレッシュな情報を基にコードを生成できる。
インスタンス作成とクロール
CloudflareはDocs、Blog、API Docs、コミュニティ、Astro、Viteなど計10以上のサイトに対して、それぞれ個別のAI Searchインスタンスを作成した。各インスタンスはドメインが異なるが、Cloudflareが所有するサイトデータであるため、統一的な方法でクロールできる。
npx wrangler ai-search instance create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
--parse-type discover上記のコマンドでは、--parse-type discover を指定することでサイトマップなしにページを発見するクロールを実行している。この内部ではBrowser Runの/crawl機能が使用され、リンクを辿って再帰的にページを見つけ出す。
Workerを使ったマルチインスタンス統合
10個のインスタンスにまたがる横断検索を実現するため、CloudflareはWorkerを用いたMCPサーバを構築した。wrangler.jsonにAI Searchネームスペースのバインディングを追加し、1つのツール呼び出しで全インスタンスを同時に検索する。
{
  "ai_search_namespaces": [
    { "binding": "AI_SEARCH", "namespace": "cloudflare-stack" }
  ]
}
context.registerTool(
'search_dev_stack',
{
description: 'Search current docs across the Cloudflare stack.',
inputSchema: z.object({ query: z.string() }),
},
async ({ query }) => {
const res = await context.env.AI_SEARCH.search({
query,
ai_search_options: {
instance_ids: ['developers-cloudflare-com', 'astro', /* ... */],
retrieval: { max_num_results: 10 },
reranking: { enabled: true },
},
})
return { content: [{ type: 'text', text: format(res.chunks) }] }
}
)この方式により、エージェントが単一のツール呼び出しで全ドキュメントを検索でき、結果にはどのインスタンスから取得されたかのメタデータが付与される。複数の検索先を順に叩く必要がなく、応答速度も一括で処理される。
コード不要の公開エンドポイントも選択可能
Workerを書かずに済ませたい場合、ネームスペースの公開URLを有効化するだけで、すべてのインスタンスにクエリを投げる/searchおよび/mcpエンドポイントが得られる。設定画面からワンクリックで有効化でき、即座に利用を開始できる。Cloudflare自身のMCPサーバもこの公開エンドポイントを活用している。
コードを書く場合は細かいチューニングやMCPツールとしての統合が可能で、コードを書かない場合は設定画面上の操作だけで外部共有が完了する。どちらの選択肢も提供されている点が、利用者のスキルや要件に応じた柔軟な導入を後押しする。
公開エンドポイントとカスタムドメインで検索を共有
AI Searchでは、公開エンドポイントに独自のカスタムドメインを割り当てられる。デフォルトのCloudflare管理URLではなく、search.example.com/mcpといったブランド化されたエンドポイントを用意できるため、サービス提供時の信頼感が高まる。
さらに、検索を限定公開したいケースではCloudflare Accessを介した認証ゲートを追加できる。これによりエンドポイントへのアクセスを許可された人物やエージェントだけに制限し、認証情報を持たない第三者からの不正なクエリを防げる。社内データや顧客限定の検索サービスを安全に運用できる設計になっている。
このカスタムドメイン機能は、SaaSプロダクトやエージェントサービスを展開する事業者にとってとくに有用だ。自社ブランドのURLで検索APIを提供することで、サービス全体の統一感が生まれ、導入先からの信頼獲得につながる。
プレビュー価格モデルでコストを予測可能に
AI Searchは現在ベータ版として無料提供されているが、正式版に向けたプレビュー価格が公開された。課金開始前には十分な通知が行われる予定だ。料金設計の中心にある考え方は「予測可能でスケーラブル」であり、埋め込みとリランキングをデフォルトモデル利用時に無料化することで、トークン数の見積もりに頭を悩ませる必要をなくしている。
料金の主な内訳
- インジェスト(テキスト): $0.75 / 1Mトークン。月間無料枠5Mトークン。
- 画像処理アドオン: +$0.50 / 1Mトークン。画像の埋め込みに使用される。
- ストレージ: $2.00 / GB・月。月間無料枠10GB。
- セマンティック検索(ハイブリッド+ベクトル): $0.75 / 1,000クエリ。無料枠2,000クエリ。
- 全文検索: $0.10 / 1,000クエリ。同上の無料枠と共有。
- 埋め込みとリランキング: 指定モデル利用時は無料。それ以外はWorkers AIの従量課金。
無料枠はインジェスト5Mトークンと検索2,000クエリがそれぞれ一つのプールとしてまとめられており、用途を気にせず使い切れる。埋め込みやリランキングのコストが気にならないため、データ更新や再インデックスの頻度を高めやすい。これは頻繁に情報が変わるナレッジベースをエージェントに与えたい開発者にとって大きなメリットだ。
2万ドキュメント規模の試算例
以下は、2万件の文書(約2,000万トークン)と1,000枚の画像をインジェストし、月間3万回のセマンティッククエリを実行した場合の想定コストである。ワーカーズ有料プランが前提で、埋め込みとリランキングにはデフォルトモデルを使用する。
- インジェスト(テキスト): 18.1Mトークン × $0.75/1M = $13.58
- 画像アドオン: 1.1Mトークン × $0.50/1M = $0.55
- ストレージ: 約1.2GB → 無料枠内で$0
- 検索: 28,000クエリ × $0.75/1k = $21.00
- 埋め込み・リランキング: $0
- 合計: 約$35.13
初月にインジェスト費用がかかるが、2か月目以降は主に検索クエリ分だけ(この例では約$21)で運用できる。ドキュメントの大幅な増加がなければ、ランニングコストを低く抑えられる構造だ。
このように、AI Searchのコストは初回のデータ登録が大部分を占め、その後は利用量に比例した検索料金のみになる。大規模なデータベースを抱える場合でも、固定費ではなく使った分だけ支払うモデルのため、予算計画が立てやすい。
AI Searchの導入方法
AI SearchはCloudflareダッシュボードから有効化し、すぐに使い始められる。もっとも簡単な導入は、次のwranglerコマンドでインスタンスを作成する方法だ。
npx wrangler ai-search create my-search \
  --namespace my-namespace \
  --source https://my-website.com \
  --type web-crawler \
--hybrid-searchこの1行でWebクローラー型のインスタンスが立ち上がり、ハイブリッド検索(セマンティック+キーワード)が有効になる。クロールが完了すれば、/searchエンドポイントで検索APIとして利用できる。さらに/mcpエンドポイントを使えば、ChatGPTやClaudeなどのモデルが直接ツールとして呼び出せる。
既存のアプリに組み込む場合はWorker経由でバインドし、エージェントと連携させればよい。カスタムドメインやCloudflare Accessを設定すれば、プライベートな検索サービスとしても公開できる。詳しい手順は公式ドキュメントを参照してほしい。
この記事のポイント
- Cloudflare AI Searchは、複数サービスの組み合わせを自動化し、データ検索基盤をワンストップで提供する。
- 公開/MCPエンドポイントやカスタムドメインにより、エージェントへの組み込みや外部共有が容易になった。
- サイトマップ不要のクロールやEmDash CMSとの統合で、あらゆるデータソースを取り込める。
- プレビュー価格ではデフォルトモデルの埋め込み・リランキングが無料で、予測しやすいコスト構造が示された。
- wranglerコマンド1行でセットアップが完了し、すぐにエージェント向け検索エンジンとして利用開始できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
エージェント開発ライフサイクル(ADLC)がCloudflareで始動。SDLCを超える新たな枠組み
ソフトウェア開発のライフサイクル(SDLC)が、AIエージェントの登場によって根本から再定義されようとしている。Cloudflareは2026年8月4日、エージェント中心の新たな開発モデル「Agent Development Lifecycle(ADLC)」の構想と、それを支える具体的なツールセットを発表した。
従来のSDLCは「計画→設計→実装→テスト→デプロイ→保守」という人間中心の工程だった。しかしAIエージェントがコード生成の速度を劇的に高めた結果、周辺の工程がボトルネック化している。ADLCはこの課題を解決し、エージェントがライフサイクル全体を自律的に管理できる環境を提供する。
ADLC(エージェント開発ライフサイクル)とは何か
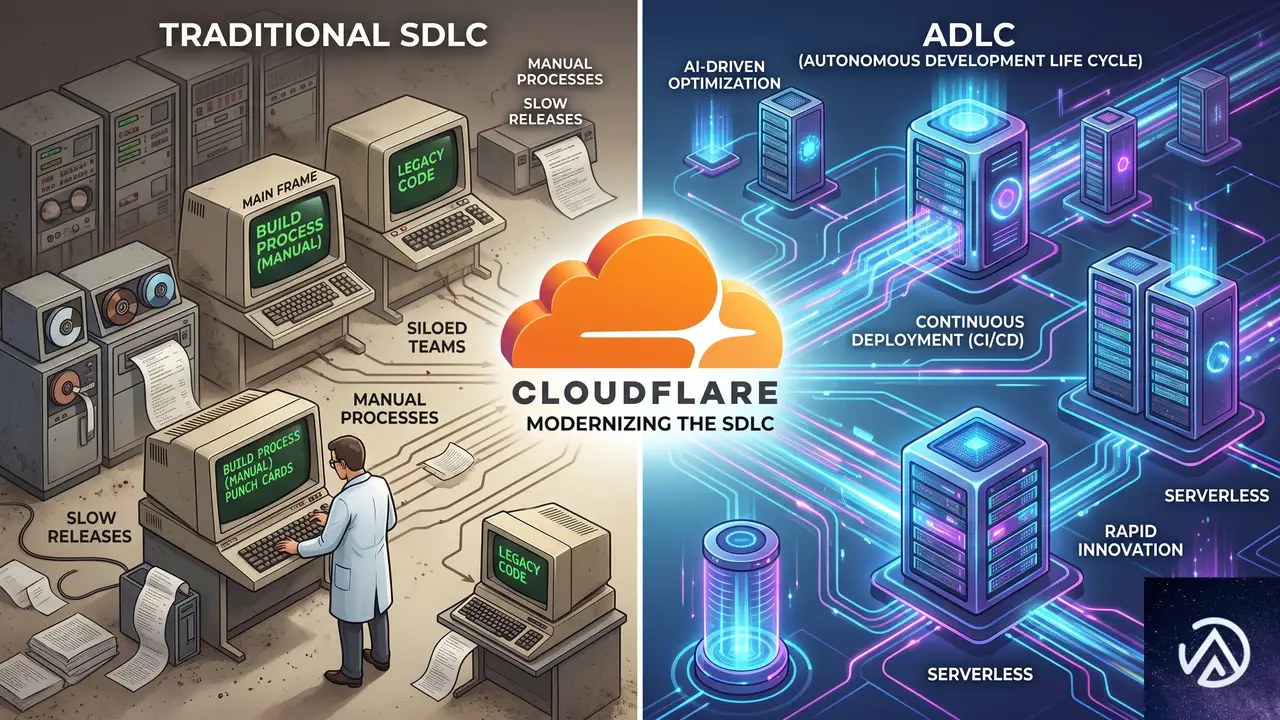
ADLCは、従来のSDLC(Software Development Lifecycle)をエージェント時代に合わせて再設計した概念だ。SDLCは1975年にランド研究所が提唱した「Systems Development Lifecycle」を起源とし、長年にわたりソフトウェア開発プロセスの標準だった。しかし、AIエージェントがコードを実装する速度は人間の比ではなく、テストやレビュー、デプロイといった他の工程が追いつかなくなっている。
Cloudflare Blogの著者Carlo Daniele氏によると、AIによって「実装」が最速かつ最安になった一方で、他の工程に携わる人々が膨大なプルリクエストやイシューに圧倒されるという逆説的な状況が生まれている。オープンソースメンテナの疲弊や本番環境の不安定化は、まさにこの非対称性の表れだ。
ADLCは、エージェントが実装だけでなく、テスト・デプロイ・監視・改善までを一貫して担うことを前提とする。そのために必要な要件は、プログラムによる操作が可能(Programmatic)、水平スケーラブル、再現可能、リアルタイムのプッシュ型イベント対応、アトミックな変更管理、適切な権限制御、そして自己改善能力の7つに整理されている。
ADLCへの移行は、単にエージェントにタスクを委譲するだけでは実現しない。Cloudflareが提唱する7要件は、いずれも人間向けに設計された既存の開発基盤では満たせないものだ。次のセクションでは、なぜこのタイミングでパラダイムシフトが必要なのかを掘り下げる。
SDLCからADLCへ なぜ今パラダイムシフトが必要なのか
エージェント時代の「人間ボトルネック」
ChatGPTやClaude、GitHub CopilotといったAIツールの普及により、コード生成のスピードは飛躍的に向上した。ところが開発現場の実態を見ると、生成されたコードのレビューやテスト、本番デプロイは依然として人間が担っている。結果として、プルリクエストの滞留が慢性化し、オープンソースプロジェクトではメンテナが数千件のイシューに対処しきれずに疲弊する事例が相次いでいる。
Cloudflareの見解では、これは「エージェントを部分的にしか使えていない」ことに起因する。実装だけをエージェントに任せ、他の工程を人間が管理するという中途半端な状態が、かえって現場の負荷を増大させているのだ。
自律走行車に学ぶ「全体最適」の視点
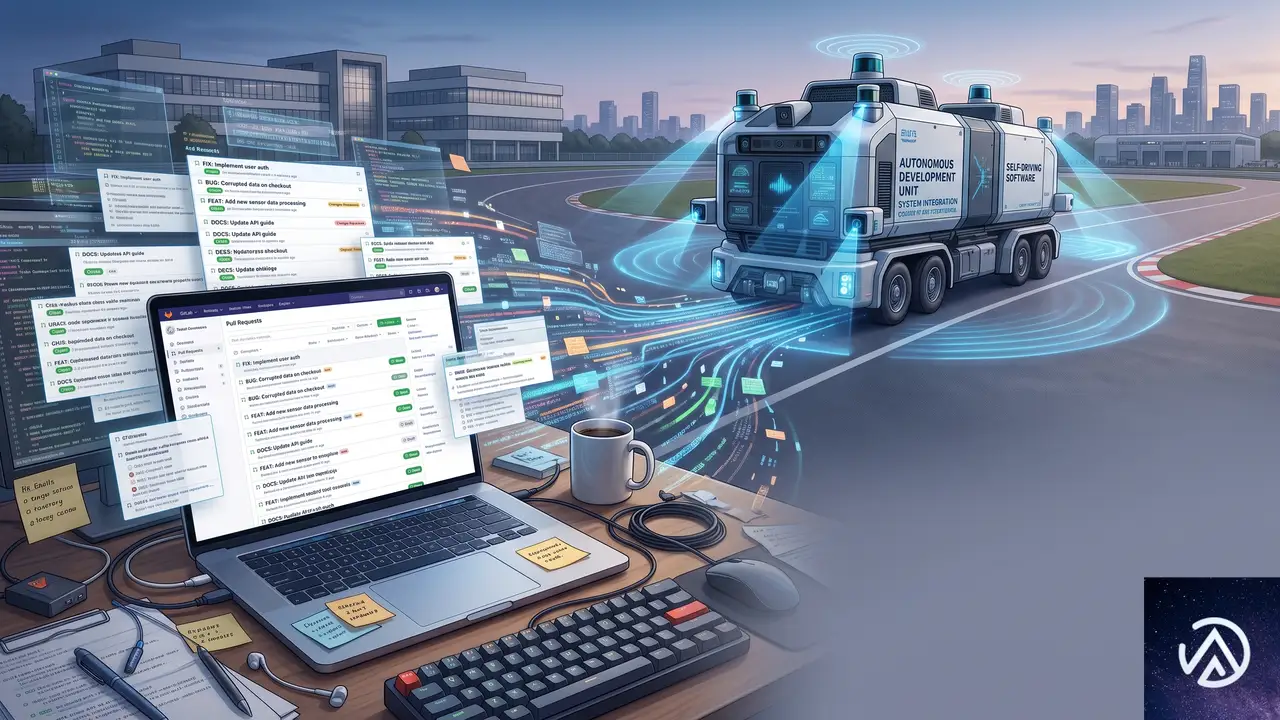
Cloudflare Blogの記事では、ADLCの必要性を自律走行車に例えて説明している。人間向けの車にAIを載せただけでは、80%の性能は出せても、残りの20%が致命的な事故を引き起こす。安全に走行するには、LiDARや高性能コンピュータ、遠隔制御システムといった専用設計の技術が必要だ。
ソフトウェア開発でも同じで、エージェントが安全にコードをマージし、本番にデプロイするには、人間向けのCI/CDパイプラインでは不十分だ。エージェント専用のインフラ、トレーシング、権限管理、自己修復の仕組みが求められる。
ここで鍵となるのが、Cloudflare Workflowsとエージェントの組み合わせだ。従来のGitHub Actionsのような線形のパイプラインではなく、動的に分岐し、コンテナやブラウザを立ち上げ、ログを解析しながら自律的にソフトウェアを出荷する「ワークフロー」がADLCの中核を担う。
Cloudflareが提供するADLC基盤の全容

Workflowsが実現する動的なCI/CD
Cloudflare Workflowsは、複数のステップをチェーンし、失敗したタスクを自動リトライし、数時間から数週間にわたって状態を保持できるサービスだ。従来のCI/CDパイプラインが静的なYAML定義だったのに対し、WorkflowsはTypeScriptで動的にワークフローを定義できる。
さらにWorkflowsは、エージェントや別のWorkflowを子プロセスとして起動できる。たとえば、毎晩収集したデータをエージェントにレビューさせ、その結果を元に次のステップを動的に決定する、といった高度なオーケストレーションが可能だ。
import { CIWorkflow } from '@cloudflare/ci'

// CIパイプラインの例: 依存関係インストール後、lint/test/typecheck/buildを並列実行
const deps = await ci.runner({
  name: 'install',
  command: 'bun install --frozen-lockfile',
  cache: { inputs: ['package.json', 'bun.lock'] },
});
await Promise.all([
  deps.runner({ name: 'lint', command: 'bun run lint' }),
  deps.runner({ name: 'test', command: 'bun run test' }),
  deps.runner({ name: 'typecheck', command: 'bun run typecheck' }),
  deps.runner({ name: 'build', command: 'bun run build' }),
]);
await deps.runner({
  name: 'deploy',
  command: 'bun wrangler deploy',
  cloudflareCredentials: { accountId: this.env.CLOUDFLARE_DEPLOY_ACCOUNT_ID },
});
このコードは、依存関係のインストールをキャッシュしつつ、後続のlintやテスト、ビルドを並列で実行するパイプラインを簡潔に表現している。Workflowsによって、エージェントが生成したコードを安全に検証し、本番へデプロイするまでの一連の流れを自動化できる。
エージェントの可観測性と自己改善
ADLCにおいて、エージェントの動作を監視し、改善につなげる仕組みは欠かせない。Cloudflareは、OpenTelemetryベースのトレーシングをローカル開発環境(WranglerやViteプラグイン)に組み込み、本番環境と同等の可観測性を提供する。また、Agent Tracesによってエージェントのセッション全体をキャプチャし、パフォーマンス向上に活用できる。
さらに、Feature Flag管理のFlagshipや、段階的デプロイメント(Gradual Deployments)、Browser Runによるヘッドレスブラウザのプログラム操作など、エージェントが自律的にソフトウェアをテストし、リリースするためのプリミティブが一通り揃っている。
エージェントが主導するソフトウェアファクトリーの実践例
Cloudflare自身のエンジニアリング標準化
Cloudflareは自社の全プロダクトとシステムリポジトリにわたり、AIを用いてエンジニアリング標準の遵守を強制している。具体的には、コードレビューや仕様チェックをエージェントが補助し、人間のレビュアーの負荷を軽減する仕組みだ。
これにより、コーディング規約の違反やセキュリティパターンの逸脱を自動検出し、修正案まで提示できる。人間はより創造的な設計判断や顧客との対話に時間を割けるようになったという。
Astroプロジェクトにおけるイシューゼロへの挑戦
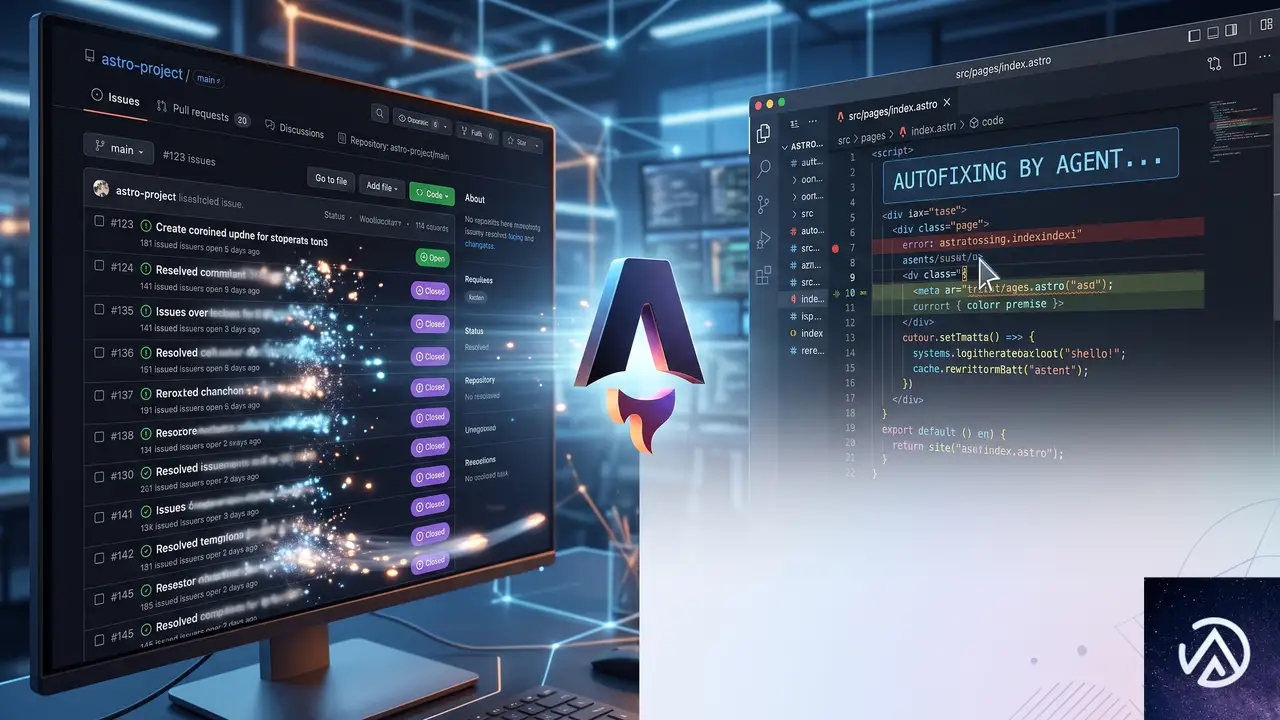
また、CloudflareはAstroというオープンソースプロジェクトにおいて、イシューの自動トリアージ、再現、修正を行うシステムを構築した。この「ソフトウェアファクトリー」により、GitHub上のイシュー件数をゼロに近づける試みが行われている。
エージェントがバグレポートを受け取り、自動で再現環境をセットアップし、修正PRを作成する。Workflowsがこれらのステップをオーケストレーションし、テストと検証を経てマージする流れだ。この事例は、ADLCが現実のプロジェクトで有効に機能することを示している。
ADLCがもたらす開発現場の未来と課題
ソフトウェアファクトリーの民主化
現在、最先端の企業だけがソフトウェアファクトリーを構築できているのが実情だ。Cloudflareは、WorkflowsやAgent Traces、Browser Runといったプリミティブを誰でも使える形で提供することで、この格差を埋めようとしている。小規模なスタートアップでも、ADLCの恩恵を受けられるようにする狙いだ。
具体的には、@cloudflare/ciパッケージによるCI/CDの簡素化や、Flueエージェントフレームワークとの統合によって、複雑なオーケストレーションを少ないコードで実装できるようになっている。
残る課題と人間の役割
ただし、ADLCへの移行には越えるべきハードルもある。エージェントが本番環境に直接変更を加えることへの心理的な抵抗感は依然として強い。Cloudflare自身も、権限の段階的な委譲(エスカレーション)の仕組みや、監査証跡の確保が不可欠だと認識している。
また、エージェントが生成するコードの品質をどう担保するか、未知のエッジケースにどう対応するかは、自律走行車と同じく「99%の壁」をどう突破するかの問題だ。CloudflareはAgent Tracesを通じてエージェントの経験値を蓄積し、時間とともにパフォーマンスが向上する仕組みを描いているが、実運用でのデータ蓄積がこれから本格化する。
それでも、コードを書くだけのエージェントから、ソフトウェアのライフサイクル全体を駆動するエージェントへの進化は、もはや避けられない流れだろう。ADLCは、そのための地図と道路を提供するものだ。
この記事のポイント
- ADLC(Agent Development Lifecycle)は、従来のSDLCをエージェント中心に再設計した新しい開発モデルである。
- AIエージェントの実装速度に他の工程が追いつかない「人間ボトルネック」の解決を目指す。
- Cloudflare Workflowsを中核に、動的でスケーラブルなCI/CDとエージェントオーケストレーションを実現する。
- Agent TracesやBrowser Runなどのプリミティブが、エージェントの自己改善と安全な本番運用を支える。
- ソフトウェアファクトリーの民主化により、スタートアップから大企業までADLCの恩恵を受けられる時代が近づいている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareがオリジン接続でポスト量子認証をサポート開始
Cloudflareがオリジンサーバーとの接続に対するポスト量子(PQ)認証のサポートを開始した。Authenticated Origin Pulls(AOP)とCustom Origin Trust Store(COTS)の2製品で、格子ベースのデジタル署名アルゴリズムML-DSAを導入する。これにより、Cloudflareと顧客オリジン間の相互TLS接続を完全に量子耐性化できるようになった。
今回の対応は、Cloudflareが掲げる2029年の完全ポスト量子セキュリティ達成に向けたマイルストーンの第一歩だ。量子コンピュータによるなりすまし攻撃の脅威が現実味を増すなか、暗号化だけでなく認証のレベルでも対策を打てる段階に入ったことを意味する。
量子コンピュータに備える認証のアップグレード
Harvest-Now/Decrypt-Laterだけでは足りない
これまで量子耐性の議論は「Harvest-Now/Decrypt-Later」と呼ばれる攻撃への対策が中心だった。攻撃者が現在の暗号化通信を蓄積しておき、将来の量子コンピュータで解読するというシナリオだ。Cloudflareも2022年から来訪者との接続、2023年からはオリジン接続でポスト量子暗号化をサポートし、広く使われてきた。
しかし、近年の量子コンピュータと暗号解読のブレークスルーにより、スケジュールが前倒しされている。問題は暗号化にとどまらない。量子コンピュータは古典的な認証情報も破ることができるため、攻撃者が正規のサーバーになりすます「なりすまし攻撃」の脅威が高まっている。そこで認証にもポスト量子の仕組みを導入する必要が出てきた。
オリジン接続だからこそ先行できる理由
訪れるユーザーとCloudflareの間の接続(コネクション1)では、Web PKIの制約があり、ポスト量子証明書の普及には時間がかかる。一方、Cloudflareと顧客オリジンサーバー間の接続(コネクション2)は、あらかじめ信頼関係が確立された閉じた環境だ。このため、公開インターネット向けの証明書基盤を待たずに、独自のPKIでML-DSA署名を導入できる。
また、Cloudflareがクライアント側になるため、接続プーリングによって多数のリクエストを少数の接続に集約できる。これにより、ポスト量子署名の処理負荷をならすことが可能だ。クラウドサービスならではの制御性を活かし、Web PKIが同様の対応をするよりも早く、実際に運用できる段階までこぎつけた。
この接続構成では、Cloudflareがクライアント証明書を提示し、オリジン側でそれを検証することで、なりすましを阻止する。両者とも量子耐性のある署名アルゴリズムだけを信頼するよう設定すれば、ダウングレード攻撃も防げる。
AOPとCOTSの設定手順
ポスト量子認証を有効にするには、Custom Origin Trust Store(COTS)にML-DSAのCA証明書をアップロードし、Authenticated Origin Pulls(AOP)にはクライアント証明書と秘密鍵を登録する。以下にCloudflare APIを使った手順を示す。すべての鍵生成にはOpenSSL 3.5.0以降が必要で、秘密鍵はFIPS 204 seed-only形式を利用する。
COTS:オリジン証明書チェーンのML-DSA化
COTSは、デフォルトの公開CAに代えて顧客が指定したCAだけを信頼する仕組みだ。ML-DSA対応により、オリジンに接続する際のサーバー証明書をポスト量子化できる。まず、ML-DSA-44のプライベートCAを作成し、そのCAでオリジンサーバー証明書に署名する。
# プライベートML-DSA-44 CAの作成
openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out origin-ca.key

openssl req -new -x509 -key origin-ca.key \
  -out origin-ca.crt -days 10950 \
  -subj "/CN=Origin Server CA"

# オリジンサーバー証明書の生成
openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out origin-server.key

openssl req -new -key origin-server.key \
  -out origin-server.csr \
  -subj "/CN=origin.example.com"

openssl x509 -req -in origin-server.csr \
  -CA origin-ca.crt -CAkey origin-ca.key -CAcreateserial \
  -out origin-server.crt -days 5475 \
  -extfile <(printf "basicConstraints=CA:FALSE\nkeyUsage=digitalSignature\nsubjectAltName=DNS:origin.example.com\n")
生成したCA証明書をCOTSにアップロードし、SSL/TLSモードをFull(strict)に設定する。これでCloudflareは、アップロードされたCAからチェーンする証明書を持つオリジンとのみ接続するようになる。
AOP:Cloudflare側のクライアント証明書
オリジンサーバーがCloudflareからの接続だけを受け付けるようにするには、AOPでクライアント証明書を設定する。ML-DSA証明書とseed形式の秘密鍵をAPI経由で登録すれば、Cloudflareがオリジンに対して自らの身元を証明するようになる。
# AOP用CAとクライアント証明書の作成
openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out aop-ca.key

openssl req -new -x509 -key aop-ca.key \
  -out aop-ca.crt -days 10950 \
  -subj "/CN=Authenticated Origin Pull CA"

openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out aop-client.key

openssl req -new -key aop-client.key \
  -out aop-client.csr \
  -subj "/CN=cloudflare-aop-client"

openssl x509 -req -in aop-client.csr \
  -CA aop-ca.crt -CAkey aop-ca.key -CAcreateserial \
  -out aop-client.crt -days 5475 \
  -extfile <(printf "basicConstraints=CA:FALSE\nkeyUsage=digitalSignature\n")
AOPはゾーン単位またはホスト名単位で有効化できる。グローバル設定のML-DSA対応は、より大規模な変更が必要なため後日対応予定だ。
ダウングレード対策と接続確認
ポスト量子署名を導入しても、検証側が従来のRSAやECDSAを引き続き信頼していれば、経路上の攻撃者によるダウングレード攻撃を受ける可能性が残る。完全な量子耐性を確保するには、オリジン側で量子脆弱な認証方式を無効化し、ML-DSAのみを信頼する設定にしなければならない。
設定後は、openssl s_clientで署名タイプを確認したり、nginxのログにクライアント証明書のシリアル番号を出力させたりして、CloudflareがML-DSA証明書を提示していることを検証する。鍵合意でもX25519MLKEM768がネゴシエートされていることをあわせて確認したい。
これらの手順を踏むことで、Cloudflareとオリジン間の通信が暗号化と認証の両面でポスト量子化される。
実装の舞台裏と教訓

制御プレーンはGoの壁をCIRCLで突破
CloudflareのSSL/TLS設定を管理するサービスはGoで書かれている。ML-DSA対応にあたり、Goの標準ライブラリがまだ同アルゴリズムをサポートしていないという課題があった。そこでCloudflareは自社の暗号ライブラリCIRCLに必要な機能を実装し、標準ライブラリの不足を補った。
ただし、このアドホックな対応は一時的なもので、2026年8月にリリース予定のGo 1.27ではML-DSAがネイティブサポートされる。バージョンアップのみで多くのサービスがポスト量子認証に対応できるようになるため、エコシステム全体にとっての追い風となる見込みだ。
BoringSSL更新の遅れとインシデント
データプレーン側では、プロキシフレームワークPingoraのオリジン接続サービスがBoringSSLに依存している。同ライブラリには4年間ものアップデートが行われておらず、Cloudflareは内部フォークをメンテナンスして機能を追加していた。ML-DSAサポートがBoringSSL本体に取り込まれたことを機に、ついにアップデートを決断した。
しかし、4年分の変更にはKeyUsageルールの厳格化が含まれており、一部の顧客証明書がRFC準拠でないと判定されてしまった。慎重にテストを重ねたにもかかわらず、2026年6月10日に小規模な接続障害が発生し、ロールバックを余儀なくされた。その後、RSA証明書向けの緩和パッチを当てて再開し、現在は安定稼働している。長期間アップデートを控えることのリスクを改めて浮き彫りにした出来事だったといえる。
完全ポスト量子化へのロードマップ
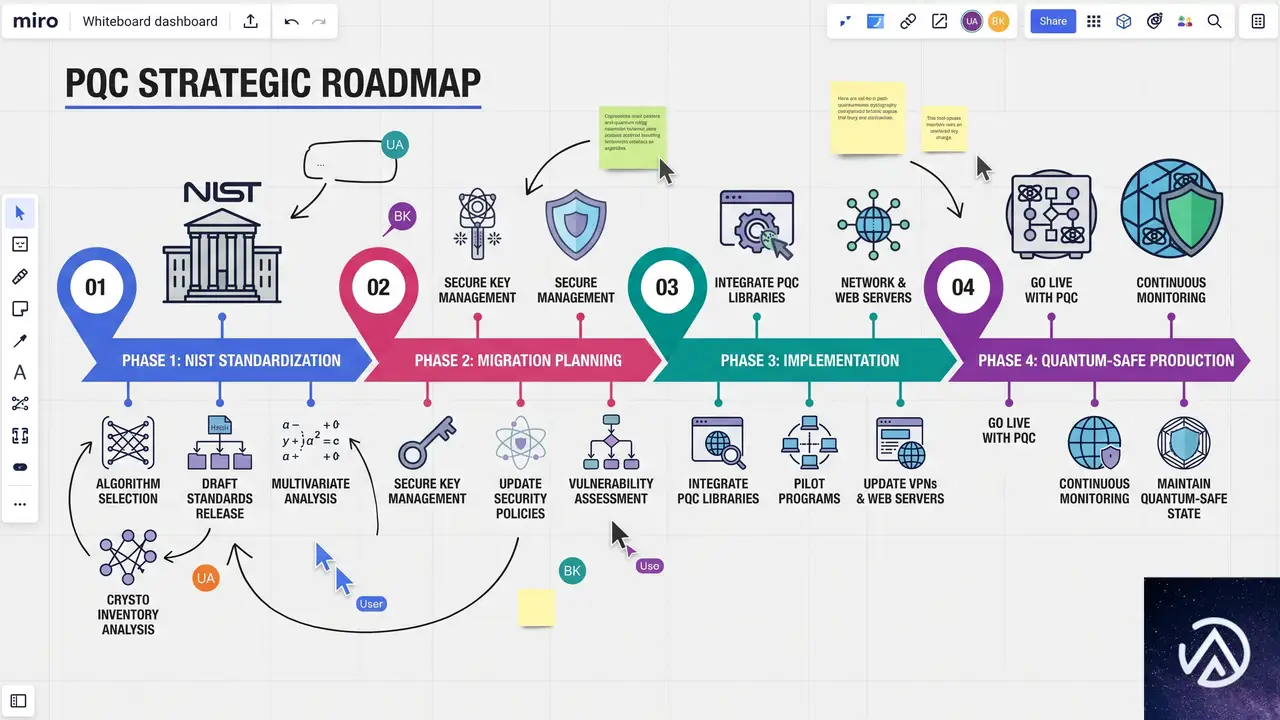
Cloudflareは2029年の完全ポスト量子セキュリティ達成を目標に掲げている。今回のAOP/COTS対応は最初のマイルストーンに過ぎない。ユーザーとCloudflare間の認証については、IETFで策定が進むMerkle Tree Certificates(MTC)による高速なポスト量子証明書の実験を経て、2027年をめどに初期展開を予定している。
Go 1.27の登場やブラウザベンダーの取り組みが進むにつれ、ポスト量子認証は急速に普及すると予想される。ひとまず、オリジンとの相互接続でML-DSAによる完全な量子耐性を確保できるようになったことは、インフラを預かる技術者にとって心強い前進だ。Cloudflareの製品別ポスト量子対応状況は、公式ドキュメントで継続的に更新されているため、導入の際は参照してほしい。
この記事のポイント
- CloudflareがAOPとCOTSでML-DSA署名をサポートし、オリジン接続の相互TLSをポスト量子化
- 量子コンピュータによるなりすまし攻撃に備え、暗号化だけでなく認証の強化が急務に
- OpenSSL 3.5.0+で鍵生成し、API経由で証明書をアップロード。ダウングレード防止には従来署名の信頼解除が必須
- Go 1.27のネイティブML-DSAサポートなど、エコシステム整備が加速中
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
.ALドメインのDNSSEC障害、CloudflareがEDE 33で透明性を向上
2026年7月3日、アルバニアの国別コードトップレベルドメイン「.AL」でDNSSECの鍵ロールオーバーに失敗する障害が発生した。この影響で、.ALドメインを使用する政府機関や銀行、メディアサイトが一時的にアクセス不能となった。
Cloudflareが運用するパブリックDNSリゾルバ「1.1.1.1」は、この障害に対してネガティブトラストアンカー(NTA)を適用して暫定対応を実施。同時に、新しい拡張DNSエラー(EDE)コード「EDE 33」を初めて導入し、NTAが適用されていることをクライアントに明示した。
この記事では、.AL障害の経緯と、DNS運用におけるNTAの透明性を高めるEDE 33の技術的意義を解説する。TLDレベルのDNSSEC障害がもたらす影響と、再発防止に向けた課題を考察する。
.ALドメインで何が起きたのか
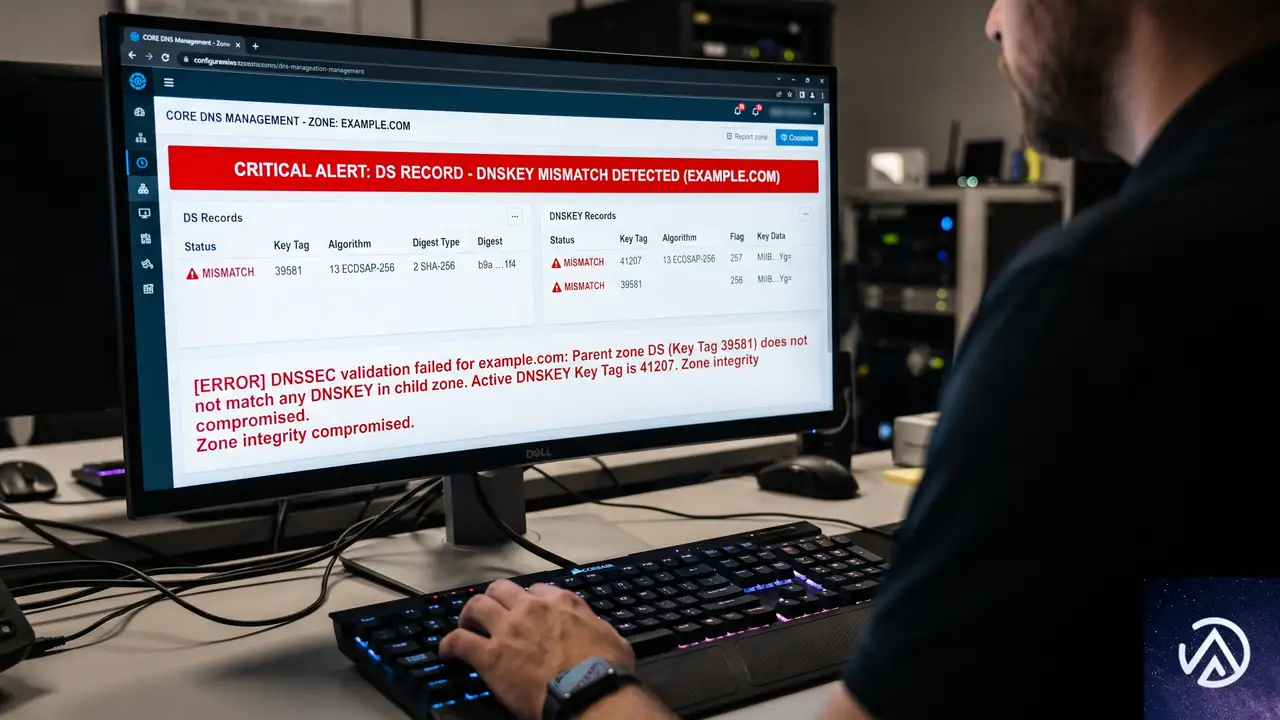
2026年7月3日14時15分(UTC)ごろ、アルバニアの通信規制当局AKEPが.AL TLDのDNSSEC鍵を更新しようとした際に設定ミスが発生した。新しいDNSKEYを公開したが、ルートゾーンに登録されていたDSレコードは古い鍵のままであり、DNSSECの信頼チェーンが切断された。
その結果、1.1.1.1を含む世界中の検証対応DNSリゾルバは、.ALドメインのDNS応答を検証エラー(SERVFAIL)として拒否するようになった。障害発生から約3時間後の17時15分、Cloudflareは1.1.1.1に.AL向けのNTAを適用し、検証を一時的にバイパスして名前解決を回復させた。
AKEPはその後、新しいDNSKEYも削除してしまい、ゾーンからDNSKEYが存在しない状態に陥った。最終的に19時15分ごろ、ルートゾーンからDSレコードが削除され、.AL全体がDNSSEC未署名の状態で名前解決が再開された。記事公開現在も、.ALは未署名のままである。
.DEに続くTLD障害の連鎖
この障害は、わずか2ヶ月前にドイツの.DE TLDで発生した同様のDNSSEC障害を想起させる。.DEの事例でも、1.1.1.1はNTAを適用して暫定対処を行い、事業者の対応を待つ形となった。
TLDレベルのDNSSEC障害は頻発するものではないが、一度発生すると配下の全ドメインに影響が波及する。.ALはCloudflare RadarのTLDランキングで191位に位置し、アルバニアの政府サービスや金融機関、報道機関などが集まる重要なドメイン空間だ。
この比較からわかるように、DNSSECの信頼チェーンはルートゾーンのDSレコードとTLDゾーンのDNSKEYが一致して初めて成立する。ロールオーバーの手順を誤ると、連鎖的に全下位ドメインの検証が失敗する仕組みだ。
NTA適用の判断基準
CloudflareはNTAを適用する前に、AKEPへの直接連絡とDNS-OARC Mattermostへの投稿を通じてコミュニティに注意喚起を行った。しかし、AKEPの連絡先アドレス自体が.ALドメインだったため、障害発生中は連絡が取れないという悪循環に陥った。
NTAの適用は、DNSSEC検証を停止するという強い措置だ。Cloudflareの著者によれば、.DEの事例と同様に「障害が公共に確認されており、すべての検証リゾルバに等しく影響する」という点を重視して判断したという。検証を停止しても名前解決を維持する方を優先した格好だ。
NTAの抱える透明性の課題
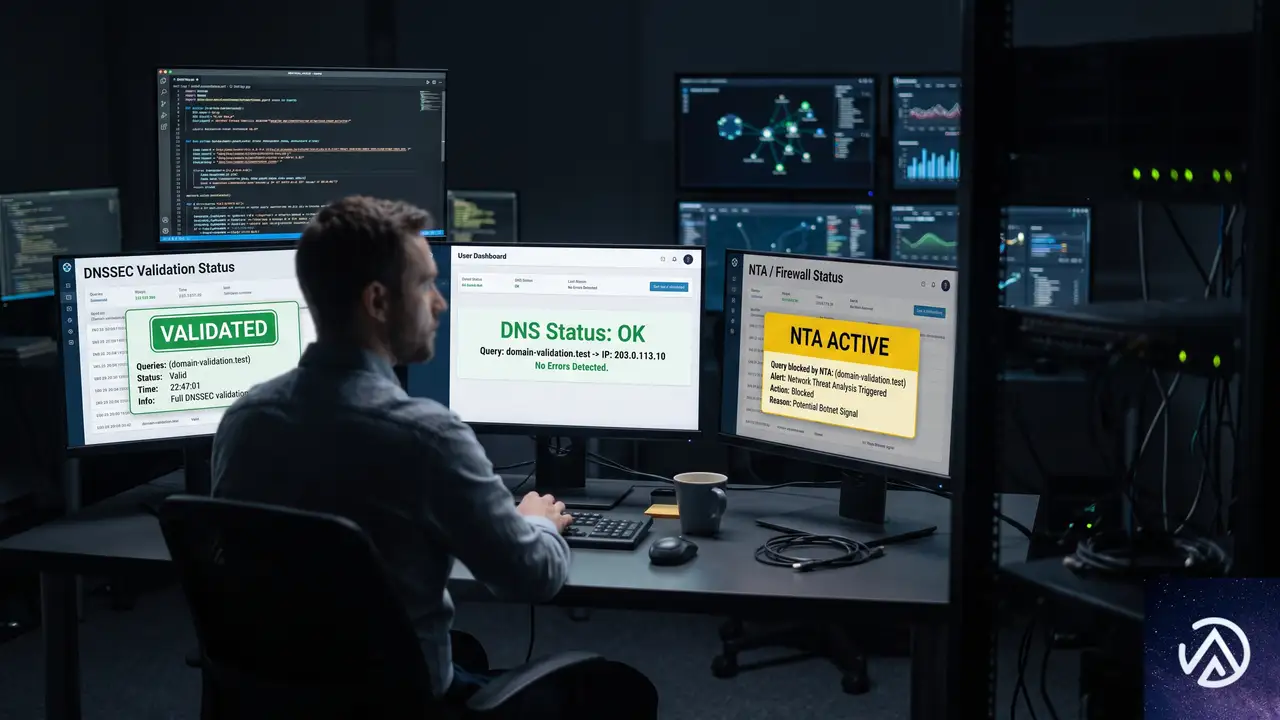
NTAはDNSSECの緊急回避手段として有効だが、一つ大きな欠点がある。それは、クライアント側からNTAの適用を検知できないことだ。NTA配下で返されたDNS応答は、通常の検証済み応答と見分けがつかない。
RFC 7646でもこの問題は認識されており、NTAの適用状況を運用者が公開することが推奨されている。Cloudflareは.DEや.ALの際にステータスページで情報を公開したが、それでも利用者が自発的に確認しなければ気づけない。監視ツールやアプリケーションがDNS応答だけで状況を把握する手段がなかった。
ANSWER: google.al → 142.251.142.196
EDE: 9 (DNSKEY Missing)
EDE: 33 (Negative Trust Anchor)
ANSWER: google.al → 142.251.142.196
● EDE 9で根本的なDNSSECエラーも同時に通知
この「見えないNTA」は、なりすましDNS応答と正当な応答を区別するDNSSECの根幹を揺るがす。NTAが適用されている間、利用者は保護されていない状態で通信していることになるが、それを知る術がなかったのだ。
EDE 33がもたらす透明性
拡張DNSエラー(EDE)コードはRFC 8914で定義されており、DNSリゾルバがエラー時だけでなく成功応答にも追加のコンテキスト情報を付加できる仕組みだ。Quad9のBabak Farrokhi氏が提案し、Cloudflareも共同執筆者として参加したインターネットドラフトで、NTAの適用を示す新しいEDEコード「EDE 33」が定義された。
1.1.1.1は.AL障害において、このEDE 33を初めて実運用に投入した。NTAが適用されている間、.ALドメインへのすべてのDNSクエリに対して、EDE 33が付加された応答が返されている。これにより、クライアントや監視ツールはDNS応答だけで「この応答はDNSSEC未検証である」と判断できるようになった。
EDE 33の実装と応答例
以下は、1.1.1.1にgoogle.alの名前解決を問い合わせた際の応答だ。ステータスはNOERRORで正しい回答が返されているが、2つのEDEコードが付加されている。
$ kdig @1.1.1.1 google.al
;; ->>HEADER<<- opcode: QUERY; status: NOERROR; id: 32848
;; Flags: qr rd ra; QUERY: 1; ANSWER: 1; AUTHORITY: 0; ADDITIONAL: 1

;; EDNS PSEUDOSECTION:
;; Version: 0; flags: ; UDP size: 1232 B; ext-rcode: NOERROR
;; EDE: 9 (DNSKEY Missing): 'no SEP matching the DS found for al.'
;; EDE: 33 (Negative Trust Anchor): 'a Negative Trust Anchor has been applied for this query (see RFC 7646)'

;; ANSWER SECTION:
google.al.              300    IN    A    142.251.142.196
EDE 9(DNSKEY Missing)は、DNSSECの信頼チェーンが切断された根本原因を示している。EDE 33(Negative Trust Anchor)は、1.1.1.1がNTAを適用して応答を返したことを示す。この2つの情報が揃うことで、運用者は「本来は検証エラーになる状況だが、NTAによって暫定的に解決された」という全体像を把握できる。
このフローは、1.1.1.1内部でNTAがどのように処理されるかを示している。EDE 33は、NTAが有効な間、DNSSECを使っていないドメインへのクエリにも付加される。NTAはゾーン全体に適用されるため、透明性もゾーン全体に対して一律に提供される設計だ。
.DE障害で生じた問題も解決
.DE障害の際、1.1.1.1はDNSSECの根本エラーではなく「EDE 22(No Reachable Authority)」を誤って返していた。これは、NTA配下で権威サーバーに到達できない場合に発生するエラーであり、真の原因を隠蔽してしまう問題があった。
.AL障害ではこの点が改善され、EDE 9(DNSKEY Missing)が正しく返されている。EDE 33と組み合わせることで、「なぜ検証に失敗したのか」と「なぜ応答が返されたのか」の両方をクライアントが把握できるようになった。
今後の標準化と運用への影響
EDE 33はIANA(Internet Assigned Numbers Authority)によって正式に割り当てられており、Knot DNSプロジェクトのkdigツールはすでにEDE 33を名前で認識するようになっている。また、Unbound向けのプルリクエストもレビュー段階にある。他のDNSリゾルバ実装も追随することが期待される。
このインターネットドラフトはIETFのDNSOPワーキンググループに提出済みで、2026年7月18日から24日にウィーンで開催されるIETF会合で議論される予定だ。標準化が進めば、EDE 33はすべての主要DNSリゾルバで実装される可能性が高い。
国内DNS運用者への示唆
国内のISPや企業が運用するDNSリゾルバでも、DNSSEC検証を有効にしているケースが増えている。.ALのようなTLDレベルの障害は稀だが、.JPや他のccTLDで発生しないとは限らない。EDE 33に対応したリゾルバ実装を採用することで、障害時の透明性を確保できる。
また、NTAの運用には慎重さが求められる。Cloudflareは.DEと.ALの両方で、コミュニティへの通知後にNTAを適用し、問題解決後に速やかに解除している。このバランス感覚は、他のDNS運用者にとっても参考になる対応だ。
残された課題
記事公開現在、.ALはDNSSEC未署名のままだ。DSレコードがルートゾーンに再登録されない限り、.AL配下のすべてのドメインはDNSSECの保護を受けられない。AKEPがいつ復旧作業を完了させるかは不透明である。
より根本的な問題として、TLD事業者のDNSSEC運用スキル不足が浮き彫りになった。鍵ロールオーバーは手順を誤ると広範囲に影響を及ぼす重要なオペレーションだ。ICANNやレジストリコミュニティによるガイドラインの整備や訓練の機会提供が求められる。
この記事のポイント
- .AL TLDのDNSSEC鍵ロールオーバー失敗により、2026年7月3日に全.ALドメインが一時的に解決不能となった
- Cloudflareの1.1.1.1はNTAを適用して暫定対処を行い、同時に新しいEDEコード「EDE 33」を初めて実運用に投入した
- EDE 33はNTAの適用をDNS応答内で明示し、従来の「見えないNTA」問題を解決する
- .DEに続くTLDレベルのDNSSEC障害は、TLD事業者の運用スキル向上とNTAの標準化の必要性を浮き彫りにした
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験