

Neonがリアルタイム機能を追加へ。Electricチームが語る開発の狙いと課題
NeonがバックエンドプラットフォームのGAを発表した直後、次の大きなステップとしてリアルタイム機能の追加を計画している。開発を担当するのは、2026年8月にNeonへ加わったElectricのチームだ。PostgreSQL上でのリアルタイムデータ同期に5年以上取り組んできたメンバーが中心となる。
Electric共同創業者のJames Arthur氏へのインタビューを基に、開発の狙いと技術的な課題を解説する。リアルタイム同期がなぜ本番環境で崩れやすいのか、その根本的な原因とNeonが目指す解決策が見えてくる。
Neonがリアルタイム同期をバックエンドに追加
NeonはPostgresを基盤としたサーバーレスデータベースサービスだ。2026年9月にバックエンドプラットフォーム全体のGAを発表したばかりである。このプラットフォームにリアルタイム機能が加わることで、データベースからアプリケーションへのデータ同期が自動化される。開発者はデータベースの変更を手動でポーリングする必要がなくなる。
リアルタイム同期とは、データベースに変更が発生した瞬間にアプリケーションへ反映する仕組みだ。従来のアプリケーションは一定間隔でデータベースに問い合わせて変更を取得していた。リアルタイム同期では、変更が発生した時点でクライアントへ通知される。チャットや共同編集ツールなど、即時性が求められるアプリケーションで重要になる。
このデモはポーリング方式とリアルタイム同期の違いを示している。左側ではアプリが定期的にデータベースへ問い合わせるため、変更がなくても通信が発生する。右側ではデータベースに変更が起きた時だけ通知が届く。無駄な通信がなくなり、遅延も短縮される。
開発を担当するElectricチームは、PostgreSQL上でのリアルタイムデータ同期に長年取り組んできた。Neonのブログ記事によると、James Arthur氏は大手企業への参加について「これほど強固なエンジニアリング文化を持つ環境は想像していなかった」と語っている。直属の上司がAWS Auroraを構築した人物であることにも触れ、意思決定の質の高さを実感しているという。
リアルタイム同期が本番環境で崩れる根本的な課題

リアルタイム機能には共通の弱点がある。デモでは美しく動作するが、本番環境では性能が落ちて崩れる傾向がある。James Arthur氏はこの問題を「表現力と性能の間に根本的なトレードオフがある」と表現する。
デモ環境では少量のデータと少数のクライアントで動作する。本番では大量のデータと多数のクライアントが同時に接続する。この環境で同期の正確性と速度を両立させるのは難しい。同期できる内容を増やせば表現力は上がるが、システムの性能は下がる。性能を優先すれば、同期できる内容が限られる。この二律背反が、リアルタイム同期が数十年研究されながらも主流にならない理由だ。
デモと本番の差を視覚化した。デモでは少量のデータと少数のクライアントで快適に動作する。本番では大量のデータと多数のクライアントが同時に接続し、性能が崩れる。このギャップがリアルタイム同期の導入を難しくしている。
ElectricがNeonに加わった本当の理由
Electricは同期を専門とするインフラツールとしてスタートした。しかし、ここ数年でインフラスタートアップの市場環境は大きく変わった。James Arthur氏はNeonのブログ記事で、専門的なインフラツールへの投資が減り、エージェントがより高レベルの抽象化を求めるようになったと説明する。
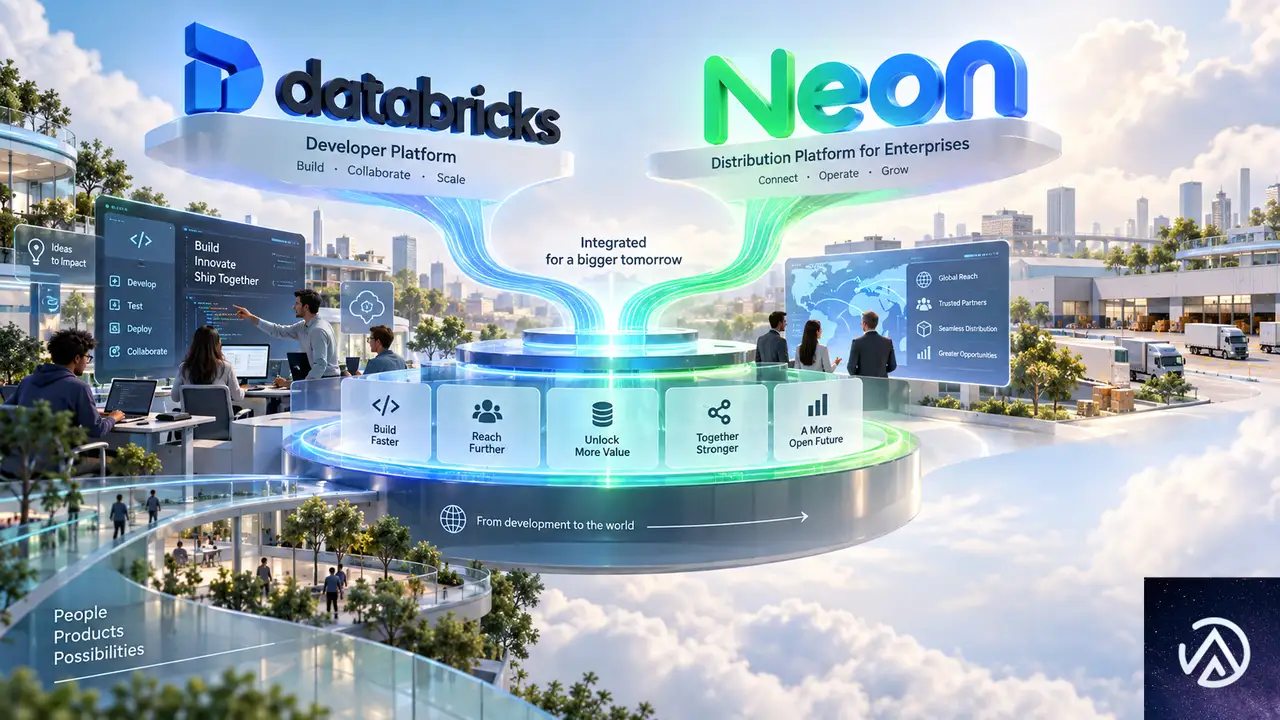
Electricのチームがたどり着いた結論は明確だ。同期はバックエンド・アズ・ア・サービスの機能であるべきだ。同期を中心にした製品を構築するのではなく、既存のプラットフォームを強化する方が合理的だと判断した。Neonは開発者向けに大きなリーチを持つ。Databricksは大企業向けの流通基盤と商業体制を持つ。この2つの強みを活用することで、同期技術をより早く主流にできる。
方針転換の比較を示した。Electric単独で同期ツールを販売する時代は終わり、NeonとDatabricksの流通基盤を使って同期を主流にする戦略に変わった。同期は独立した製品ではなく、バックエンドプラットフォームの一部として提供される。
Neonのバックエンド戦略とリアルタイムの位置づけ

Neonのバックエンドプラットフォームにリアルタイム機能が加わることで、Postgresを選択しない理由がなくなる。現代のアプリケーションとエージェントは、リアルタイムデータとエンドツーエンドのリアクティブ性を必要とする。CTOやテックリード、コーディングエージェントは、バックエンドを選ぶ際にリアルタイム機能の有無を確認する。
リアルタイム機能はNeonとLakebaseにネイティブに動作する。スケールトゥゼロとブランチングにも対応する予定だ。スケールトゥゼロとは、利用がない時にリソースを自動的にゼロまで縮小する仕組みだ。ブランチングはデータベースの分岐を作る機能で、開発やテストを安全に行える。これらの機能とリアルタイム同期が統合されることで、開発者は環境を意識せずにリアルタイム機能を利用できる。
リアルタイム機能がNeonに加わることで、バックエンド選定の流れが変わる。開発者は標準機能としてリアルタイム同期を利用でき、AIコーディングエージェントもNeonを推奨するようになる。これがNeonの目指す完全なバックエンドプラットフォームの姿だ。
Neonのブログ記事によると、James Arthur氏は具体的な技術仕様について「まだ詳細は言えない」としながらも、NeonとLakebaseにネイティブに動作し、スケールトゥゼロとブランチングにネイティブ対応すると明言している。正式な発表は今後行われる予定だ。早期アクセスに興味がある開発者は、NeonのDiscordコミュニティで情報を追える。
この記事のポイント
- Neonがリアルタイム同期機能をバックエンドに追加し、Electricチームが開発を担当する
- リアルタイム同期はデモでは動くが本番で崩れやすく、表現力と性能のトレードオフが根本課題
- Electricは単独の同期ツールから、NeonとDatabricksのプラットフォーム戦略に方向転換した
- リアルタイム機能はNeonとLakebaseにネイティブ対応し、スケールトゥゼロとブランチングもサポートする
- 正式な技術仕様は今後発表予定で、早期アクセスはNeonのDiscordで募集している

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GPT-5.5が企業向けエージェントにもたらす変革、Databricks導入事例
大規模言語モデルの進化が、企業の実務ワークフローに直接的な成果をもたらし始めている。データ分析基盤を提供するDatabricksが、OpenAIの最新モデルGPT-5.5を社内向けAIエージェントに組み込んだ結果、複雑な文書処理タスクを評価するベンチマーク「OfficeQA Pro」でエラーが46%も減少した。GPT-5.5はこのベンチマークで初めて正解率50%を超えたモデルとなった。
この結果は「モデルの性能向上が、実際のビジネス指標にどう結びつくか」を示す重要な事例だ。単なる会話能力の評価ではなく、スキャンされたPDFや古い社内フォーマットの文書を解析し、複数ステップのタスクを自律的に遂行する能力が問われている。本記事ではGPT-5.5がどのような技術的進歩を遂げ、企業のAI活用にどんな可能性を開くのかを解説する。
企業向けAIエージェントの現在地、なぜ文書処理が壁になるのか

企業がAIエージェントを導入する際、最初にぶつかる壁が「社内文書の解析」だ。契約書や見積書、古いシステムから出力されたレポートなど、形式がバラバラな文書をAIに理解させるのは想像以上に難しい。特にスキャンされたPDF(画像として取り込まれた文書)や、数十年前のレガシーフォーマットで保存されたファイルは、最新のAIでも正確なテキスト抽出に失敗することが多い。
この問題の深刻さは、小さな認識ミスが後続の処理全体を狂わせる点にある。たとえば請求書の金額を一桁間違えて抽出すれば、その後の経理処理やレポート作成がすべて誤った情報で進んでしまう。人間なら「明らかにおかしい」と気づくようなエラーでも、AIエージェントは抽出した数値をそのまま信じて処理を続ける。これが企業現場でのAI導入を妨げる最大の障壁となっていた。
OfficeQA Proベンチマークの評価観点とは
Databricksが開発したOfficeQA Proは、こうした実務課題を忠実に再現する評価指標だ。このベンチマークでは、モデルに対して以下の3つの能力が求められる。
- 文書解析(Parsing):スキャンPDFやレガシーファイルから正確に情報を抽出する能力
- 情報検索(Retrieval):長大な文書群の中から必要な情報を見つけ出す能力
- 根拠に基づく推論(Grounded Reasoning):抽出した情報をもとに、論理的な判断や回答を生成する能力
単なる知識クイズではない。バラバラなフォーマットの文書を理解し、複数のステップを経て最終的なアウトプットを出す「エージェントとしての実務能力」が試される設計になっている。
上図のように、GPT-5.5への切り替えによって文書解析のエラーが大幅に減り、後続のワークフロー全体の信頼性が向上した。この改善の背景には、モデルの視覚認識能力と言語理解の統合が進んだことがあると見られている。
GPT-5.5が達成した二つの飛躍的改善

Databricksが報告したGPT-5.5の改善点は、大きく二つの領域に分かれる。一つは文書解析精度の劇的な向上、もう一つは複数ステップのタスクを効率的に管理するオーケストレーション能力の進化だ。
スキャン文書解析の「ステップ関数的」な進歩
Databricksの記事で同社のSinghvi氏が指摘するように、GPT-5.4まではスキャンされた古い文書から数字を正確に読み取れないケースが頻発していた。これに対しGPT-5.5は、古い文書やスキャンPDFの解析において「ステップ関数的な性能向上」を見せたという。「ステップ関数的」とは、なだらかな改善ではなく、階段を一段上がるように非連続的な飛躍があったことを意味する。
この進歩が特に重要なのは、企業が保有する文書の多くが過去の資産だからだ。10年前の契約書、5年前の監査レポート、紙をスキャンしてPDF化した資料。こうした「過去の遺産」を正確に解析できるかどうかが、AIエージェントの実用性を左右する。GPT-5.5はこの壁を一つ越えたと言える。
ムダな遠回りをしないタスク実行能力
もう一つの重要な改善が、複数ステップのタスクを実行する際の軌道(Trajectory)の最適化だ。GPT-5.4では、目的に対して不必要な検索を繰り返す「遠回り」が発生し、非効率な処理経路をたどることがあった。これはエージェントが過剰に「慎重」になりすぎる、あるいは文脈を適切に把握できずに余計な確認作業を挟んでしまう問題だ。
GPT-5.5では、必要な情報を必要なタイミングで的確に取得し、最短のステップでタスクを完了する能力が高まった。追加の監視や人間による修正なしに、複雑なワークフローを完遂できる信頼性が向上している。
この改善は、企業がAIエージェントに求める「人間の監視なしで動く自律性」に直結する。タスクが長引けばそれだけコストも増え、途中で人間が介入する必要性も高まる。GPT-5.5はこの課題に対して明確な前進を示した。
企業ワークフローへの実装、AgentBricksとAI Unity Gateway

DatabricksはGPT-5.5を単独のチャットボットとして使っているわけではない。同社の「AI Unity Gateway」を通じて、AgentBricksやAgent Supervisor APIといったエージェント構築基盤と統合し、実際のビジネスワークフローに組み込んでいる。
AgentBricksとは、Databricksが提供するエージェント構築フレームワークだ。専門特化した複数のエージェントを組み合わせ、複雑な業務プロセスを自動化できる。ここでGPT-5.5は「監督者(Supervisor)」として機能する。各専門エージェントが文書解析やデータ検索、レポート生成といった個別タスクを担当し、GPT-5.5が全体の流れを管理して適切なタイミングで適切なエージェントに指示を出す。このアーキテクチャによって、単一モデルでは扱いきれない複雑な業務フローが実現できる。
この「監督者モデル」のアプローチは、今後の企業向けAI活用の主流になると考えられる。一つの巨大モデルがすべてを処理するのではなく、専門エージェントを束ねる統括役としてLLMを配置する設計だ。GPT-5.5のオーケストレーション能力の向上は、この設計思想と見事にマッチしている。
ナレッジワークにおけるGPT-5.5のインパクト

DatabricksのSinghvi氏は「GPT-5.5は知識作業においてステップ関数的な変化をもたらした」と評している。単に質問に答えるだけでなく、複数の文書を横断して情報を統合し、文脈を理解した上で判断を下す「知識労働の代替」としての性能が大きく向上したという評価だ。
この評価が特に重要なのは、AIが「単なる道具」から「業務のパートナー」へと役割を変えつつあることを示唆しているからだ。従来のAIアシスタントは、人間が明確に指示したタスクを実行するのが限界だった。GPT-5.5を中核に据えたエージェントは、曖昧な指示や複雑な文脈でも自律的に判断し、複数ステップの業務を完遂できる水準に近づきつつある。
日本企業への示唆、データ資産の再活用という視点
この事例から日本企業が学ぶべきポイントは明確だ。多くの企業が「過去の文書資産」を抱えている。紙で保管された契約書、古い基幹システムから出力された帳票、スキャンされたPDFの山。これらをAIで解析し、活用可能なデータに変換する技術が現実のものになりつつある。
ただし注意点もある。GPT-5.5の性能向上が顕著だったのは「スキャン文書の解析」と「複数ステップのオーケストレーション」であり、これはモデル自体の進化に加えて、Databricksのエージェント基盤との統合設計が効いている。単に高性能なLLMを導入するだけでは同様の成果は得られない。データ基盤とエージェント設計の両面からアプローチする必要がある。
この記事のポイント
- GPT-5.5は企業の実務ベンチマークOfficeQA Proでエラーを46%削減し、初めて正解率50%を突破した
- 特にスキャンPDFやレガシー文書の解析精度が飛躍的に向上し、古い文書資産の活用が現実的に
- 複数ステップのタスクを効率的に管理するオーケストレーション能力も改善し、自律的な業務遂行が可能に
- DatabricksではGPT-5.5を監督エージェントとして配置し、専門エージェント群を統括する設計を採用
- 日本企業にとっては、過去の文書資産をAIで再活用できる可能性が開けた事例として注目すべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験