

AWS CloudWatch Omniが登場。AIとチームで行う新しい可観測性
AWSがCloudWatch Omniを発表した。アプリケーションとAIエージェントの両方を監視できる新しい可観測性体験で、チーム全体が同じワークスペースで調査を進められる。
OpenTelemetryベースで構築されており、既存のCloudWatchテレメトリをそのまま活用できる。AWSマネジメントコンソールへのアクセス権限がなくても、専用URLとSSOで利用可能だ。
この記事では、CloudWatch Omniの主要機能、AI調査の仕組み、セットアップ手順、既存環境との関係を解説する。運用チームが抱えるダッシュボード管理や障害調査の負担をどう軽減するかが焦点だ。
CloudWatch Omniとは何か
アプリケーション中心の可観測性
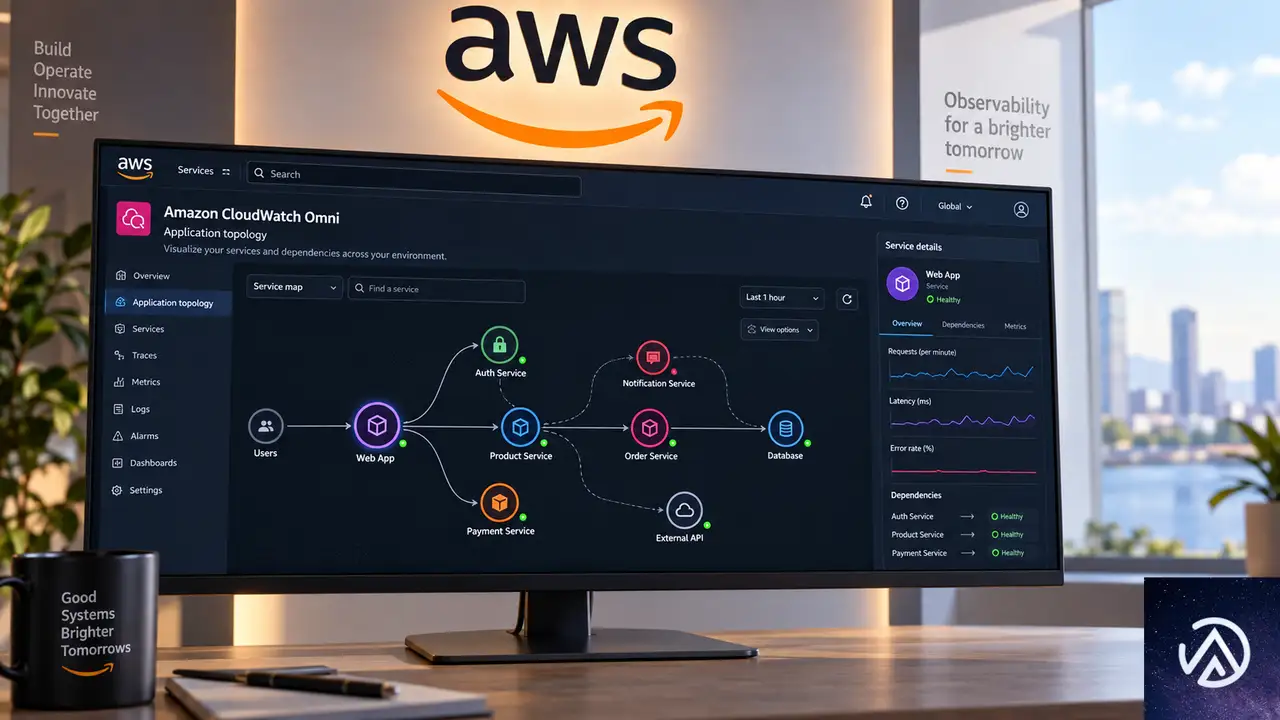
CloudWatch Omniは、インフラストラクチャ単位ではなく、アプリケーション単位でテレメトリを整理する。従来のモニタリングツールはサーバーやコンテナといったリソースごとに指標を表示するが、Omniはサービス同士の依存関係を自動的にマッピングし、システム全体をひとつの接続された構造として見せる。
このアプローチにより、担当者は「どのサーバーでエラーが出たか」ではなく「どのアプリケーションで問題が起きているか」を即座に把握できる。ダッシュボードを手動で更新する手間も減る。
この比較デモは、リソース中心からアプリ中心への考え方の転換を示している。Omniは自動検出とトポロジーマッピングにより、運用者が全体像を維持する負担を軽減する。
OpenTelemetryとの統合
CloudWatch OmniはOpenTelemetryを基盤としている。OpenTelemetryは、メトリクス・ログ・トレースなどのテレメトリデータを収集するためのオープン標準だ。すでにCloudWatchに送信しているテレメトリは、再設定なしでOmniに表示される。
さらに、OpenTelemetryで計装された他のワークロードも、OTLP(OpenTelemetry Protocol)エンドポイントを通じてOmniに取り込める。これにより、オンプレミス環境や別のクラウドで稼働するアプリケーションも同じワークスペースで監視できる。
チーム全体で使える共同作業の仕組み
CloudWatch Omniの大きな特徴は、チーム全員が同じワークスペースを共有できる点にある。エンジニアは専用URLにアクセスし、企業のSSO(シングルサインオン)でログインする。AWSマネジメントコンソールへのアクセス権限は不要だ。
IAM Identity Centerを通じてOktaやAzure ADなどのIDプロバイダーと連携できる。SRE、開発者、データベースエンジニア、マネージャーが同じデータと調査コンテキストを共有する。
このフローは、通常のインシデント対応時にOmniがどのように進行するかを示している。チーム間の引き継ぎ時にコンテキストが失われる問題が解消される。
エスカレーション時の連携強化
障害がチームの境界を越えると、Slackのスレッドやスクリーンショットでの情報共有になりがちだ。Omniでは次の担当者が同じセッションに参加し、これまでの調査内容をそのまま引き継げる。
調査履歴は自動的に記録されるため、インシデントレポートを別途作成する必要もない。
AIが調査を支援するAmazon DevOps Agent
CloudWatch Omniには、Amazon DevOps Agentと呼ばれるAIアシスタントが組み込まれている。調査セッションの中で、シグナルの相関分析や次のアクションの提案を行う。
このエージェントは、エンジニアが見ているのと同じテレメトリデータを参照する。そのため、提案内容はアプリケーションの実際の状態に基づいたものになる。
DevOps Agentは、相関イベントの特定や依存関係グラフを通じた根本原因の追跡を支援する。調査履歴は事後レビューにも活用できる。
エージェントの役割と限界
DevOps Agentはあくまで支援ツールであり、人間の判断を代替するものではない。提案内容をそのまま鵜呑みにするのではなく、エンジニアの専門知識と組み合わせて使うことが重要だ。
また、エージェントはテレメトリデータのみに基づいており、コードのビジネスロジックや組織固有の事情までは考慮しない。この点は運用チームが補完する必要がある。
セットアップ手順
CloudWatch Omniのセットアップは数分で完了する。既存のCloudWatch環境を再設定する必要はない。
既存CloudWatchユーザーの場合
CloudWatchコンソールで「Try CloudWatch Omni」をクリックするだけで、既存のログ、メトリクス、トレース、アラームが即座に利用可能になる。ワークロードは自動的に検出され、アプリケーショントポロジーをすぐに確認できる。
組織全体への展開
管理者はドメインを設定し、IAM Identity Center経由でIDプロバイダーを接続する。その後、チームと環境ごとにSpaceを定義し、ユーザーを招待する。各Spaceは既存のCloudWatchデータを参照するため、データの移動は不要だ。
他環境のアプリケーション取り込み
オンプレミスや他クラウドで稼働するアプリケーションも、コネクターを利用してテレメトリをOmniに取り込める。取得したデータはAWSデータと同じSpaceや調査セッションに表示される。
既存のCloudWatchとの関係と料金
CloudWatch OmniはCloudWatchを置き換えるものではなく、拡張するものだ。既存のアラーム、ダッシュボード、API、コンソールのワークフローはそのまま機能する。
アクセスは専用のWebアプリケーション経由で、エンタープライズSSOに対応する。セットアップ後、DevOps AgentはすべてのOmni調査セッションでデフォルトで有効になる。
料金体系
料金の詳細はAWSの公式価格ページで確認できる。既存のCloudWatchユーザーはコンソールから直接試用できる。
導入コストの見積もりには、監視対象のワークロード数と取り込むテレメトリ量が影響する。
生成AIワークロードへの対応
CloudWatch Omniは、生成AIやエージェントワークロード向けの専用可観測性も提供する。トレース探索、評価フレームワーク、リアルタイムモニタリングが含まれる。
詳細はAWSの別記事で紹介されている。エージェント可観測性のハンズオンも参照できる。
この記事のポイント
- CloudWatch Omniはアプリケーション中心の可観測性を提供する
- OpenTelemetryベースで既存テレメトリを活用できる
- チーム全体が同じワークスペースで共同調査できる
- Amazon DevOps AgentがAI支援で根本原因特定を助ける
- セットアップは数分で完了し、既存環境への影響はない

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubが8月17日の大規模障害を報告。CTOが原因分析と再発防止策を公表
2026年8月17日、GitHubで大規模なサービス障害が発生した。障害から3日後の8月20日、GitHubのCTO(最高技術責任者)であるVlad Fedorov氏が公式ブログで報告記事を公開し、原因分析と今後の再発防止策について言及した。
本記事では、今回の障害から読み取れる大規模プラットフォームの運用課題と、GitHubが示した今後の方向性を整理する。開発者やDevOps担当者にとって、自社システムの信頼性を見直す材料になるはずだ。
障害の概要とCTOによる報告
2026年8月17日に発生した障害は、GitHubの主要サービスに広範な影響を及ぼした。具体的な原因や影響範囲の詳細は記事内で段階的に明らかにされているが、CTO自らが報告に乗り出した点が今回の特徴だ。
CTO Vlad Fedorov氏について
報告記事の著者であるVlad Fedorov氏は、GitHubのCTOとして開発者ツールの未来を率いる立場にある。GitHub入社前はFacebook(現Meta)で上級副社長を12年間務め、プライバシー・広告・プラットフォーム分野で2,000人を超えるエンジニア組織を統率した経験を持つ。さらに前職ではUserCloudsというデータガバナンス関連のスタートアップを共同創業しており、Microsoftでの勤務経験もある。
大規模インフラの運用経験が豊富な人物が障害報告の筆を取ったこと自体、GitHubが今回の障害を単なるインシデントとしてではなく、プラットフォーム全体の信頼性に関わる重要事案として扱っていることを示している。
障害報告のタイミングが示すもの
障害発生は8月17日、報告記事の公開は8月20日。この3日間の間隔は、原因の切り分けと分析に十分な時間をかけたうえで、断定的な情報をまとめてから公表したことを示唆する。大規模障害では初期対応中に誤った情報を出さないことが重要であり、GitHubは原因を確定させたうえで報告に踏み切ったと見られる。
このデモは障害前後の状態を示した概念図である。実際の影響範囲についてはGitHubの公式報告を確認してほしい。
大規模プラットフォーム障害が浮き彫りにする運用課題
GitHubのような大規模プラットフォームの障害は、単一のサービス停止にとどまらない。世界中の開発チームが日々のワークフローをGitHubに依存しているため、障害の影響は連鎖的に広がる。コードのプッシュ、プルリクエストのレビュー、CI/CDパイプラインの実行、ドキュメントの更新など、あらゆる工程が停止する。
依存の集中が生むリスク
開発インフラの集中化は利便性をもたらす一方で、単一障害点を生み出す。多くの企業がGitHubを中心に開発プロセスを構築しているため、GitHubが停止すると自社の開発活動も止まる。この依存関係の深さは、今回の障害でも改めて認識されたはずだ。
インシデント対応における透明性の重要性
CTOが公式ブログで詳細な報告を行う姿勢は、インシデント対応における透明性の重要性を示している。障害の原因を隠さず、技術的な分析結果を公開することで、利用者の信頼を維持する狙いがある。GitHubのこの対応は、他社のインシデント報告の手本にもなるだろう。
上図は大規模障害から得られる一般的な教訓を整理したものだ。GitHubの報告でも、これらの要素がどのように現れたのかが焦点となる。
GitHubが示す今後の取り組み
記事タイトルにある「the work ahead(今後の取り組み)」という表現から、GitHubは今回の障害を教訓として、具体的な改善策を打ち出していることが読み取れる。詳細な技術的対策は記事内で段階的に説明されているものとみられるが、大規模プラットフォームの再発防止策として、以下の方向性が考えられる。
インフラの冗長化と障害分離
大規模障害の再発防止には、インフラの冗長化が不可欠だ。特定のコンポーネントに障害が発生しても、他のコンポーネントが機能を維持できる構成が求められる。GitHubのような複数のサービスが連携するプラットフォームでは、障害の影響を局所化するための仕組みも重要になる。
監視・検知体制の強化
障害の早期検知は被害を最小限に抑える鍵を握る。異常をリアルタイムで検知し、自動的にフェイルオーバーを実行する仕組みは、大規模プラットフォームの必須要件だ。今回の障害を踏まえ、GitHubは監視体制の見直しにも着手していると考えられる。
上図は大規模プラットフォームにおける障害対応の理想的なフローを示している。GitHubの報告では、今回の障害でどのステップに課題があったのかが分析されていると考えられる。
開発者と企業が取るべき対策
GitHubの障害は、プラットフォームに依存するすべての開発者と企業に影響を与える。自社の開発インフラを見直す契機として、いくつかの対策が有効だ。
外部依存のリスク評価
まず自社の開発プロセスがどの外部サービスに依存しているかを洗い出す必要がある。GitHubだけでなく、CI/CDツール、クラウドサービス、パッケージレジストリなど、開発ワークフローの各段階で外部依存が存在する。それぞれのサービスに障害が発生した場合の影響を評価し、必要に応じて代替手段を用意しておくことが重要だ。
バックアップと代替ワークフローの整備
GitHubが停止した場合でも開発を継続できるよう、ローカルリポジトリの保持やミラーの活用を検討する価値がある。完全な代替は難しくても、緊急時の手順を文書化しておくだけで、障害発生時の混乱を大幅に減らせる。
この記事のポイント
- GitHubで2026年8月17日に大規模障害が発生し、CTOのVlad Fedorov氏が3日後に報告記事を公開した
- CTO自らが報告に乗り出したことは、GitHubが信頼性を最優先事項と位置づけていることの表れである
- 大規模プラットフォームの障害は単一障害点のリスクと透明性の重要性を改めて示した
- GitHubは「今後の取り組み」としてインフラの冗長化と監視体制の強化を進めると見られる
- 開発者と企業は外部依存のリスクを評価し、緊急時の代替ワークフローを整備しておくべきだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Supabase Evals公開、AIエージェントのコード品質を自動評価する基盤
Supabaseが2026年7月31日、AIコーディングエージェント向けの評価フレームワーク「Supabase Evals」をオープンソースで公開した。Claude CodeやCodex、OpenCodeといった主要エージェントを使い、実際のSupabaseプロジェクト開発を自動で試行し、その成否を定量的に測る仕組みだ。
このフレームワークは、エージェントがデータベーススキーマの構築やEdge Functionsのデバッグ、RLSポリシーの修正といったタスクをどれだけ正確にこなせるかを評価する。公開されたベンチマーク結果は誰でも閲覧でき、エージェントの得意分野や弱点が数値で把握できる。
なぜSupabaseがこの基盤を作ったのか。AIを使ってSupabase上にアプリを構築する開発者が急増する中、エージェントの「実力」を正確に把握し、改善につなげる必要があった。本記事ではその仕組みと、初期の評価で明らかになったエージェントの弱点、そして今後の展望を解説する。
Supabase Evalsが目指すもの
Supabase Evalsは、AIコーディングエージェントがSupabaseを使った開発タスクを実行する際のパフォーマンスを評価するためのフレームワークだ。ベンチマークテストとリグレッション(回帰)テストの2つのスイートを持ち、エージェントの実力を多角的に測る。
具体的には、エージェントがCLIやMCPサーバー、各種ドキュメントを活用しながらスキーマ設計やEdge Functionsの作成、RLSポリシーの修正などを行う。その結果を「ユーザーが特定のデータにアクセスできるか」「Edge Functionが期待通りのレスポンスを返すか」といった決定論的なチェックと、LLMによる判定(LLM-as-a-judge)でスコア化する。
この基盤は、Supabaseが公開する公式ベンチマークのほか、日次で動作する内部のリグレッションスイートにも利用されている。これにより、新しい機能がエージェントの動作を悪化させていないかを継続的に監視できる。
なぜ今、AIエージェント評価基盤が必要なのか

AIコーディングエージェントを使った開発は日常化しつつある。SupabaseのCLIやMCPサーバー、エージェントスキル、ドキュメントを介してエージェントがプロジェクトを構築するケースが増えてきた。しかし、各エージェントがどこでつまずき、どの機能がうまく使えていないのかを体系的に把握する手段が不足していた。
Supabaseの公式ブログ記事によれば、エージェントが苦手とするパターンを特定し、それを修正した上で再発防止(リグレッション)を確認するサイクルを回すことが目的だ。単一のツールだけではなく、Supabaseが提供するすべてのインターフェースを横断的に評価できる点が特徴である。
従来は開発者自身が手動でコードを書く前提だったため、エージェントに特化したテスト基盤は存在しなかった。Evalsの登場により、AI時代の開発者体験を数値で議論できる土台が整ったと言える。
評価の仕組みとベンチマーク/リグレッションの二層構造

このフレームワークでは、エージェントが実際のSupabase環境で作業するため、机上の空論ではない実用的な評価が可能だ。テスト結果はWebアプリで可視化され、誰でも確認できる。
初期ベンチマークが明らかにしたAIエージェントの弱点

スキル読み込みの効果は想定以上に限定的、ただしドキュメント参照は改善
Supabase Evalsのベンチマーク結果では、エージェントがスキル(エージェント向けの最適化ガイド)を読み込んでいない状態でも、多くのシナリオをクリアできることがわかった。ビルド段階では、Opus 5とKimi K3がスキルなしで100%のスコアを達成している。
スキル読み込みの効果は限定的だが、Sonnet 5は78%から100%へ、GPT-5.6 Solは89%から100%へ、GPT-5.4 miniは78%から89%へと改善した。特に、スキルを有効にするとSupabaseドキュメントの参照頻度が一貫して増え、古い事前学習知識を上書きする必要があるエッジケースで差がついた形だ。
宣言的スキーマを使わず、マイグレーションを手書きする傾向
Supabaseには宣言的スキーマという、データベースの構造を一つのファイルで管理できる仕組みがある。本来は複数のマイグレーションファイルをつなぎ合わせるより効率的だが、エージェントは既に宣言的スキーマが使われているプロジェクトでも、手書きのマイグレーションを作成しようとする傾向があった。
この問題を受け、Supabaseはエージェントスキルの中で「どのワークフローを選ぶべきか」の指針を明確に改訂し、Evalsを使って修正が正しく反映されたことを確認した。
新しいライブラリ「@supabase/server」の発見率が低い
Supabaseは最近、Edge Functionsを安全に書くためのボイラープレートを簡略化する@supabase/serverパッケージをリリースした。しかし、エージェントは依然としてsupabase-jsを使い、手動で認証を検証する方法を選んでしまう。
このためSupabaseは「どのパッケージを選ぶべきか」を解説する専用ガイドを公開し、エージェントの判断材料として提供している。
Postgresベストプラクティススキルの有効化が不安定
Evalsは、エージェントがセッション中にどのスキルを読み込んだかを追跡している。主要な「supabase」スキルはほぼ常に読み込まれるのに対し、Postgresのベストプラクティスを教えるスキルは当初、約1割のシナリオでしか有効化されなかった。
スキルの説明文を具体的なトリガーで書き直した結果、有効化率は60%まで向上したが、それでもOpenAIモデルの方がより安定してスキルを活用する傾向が見られる。
ドキュメント参照の頻度に大きなばらつき
Evalsの実行中、エージェントがSupabaseドキュメントを読む頻度も測定している。CodexベースのエージェントはClaude Codeよりもドキュメントをチェックする傾向があり、最も高性能なOpenAIモデルは毎シナリオ約8ページを読むのに対し、Claude Codeは約2ページにとどまる。
しかもClaude Codeはスキルを読み込んでいても、40%未満のシナリオでしかドキュメントを確認しない。Supabaseはエージェントが必要な情報を確実に見つけられるよう、改善を進めている。
AIエージェント時代のSupabase開発体験を支える展望
Supabase Evalsはまだ出発点に過ぎない。今後はエッジケースのカバレッジを広げ、エージェントやプロダクトの進化に合わせて新しいシナリオを追加していく計画だ。スコアリングの精度と安定性も引き続き強化される。
また、内部のリグレッションシナリオのなかで信頼性が確認されたものは、順次公開ベンチマークへと格上げされる方針である。さらに、エージェントがタスクに失敗した際にフィードバックを提出できるCLIコマンドやMCPツールも開発中で、これにより次の改善優先度をデータドリブンに決定できるようになる見込みだ。
AIコーディングエージェントを本格的にプロダクト開発に組み込むチームにとって、Supabase Evalsは「エージェントが何を得意とし、どこでつまずくのか」を数値で判断する貴重な羅針盤になる。公開されたベンチマークはsupabase.com/evalsで誰でも確認できる。
この記事のポイント
- SupabaseがAIコーディングエージェント向け評価フレームワーク「Supabase Evals」をOSS公開
- 実際のSupabase環境でエージェントを動作させ、ベンチマークとリグレッションの2層でスコア化
- 初期のベンチマークでは、スキル無しでも高スコアの一方、宣言的スキーマの無視や新ライブラリの未発見など弱点が判明
- ドキュメント参照頻度のばらつきやスキル活性化の不安定さも浮き彫りに
- 今後はエッジケースの拡充やエージェントからのフィードバック収集機能の追加を予定
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Vercel Sandboxの永続化機能が正式版に、環境構築の手間を大幅削減
Vercelが提供するクラウド開発環境「Vercel Sandbox」において、filesystemの状態をセッション間で自動保存する永続化機能が正式版(GA)となった。2026年5月26日の発表だ。開発者はこれまで、Sandboxを再起動するたびに依存パッケージのインストールやファイル配置をやり直す必要があったが、今回のアップデートでその手間が大幅に削減される。
永続化はデフォルトで有効化されており、スナップショットの取得や状態管理を手動で行う必要はない。Sandboxに一意の名前を付与すれば、その名前をキーとして環境を再開できる仕組みだ。セッションの起動と停止はVercel側で自動的に処理されるため、開発者はワークフローを中断されることなく作業を継続できる。
Sandbox永続化が解決する課題

クラウドベースの開発環境において、セッション終了後の状態消失は長年の課題だった。従来のVercel Sandboxでは、セッションが終了するたびにfilesystem上の全データが破棄されていた。このため、毎回の起動時に再度依存関係のインストールや環境設定を行う必要があり、開発開始までの待ち時間が大きな非効率を生んでいた。
永続化機能は、この問題に対する直接的な解決策だ。Sandboxのfilesystem状態が自動的にスナップショットとして保存され、次回セッション開始時に自動復元される。スナップショットはユーザーが明示的に操作する必要はなく、セッション終了時に自動取得される仕組みである。これにより、npmパッケージのインストールやプロジェクトファイルの配置といった繰り返し作業から開発者が解放される。
※毎回セッション開始時に環境構築が必要。待ち時間が発生し、開発効率が低下する
※前回の状態が自動的に復元される。セットアップ不要で作業を継続できる
この変化は、継続的な開発やCI/CDパイプラインでの自動テストなど、頻繁な環境再作成が発生するシナリオで特に効果を発揮する。
永続的Sandboxの作成と利用

デフォルトで有効化される永続性
Sandbox.create()を呼び出す際、永続化は自動的に有効になる。特別な設定やオプションの指定は不要だ。作成時にnameパラメータで一意の名前を付与すれば、その名前がプロジェクト内での参照キーとなる。この名前は後から変更することも可能であり、プロジェクトの命名規則に合わせた管理ができる。
名前付きSandboxは単なる識別子以上の役割を持つ。チーム内で「staging-test」「feature-auth」といった意味のある名前を付けることで、目的に応じた環境の使い分けが容易になる。また、存在しない名前を指定した場合は新規作成、既存の名前を指定した場合は既存環境の復元と、名前ベースの直感的な操作が可能だ。
import { Sandbox } from "@vercel/sandbox";

// filesystemは自動的にスナップショット保存される
const sandbox = await Sandbox.create({ name: "my-sandbox" });

await sandbox.runCommand("npm", ["install"]);

await sandbox.stop();上記のコードでは、npm installでインストールされた依存パッケージが自動的にスナップショットとして保存される。次回Sandbox.get({ name: "my-sandbox" })で取得した際には、インストール済みの状態から即座に作業を再開できる。
ステートレスSandboxとの使い分け
永続化は便利だが、すべてのユースケースで必要とは限らない。一時的な検証や使い捨てのテスト環境では、永続化を無効にすることでスナップショット保存にかかるストレージコストを節約できる。スナップショットストレージはコンピューティングリソースとは別の課金体系であり、不要な保存はコスト増につながるためだ。
import { Sandbox } from "@vercel/sandbox";

const sandbox = await Sandbox.create({ persistent: false });

// 既存のSandboxを後から変更することも可能
await sandbox.update({ persistent: false });CLIを利用する場合は、sandbox createコマンドに--non-persistentフラグを付与する。非永続的Sandboxはセッション終了時にfilesystemが完全に破棄されるため、機密データを含む一時的なテストや、毎回クリーンな状態から始めたいCIジョブに適している。
● チーム共有の検証環境
● 長期メンテナンスのテスト環境
● クリーン状態が必要なCIジョブ
● 機密データを含む一時テスト
この使い分けにより、必要な場面では永続化の利便性を享受しつつ、不要な場面ではコストを最適化できる。開発の初期段階で「この環境は使い続けるか、それとも一度限りか」を判断基準にするのが実践的なアプローチだ。
セッション再開の仕組み

永続化されたSandboxの再開は完全に自動化されている。停止中のSandboxに対してrunCommand()やwriteFiles()などの操作を呼び出すと、最新のスナップショットから自動的に新しいセッションが開始される。開発者が明示的に「再開」を指示する必要はなく、操作の実行がトリガーとなって透過的に処理される。
import { Sandbox } from "@vercel/sandbox";

const resumedSandbox = await Sandbox.get({ name: "my-sandbox" });

// 自動的にSandboxが再開される
await resumedSandbox.runCommand("npm", ["test"]);Sandbox.get()で取得した段階ではまだセッションは開始されておらず、実際にコマンドを実行するタイミングでバックグラウンドで復元処理が走る。この遅延実行モデルにより、不要なセッション起動を避け、リソースの効率的な利用が可能になる。復元にかかる時間はスナップショットのサイズに依存するが、一般的なプロジェクト規模であれば数秒から十数秒程度で完了する。
この設計の利点は、開発者が環境のライフサイクル管理から解放される点にある。「今このSandboxは起動しているか」「停止状態からどう再開するか」といった状態管理の認知負荷がなくなり、コードの記述やテストの実行といった本質的な作業に集中できる。
コスト管理とスナップショットストレージの最適化

永続化機能の利用にあたって注意すべき点は、スナップショットストレージの課金だ。Vercel Sandboxの料金体系では、コンピューティングリソースとスナップショットストレージが別々に課金される。永続化を有効にしたSandboxが増えるほど、保存されるスナップショットの総容量も増加し、それに比例してコストが発生する。
では、どのようにコストを最適化すればよいのか。以下の方針が実践的だ。
● npm install に30秒以上かかる大規模プロジェクト
● チームメンバー間で共有する標準環境
● PRごとに自動生成されるCI環境
● 依存関係がほぼない小規模スクリプトの実行
実際の運用では、Sandbox.update({ persistent: false })を使って後から設定を切り替えられるため、最初は永続化ありで作成し、不要と判断した時点で無効化する柔軟な運用が可能だ。また、Sandbox.delete()を使えば不要になったSandboxとそのスナップショットを完全に削除でき、ストレージの無駄遣いを防げる。
スナップショットの保存間隔や保持数については、現時点ではセッション終了時に自動取得される仕組みのみが提供されている。将来的にはスナップショット取得のタイミングを制御するオプションが追加される可能性もあるが、現行バージョンではシンプルに「停止時保存」のモデルで統一されている。このシンプルさが、開発者の意思決定コストを下げている面もある。
その他の重要な改善点

今回のGAリリースでは、永続化機能に加えていくつかの重要なAPI拡張も同時に提供されている。これらは永続化機能と組み合わせることで、より柔軟なSandbox管理を実現する。
Sandbox.fork() による環境の複製
既存のSandboxから新しいSandboxを作成するSandbox.fork()が追加された。特定の時点の環境を複製し、そこから別の検証を分岐させたいケースで役立つ。たとえば、メインの開発環境から「機能Aの実験用」「機能Bの実験用」をそれぞれフォークし、独立してテストを進められる。
Sandbox.getOrCreate() の冪等性
Sandbox.getOrCreate()は、指定した名前のSandboxが存在すれば取得し、存在しなければ新規作成する冪等な操作を提供する。CI/CDパイプラインでの環境セットアップスクリプトなど、「あれば使う、なければ作る」というパターンが1行で完結する。エラーハンドリングの分岐を書く必要がなくなり、コードの可読性が向上する。
ライフサイクルフックとタグ機能
onCreateおよびonResumeフックが追加され、Sandboxの作成時や再開時に任意の処理を挿入できるようになった。環境変数の動的設定や、起動時チェックの自動実行など、プロジェクト固有の初期化処理を組み込める。また、Tags機能によりSandboxにカスタムプロパティを付与でき、マルチテナント環境での追跡や分類が容易になる。たとえば「environment: staging」「team: frontend」といったタグを付けてフィルタリングすることが可能だ。
実践的な活用シナリオ

永続化機能の登場により、Vercel Sandboxの適用範囲は大きく広がる。ここでは具体的な活用シナリオをいくつか挙げる。
すべての依存パッケージがインストール済みのSandboxをSandbox.fork()でメンバーに配布。環境構築の時間をゼロにし、全員が同一条件で開発を始められる。新メンバーのオンボーディング時間も大幅に短縮される。
テストスイートの実行環境を永続化し、依存パッケージのインストール時間を削減。PRごとにSandbox.getOrCreate()で専用環境を用意し、テスト実行後のクリーンアップもSandbox.delete()で自動化できる。
報告されたバグの発生環境をSandboxで再現し、そのまま永続化。修正パッチの検証が完了するまで環境を保持し、必要に応じてSandbox.fork()で別の修正アプローチも並行テストできる。
これらのシナリオに共通する利点は、「環境の再現性」と「セットアップ時間のゼロ化」だ。特にマイクロサービスアーキテクチャのように複数の依存関係が絡むプロジェクトでは、個々の開発者がローカルで依存関係を解決するよりも、クラウド上の永続化環境を共有する方が圧倒的に効率的なケースが多い。
この記事のポイント
- Vercel Sandboxの永続化機能が正式版となり、セッション間のfilesystem自動保存がデフォルトで有効化された
- 名前ベースのSandbox管理で環境の作成・取得・再開が直感的に行え、スナップショット操作は完全自動化されている
- 永続的Sandboxと非永続的Sandboxの使い分けにより、利便性とコスト最適化のバランスが取れる
- forkやgetOrCreateなどのAPI拡張で、チーム開発やCI/CDパイプラインへの統合がより容易になった
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

DockerがカスタムMCPカタログとプロファイルを正式提供、企業のAIツール管理が新段階へ
Dockerは2026年5月15日、MCP(Model Context Protocol)サーバーを管理する「カスタムカタログ」と「プロファイル」の一般提供を開始した。組織はこれらを使ってMCPサーバー群を一元的に管理し、開発者は作業内容に応じたツール構成を簡単に切り替えられるようになる。
この発表の背景には、企業へのMCP導入が進むにつれて「誰がどのMCPサーバーを信頼して使うべきか」という調整コストが急増していた現実がある。Dockerの新機能は、プラットフォームチームが推奨するツール群を「カタログ」として配布し、現場の開発者が「プロファイル」で自由に組み替えるという二層構造でこの課題を解決する。
MCP活用の壁とDockerの解決策

MCPはAIエージェントが外部ツールやデータソースと対話するための標準プロトコルだ。ChatGPTのプラグイン機能に相当するが、ベンダーに依存せずオープンな仕様で設計されている。Dockerは2025年後半からMCPサーバーの統合管理機能「MCPカタログ」を提供してきたが、公開サーバーだけでは社内ツールや独自要件に対応しきれないという声が増えていた。
特に大きかったのは「全社で使える信頼済みリストがほしい」というニーズと「開発者個人のワークフローに合わせた構成を使いたい」というニーズのせめぎ合いだ。前者を強めると開発者の自由度が下がり、後者を優先するとセキュリティ基準が守れなくなる。Dockerが今回一般提供を始めたカスタムカタログとプロファイルは、この二つを両立させるインフラにあたる。
カスタムカタログとプロファイルの役割分担
カスタムカタログは「組織が推奨するMCPサーバーの集合」を定義し、OCIアーティファクトとして配布できる仕組みだ。プロファイルは個人がカタログから選んだサーバー群を「コーディング用」「企画用」といった用途別にまとめ、クライアント(Claude Codeなどのエージェント)に切り替えて接続できる。
この二層構造によって「組織が定める信頼の枠組み」と「個人が工夫する効率化」が衝突しなくなる点が最大の価値だ。プラットフォームチームはガードレールを引き、開発者はその中で自由にツールを組み替える。
カスタムMCPカタログの作成と配布手順

Dockerの公式ブログで解説されている手順に沿って、実際にカスタムカタログを作成する流れを見ていこう。ここではDocker Hubをレジストリとして使う例だが、プライベートレジストリにも対応する。
ステップ1 自前のMCPサーバーをイメージ化する
まず、組織内で使いたい独自のMCPサーバーをDockerイメージとしてビルドし、レジストリにプッシュしておく。Dockerの解説では、さいころを振るroll-diceというサンプルサーバーが使われている。stdioで通信する標準的なMCPサーバーであり、Dockerfileからイメージを作成する手順は通常のコンテナ開発と変わらない。
イメージが用意できたら、そのサーバーのメタデータをYAMLファイルに記述する。ファイル名や格納場所は任意だ。
name: roll-dice
title: Roll Dice
type: server
image: roberthouse224/mcp-dice@latest
description: An mcp server that can roll dice
このYAMLにはサーバーの識別名、表示タイトル、Dockerイメージの参照先、説明文が含まれる。実際の運用では、ここにアクセス権限や設定パラメータのメタ情報を追加することも考えられる。
ステップ2 Docker MCPカタログと自前サーバーを束ねる
次に、docker mcp catalog createコマンドを使ってカスタムカタログを作成する。引数にはDocker公式カタログから取り込みたいサーバーと、先ほど用意したYAMLファイルのパスを指定する。
docker mcp catalog create roberthouse224/our-catalog \
  --title "Our Catalog" \
  --server catalog://mcp/docker-mcp-catalog/playwright \
  --server catalog://mcp/docker-mcp-catalog/github-official \
  --server catalog://mcp/docker-mcp-catalog/context7 \
  --server catalog://mcp/docker-mcp-catalog/atlassian \
  --server catalog://mcp/docker-mcp-catalog/notion \
  --server catalog://mcp/docker-mcp-catalog/markitdown \
--server file://./mcp-dice.yamlcatalog://スキームでDockerの公式カタログから既存のサーバーを取り込み、file://スキームで自作サーバーのメタデータを追加している。このカタログはローカルマシン上にOCIアーティファクトとして作成され、docker mcp catalog showで内容を確認できる。
ステップ3 カタログをレジストリで共有する
作成したカタログは、docker mcp catalog pushでDocker Hubやプライベートレジストリにプッシュすれば即座に共有可能になる。OCIアーティファクトとしての配布は、組織内のリポジトリアクセス権限をそのまま使えるため、追加のインフラ管理が不要だ。
docker mcp catalog push roberthouse224/our-catalogこれで、組織内の他メンバーはDocker Desktopの「カタログインポート」機能か、docker mcp catalog pullコマンドでこのカタログを取得できる。公式カタログにはない社内ツールが含まれている点、すべてのサーバーが組織としての信頼審査を通過している点が、単なる公開カタログとの決定的な違いだ。
カスタムカタログがエンタープライズにもたらす意味

ここで一歩引いて、この機能が企業のAI活用に何をもたらすかを考えてみたい。単なる「MCPサーバーリストの共有」に見えるが、実際にはもっと大きな変化の起点になる。
第一に、MCPサーバーの発見と評価にかかるコストが大幅に下がる。開発者がインターネット上からMCPサーバーを探して安全性を個別に判断する必要がなくなり、組織が「使ってよいもの」をあらかじめ提示できる。これはソフトウェアサプライチェーン管理の考え方をAIツールに応用したものとも言える。
第二に、プライベートレジストリと組み合わせれば、社内限定のAIツールを企業秘密として保護しながら配布できる。たとえば自社データベースに特化したMCPサーバーを、アクセス権のあるメンバーだけに提供する使い方が想定される。Dockerのブログでも「プライベートカタログ」という方向性が示唆されている。
第三に、OCIアーティファクトという既存の業界標準に乗っていることが地味ながら重要だ。組織はすでにコンテナレジストリの運用ノウハウとアクセス管理の仕組みを持っている。それをそのままMCPに転用できるため、新たに専用の配信インフラを構築する必要がない。
このようにカスタムカタログは「野良ツールの乱立を防ぎつつ、社内イノベーションを促進する」バランサーとして機能する。とはいえ、カタログで提供されるのはあくまで「選択肢の集合」だ。実際の作業でどのツールをどう組み合わせるかは、次のプロファイル機能が受け持つ。
MCPプロファイルで個人ワークフローを最適化する

プロファイルは、カタログから選んだMCPサーバー群を「コーディング」「企画」「調査」などの用途別に束ね、任意のAIクライアントに接続できる仕組みだ。特定のプロファイルには必要なツールだけが含まれるため、エージェントのコンテキストウィンドウを無駄に消費しない利点がある。
作業モードの切り替えを数クリックで実現
Docker Desktop 4.63から利用できるプロファイル機能の基本動作はシンプルだ。カスタムカタログを開き、使いたいサーバーを選択して「新しいプロファイル」を作成する。プロファイルには接続先クライアント(Claude Codeなど)を指定できるが、後から付け替えることも可能だ。
たとえば、Playwright、GitHub、Context7を含む「コーディング」プロファイルと、Atlassian、Markitdown、Notionを含む「企画」プロファイルを別々に作っておけば、作業内容に応じてクライアントの接続先を切り替えるだけでツール環境が丸ごと入れ替わる。これまではツールセットを切り替えるたびに再設定が必要だったが、プロファイルによりワンアクションで済む。
設定の保存と再利用で反復作業を削減
プロファイルのもう一つの利点は、MCPサーバーの設定を永続化できることだ。Markitdownサーバーにアクセス可能なディレクトリパスを指定する場合や、GitHubサーバーのうち使うツールをget_meだけに絞る場合など、一度設定した内容はプロファイルに保存される。これにより、毎回手動で同じ設定を繰り返す手間が省ける。
コンテキストウィンドウの最適化という観点では、大量のツールをエクスポートするMCPサーバーに対して「このタスクではツールAとBだけ有効化する」と制限できる点が実用的だ。エージェントの推論性能を落とさず、必要な機能だけに集中させられる。この仕組みは、社内開発するMCPサーバーにリッチな設定オプションを持たせることで、さらに強力な再利用性を発揮するだろう。
上図のように、同じカタログから異なるプロファイルを複数作成し、用途に応じて切り替える運用が基本スタイルになる。この考え方は、VS Codeのワークスペース設定や、ターミナルのプロファイル管理に近い。AIエージェント時代の「作業環境テンプレート」と捉えるとわかりやすいだろう。
プロファイルの共有と今後の展望

プロファイルもカスタムカタログと同様、OCIアーティファクトとしてレジストリで共有できる。docker mcp profile pushでプッシュすれば、チームメンバーはdocker mcp profile pullで即座に同じツール構成を手に入れられる。うまくいった設定を「テンプレート」として展開できるこの仕組みは、プロジェクト立ち上げ時の環境構築コストを大幅に下げる。
docker mcp profile push coding your-namespace/codingDockerは今後、以下の方向性でカスタムカタログとプロファイルを拡張していくとしている。
- ガバナンスとポリシー制御により、承認されたカスタムカタログ以外からのMCP利用を制限
- カタログとプロファイルのディスカバビリティを向上し、実績のある構成を見つけやすくする
- プロファイルスコープでのシークレット・設定値管理を強化し、セキュアな代替手段として整備
- エージェントスキルとの連携により、プロファイルを依存関係として参照するワークフロー
特に最後の「エージェントスキルがプロファイルを依存関係として参照する」という構想は興味深い。たとえば「データ分析スキル」が起動するときに、必要なMCPサーバー構成をプロファイルから自動で引き込むといった使い方が想定されている。これが実現すれば、AIエージェントが自律的に必要なツールを調達して動く世界がさらに近づく。
この記事のポイント
- DockerがカスタムMCPカタログとプロファイルの一般提供を開始し、企業のAIツール管理に新たな基盤が加わった
- カスタムカタログは組織が信頼するMCPサーバー群をOCIアーティファクトで配布し、発見コストとセキュリティリスクを同時に下げる
- プロファイルは個人が用途別にツール構成を保存・切り替えできる仕組みで、コンテキスト最適化にも有効
- 両方ともOCIアーティファクトで共有可能なため、既存のコンテナレジストリ運用の延長でチーム展開できる
- 今後のポリシー制御やエージェントスキル連携により、エンタープライズMCPのガバナンス基盤として発展が見込まれる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS MCP Serverが一般提供開始、AIエージェントのAWS操作を安全・効率的に
AWSは2026年5月6日、AIエージェント向けのマネージドサービス「AWS MCP Server」の一般提供を開始した。AIコーディングアシスタントがAWSの各種サービスを安全に呼び出し、最新ドキュメントを参照し、必要ならサンドボックス内でスクリプトを実行できるようになる。
これまではAIエージェントがAWSを操作しようとしても、訓練データが古く、IAMポリシーが過剰になりがちだった。本サーバーはそうした課題を解決し、本番環境でも使えるレベルのインフラコード生成を後押しする。
本記事ではAWS MCP Serverの機能、GAで追加された新要素、具体的な利用手順、対応ツール、料金までを詳しく解説する。
AWS MCP Serverの概要

MCP(Model Context Protocol)は、AIエージェントが外部サービスやツールと安全にやり取りするための標準プロトコルだ。AWS MCP Serverはこのプロトコルに準拠したマネージド型のリモートサーバーであり、数個の固定ツールを通じて1万5000を超えるAWS APIへのアクセスを提供する。
AIコーディングアシスタントは多くの場合、訓練データに依存するため、2025年後半以降に登場した新サービス(Amazon S3 VectorsやAurora DSQLなど)を知らない。また、インフラ構築時にAWS CLIを好み、AWS CDKやCloudFormationといったIaCツールを使わない傾向があった。生成されるIAMポリシーも権限が広すぎるなど、デモ用には動いても本番投入は難しい状態だった。
この仕組みにより、AIエージェントは常に最新の情報と最小権限でAWSリソースを操作できる。ツールの数が少なく固定されているため、モデルのコンテキストウィンドウを圧迫せず、ハルシネーション(誤った回答の生成)も抑えられる。
GAで追加された主な機能

プレビュー期間を経て正式提供となったAWS MCP Serverでは、以下の機能が新たに導入されている。
IAMコンテキストキーのサポート
従来はMCPサーバー自体の利用に専用のIAM権限が必要だったが、今回からIAMコンテキストキーに対応した。これにより、通常のIAMポリシーの中で「特定のユーザーは更新系APIを許可、MCPサーバー経由では読み取り専用」といったきめ細かい制御が可能になる。余分な権限管理の手間が減り、セキュリティ設計がシンプルになる。
ドキュメント検索の認証不要化
search_documentationおよびread_documentationツールが、認証なしでも利用できるようになった。これにより、まだAWSアカウントを持っていない段階でも、AIエージェントは最新のAWSドキュメントを参照して設計や調査を行える。
トークン消費の最適化
インタラクションあたりのトークン消費量が削減された。マルチステップのワークフローを伴う複雑なタスクでは、モデルのコンテキストウィンドウがすぐに埋まりがちだったが、今回の改善でより長い会話を維持しやすくなっている。
run_scriptツールとサンドボックス実行

GAの大きな目玉がrun_scriptツールの追加だ。AIエージェントは短いPythonスクリプトを記述し、MCPサーバー側のサンドボックス環境で実行させることができる。このサンドボックスは呼び出し元のIAM権限を継承するが、ネットワークアクセスは一切持たない。つまり、エージェントはAWSリソースのデータを処理できるものの、ローカルのファイルシステムやシェルには触れない。
…
# 複数APIを組み合わせた処理を1回のラウンドトリップで
従来、エージェントが複数のAPIを呼び出してデータを結合する場合、1つずつリクエストを送っては応答を待つ必要があり、時間もトークンも浪費していた。run_scriptを使えば、1回のラウンドトリップで一連の処理を完結させられる。これにより、処理速度とコンテキスト効率の両方が大幅に向上する。
Skillsによるベストプラクティスの提供

プレビュー版では「Agent SOPs」という形式でガイダンスが提供されていたが、GAではより洗練された「Skills」に移行した。Skillsは、エージェントがよく間違えるタスクに対して、AWSの各サービスチームがメンテナンスする検証済みのベストプラクティスを提供する。
スキルにより生成されるコードの品質が安定し、エラーやトークンの無駄も減る。ツール一覧を短く保ちつつ、必要なガイダンスをピンポイントで渡せるため、エージェントの挙動が予測しやすくなり、無駄な試行錯誤も抑制される。
エンタープライズの現場では、開発者の数だけ書き方がバラバラになりがちだが、Skillsによってサービスチーム公認のパターンがチーム全体に自然と浸透する。結果として、セキュリティレビューの工数も削減できるだろう。
セキュリティと監査の仕組み

AWS MCP Serverは、ユーザーが直接操作する時とAIエージェント経由の操作を明確に区別できる設計になっている。IAMポリシーやSCP(Service Control Policies)を使って、特定のユーザーには全操作を許可しつつ、MCPサーバーには読み取り専用のみ許可する、といった制御が可能だ。
さらに、AWS-MCP名前空間のAmazon CloudWatchメトリクスが提供され、MCPサーバー経由のAPIコールと人間による直接のAPIコールを分離して監視できる。AWS CloudTrailもすべてのAPI呼び出しを記録するため、コンプライアンスチームが求める監査証跡を完全な形で確保できる。
このように、AIエージェントが安全にインフラを操作できる環境が整ったことで、これまで人間の開発者しか触れなかった本番環境へのAI活用も現実味を帯びてきた。
利用方法と対応ツール
AWS MCP Serverは、MCPに対応するあらゆるAIコーディングツールから利用できる。Claude Code、Cursor、Kiro、OpenAI Codexなど、主要なアシスタントはすでにサポートしている。
セットアップは非常にシンプルだ。AWS MCP ServerはIAM SigV4認証を利用するが、多くのMCPクライアントはOAuth 2.1のみに対応している。そのため、オープンソースの「MCP Proxy for AWS」を使ってIAM認証をOAuthにブリッジする。具体的には以下のようなコマンドで設定する。
curl -LsSf https://astral.sh/uv/install.sh | sh
claude mcp add-json aws-mcp --scope user \
   '{"command":"uvx","args":["mcp-proxy-for-aws@latest","https://aws-mcp.us-east-1.api.aws/mcp","--metadata","AWS_REGION=us-west-2"]}'
/mcpコマンドを実行すると、AWS MCP Serverが利用可能なツール一覧が表示される。search_documentationツールを呼び出し、最新のS3 Vectorsの情報をもとに回答を生成する。プロキシはローカルマシン上で動作し、MCPサーバーのエンドポイントとしてhttps://aws-mcp.us-east-1.api.aws/mcp(米国東部)または欧州(フランクフルト)のリージョナルエンドポイントを指定する。APIコール自体は他の全リージョンに対しても実行可能だ。
料金と提供リージョン

AWS MCP Server自体に追加料金は発生しない。支払うのは、AIエージェントが操作した結果として作成されたAWSリソースの利用料と、データ転送料金のみだ。このため、まずは試験的に導入し、効果を検証しやすい。
現在の提供リージョンは米国東部(バージニア北部)と欧州(フランクフルト)の2拠点。今後、他のリージョンにも順次拡大される見込みだ。
AWS MCP Serverはすでに多くのAIコーディングアシスタントで利用可能であり、AWSドキュメントの最新ページからクイックスタートガイドを参照できる。
この記事のポイント
- AWSがAIエージェント向けのマネージドMCPサーバーを一般提供開始
- call_aws、search_documentation、run_scriptの3ツールでAWSを安全に操作
- run_scriptはサーバー側サンドボックスでスクリプトを一括実行し高速化
- SkillsによりAWSチーム公認のベストプラクティスをコード生成に活用可能
- IAMとCloudTrail/CloudWatchで人間の操作とAIの操作を明確に分離監査
- サーバー利用料は無料、リソース使用量のみの課金。米国東部と欧州で提供開始
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験