

AI攻撃は自律化へ移行!6時間で数千件の認証情報を奪う新手口を解説
Google Threat Intelligence Group(GTIG)は2026年9月8日、敵対的AI利用の進化をまとめた四半期レポートを公開した。攻撃者が単純なプロンプト入力から、自律的に動くエージェンティックAIの活用へ移行している実態が明らかになっている。
2026年第2四半期には、クラウド環境を侵害した攻撃者が6時間未満で認証情報の大量収集キャンペーンを計画し、構築し、実行した事例が確認された。数千件規模の認証情報が奪取されている。
この変化は、防御側が攻撃を検知して対応するまでの時間を大きく縮める。AIを使う側の企業にとって、単なる技術トレンドではなく、クラウドと認証情報の管理体制に直結する問題だ。
攻撃者は「AIに聞く」から「AIに任せる」へ移行した
2026年5月の前回レポート以降、GTIGは攻撃者が基本的なプロンプト入力から、エージェンティックAIワークフローとAI対応自動化へ踏み出しているのを観測している。ここでいうエージェンティックAIとは、人間が1つずつ指示を出さなくても、目標を与えれば自分で計画を立てて実行するAIシステムのことだ。チャット型AIが1往復で終わるのに対し、エージェンティックAIはツールやAPIを呼び出しながら複数の工程を連続で進める。
従来の攻撃では、攻撃者がAIの出力を確認し、コマンドを実行し、結果を見て次の指示を出すというループが発生していた。エージェンティックAIはこの人間の介在を大幅に減らし、エラー修正やIPアドレスの切り替えまで自律的に行う。その結果、防御側が気づく前に攻撃が完了するケースが増えている。
この違いが攻撃スピードの差につながる。GTIGは2026年第2四半期に、このエージェンティックAIを使った攻撃が実戦投入された事例を確認した。
6時間で数千件の認証情報を奪ったキャンペーンの中身
Mandiantが観測した事例では、金銭目的とみられる攻撃者が組織のクラウド基盤を侵害し、自律型のマルチエージェント攻撃フレームワークを展開した。攻撃者はAIコーディングチャットボット、プロンプト、エージェント指示書を組み合わせ、計画・構築・実行を6時間未満で完了させている。通常は大規模なグループが持つリソースと同等の規模と速度で、数千件の第三者認証情報が奪取された。
攻撃者はマークダウン形式の指示書を運用プレイブックとして使った。マークダウンとは文書を書くための軽量な記法で、AIへの指示書としても扱いやすい。AIはこの指示書に従い、脆弱性スキャンパイプラインを自律的に管理し、リアルタイムでトラブルシューティングを行い、IPアドレスのローテーションまで自動実行した。攻撃トラフィックは被害者のクラウド基盤から正当なIPアドレスを経由して送信され、検知を難しくしていた。
この事例では、指示書とプロンプトを組み合わせることで、AIが自律的にパイプラインを管理した。人間の操作を挟まないため、防御側が気づく前に攻撃が完了してしまう。
GTIGはこの動きを、受動的なインフォスティーラーから攻撃的なエージェンティック収集への転換点と位置づけている。インフォスティーラーとは、端末に保存されたパスワードやCookieなどを盗み出すマルウェアだ。従来は端末を起点に情報を集めるだけだったが、新たな手法ではサーバーサイドの脆弱性を自ら探索し、狙いを定めて攻撃する。
AIコーディングが広げたオープンソースの死角
AI支援コーディングの普及でオープンソース資産の量が増え、開発速度が上がった。一方でサードパーティパッケージや依存関係の精査が甘くなり、攻撃者に付け込まれる余地が生まれている。GTIGは、AI支援コーディングが2025年から2026年初めに観測された大規模サプライチェーン侵害の一因になったとみている。
具体的な事例も確認された。2026年初めには、北米とアジアの企業環境で悪意あるオープンソースAI資源のダウンロード試行が検知された。2026年4月には、AIコーディングエージェントが暗号資産プロジェクトのコードベースに悪意ある依存関係を組み込んだ事例が公表されている。2026年5月には、LLMプロキシサービスを密かにインストールする悪意あるパッケージも特定された。これは地域的なLLMアクセス制限を迂回するために使われる。
金銭目的の攻撃者UNC6780(TeamPCP)は、こうしたリスクの深刻さを示す存在だ。UNC6780はPyPIやnpm、Docker Hubといったエコシステムを標的にし、侵害後にDUSTMAKERと呼ばれる認証情報窃取マルウェアを展開する。窃取したデータは直接売ったり、ランサムウェアグループとの提携で利益に変えられたりする。
UNC6780はAIコーディングアシスタントやLLMセキュリティスキャナーを騙す複数の手口も実装している。代表的なのがプロンプトインジェクションだ。これはAIが読むテキストの中に悪意ある指示を忍ばせる攻撃で、コードを自動分析するAIに「安全だ」と誤認させる偽の指示を仕込む。GitHub Actionsのワークフローを悪用して専有AIリポジトリを盗み出し、別の攻撃者に渡して恐喝に使わせた事例もあった。
専有AIモデルとクラウド計算資源が次の標的
2026年第2四半期、最先端モデルへの直接攻撃は確認されなかった。しかし専有AIの研究やモデルを盗む事例は増加している。標的はAIラボや先端AI企業にとどまらず、政府・軍事・医療・メディア・エンターテインメント分野にも広がった。攻撃者もサイバーエスピオナージ集団だけでなく、データ窃取恐喝グループまで含まれる。
中国関連の脅威アクターUNC6508は、北米の学術・医療・軍事研究機関を対象にした複数年キャンペーンを展開している。UNC6508は専有AI研究を標的にするだけでなく、クラウド環境を侵害してローカルLLM基盤を展開し、商用AI APIの監視を避けながら被害者の計算資源を利用していた。
データ窃取恐喝の事例も複数確認された。医療分野では企業データと製薬研究、専有AIモデルが盗まれ、身代金を支払わなければ公開すると脅迫された。AIメディア生成企業の事例では、ソースコード、プロンプト、スキル、モデルスクリプト、シークレットが流出した。モデル重みとはAIモデルが学習で得た知識を数値として保存したデータで、これが盗まれるとAIの再現や改変に悪用される恐れがある。
アカウント売買とLLMJackingの実態
プレミアムモデルや高性能計算へのアクセスコストは、攻撃者にとって大きな障壁だ。そのためAIアカウントの窃取・購入・販売が地下フォーラムで増加している。ClaudeやGeminiの認証情報に加え、Cursor ProやDevinなど自律型コーディングIDEの需要も高く、アカウント単価は2026年に平均で2倍以上に跳ね上がった。
認証情報の入手経路として広く使われるのがインフォスティーラーだ。LUMMAC.V2、STEALC.V2、VIDAR、ACRSTEALERなどの制御者は、従来のAIブラウザプロファイルに加えて、AI開発者設定を狙い始めた。2026年5月には、ACRSTEALERがClineのsecrets.jsonやContinue AIのconfig.yamlを標的にする命令を配布した事例が確認されている。これらのファイルには平文のAPIキーが保存されることがあり、APIキーとはシステム同士がやりとりするための合言葉のようなものだ。これが漏れると、被害者の有料モデル利用枠を攻撃者が直接使えてしまう。
LLMJackingも増えている。LLMJackingとは、被害者のクラウド環境を侵害して計算資源を乗っ取り、AIワークロードを不正に実行する手口だ。2026年4月の侵入事例では、GitHubの個人アクセストークン(PAT)が露出したことが起点となった。攻撃者はこれを使ってクラウド環境に初期アクセスし、不正なAIインフラを展開して高性能計算資源を拡張した。
LLMJackingは、被害者が気づかないうちに高額なクラウド利用料が発生する点でも厄介だ。GTIGは2026年に入り、地下フォーラムでのAIアカウント売買と並んでこの手口の増加を確認している。
企業が取るべき対策とGoogleの防御
Googleは多層的な防御戦略を取っている。モデルレベルの安全策、脅威インテリジェンス、封じ込めプロトコルを組み合わせ、モデル抽出攻撃に対してはリアルタイム防御を展開する。モデル抽出攻撃とは、既存のAIモデルに大量の質問をして応答を学習させ、模倣モデルを作る手口だ。Googleは不正な模倣モデルの性能を落とし、専有ロジックの複製を検知する対策を導入している。
2026年6月には、中国拠点のサイバー犯罪サービス「Outsider Enterprise」を遮断した。このサービスはフィッシングキットを提供し、Googleなどの有名ブランドを大量になりすましていた。運営者はGeminiを使ってコードを生成し、キャンペーンを大規模に実行していた。GoogleがGeminiの悪用で法的措置に踏み切ったのはこれが初めてだ。
企業向けにはGoogle AI Threat Defense(AITD)を提供している。AITDはGeminiなどの推論力、Wizのリスク優先順位付け、GeminiとCodeMenderの自動修復、Mandiantの最前線インテリジェンスを統合した自律型アーキテクチャだ。軽量モデルで継続スキャンを行い、高リスクの脆弱性には特化型の先端モデルを割り当てる。さらに脆弱性検出と自動パッチ適用に特化したGemini 3.8 Flash Cyberも投入している。
実務面では、クラウド認証情報の定期的なスキャンとローテーション、GitHubの個人アクセストークン管理、AIアカウントの多要素認証、オープンソース依存関係の精査が基本になる。AIを業務に導入する場合は、通常のセキュリティ監視に加えて、AI特有の脅威を検出する仕組みを組み込むことが欠かせない。
この記事のポイント
- 攻撃者はチャット型のAI利用から、自律的に動くエージェンティックAIへ移行している
- 2026年第2四半期には6時間未満で数千件の認証情報を奪うキャンペーンが確認された
- AIコーディングの普及でオープンソース経由のサプライチェーンリスクが拡大している
- 専有AIモデルやAPIクレデンシャルが窃取と恐喝の標的になっている
- AIアカウントの売買とLLMJackingが増加し、クラウド計算資源が乗っ取られている
- 防御には認証情報管理、依存関係の精査、AI特有の脅威検出が欠かせない

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Run instances登場!AIエージェントを月額6ドル弱で常時稼働
Google Cloudが2026年8月27日、常時稼働するAIエージェント向けの新サービス「Cloud Run instances」をプレビュー公開した。サーバーレスの利便性を保ちながら、単一インスタンスを長期間動かし続けるための専用ランタイムだ。
1vCPU・1GiBメモリの構成なら、30日間連続稼働して月額5.70ドル。従来の専用VMと比較すると運用コストと管理負担を大幅に抑えられる。
パーソナルAIエージェントを自宅のPCや専用サーバーで動かしていた開発者にとって、クラウド移行の有力な選択肢になる。本記事ではCloud Run instancesの特徴、料金構造、実際のデプロイ手順までを解説する。
Cloud Run instancesの基本と既存サービスとの違い
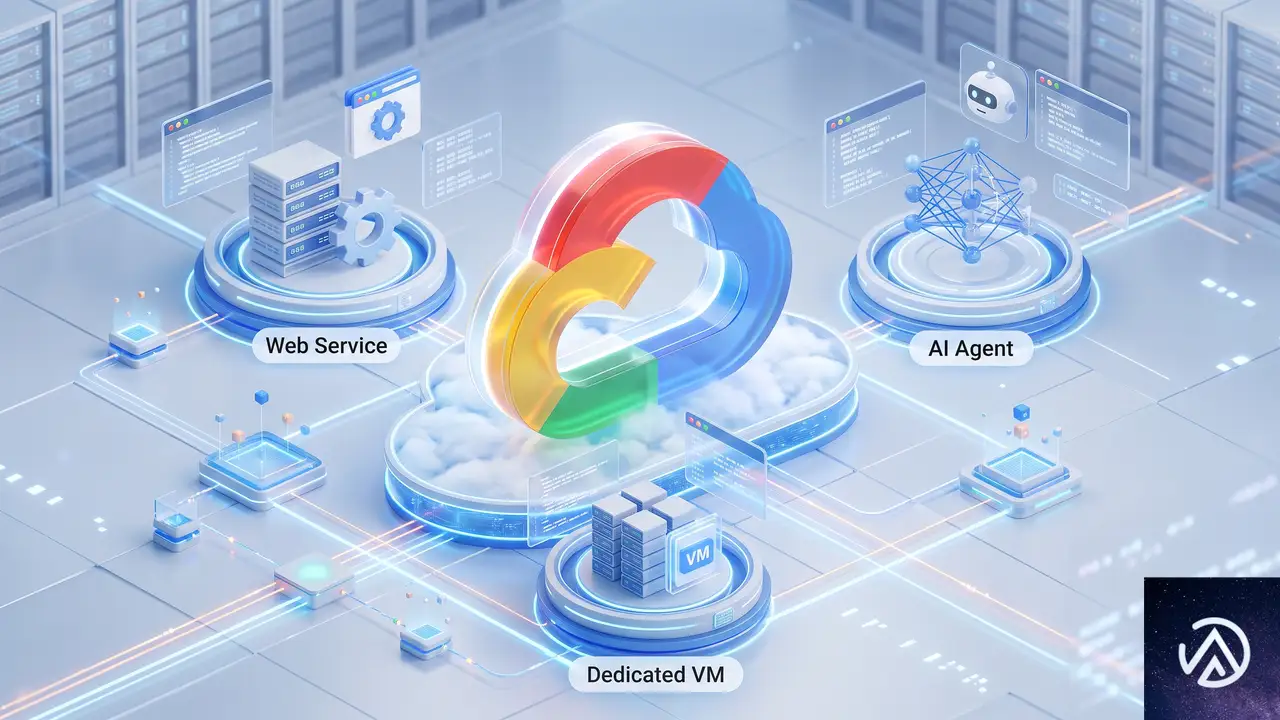
Cloud Run instancesは、Google Cloudのサーバーレスコンテナ基盤であるCloud Runの新しい実行モードだ。既存のCloud Run servicesが高スループットなWebサービス向けに設計されているのに対し、Cloud Run instancesは「1つのインスタンスを確実に動かし続ける」ことに特化している。
主な特徴は次の4つにまとめられる。
- オートスケーリングなしの単一インスタンスのみを実行する
- 最大7日間の連続実行と自動再起動ポリシーを標準で備える
- 更新や再起動後も変わらない固定HTTPS URLが発行される
- 使わないときは停止し、必要なときに再開できる
3つの実行環境の違いを比較した図だ。Cloud Run instancesは既存Cloud Runと専用VMの中間的な位置づけで、サーバーレスの手軽さと常時稼働の確実性を両立している。
既存のCloud Run servicesとの決定的な違い
Cloud Run servicesは、リクエストが途絶えるとインスタンスがスケールゼロになる。これは高トラフィックなWeb APIには効率的だが、常に1つのコピーが動き続けることを期待するAIエージェントには不向きだ。一方、Cloud Run instancesはオートスケーリングを行わず、指定した設定のインスタンスを1つだけ動かし続ける。これが最大の設計上の違いになる。
なぜAIエージェントに最適なのか
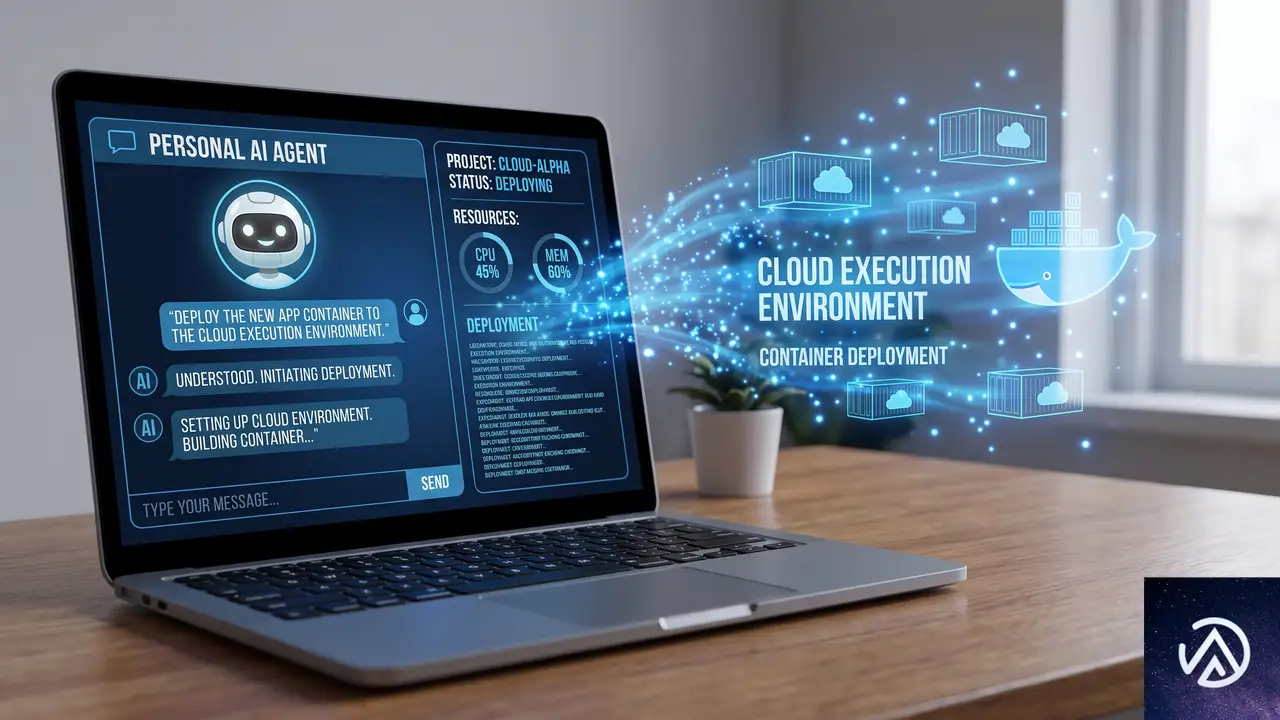
OpenClawやHermesといったパーソナルAIエージェントは、継続的に動作し、通常は一度に1人のユーザーにしかサービスしない。これらの特性は、ステートレスな高スループットWebサービスとはインフラ要件が大きく異なる。
OpenClawは、ユーザーの代わりにさまざまなタスクを実行するオープンソースのパーソナルAIエージェントだ。使うほど学習して賢くなる。多くのOpenClawユーザーは最初に自分のノートPCで実行し始めるが、ノートPCがスリープするたびに停止してしまう問題に直面する。ここでクラウド上の常時稼働環境が必要になる。
従来の選択肢の問題点
専用VMを借りる方法もあるが、24時間365日の課金、OSのアップデート管理、ファイアウォールのポート開放、HTTPSエンドポイントの構築といった手間が発生する。Cloud Run instancesはこれらの管理タスクをクラウド側に任せつつ、低コストで常時稼働を実現する。
ここでのポイントは、AIエージェントのワークロードが「バースト型」であることだ。普段は待機状態でCPUをほとんど使わず、ユーザーが指示を出した瞬間だけ計算リソースを消費する。共有vCPUとバーストバジェットによる課金モデルは、このバースト型の特性と相性が良い。常時フルパワーのCPUを確保する必要がないため、価格を抑えられる。
料金とコスト構造の分析
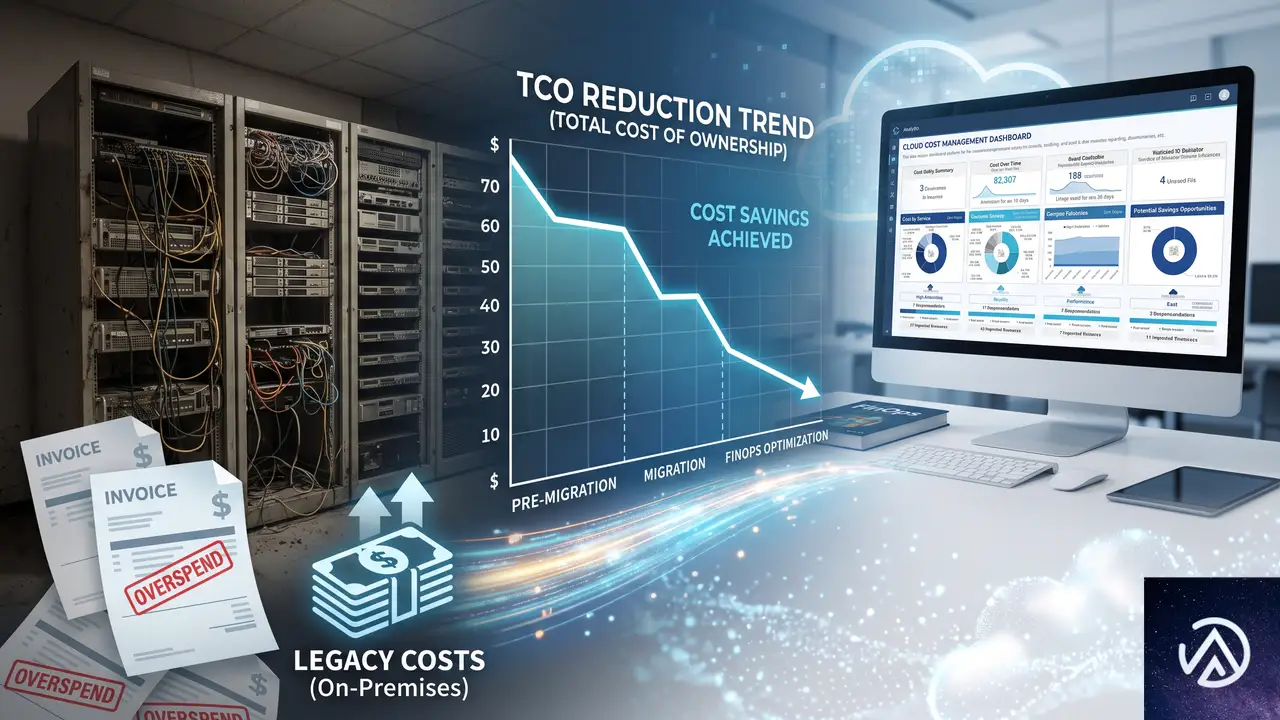
1vCPU・1GiBメモリのCloud Run instanceを30日間連続稼働させた場合のコストは5.70ドル。共有vCPUとvCPUバーストバジェットを利用して、低く予測可能な価格で連続実行を実現している。
従来の専用VMと比べると、クラウド料金に大きな差がある。30日間連続稼働でわずか5.70ドルという価格は、個人開発者が気軽に試せる水準だ。
価格設定の分析
5.70ドルという価格は、パーソナルAIエージェントの利用シーンを想定した戦略的な設定だ。個人開発者がノートPCの代わりにクラウドでAIエージェントを常時稼働させるには、月額10ドル以下という心理的なハードルが大きい。Cloud Run instancesはこの価格帯を実現したことで、パーソナルAIエージェントのクラウド移行を加速する可能性がある。
OpenClawデプロイの実践手順
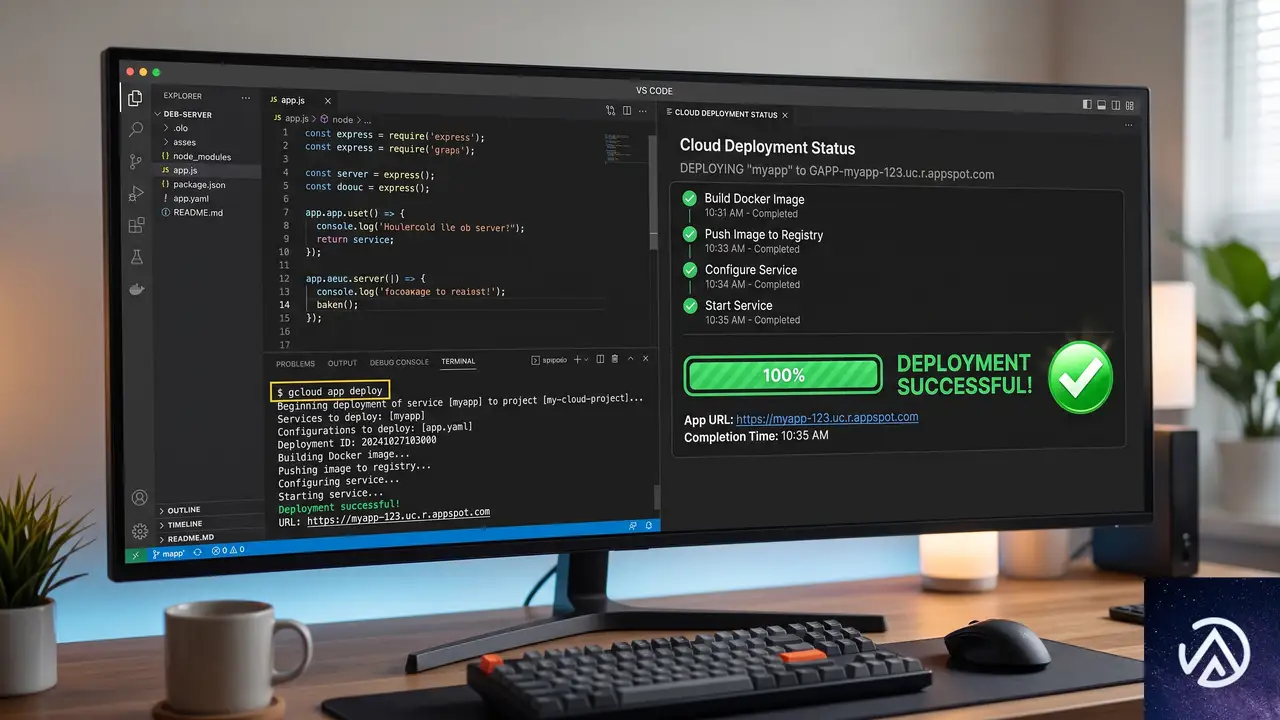
OpenClawをCloud Run instancesにデプロイする手順はシンプルだ。設定ファイルをCloud Storageバケットにアップロードした後、1つのコマンドを実行するだけでデプロイが完了する。
デプロイ後のOpenClawは、使いたい限り動かし続けられる。メッセージングアプリと接続してタスクを任せることも、必要なツールと連携させることも可能だ。
SSHアクセスと今後のアップデート
Cloud Run instancesとCloud Run servicesの両方で、SSHアクセス機能が近日中に提供される予定だ。これにより、実行中のコンテナに直接ログインしてデバッグや設定変更ができるようになる。詳しい手順はCloud Runのcodelabで公開されている。
ユーザー事例と今後の展望
OffDeal社の導入効果
中小企業向けのAI投資銀行を提供するOffDealは、Cloud Run instancesを長期間稼働するエージェントの主要インフラとして利用している。OffDeal社のLuis Ruiz Morel氏によれば、コールドスタートが88%削減され、実装も非常にシンプルで信頼性が高いとのことだ。
コールドスタート88%削減とは、エージェントが待機状態からタスクを開始するまでの起動時間が大幅に短縮されたことを意味する。AIエージェントの応答性がビジネス成果に直結するユースケースでは、この改善は大きな価値となる。
プレビューからGAへ
Cloud Run instancesは現在プレビュー段階で、パフォーマンスを犠牲にせずに新しい種類のワークロードをコスト効率よく実行する手段として提供されている。今後、GA(一般提供)への移行とともに、より多くのAIエージェントワークロードがこの基盤に集約される可能性がある。
Cloud Run instancesの登場は、サーバーレスコンピューティングの適用範囲を「常時稼働するステートフルなワークロード」にまで広げる動きとして捉えられる。従来のサーバーレスは「イベント駆動・ステートレス・短期実行」が前提だったが、AIエージェントのような新しいワークロードの台頭が、この前提を変えつつある。Google Cloudがこのニーズに素早く応えた形だ。
この記事のポイント
- Cloud Run instancesは常時稼働するAIエージェント向けの新しいサーバーレス実行環境
- 単一インスタンスのみ、オートスケーリングなし、最大7日間連続実行
- 1vCPU・1GiBメモリで30日間連続稼働して月額5.70ドル
- 固定HTTPS URLが提供され、停止・再開も自由
- OpenClawを1コマンドでデプロイ可能
- 近日中にSSHアクセス機能が追加予定
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloudが2029年までに耐量子暗号へ完全移行。PQCロードマップの全容と企業が取るべき3ステップ
Google Cloudが2026年8月11日、2029年までに耐量子暗号(PQC / Post-Quantum Cryptography)へ完全移行するためのロードマップを公開した。量子コンピュータによる将来の暗号解読リスクに備え、APIエンドポイントやロードバランサーの対応はすでに始まっている。
今回の発表では、移行戦略の3つの重点領域、2026年に完了した基盤整備、2027年から2028年にかけてのドメイン別計画が示された。企業が今すぐ着手すべき3つのステップも提示されている。
量子コンピュータが実用化されれば、現在広く使われているRSAやECDSAなどの公開鍵暗号は解読可能になる。その影響はクラウドサービス全体に及ぶ。本記事では、Google CloudのPQCロードマップの全容と、企業に求められる対応を整理する。
PQC移行の全体像と2029年目標
Google CloudのPQC移行戦略は「セキュアバイデザイン」を基本方針とする。設計段階から量子安全を組み込むアプローチであり、単なる後付けの対策ではない。Google Quantum Threat Modelという独自の脅威モデルを土台に、3つの重点領域で保護を進める。
SNDLリスクとは何か
SNDL(Store Now, Decrypt Later)は「今保存して後で復号する」攻撃だ。攻撃者が現在の暗号化通信を傍受してデータを蓄積しておき、量子コンピュータが実用化された時点で一括して復号する。今日の暗号化データが将来の量子コンピュータで解読されるリスクは、すでに現実のものとなっている。
これがPQC移行を急ぐ最大の理由だ。機密データの保存期間が数十年に及ぶ場合、現在の暗号化方式のままでは将来の解読リスクを抱え続けることになる。特に金融機関や政府機関、医療機関では、このリスクへの対応が喫緊の課題だ。
このデモはSNDL攻撃のリスクとPQCによる防御の違いを示している。攻撃者がどれだけデータを蓄積しても、量子安全な鍵交換を使っていれば将来の解読は不可能になる。
Googleが定める3つの重点領域
Google CloudがPQC移行戦略で優先するのは、以下の3領域である。
- SNDLリスクの緩和。現在の暗号化データが将来の量子コンピュータで解読されることを防ぐ。
- 偽造に対する完全性の確保。デジタル署名を強化し、データやIDの偽造を防ぐ。
- 暗号アジリティの基盤強化。暗号標準の進化に合わせて、新しい方式を最小限の工数で採用できる柔軟なシステムを構築する。
3番目の「暗号アジリティ」は特に重要だ。暗号標準は今後も進化し続ける。特定のアルゴリズムに依存せず、新しい標準が出たら容易に切り替えられる仕組みがあれば、将来の移行コストを大幅に抑えられる。Googleはこの基盤への投資を戦略の中核に置く。
Google Cloudは規制期限を待たずに、内部インフラと顧客向けサービスのPQC移行を前倒しで進めている。2029年の完全対応を目標に、Sovereign Cloudの取り組み(Google Cloud DedicatedやGoogle Distributed Cloud)にもPQCソリューションを展開中だ。
2026年に完了した基盤整備
2026年時点で、すでに複数の基盤的マイルストーンが達成されている。これらは顧客に対して即座の保護を提供するものだ。
APIエンドポイントとロードバランサーの対応
Google CloudのAPIエンドポイントは、量子安全な鍵交換に対応した。google.comと*.googleapis.comの両方が、NIST標準化済みのML-KEM(FIPS 203)をハイブリッドモードで実装している。ハイブリッドモードとは、従来の暗号とPQCを併用する方式だ。互換性を保ちながら量子安全性を確保できる。
アプリケーションロードバランサーとプロキシロードバランサーも、TLS 1.3における量子安全ハイブリッド鍵交換(X25519MLKEM768)をサポートする。当初はオプトイン方式で提供され、顧客は既存アプリケーションへの影響を最小限に抑えながら検証を進められる。
さらに、ChromeとCloudflareが進めるMerkle Tree Certificatesの実験にも参画している。PQC署名をWebPKIに適用する際の課題(署名サイズの肥大化など)に対処する取り組みだ。
Cloud KMSのPQCアルゴリズム一般提供
Cloud KMSでは、NIST標準化済みのPQCアルゴリズム(ML-KEM、ML-DSA、SLH-DSA)が一般提供(GA)に達した。暗号化鍵と署名鍵の両方で量子安全なアルゴリズムを利用できる。
これは企業にとって大きな意味を持つ。既存のCloud KMS利用者は、新しいPQCアルゴリズムを試すために特別な準備をする必要がない。すでに一般提供されているため、本番環境での利用も可能だ。
ドメイン別ロードマップ(2027〜2028年)
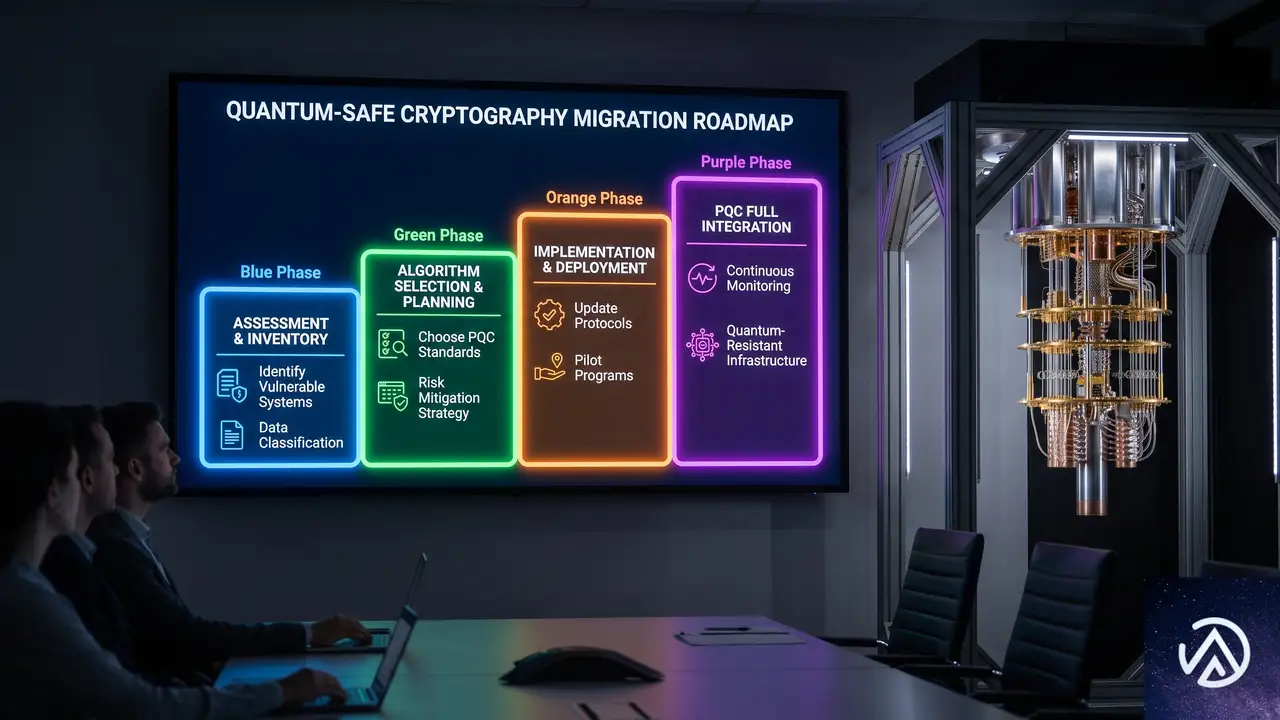
Google Cloudは2029年の完全対応に向けて、リスクベースのアプローチで3つのドメインを定義した。各ドメインには目標完了時期が設定されている。サービスによって個別のタイムラインは調整される可能性があるが、大多数のサービスは目標時期に合わせて移行を完了する見込みだ。
このタイムラインは、Google CloudのPQC移行が段階的に進むことを示している。2026年の基盤整備から始まり、2027年には通信経路の保護、2028年には署名と鍵管理、2029年に全体の収束を目指す。
ドメイン1 SNDL対策(2027年目標)
ドメイン1は非対称暗号の脆弱性に対処する。将来の量子コンピュータが今日の暗号化データを復号するリスクを防ぐのが目的だ。対象となるのは以下の3つの経路である。
- 顧客ワークロードの保護。Google Cloudサービスとロードバランサーに量子機密TLS 1.3ハンドシェイクを提供する。
- 管理者・開発者フローの保護。Cloud VPNやInterconnectを含む管理者経路をSNDLから守る。開発者向けにはクライアントライブラリ、SDK、オープンソース暗号ライブラリのTinkを対応させる。
- データパイプラインの保護。分析・ストレージプラットフォームのデータ転送を保護し、機密情報が傍受・蓄積されても将来復号されないようにする。
このドメインの特徴は、通信経路の保護に焦点を当てている点だ。特にTinkの対応は重要である。TinkはGoogleが開発したオープンソース暗号ライブラリで、多くの開発者が利用している。TinkがPQCに対応することで、開発者はアプリケーションレベルで量子安全な暗号を容易に導入できる。
ドメイン2 完全性と否認防止(2028年目標)
ドメイン2はデジタル署名と証明の量子対応を扱う。量子コンピュータによる偽造攻撃からデータの完全性と信頼性を守る。3つの主要分野がある。
1つ目はソフトウェアサプライチェーンの保護だ。Binary Authorization、Cloud Build、Assured Open Source Softwareなどのサービスで、量子耐性のある証明(アテステーション)を導入する。信頼できる変更されていないイメージだけが本番環境で実行されることを保証する。
2つ目は量子安全な証明書の発行だ。内部および外部の認証局(CA)をML-DSA証明書に対応させる。状況に応じてSLH-DSA証明書もサポートする。IETF(Internet Engineering Task Force)の標準化に積極的に貢献しており、大規模な署名サイズ問題にはMerkle Tree Certificatesなどの新しいアプローチを検証中だ。
3つ目はIDとアクセスの保護である。サービスアカウントキーやトークン(JWT / OAuth)を量子偽造に対して耐性のある方式に移行する。
ドメイン3 基盤と鍵管理(2028年目標)
ドメイン3はPQC移行の土台となる暗号アジリティを扱う。ここでの投資が、ドメイン1と2の実現を支える。
基盤となる鍵管理とライブラリでは、Cloud KMSとBoringSSL、Tinkを通じてNIST承認アルゴリズムを有効にする。Cloud KMSはすでにML-KEM、ML-DSA、SLH-DSAの一般提供を開始しており、量子安全な鍵のインポートも準備中だ。
ハードウェアが関わる部分では、Confidential ComputingとCloud HSMにPQCを組み込む。量子的なルートオブトラストを確立し、物理的な基盤を保護する。OpenTitanやCaliptra v2.1、TPM 2.0 v185などのオープンソースシリコン基盤もPQC対応を進めている。
Google Workspaceのクライアントサイド暗号化(CSE)と外部鍵マネージャー(EKM)にもPQCオーケストレーションを導入する。オンプレミスの鍵プロバイダーとの連携も進める計画だ。
量子安全における共有責任モデル
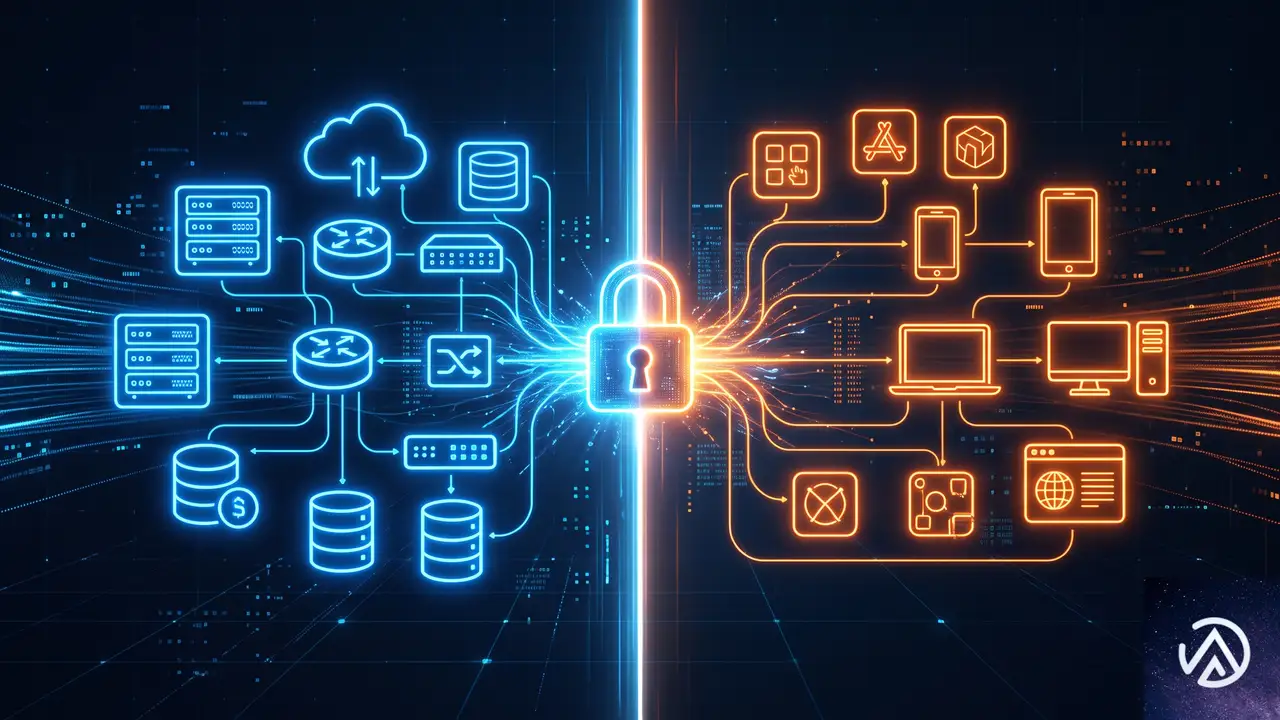
量子安全はGoogle Cloudと顧客の共同作業である。クラウドセキュリティの共有責任モデルがPQCにもそのまま適用される。
この図は責任の境界を明確にしている。重要なのは、Google Cloud側のPQC対応が完了しても、顧客がクライアントソフトウェアを更新しなければ量子安全な接続は確立しない点だ。
Google側の責任範囲
Googleはサーバー、ネットワーク、転送中の暗号化、グローバルフロントエンド、ALTSプロトコルのPQC移行を一括して管理する。ハードウェアの移行は、積極的な交換と自然な機器更新サイクルを組み合わせて段階的に進める。物理コンポーネントの中には2029年を超えて移行が続くものもあるが、安定性を優先したフェーズドアプローチを取る。
顧客側の責任範囲
顧客は自社アプリケーションの管理に責任を持つ。クライアントソフトウェアをPQCハンドシェイク対応に更新すること、非対称鍵のライフサイクル管理、Google Cloudサービスの設定変更が含まれる。
ここが最も見落とされやすいポイントだ。インフラ側がPQC対応しても、クライアント側が古い暗号方式で接続すれば、量子安全性は確保されない。企業のセキュリティチームは、自社のクライアントソフトウェアがPQC対応済みかどうかを確認する必要がある。
企業が今すぐ着手すべき3つのステップ
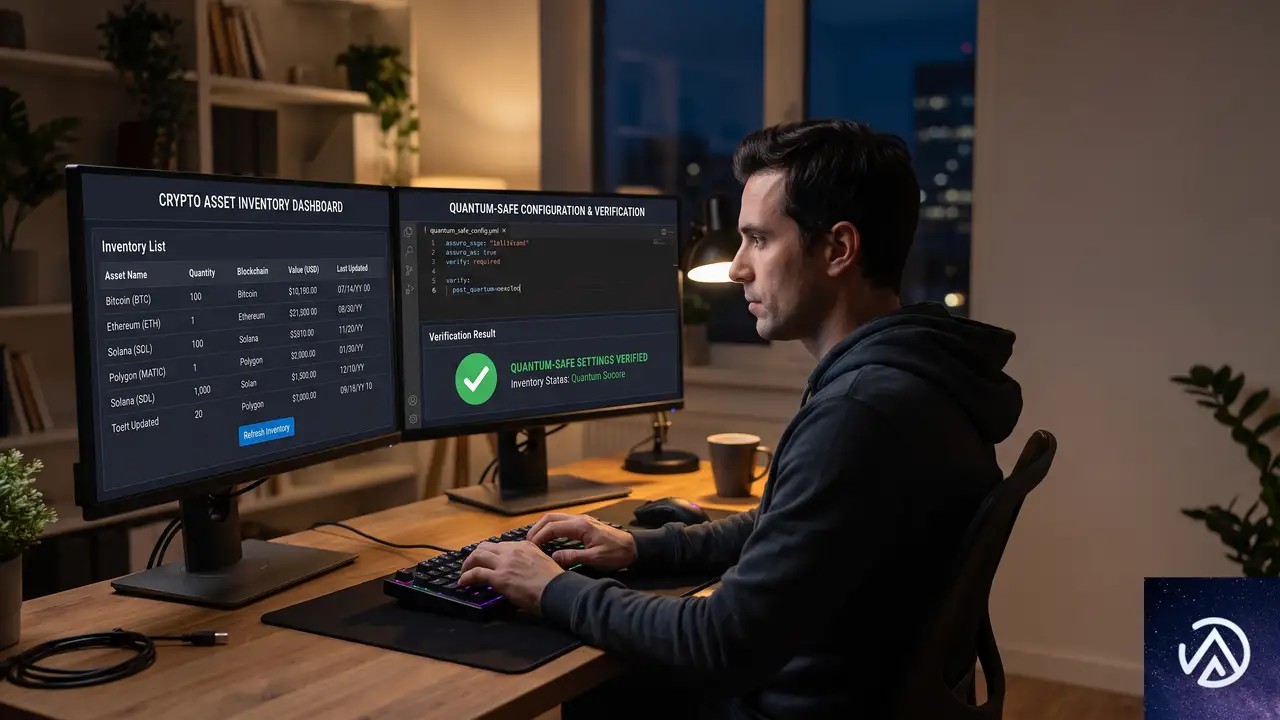
Google CloudはPQC移行の第一歩として、企業が即座に着手できる3つのステップを提示している。どれも実務に直結する具体的なアクションだ。
- 棚卸し(Inventory)。Cloud Asset InventoryやWizなどのツールを使って、鍵や証明書などの暗号資産を特定する。組織全体の暗号リソースをマッピングし、移行バックログの優先順位を定義する。
- 更新(Update)。開発チームとSREチームが使うソフトウェアが、BoringSSL、Chrome、SDKなどPQCアルゴリズムに対応していることを確認する。エッジで量子安全接続が有効化された際に、社内ワークフローが準備できている状態を作る。
- 検証(Validate)。Google Cloudの量子安全APIとロードバランサーを使って既存アプリケーションの挙動をテストする。本番環境に影響が出る前に、アーキテクチャ上のボトルネックを特定できる。
この3ステップは、PQC移行を「待つ」のではなく「準備する」アプローチだ。特に検証は重要である。量子安全なTLS接続は従来よりオーバーヘッドが大きい場合があり、アプリケーションのパフォーマンスに影響を与える可能性がある。事前のテストで課題を洗い出しておけば、本番移行時のリスクを大幅に減らせる。
この記事のポイント
- Google Cloudは2029年までにPQC完全対応を目指し、ロードマップを公開した
- SNDLリスク(今保存して後で復号)は企業にとって喫緊の課題である
- 2026年時点でAPIエンドポイント、ロードバランサー、Cloud KMSのPQC対応が完了している
- 3つのドメイン(SNDL対策、完全性確保、鍵管理基盤)で2027〜2028年に移行を進める
- 企業は棚卸し、更新、検証の3ステップで今すぐ準備を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GKE Agent Sandboxがエージェント1台あたりのコストを75%削減する仕組み
AIエージェントを本番環境でスケールさせようとすると、すぐにコストとリソースの壁にぶつかる。Google Cloudが2026年7月30日に公開したブログ記事では、Google Kubernetes Engine(GKE)の新機能「GKE Agent Sandbox」とオーケストレーションを組み合わせることで、同一の仮想マシン上で動かせるエージェント数を最大3.5倍に増やし、エージェント1台あたりのコストを最大75%削減できるという検証結果が示された。
エージェントは要求に応じて動作するバースト型のワークロードであり、何もしない待機時間が長い。従来のように固定的なコンピュートリソースを割り当てる方法では、遊休状態のエージェントが貴重なCPUやメモリを消費し続けてしまう。この問題に対するGKEのアプローチを詳しく見ていく。
マイクロVM方式の限界とGKE Agent Sandboxの登場
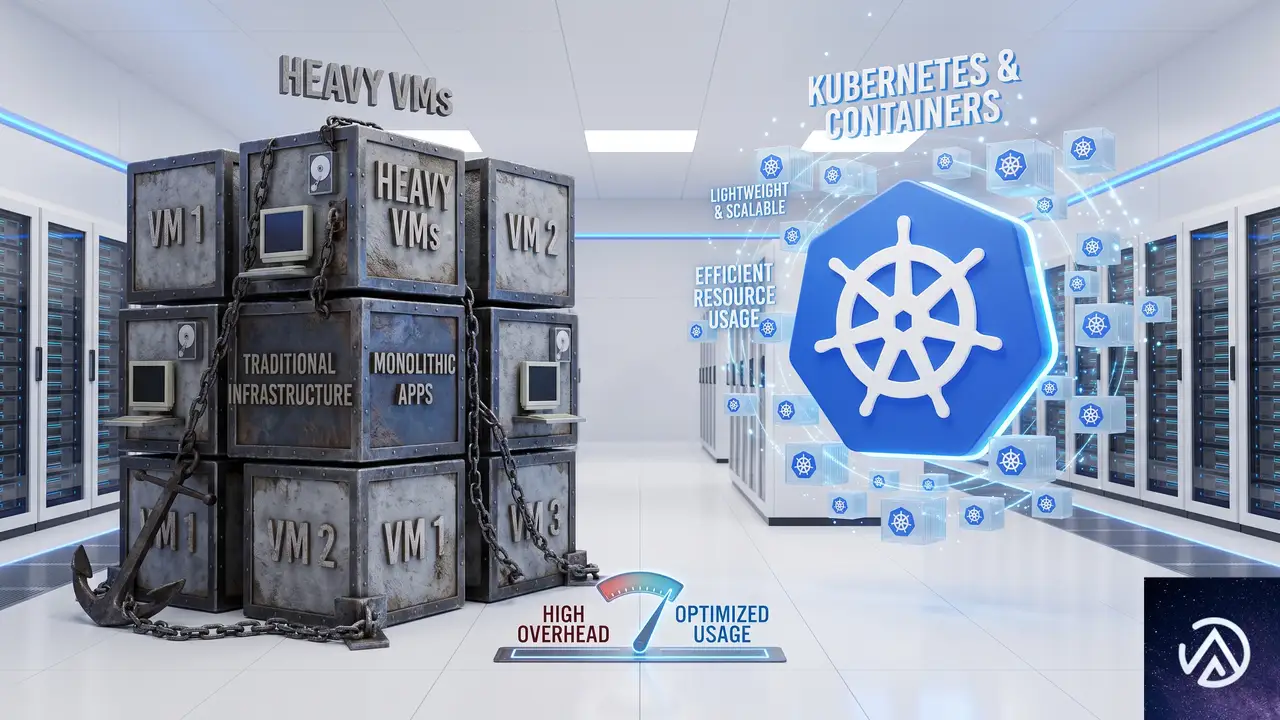
マルチエージェントを安全に動かすための一般的な方法として、各エージェントを専用のマイクロVM(Kata Containersなど)で隔離するやり方がある。ハードウェアレベルの隔離によってセキュリティを確保する狙いだ。しかしこの方式には大きな落とし穴がある。
マイクロVMはエージェントごとにゲストOSを起動するため、メモリとCPUに無視できないオーバーヘッドが生じる。実際にGoogle CloudのチームがOpenClawプロファイルを使い、48vCPUの標準VMインスタンス(n2-standard-48)上でテストしたところ、61個のエージェントを起動した時点で信頼性が低下し、ヘルスチェックの失敗が頻発し始めたという。
これに対してGKE Agent Sandboxは、gVisorというオープンソースのセキュアコンテナサンドボックスを土台にしている。gVisorはユーザー空間カーネル(Sentry)でシステムコールを捕捉・フィルタリングし、ハードウェア隔離に近いセキュリティを実現しつつ、ゲストOSを丸ごと動かす必要をなくした。
結果として、同一VM上で動作可能なエージェント数は88個まで増加。これはベースライン比で44%の密度向上であり、エージェント1台あたりのコストは30%以上削減された計算になる。しかも性能プロファイルはほぼ維持できると報告されている。
この方式が評価を得たのは早く、2026年5月の一般提供開始から4週間足らずで利用量が7倍以上に急増した事実が、その実用性を裏付けている。
遊休エージェントを「凍結」するオーケストレーションの威力
GKE Agent Sandboxは稼働中のワークロードを効率化するが、遊休状態のエージェントがリソースを占有し続ける問題は残る。そこでカギを握るのが、Kubernetes本来のオーケストレーション機能とGKE Podスナップショットを組み合わせた「凍結・再開」パターンだ。
具体的には、エージェントが待機状態に入ったタイミングでPodスナップショットを作成し、永続ストレージにチェックポイント(凍結)として保存する。これにより物理的なCPUとメモリが解放され、クラスタに返却される。新しいトリガーが届くと、軽量なコントローラやイベントゲートウェイがリクエストを捕捉し、ミリ秒単位でスナップショットからエージェントを再開する。
この仕組みによって、物理リソースをワークロードの実態に基づいて「オーバーサブスクライブ(超過割り当て)」できるようになる。つまり、実際の瞬間的な需要以上のエージェントを同じノードに詰め込めるわけだ。その結果、間欠的にしか動かないエージェントであれば、ベースラインの3.5倍にあたる274個のエージェントを単一ノードで動作させることが可能になった。
ただし、やみくもに詰め込めばよいわけではない。エージェントの種類によって求められる起動時間やレイテンシは大きく異なるからだ。
エージェントの特性に合わせた3つのデプロイ戦略
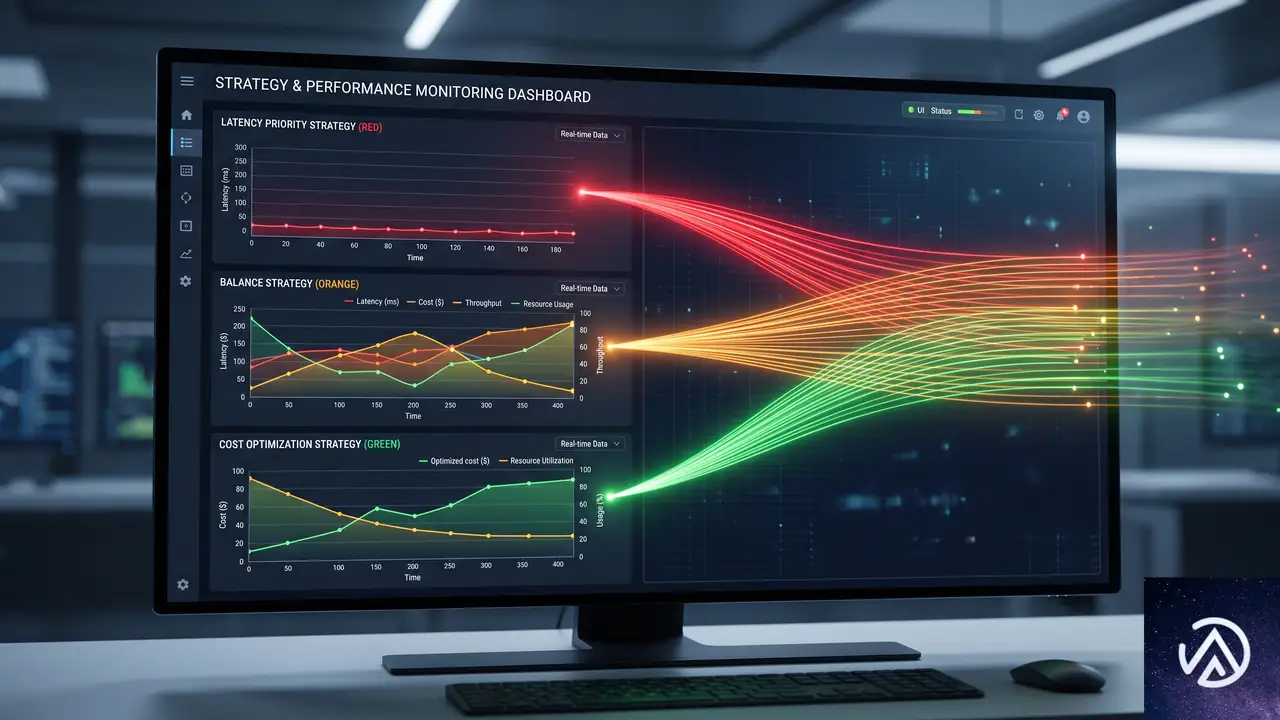
GKEでは、すべてのエージェントに一律の戦略を強制するのではなく、ノードプールやワークロード設定ごとに異なる挙動を共存させられる。Google Cloudのブログでは、レイテンシ要件に応じた3つの典型例が紹介されている。
リアルタイムコーディングアシスタント(レイテンシ重視)
開発者向けの対話型エージェントでは、起動時間が1秒未満であることと、待ち行列が一切発生しないことが絶対条件だ。このケースでは、GKE Podスナップショットと「Agent Sandboxウォームプール」を組み合わせる。事前にウォームアップされた隔離サンドボックスを常時待機させておくことで、ほぼ瞬時に実行を開始できる。この構成で同一ノード上に133個のエージェントを収容できたと報告されている。
自律的なチームメイト型エージェント(バランス型)
バックグラウンドで対話的に動くエージェントは、平均的な起動時間(数秒)を許容できる。サスペンド&レジューム機能を利用し、遊休時にはリソースを解放、必要時にオンデマンドで復元する。待機中のコンピュートコストを支払う必要はない。
ヘッドレスなバックグラウンドエージェント(レイテンシ許容型)
日次レポートの生成や調査タスクのような定期ジョブは、多少の待ち時間があってもビジネス成果に支障をきたさない。こうしたエージェントには最大限のリソース超過割り当てを適用し、クラスタに空きが出るまで1時間ほど待つ戦略も有効だ。
このように、ワークロードの性質に合わせて「パフォーマンス最適化」と「コスト最適化」のバランスをチューニングできるのがGKEの強みだ。サンダリングハード(多数のエージェントが一斉に起動してコンピュートを要求する問題)に対しても、ウォームプールやサスペンド&レジュームの設定で自由度の高い制御が可能になる。
コスト削減を実現するための実践的なアプローチ
GKE Agent Sandboxとオーケストレーションの組み合わせによって、エージェントの台数に比例してインフラ予算が増えていく構図を抜本的に変えられる。Google Cloudの検証では、パフォーマンスを重視する構成でも133個のエージェント(ベースライン比約2.2倍)、コスト最適化を突き詰めた構成では274個(同3.5倍)のエージェントを同一ノードで動作させることに成功した。
実務に落とし込む際のポイントは3つある。第一に、セキュリティを保ったままオーバーヘッドを削減するGKE Agent Sandboxへの移行を検討すること。第二に、Podスナップショットによる「凍結・再開」をアーキテクチャに組み込み、遊休リソースを徹底的に活用すること。第三に、すべてのエージェントを同じ扱いにせず、レイテンシ要件に応じてデプロイ設定を変えることだ。
なお、GKE Agent Sandboxの詳細な設定やウォームプール、サスペンド&レジュームの具体的な手順は、Google Cloudの公式ドキュメントで公開されている。まずは既存のエージェントワークロードを対象に、小規模なPoCから始めてみるとよいだろう。
この記事のポイント
- GKE Agent SandboxはgVisorベースの軽量サンドボックスで、マイクロVMに比べてエージェント密度を44%向上させ、1台あたりのコストを30%以上削減する
- Podスナップショットとサスペンド&レジュームの組み合わせにより、遊休エージェントを凍結して物理リソースを解放し、理論上3.5倍の密度(最大75%のコスト削減)を達成可能
- ワークロードのレイテンシ要件に応じて「リアルタイム型」「バランス型」「コスト最適化型」の3戦略を使い分けることで、無理なくスケールできる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloud、OKF v0.2でエージェント間の信頼問題に挑む
Google Cloudは2026年7月24日、エージェントやAIが生成・共有する知識の信頼を体系的に扱えるフォーマット「Open Knowledge Format(OKF)」のバージョン0.2を発表した。OKF v0.2では、来歴・信頼レベル・鮮度・ライフサイクル・計算結果の証明という5つの問いにファイルのメタデータで直接答えられるようになる。
エージェント同士が大量の知識を自動生成してやり取りする世界では「誰がいつ作り、本当に確認済みで、今も正しいのか」という情報抜きに安心して使えない。OKF v0.2はこの課題に、マークダウンとYAMLフロントマターというシンプルな仕組みで応えるものだ。
すべての新フィールドはオプションであり、v0.1からの後方互換性も保たれている。ただし、これらの信頼信号が「ない」こと自体が「未検証」として識別可能になる点が重要である。
エージェント間知識共有で失われる「暗黙の信頼」を補う
OKFは、テーブルスキーマやメトリクス定義、運用ルールブックといったエージェントが必要とするコンテキストを、特定プロプライエタリなサービスではなく、標準的なフォーマット上に保持することを目指して登場した。2026年6月のv0.1では、マークダウン本体とYAMLのフロントマター、少数の規約という最低限の構成だった。
今回のv0.2は、コミュニティからのフィードバックを踏まえたものである。多くの拡張提案やエコシステムツールのカタログ化が進む一方、最も大きな懸念として浮上していたのが「エージェントが書き込んだ知識を信用できるのか」という問いだった。
人が手書きしたWikiページには、作成者の責任という暗黙の保証がある。しかし、エージェントが一晩で数千もの概念を生成する世界では、その保証は機能しない。消費者(これも別のエージェントであることが多い)は、明示的な信号だけを頼りに概念を評価しなければならず、具体的には次の5つの問いに答える必要がある。
- 何から作られたのか(来歴)
- どれだけ信頼できるのか(信頼)
- まだ正しいのか(鮮度)
- 現在のバージョンはどれか(ライフサイクル)
- その数値は規定の方法で算出されたか(証明)
OKF v0.2では、これらすべての問いにフロントマターのフィールド群で答えられ、しかもフォーマットとしての意見の少なさは維持される。
記述から判断へ、信頼をフィルタリングするメタデータ
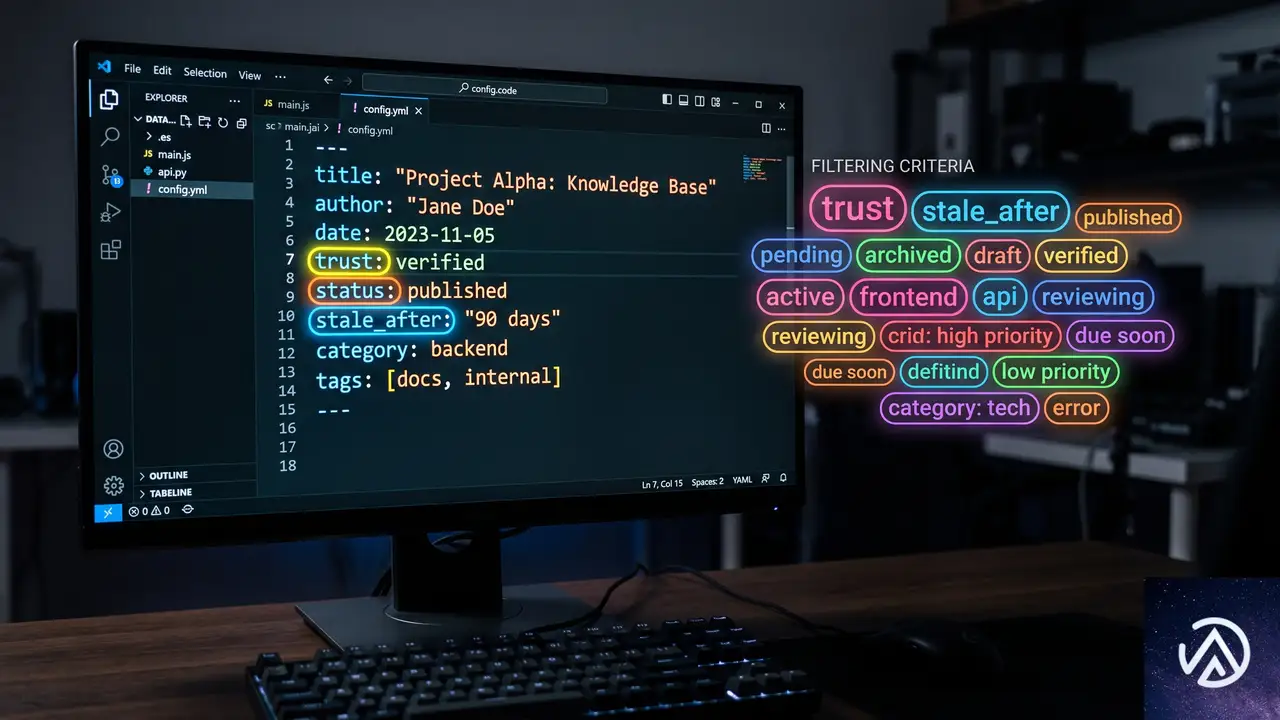
v0.1のフロントマターには、概念のタイプやタイトル、説明、リソース、タグといった「その概念が何か」を示す情報が含まれていた。v0.2ではこれに加え、「読む前にその概念について決断するための情報」、すなわち誰が作り、検証済みか、鮮度はどうか、値がどう計算されるべきかといったフィールドが追加されている。
これらの信号をフロントマターに置く理由は明確だ。エージェントが検索・探索する際、最初に行うのは「この概念がそもそも関連性があるか」の判断であり、多くの場合、ファイル本文にまでアクセスする必要はない。本文に含まれる情報は簡潔であるべきだが、フロントマターは信頼性と関連性の判断だけを支援する信号を凝縮して提供する。トークン消費を抑えつつ、高頻度で安価にチェックできるためだ。
これにより、信頼は「読み始める前にフィルタリングできる」ものになる。
来歴(Provenance)で素材と信頼信号を記録する
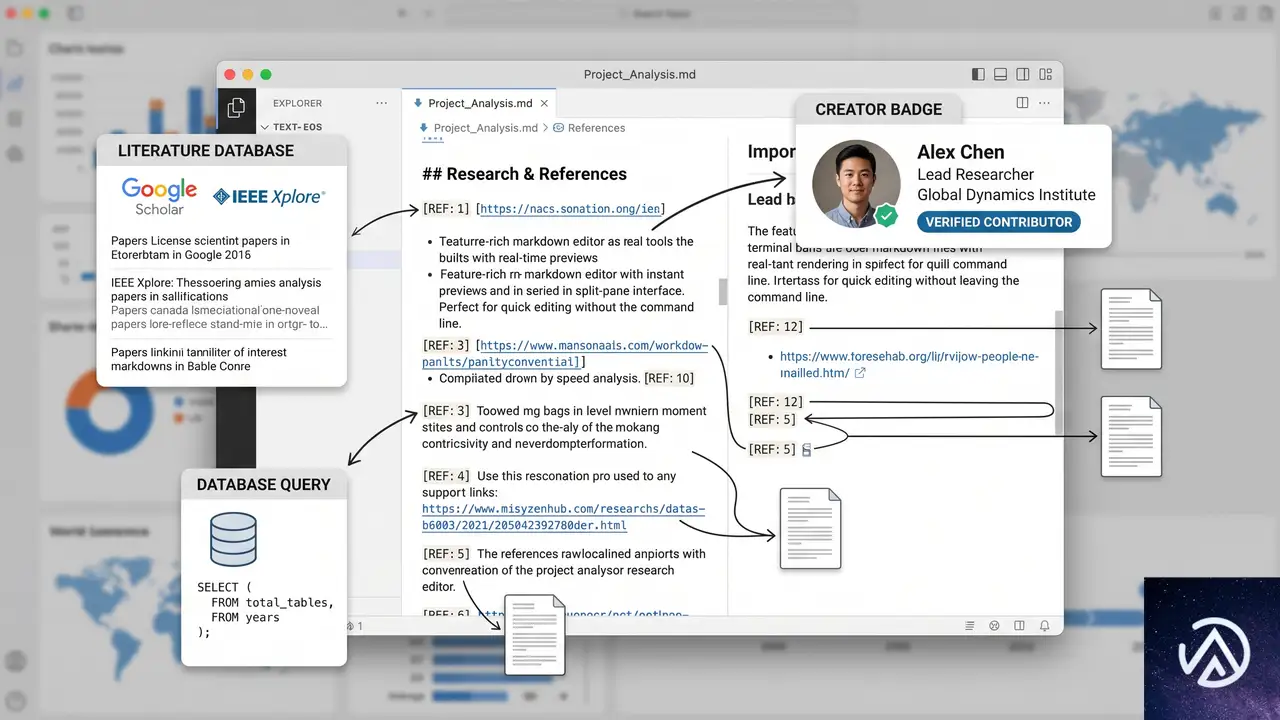
新しい sources フィールドは、概念が派生した素材を記録する。外部ドキュメント、バンドル内の相対パス、あるいは「プロジェクトXの全クエリ」といったスコープ記述子まで格段に表現できる。同時に、各エントリは author、usage_count、last_modified といった客観的なクレジビリティ信号を持てる。
ここであえて「信頼スコア」を導入しなかった点がOKFの設計思想を表している。スコアは主観的で、消費者ごとに通用せず、付けられた瞬間から陳腐化しやすい。OKFは信号を記録し、信頼度の推論は消費者側に委ねる。利用頻度が高く、最近更新され、信頼できる作成者がいる素材ほど信頼されるのは人の判断と変わらず、必要に応じて動的にスコアリングも可能だ。
本文中で特定の素材を引用する場合は、通常のマークダウンの脚注記法([^export-schema])を使い、末尾に追いやるのではなく主張単位で出典を結びつける。
信頼の階層を generated と verified で分離する
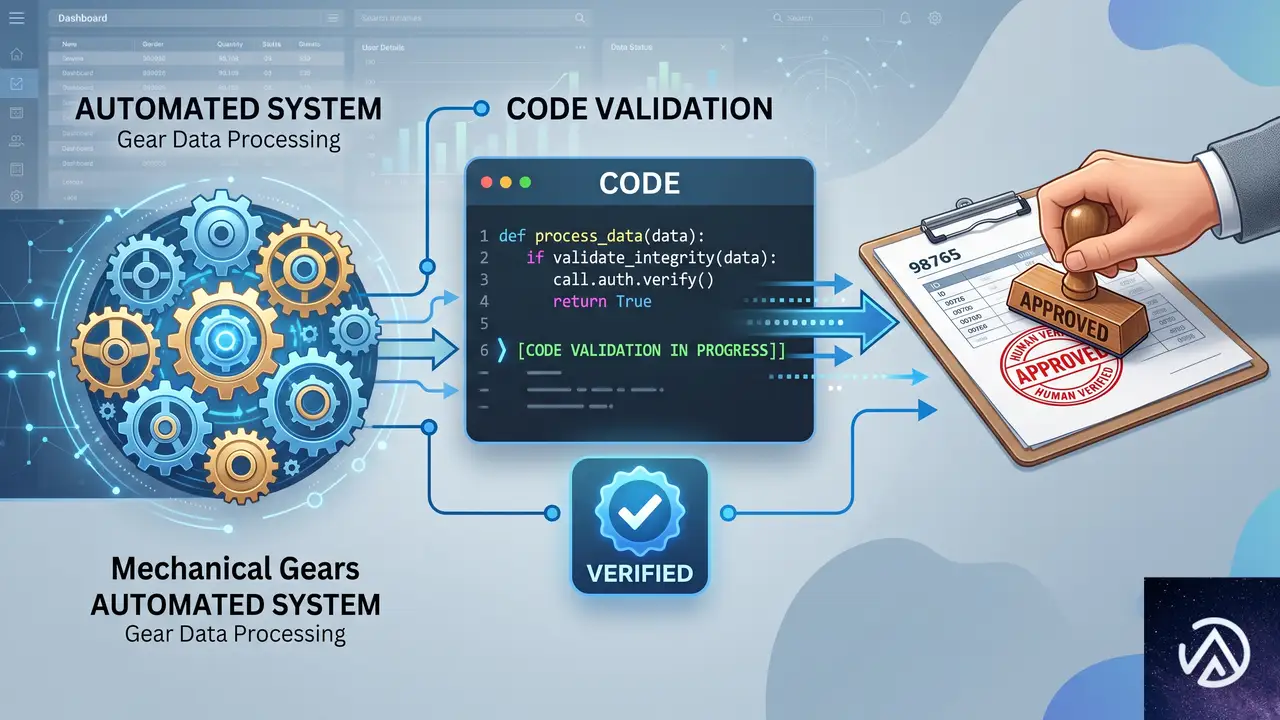
信頼は2つの独立したフィールドで確立される。何かを作った者とそれを確認した者は必ずしも同一ではないからだ。
generated { by, at }現在のコンテンツが誰によって、いつ最後に意味的な変更を加えられたかを記すverified [ { by, at } ]素材や元リソースに対する独立した確認のリスト。人間の承認、定期的な財務プロセス、あるいは両方を含む
verified の有無と内容から、消費者は「信頼ティア」を導出できる。未入力なら未検証、機械のアクターだけならマシン確認済み、human:<id> が含まれれば人間レビュー済みとなる。これはあくまで助言信号であり、アクセス制御ではない。しかし、エグゼクティブ向けダッシュボードでは「人間レビュー済みのメトリクスだけを表示する」といったフィルタリングがフロントマターだけで可能になる。
title: 売上高
description: 当四半期の純売上
(信頼信号は皆無 / エージェントにとって不透明)
title: 売上高
generated:
by: reference_agent
at: 2026-07-20
verified:
– by: human:vp_finance
at: 2026-07-23
stale_after: 2026-12-31
status: stable
このように、v0.2のフロントマターは「読まずに判断する」ための情報を一箇所にまとめる。概念の本文を開く前に、信頼性でフィルタリングできるため、大量のエージェント生成知識を効率よく扱える。
鮮度とライフサイクルを stale_after と status で宣言する
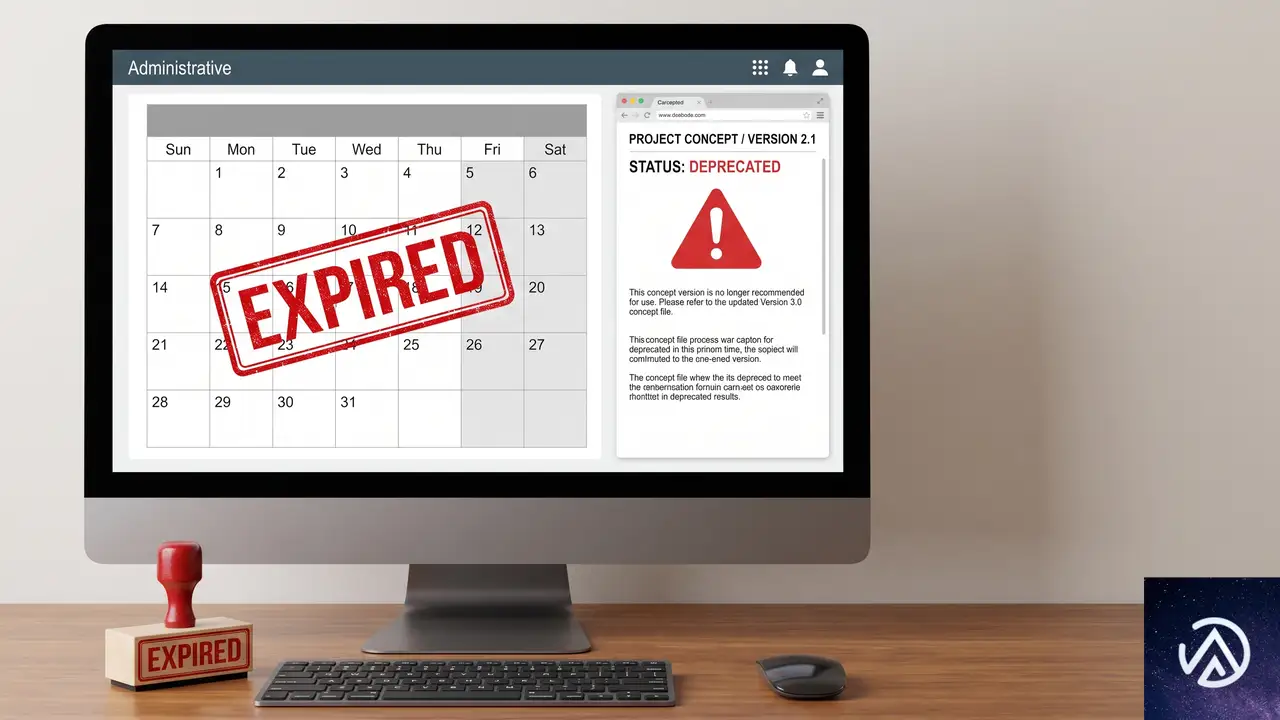
知識が「今も正しいか」を機械的に判断するために、OKF v0.2は stale_after と status を使う。status は概念を draft → stable → deprecated と遷移させ(省略時は stable)、stale_after は絶対日付で鮮度切れを表す。相対TTL(Time to Live)ではなく絶対日付を採用したのは、非LLMの決定論的な消費者が単純な日付比較で陳腐化を判定できるようにするためだ。
たとえば、ある小売企業の財務チームが毎年1月にポリシーを再承認する場合、関連メトリクスには stale_after: 2026-12-31 を付与する。2027年1月1日以降、これらの概念は再検証を経なければ利用させない、といったルールをコード化できる。また、status: deprecated を設定すれば、古い計算式で定義されたメトリクスを履歴再現用に保存しつつ、新しい作業では表示させないことも簡単だ。
計算の正当性を検証するAttested Computation
来歴は「主張がどこから来たか」を答えるが、エージェントが実際にドル換算の数字を報告する瞬間には、より厳しい問いが必要になる。「その数値は規定された方法で算出されたのか、それともエージェントが勝手にSQLをでっち上げたのか」である。
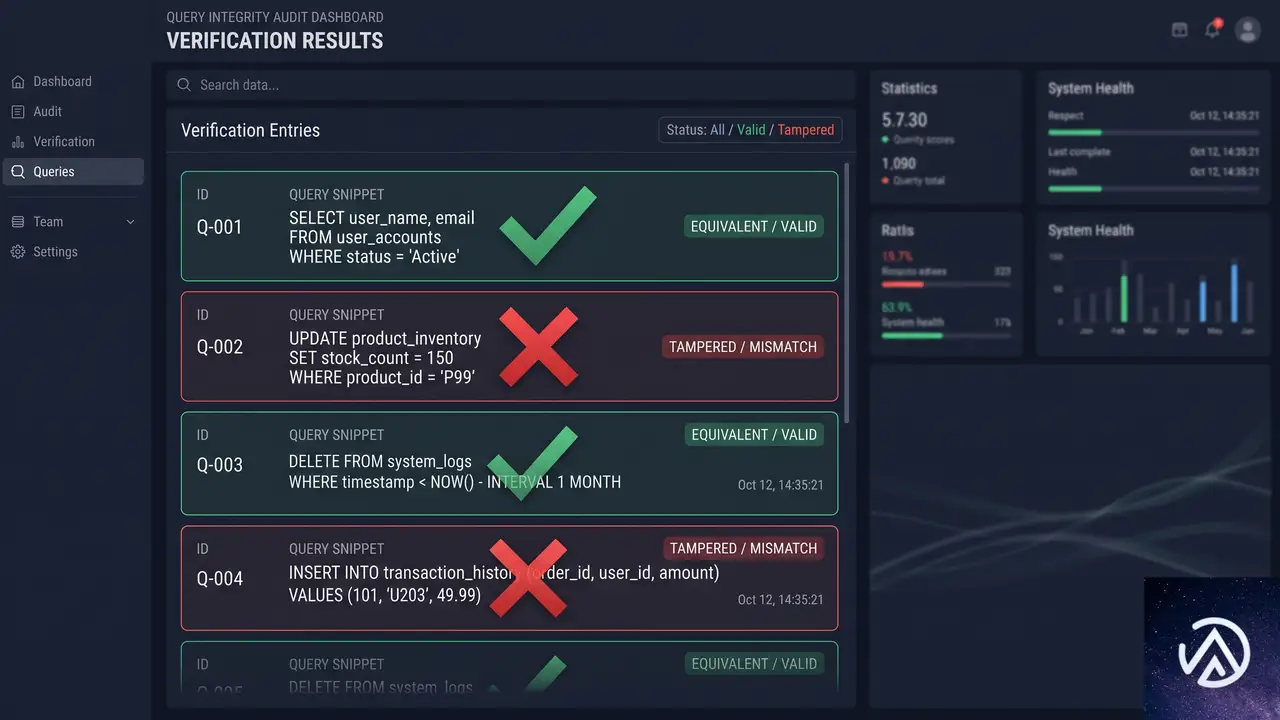
OKF v0.2は Attested Computation という新しい概念タイプを導入した。これは値の意味だけでなく、認可された計算方法と、それが実際に実行されたことを検査する手段を併せ持つ。エージェントは宣言されたパラメータを埋めるだけで、計算式そのものを編集してはならない。消費者は、指定されたエグゼキューターで計算を実行し、レシート(実行されたSQLやジョブID、結果)を取得し、決定論的なアテスター(LLM不要の検証プロセス)でレシートを検査する。
アテスターは、承認済みの計算定義と実行されたクエリが等価であるか、表示された値がレシートの情報源と一致するかを機械的に確認する。SQLを正規化し、コメントや空白を除去して比較するといった方法で、テーブル名の差し替えやフィルタの追加、JOINの欠落を検出する。検証に失敗すれば、消費者はその値を表示しない。
この仕組みによって、定義の検証(verified)と実行時の証明(アテステーション)が分離される。定義が古くても実行時の証明は通る可能性があり、定義が最新でも毎回の実行で証明を取らなければならない。両者が必要だからこそ、OKF v0.2は双方を備えている。
v0.2の互換性とエコシステム
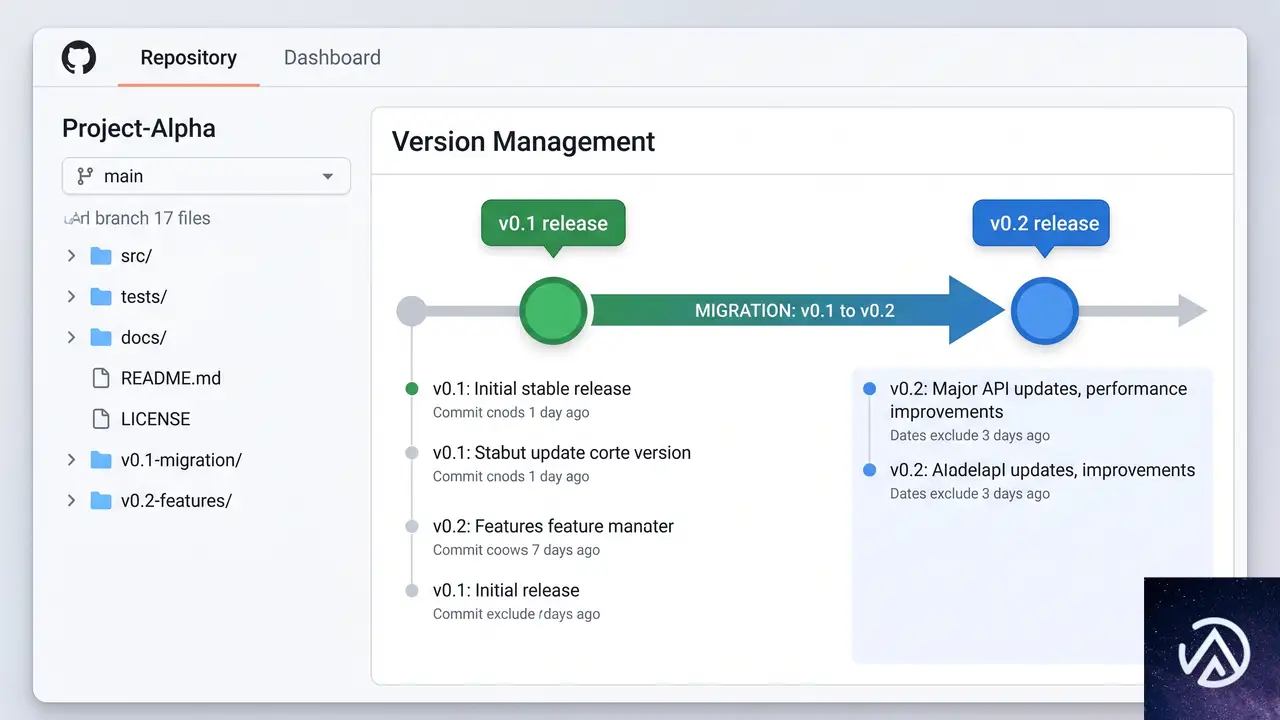
v0.2はマイナーバージョンアップであり、v0.1のバンドルは無変更でそのまま読み込める。意図的な名称変更として、timestamp が generated.at に、本文末尾の引用リストが sources フィールドに置き換わっているが、いずれもv0.2の消費者がv0.1の形式にフォールバックできる。
GitHub上のリファレンス実装もv0.2対応が進められており、サンプルバンドル(GA4 eコマース、Stack Overflow、Bitcoin、本稿で紹介された小売の例)はv0.2のフィールドを備える。また、Google CloudのKnowledge Catalog(旧Dataplex)を用いたデモでは、OKFの信頼信号をカタログ往復後も維持できることが示されている。
この記事のポイント
- OKF v0.2は来歴・信頼・鮮度・ライフサイクル・計算結果の証明をフロントマターで表現し、エージェント間知識の信頼を形式化する
generatedとverifiedの分離により、作成と確認の責任を切り分け、人間レビュー済みなどのティア別フィルタリングが可能stale_afterとstatusで機械的な鮮度管理とライフサイクル制御を実現- Attested Computationでは計算式の改ざんを検出し、結果の証明を決定論的に行う
- 後方互換性を保ちつつ、信号の不在が「未検証」として区別されることで、暗黙の信頼から脱却できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Cloud Runのマルチリージョン高可用性が強化、障害検知と自動復旧が数秒単位に
発表の概要

Google Cloudは2026年7月20日、Cloud Runにおけるマルチリージョン高可用性の機能強化を発表した。ミッションクリティカルなアプリケーションのダウンタイムは、企業の収益や評判に直結する問題だ。これに対処するため、Cloud Runは単一コマンドで複数リージョンに同一サービスを展開できる設計をとってきたが、今回のアップデートで障害検知と自動復旧の精度が大幅に向上している。
新たに導入された機能は「Readiness Probe」と「Service Health」の2つだ。インスタンスレベルの死活監視とリージョンレベルの健全性評価を組み合わせることで、リージョン障害が発生した際のトラフィック迂回が数秒単位で自動化される。
マルチリージョン高可用性を支える2つの新機能

Readiness Probeの役割は「個々のコンテナが外部リクエストを受け付けられる状態か」を確認することだ。この結果はCloud Runコンソールからもリージョン別に確認でき、どのリージョンでインスタンスが縮退しているかが一目で分かる。
Service Healthはこのプローブ結果をリージョン単位で集約するレイヤーにあたる。複数のヘルスチェック結果を「そのリージョンが正常に稼働しているかどうか」というひとつの評価に落とし込み、グローバルロードバランサがこの評価に基づいてルーティングを切り替える。この仕組みにより、障害発生時の手動オペレーションが原則不要になる。
パブリックとプライベートで異なる自動フェイルオーバーの経路

自動フェイルオーバーを実現するには、トラフィックが流入してくるネットワーク層によってロードバランサの種類を選択する必要がある。Cloud Runは外部向けと内部向けで最適なバランサ構成を用意している。
この構成の利点は、どちらのパターンでもロードバランサ側が自動でService Healthを参照し、異常リージョンをルーティング対象から外してくれる点にある。手動でのDNS切り替えや手作業によるトラフィック操作が不要になるため、復旧までの時間が大幅に短縮される。
設計段階で押さえるべき3つのポイント

Service Healthの活用を前提にマルチリージョン構成を設計する際、見落としやすい検討項目が3つある。いずれも高可用性に直結するため、初期段階で整理しておくことが望ましい。
単一障害点をなくすには、インフラ層だけでなくアプリケーション自体のステートレス設計が前提になる。データ層を別途冗長化し、ロードバランサの背後で自由にインスタンスを入れ替えられる状態を作っておくことが、Cloud Runのマルチリージョン構成を最大限活かす秘訣だ。
利用開始とコスト
Cloud Runのマルチリージョン高可用性に関する一連の機能は、すでに全リージョンで利用可能だ。Service Healthの機能そのものに追加料金は発生しない。Readiness Probeの実行に伴う標準的なCPU・メモリ消費のみが課金対象となる。
導入にあたっては、既存のCloud RunサービスにReadiness Probeを設定し、Service Healthを有効にしたうえで適切なロードバランサに接続するだけでよい。公式ドキュメントにチュートリアルが用意されており、少ないステップでマルチリージョン高可用性の基盤を整えられる。
この記事のポイント
- Readiness Probeがコンテナ単位の死活監視を行い、Service Healthがリージョン単位の健全性を可視化する
- Serverless NEGを通じてグローバルロードバランサに健全性が通知され、障害リージョンを数秒で自動迂回する
- パブリック向けは外部ALB、VPC内向けは内部ALBを選択すれば、どちらも自動フェイルオーバーに対応可能
- DB層を含めた全レイヤーでの冗長化と、データレプリケーションの方針決定が設計の鍵を握る
- 機能追加に伴う追加コストはなく、通常のリソース消費のみで全リージョンですぐに利用を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

83%の組織がエージェントAI対応にインフラ刷新が必要と回答、Google Cloud調査
Google Cloudが2026年7月に公開した「State of AI Infrastructure」レポートによると、実に83%の組織が「本番レベルのエージェントAIを支えるにはインフラの刷新が不可欠だ」と回答した。この数字はもはや一部の先進企業だけの課題ではなく、業種を問わず広がる構造的な問題を浮き彫りにしている。
本記事では、Google Cloud Blogの調査概要をもとに、エージェントAIが既存のクラウド基盤に与える負荷と、企業が次に打つべきインフラ戦略を解説する。推論コストの急増やエージェントの統制不能、データの断片化、エネルギー制約といったテーマを具体的なデータとともに取り上げる。
推論コストの急増と流動的コンピューティング

推論税の正体
エージェントAIは1回の指示で数百の後続アクションを連鎖的に引き起こす。チャット型AIのように単発で完結する処理とは根本的に負荷の性質が異なる。Google Cloud BlogのDrew Bradstock氏によれば、この連続推論ループがレガシーアーキテクチャに加わる経済的負担を「推論税」と呼んでいる。
調査では62%のリーダーが「データエグレス料金やストレージ肥大化、アイドル状態の専用ハードウェアによって深刻な推論税が発生している」と回答した。81%は運用の複雑さをAIスケーリングの隠れたコストとして挙げている。
上図が示すのは、エージェントAIの負荷特性と基盤の適合性がコストを左右する構図だ。ストレージ肥大化を放置すれば推論税は雪だるま式に膨らみ、競争力を大きく損なう。
TPU 8tとTPU 8iが示す選択肢
規模の大きいトレーニングにはTPU 8t、低レイテンシ推論にはTPU 8iといった具合に、用途に合わせた計算リソースを動的に組み合わせる発想が鍵になる。Google Cloud Blogの記事では、重いトレーニング、リアルタイム推論、オーケストレーションの3層に分けた「流動的コンピュート」が提案されている。
- 大規模学習向け:TPU 8t(第8世代)は第7世代比で約3倍の性能と最大2倍の電力効率を達成。超大規模モデルの学習時間を大幅に短縮する
- 低レイテンシ推論向け:TPU 8iはオンチップメモリを最大化し、リアルタイム応答が求められるエージェントの思考と反応を高速化する
- 制御プレーン向け:ArmベースのGoogle Axion CPUが強化学習シミュレーションやエージェントのオーケストレーションをコスト効率よく実行する
こうした選択肢を使い分けることで、ピーク負荷時だけ専用チップを割り当て、普段は汎用プロセッサに戻すといった柔軟なリソース管理が可能になる。
急拡大するエージェントの統制

エージェントスプロールの現実
エージェントはメールの読み取りからデータベース照会、業務ワークフロー実行まで自律的に動く。組織内で数十、数百のエージェントが稼働し始めると、個別管理が極めて難しくなる。これを業界では「エージェントスプロール(agent sprawl)」と呼び始めており、調査でも79%のリーダーがセキュリティ・ガバナンス・MLOpsを推論スケーリングの最大の課題に挙げている。
上図のように、統制プレーンを導入することで、これまで管理者が人力で追いかけていた権限設定や操作ログが集約され、監査や緊急停止も一元的に実施できる。調査では78%の組織が生成AIソリューションをメインのクラウドパートナーから直接調達しており、この集中傾向は2025年から30ポイント上昇している。
Agent Gatewayが担う役割
Google Cloud Blogで紹介されているAgent Gatewayは、企業向けに設計されたエージェント統制のハブだ。エージェント同士のデータ共有を可視化し、読み取りと書き込みのスコープを細かく設定できる。重要なアクションの前には人間の承認を挟むヒューマンインザループ機能も提供する。
- 全エージェントの認証を統一し、分散ツールをつなぎ合わせる必要がない
- データ共有のログと監査証跡を完全に管理できる
- エージェント単独では実行できない重要操作に対して、人による承認フローを組み込める
スケールする自律エージェント群を安全に運用するうえで、こうした統制基盤はもはやオプションではなく必須のレイヤーになりつつある。
データ基盤の統一

自律型エージェントは推論のたびに組織全体へ重いクエリを発行する。Drew Bradstock氏の指摘では、データがサイロ化して断片化していると「エージェントは事実上、目隠しをされたまま飛んでいる」状態になるという。このため、断片化したデータを単一の文脈で扱える統合データ層の整備が急務とされている。
統合データ層が整うと、エージェントはデータの置き場所を意識せずに検索・推論できる。非構造化データを自動的に構造化するSmart Storageと、マルチクラウド環境を横断するCross-Cloud Lakehouseが、この層を現実のものにしている。
ハイブリッドマルチクラウドとデジタル主権

パブリッククラウドかオンプレミスかという二者択一はすでに終わっている。調査では52%の組織がハイブリッドマルチクラウド構成を採用していた。これは単なるコスト分散ではなく、デジタル主権とデータの重力が強い推進力になっているからだ。
- データ所在地規制への対応:調査参加者の48%が厳格なデータレジデンシー管理を優先事項に挙げている。各国の法改正に即応できる柔軟な配置が求められる
- 完全隔離環境の需要:Google Distributed Cloudのようにパブリッククラウド技術をオフラインで利用できるサービスが、政府機関や金融機関を中心に拡大している
- データ重力の現実:巨大なデータセットは動かすより「その場で処理する」方が現実的で、エッジやオンプレとの組み合わせが不可欠になる
つまり、単一のクラウドに依存する時代は終わり、データの物理的な位置と主権に合わせてAIを走らせる場所を選べるアーキテクチャが標準になりつつある。
エッジでのAI実行が必然になる理由

調査結果の中で特に目を引くのが、90%の組織が「エッジへのAI配置が重要」と回答し、72%は「極めて重要」または「非常に重要」と位置づけた点だ。エージェントAIのリアルタイム性を追求するほど、集中型クラウドだけでは限界が露呈する。
エッジに推論機能を分散させると、クラウド往復のレイテンシが不要になるだけでなく、通信断でも業務が停止しない耐障害性と、トークンあたりの変動費削減を同時に実現できる。製造現場や病院、小売店舗など「止まらない自律処理」が求められる現場にとって、これが決定的な価値になる。
エネルギー壁を突破する設計

91%のリーダーがハードウェア選定時に消費電力を考慮し、61%はそれを「主要または極めて重要な要素」と位置づけている。かつて年次報告書のサステナビリティ指標でしかなかった電力消費が、今ではデータセンターの立地や事業継続そのものを左右する制約に変わっている。
- 電力網の逼迫:一部地域では追加電力の調達が不可能で、新規の計算インフラをプロビジョニングできない
- 規制圧力の強化:ドイツでは新設データセンターにPUE 1.2以下が義務化。アイルランドは大規模データセンターに100%のオンサイト発電能力を要求
- TCOへの影響:高消費電力のハードウェアは冷却設備やラック設計の大規模投資を強いり、総保有コストを押し上げる
Google Cloud Blogによれば、ワットあたりの性能向上が「戦略的資産」として位置づけられている。TPU 8tは第7世代比で最大2倍の電力効率を達成しており、規制基準を満たしながら高性能を維持する設計思想がエネルギー壁を突破するカギだとされている。
まとめ
本レポートの核心は「エージェントAI時代のインフラは、計算・セキュリティ・データ・エッジ・電力のすべてを統合的に設計しなければならない」という一点に集約される。AI Hypercomputerのような各レイヤーを共同設計するアーキテクチャが、高コストで機能不全に陥る従来モデルからの脱却策として注目されている。
物理世界とデジタルを結ぶフィジカルAIの波も現実化しつつあり、ロボットのトレーニングにデジタルツインを使う取り組みがGoogle Cloud上で始まっている。インフラ戦略を抜本的に見直すタイミングが、いま訪れていると言える。
この記事のポイント
- 83%の組織がエージェントAI本番運用にインフラ刷新が必要と回答
- 62%が推論税、81%が運用の複雑さをスケーリングの隠れコストと認識
- 79%がセキュリティ・ガバナンス・MLOpsを最大の課題に挙げている
- 90%がエッジAIを重要視し、72%は「極めて重要」と回答
- 91%がハードウェア選定で消費電力を考慮し、ワットあたり性能が新たな指標に
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Run Sandboxesがパブリックプレビュー、AI生成コードを安全に隔離実行
Cloud Run Sandboxesがパブリックプレビューに。AI生成コードを隔離実行

Google Cloudは2026年7月9日、Cloud Run上で信頼できないコードを安全に実行するサンドボックス機能をパブリックプレビューとして公開した。AIが生成したプログラムや、エンドユーザーがアップロードしたスクリプトを、ホスト環境やクラウドの認証情報から完全に分離した状態で動かせる。
起動はミリ秒単位で、既存のCloud RunインスタンスのCPUやメモリを共有する。追加のVMや専用のサンドボックスホスティングプラットフォームを使う必要はなく、追加料金も発生しない。この発表はベルリンで開催中のWeAreDevelopers World Congressで行われた。
これまで開発者は、AIが動的に生成したコードを安全に実行するために、コンテナクラスタを組んだり、サードパーティのmicroVMランタイムを契約したりする必要があった。Cloud Run Sandboxesは、その複雑さを取り除くサーバーレスネイティブの仕組みだ。
サンドボックスとは何か、なぜ必要なのか
サンドボックスとは、プログラムを隔離された領域で実行する仕組みのことだ。子供が砂場(サンドボックス)の中で自由に遊んでも、砂が外に散らばらないのと同じで、中で何が起きても外側のシステムには影響を与えない。
AIエージェントやLLM(大規模言語モデル)がコードを生成する時代では、この隔離が極めて重要になる。モデルが書いたPythonスクリプトに意図しないファイル削除やネットワーク経由のデータ流出が含まれていたとしても、サンドボックス内で止められるからだ。
Cloud Run Sandboxesは、既存のCloud Runサービスインスタンス内でほぼ瞬時に生成できる軽量な隔離実行境界だ。専用のVMを立ち上げる必要がなく、サーバーレス環境を離れずにすべてが完結する。
サンドボックスの仕組みとセキュリティ設計

シンプルな有効化とネイティブな呼び出し
利用開始は驚くほど簡単だ。Cloud Runサービスをデプロイする際に、gcloudコマンドまたはYAML設定でサンドボックスランチャーを有効にするフラグを1つ追加するだけでよい。有効化すると、軽量なサンドボックスCLIバイナリが実行環境に自動でマウントされ、標準的なサブプロセス呼び出しでプログラムからサンドボックスを生成できる。
実際の動作例として、LLMが動的に生成したPythonコードを安全に実行するデモが公開されている。1000個のサンドボックスを起動し、それぞれの処理を実行して停止するまでの平均レイテンシは500ミリ秒だ。
ゼロトラストを前提とした3層のセキュリティ境界
Cloud Run Sandboxesは、悪意あるコードや誤ったコードからホストアプリケーションとクラウドリソースを守るために、3つの重要なセキュリティ境界を強制する。
この3層構造によって、AIが生成したコードがどれほど予測不能な動作をしても、ホスト側への影響は生じない。セキュリティを理由にAIコード実行を諦めていた開発者にとって、大きな転換点になる。
3つの主要ユースケース
Cloud Run Sandboxesは特に以下の3つの用途で力を発揮する。いずれも「信頼できないコードを隔離実行する」という共通の要件を持つシナリオだ。
ADKとComputeSDKとの統合
Cloud Run Sandboxesは、Googleのエージェント開発キットであるADK(Agent Development Kit)の次期バージョンでネイティブサポートされる。新しいCloudRunSandboxCodeExecutorを使うと、ADKエージェントがわずか1行のコードでサンドボックス内のコード実行を指示できる。
また、ベンダーに依存しないサンドボックス実行用SDKであるComputeSDKにも対応が追加された。このSDKを使えば、Cloud Runサービスの外部からリモートでサンドボックスを呼び出すことも、サービス上のローカルツールとして直接使うこともできる。既存のツールチェーンにスムーズに組み込める設計だ。
コスト面の利点と実運用への影響
Cloud Run Sandboxesの大きな特長は、追加コストが一切かからないことだ。オンデマンドのVMに対して高いプレミアムを課金する専用サンドボックスホスティングプラットフォームとは異なり、既存のCloud Runインスタンスに割り当てられたCPUとメモリを直接共有する。
起動時間がミリ秒単位であることも実運用上の利点だ。従来のVMベースの隔離環境では、新しいVMを立ち上げるたびに数秒から数十秒の待ち時間が発生していた。Cloud Run Sandboxesなら、ユーザーからのリクエストに対してほぼ待ち時間なく応答できる。
Google Cloud Blogの記事で紹介されたデモでは、1000個のサンドボックスを起動してコードを実行し、終了するまでの平均レイテンシが500ミリ秒だった。これは「AIが生成したコードをリアルタイムで安全に実行する」という要件に対して十分実用的な数値だ。
この記事のポイント
- Cloud Run SandboxesはAI生成コードや信頼できないバイナリを安全に実行する隔離環境で、パブリックプレビューとして公開された
- 起動はミリ秒単位で、既存のCloud Runインスタンスのリソースを共有するため追加コストは発生しない
- 環境変数の隔離、ネットワーク通信のデフォルト遮断、安全なファイルシステムオーバーレイの3層でセキュリティを確保
- LLMコードインタプリタ、ヘッドレスブラウザ、ユーザー提出コードの実行が主要ユースケース
- ADKとComputeSDKに組み込み対応し、開発者は1行のコードでサンドボックス実行を指示できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Claude Fable 5がGoogle Cloudで一般提供開始。エージェント構築の新たな基盤を考察
Anthropicの最新モデル「Claude Fable 5」が、Google Cloud上で一般提供を開始した。このモデルは複雑な多段階推論や高度なコード生成を得意とし、長期間にわたって自律的に動作するエージェントの構築に適している。クラウドAIの基盤に何が起きているのかを読み解く。
Claude Fable 5の登場とその戦略的な位置付け
Anthropicのモデル群には、Haiku(軽量高速)、Sonnet(バランス)、Opus(超高性能)がある。今回登場したFableシリーズは、これらのニックネームとは明らかに異なる文脈を持つ。筆者の見解では、Fableは「物語(ストーリー)の生成」、つまり長文脈の一貫性維持や、複雑なオーケストレーションを必要とするエージェントタスクに特化した系統と位置付けられる。
このモデルは単に速度や知識量を競うだけでなく、「どれだけ複雑な仕事を最後までやり遂げられるか」を重視している。特に、長期稼働エージェントとしての使用が強く想定されている点が、他のモデルとの差別化要因だ。
Fable 5は、単発のレスポンスを返すだけではない。途中で文脈を見失ったり、指示を忘れたりする問題を大幅に低減し、ソフトウェア開発や分析業務といった長時間の集中を要するタスクで真価を発揮する。
Fable 5の主要な能力と想定されるユースケース
Google Cloudの公式発表とAnthropicのリリースノートから、Fable 5の中核的な機能強化点を読み解くと、以下の3つに集約される。
複雑な多段階推論と高度なコード生成
Fable 5は、数学的推論やコード生成ベンチマークで大幅な性能向上を達成している。これは単にコードを出力するだけでなく、既存のリポジトリ全体を理解し、アーキテクチャレベルの提案ができることを示す。典型的な「次のトークン予測」を超え、人間のソフトウェアアーキテクトのように数手先を読む能力が強化された。
長期稼働エージェントの実現
多くのLLMは文脈が長くなると応答精度が落ちる。Fable 5は「長時間にわたって自律的にツールを使い、タスクを完了させる」というエージェント動作に最適化されている。カスタマーサポートの自動化、継続的なデータ収集、IT運用の自動化など、数時間から数日単位で動くAIエージェント基盤として機能する。
深いマルチモーダル文書分析
テキストだけでなく、PDF内のグラフ、パワーポイントの図表、画像内のテキストまでを横断的に理解する能力が向上した。これにより、企業内に散在する非構造化データの分析ハードルが大幅に下がる。数百ページの契約書や仕様書を読み込ませ、瞬時に要約や矛盾点の洗い出しを行うといった使い方が視野に入る。
これらの能力は、もはや「優秀なアシスタント」ではなく「自立したチームメンバー」という表現が近い。開発現場ではコードレビューを完全自動化し、法務部門では契約書の精査を任せられる。人間が最終判断する仕事の質とスピードが、根本から変わる可能性をはらんでいる。
Google CloudのAgent Platformがもたらす実用性
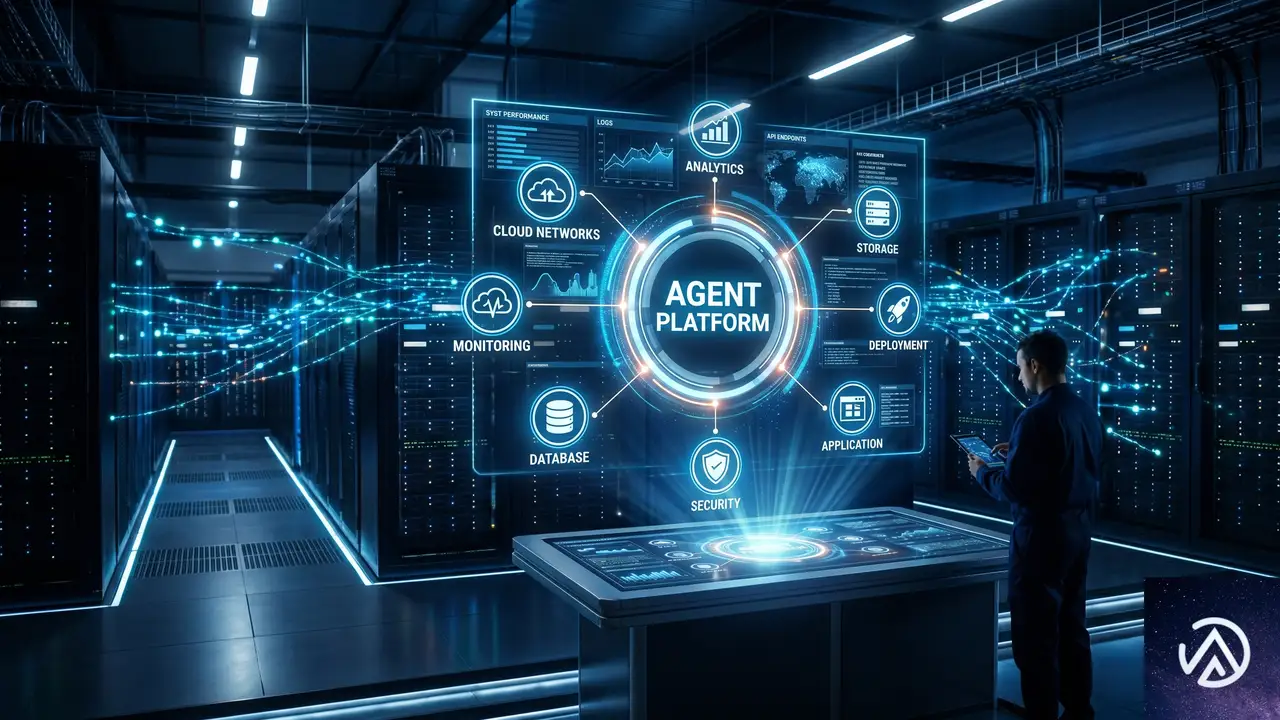
モデル単体の性能もさることながら、今回の発表で注目すべきはGoogle Cloudの「Agent Platform」上で提供される点だ。これは単なるAPIゲートウェイではない。エージェントの構築、テスト、デプロイ、監視までを垂直統合した基盤である。
具体的には、Googleが持つエンタープライズグレードのセキュリティ(IAM、VPC Service Controls)、Vertex AIのMLOps機能(モデル評価、メタデータ管理)、そしてCloud RunやBigQueryといった周辺サービスとの統合がシームレスに行える。Fable 5のような高度なモデルを「安全に」「堅牢に」本番環境で動かすために必要なピースがあらかじめ揃っている。
ここで重要なのは、強力なモデルを手に入れることと、それをビジネスで使いこなすことの間にあるギャップが、Agent Platformによって埋められる点だ。認証基盤や監査ログが整っていない状態でAIエージェントに重要な業務を任せることは難しい。Google Cloudのプレゼンスは、企業のAI導入における「最後の1マイル」を解決する。
開発者が今日から試すべき3つのアプローチ
Fable 5とAgent Platformが利用可能になったことで、Web制作やシステム開発の現場で即座に試せる実験領域が広がった。筆者の視点から、特に費用対効果が高いと想定される3つのシナリオを提示する。
コードレビューの完全自動化プロトタイプ
GitHub連携をトリガーに、Fable 5がPull Request全体を解析する。コーディング規約のチェックだけでなく、コードの脆弱性、パフォーマンス劣化リスク、過去の類似実装との矛盾点までを自然言語でレビューコメントする。人間のレビューアは、Fable 5が出した指摘が正しいかどうかの最終判断だけに集中できる。
非構造化ドキュメントのデータベース化
クライアントから提供された古い仕様書のPDF、競合分析のスライド、展示会で撮影したホワイトボードの写真などをまとめてFable 5に投入する。モデルはこれらを横断的に解析し、共通する要求定義や矛盾する記述を抽出して構造化データとして出力する。データベースに格納することで、後続の検索やレポート作成が自動化される。
社内向け「なんでも調査エージェント」の起案
定型的なリサーチ業務をエージェント化する。例えば「3ヶ月以内に更新された特定分野の法改正情報を、週次で一覧化してSlackに投げる」といったタスクをFable 5に任せる。モデルが自律的にGoogle検索や社内Wikiを巡回し、複数ステップの推論を経て最終的なサマリーを生成するPoCは、数日あれば構築可能だ。
このアプローチによって、人間の工数は「クリエイティブな問題解決」と「AIの提案に対する最終的な意思決定」に集中できるようになる。
この記事のポイント
- Anthropicの最新モデルClaude Fable 5は、複雑な推論と長期稼働エージェントに特化してGoogle Cloud上で一般提供が開始された
- 高いコード生成能力と深いマルチモーダル分析を持ち、単なるテキスト生成を超えたタスクの自動化が可能になった
- Google CloudのAgent Platformとの統合により、エンタープライズレベルのセキュリティと運用基盤が整備されている
- 人間はAIの最終判断に集中する働き方へシフトするため、コードレビューや文書分析のプロトタイプを早期に試す価値がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloud、AlloyDB向けリモートMCPサーバーがGA。AIエージェントとDBの安全な統合を実現
Google CloudがAlloyDB向けのリモートMCP(Model Context Protocol)サーバーの一般提供を発表した。これまでローカル開発が中心だったMCPだが、本番環境での運用に耐えるフルマネージドな仕組みとして登場した。AIエージェントが企業のオペレーショナルデータベースに直接アクセスし、安全にクエリを実行できるようになる。
この記事では、リモートMCPサーバーが解決する技術的課題と、AlloyDBを基盤にしたエージェントアプリケーションの構築方法を解説する。データの鮮度、セキュリティ、運用負荷のバランスを取るアーキテクチャを具体的に示す。
リモートMCPとは何か(ローカルMCPとの違い)
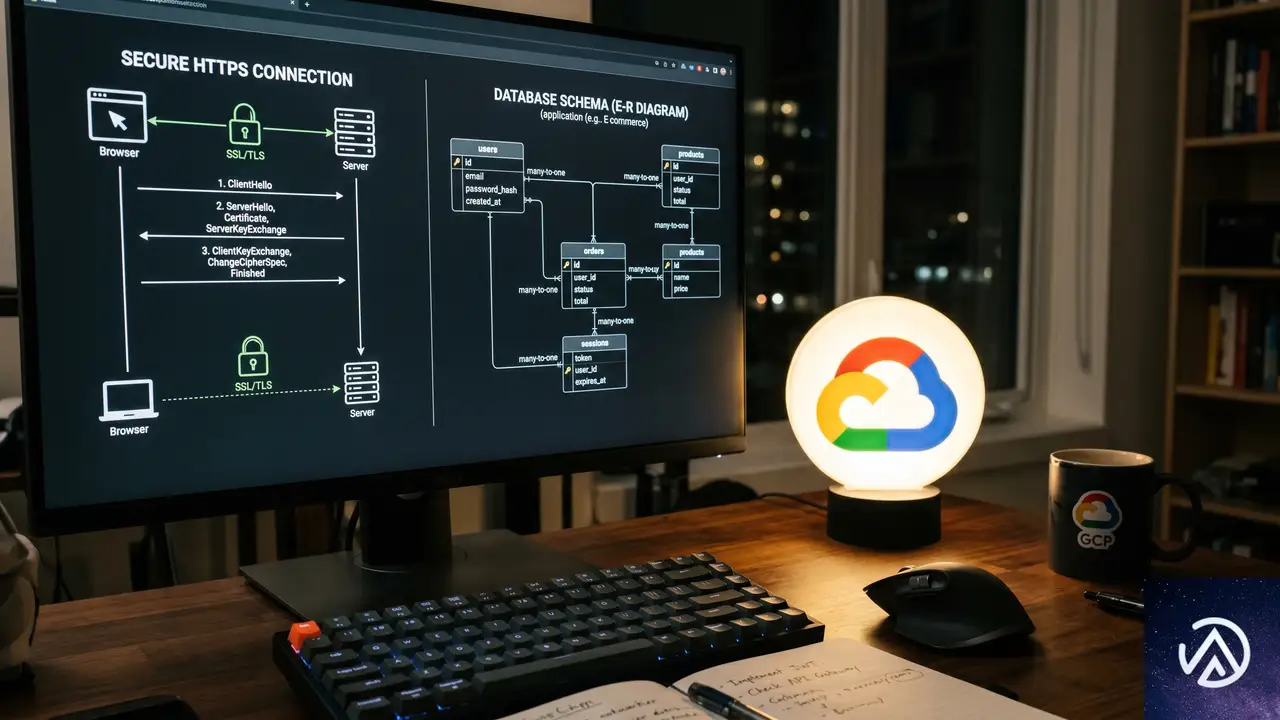
MCP(Model Context Protocol)とは、大規模言語モデル(LLM)が外部のデータソースやツールと安全に通信するためのオープン標準プロトコルだ。Anthropicが提唱し、現在では多くのAIエージェントフレームワークで採用されている。従来は開発者のローカルマシン上で動作する「ローカルMCPサーバー」が主流だった。
ローカルMCPサーバーは標準入出力(stdio)を使ってプロセス間通信を行う。これは開発段階では手軽だが、本番環境に持ち込むと途端に問題が顕在化する。複数のエージェントインスタンスが同時にデータベースへアクセスする場合、プロセス管理が複雑化し、ネットワーク越しのセキュリティ確保も難しくなる。
リモートMCPサーバーは、これらの課題をHTTPエンドポイント経由で解決する。Google Cloudのマネージドインフラ上で動作し、OAuth 2.0ベアラートークンによる認証とIAM(Identity and Access Management)によるきめ細かな権限制御を提供する。エージェント開発者はインフラ管理から解放され、クエリ実行に集中できる。
なぜAlloyDBと組み合わせるのか
AlloyDBはGoogle CloudのフルマネージドPostgreSQL互換データベースだ。標準PostgreSQLと比較して、ベクトル検索では最大6倍高速、フィルタ付きクエリでは最大10倍高速というパフォーマンスを備える。ScaNNインデックスを使えば100億ベクトル規模まで拡張でき、AIエージェントのRAG(検索拡張生成)ワークロードに最適化されている。
さらにAlloyDBには、データベース内で直接埋め込みベクトルを生成するAI Functionsや、Gemini Enterprise Platformモデルを使った検索結果のリランキング機能が組み込まれている。エージェントがデータベースにクエリを投げるだけで、最新のオペレーショナルデータに基づいた回答を得られる。データの鮮度を保つためのETLパイプラインが不要になるケースも多い。
リモートMCPサーバーが解決する5つの本番課題
Google Cloudブログの発表によると、リモートMCPサーバーは単なる通信方式の変更にとどまらない。本番環境でAIエージェントを運用するチームが直面する、以下の5つの課題を包括的に解決する設計になっている。
特に注目すべきはIAMによる権限制御だ。従来のデータベース接続では、共有パスワードやAPIキーを使うことが多かった。しかしリモートMCPでは、エージェントごとに特定のテーブルやビューへのアクセス権をIAMで付与できる。読み取り専用のSQL実行ツールを選択すれば、エージェントが誤ってデータを削除するリスクを根本から排除できる。
Model Armorによるプロンプトセキュリティ
リモートMCPサーバーは、Google CloudのModel Armorと統合されている。Model Armorはプロンプトとレスポンスの両方をスクリーニングし、プロンプトインジェクション攻撃や機密データの意図しない流出を防ぐ。エージェントのサービスアカウントが広範なデータベース権限を持っていても、Model Armorがデータの出し方をフィルタリングする仕組みだ。
たとえば、エージェントが顧客のクレジットカード番号を含むカラムにアクセスできる権限を持っていたとしても、Model Armorがレスポンスからその情報を除去できる。これは「権限はあるが出力は制限する」という新しいセキュリティモデルであり、ゼロトラストの考え方をAIエージェントに適用した形だ。
エージェントから見たAlloyDBの強み

リモートMCPサーバーは接続の仕組みを提供するが、その先にあるデータベース自体の性能も重要だ。AlloyDBはエージェントアプリケーションに特化したいくつかの特徴を持つ。
まず、ベクトル検索性能だ。ScaNNインデックスを使うと、標準PostgreSQLの最大6倍の速度でベクトルクエリを実行できる。100億ベクトルまでスケールするため、大規模なRAGアプリケーションでもパフォーマンスが劣化しない。フィルタ条件付きのベクトル検索では最大10倍高速化される。これは「直近30日以内のドキュメントから類似検索」のような実用的なクエリで差が出る。
次に、ハイブリッド検索とリランキングだ。RUM(RUMインデックス / Row Usage Matrix)を使った全文検索とベクトル検索の組み合わせや、Reciprocal Rank Fusionによる結果の融合が可能だ。さらにGemini Enterprise Platformモデルを使ったインテリジェントなリランキングにより、エージェントは最も関連性の高い情報を優先的に取得できる。
また、AlloyDBのAI Functionsはデータベース内部で埋め込みを生成する。外部の埋め込みAPIを呼び出す必要がなく、数百万件の埋め込みを効率的に生成できる。Lakehouse Federationを使えば、BigQueryの分析データやIcebergテーブルのアーカイブデータにも、同じPostgreSQLインターフェースから透過的にアクセスできる。
AIエージェントにとって重要なのは「データの鮮度」と「アクセスの容易さ」だ。AlloyDBのリアルタイム埋め込み生成とLakehouse Federationの組み合わせにより、エージェントは最新のオペレーショナルデータと過去の分析データを区別なく扱える。配送車両の位置情報のような刻々と変化するデータでも、クエリを発行した瞬間の状態を取得できる。
実際の導入手順とデモの流れ
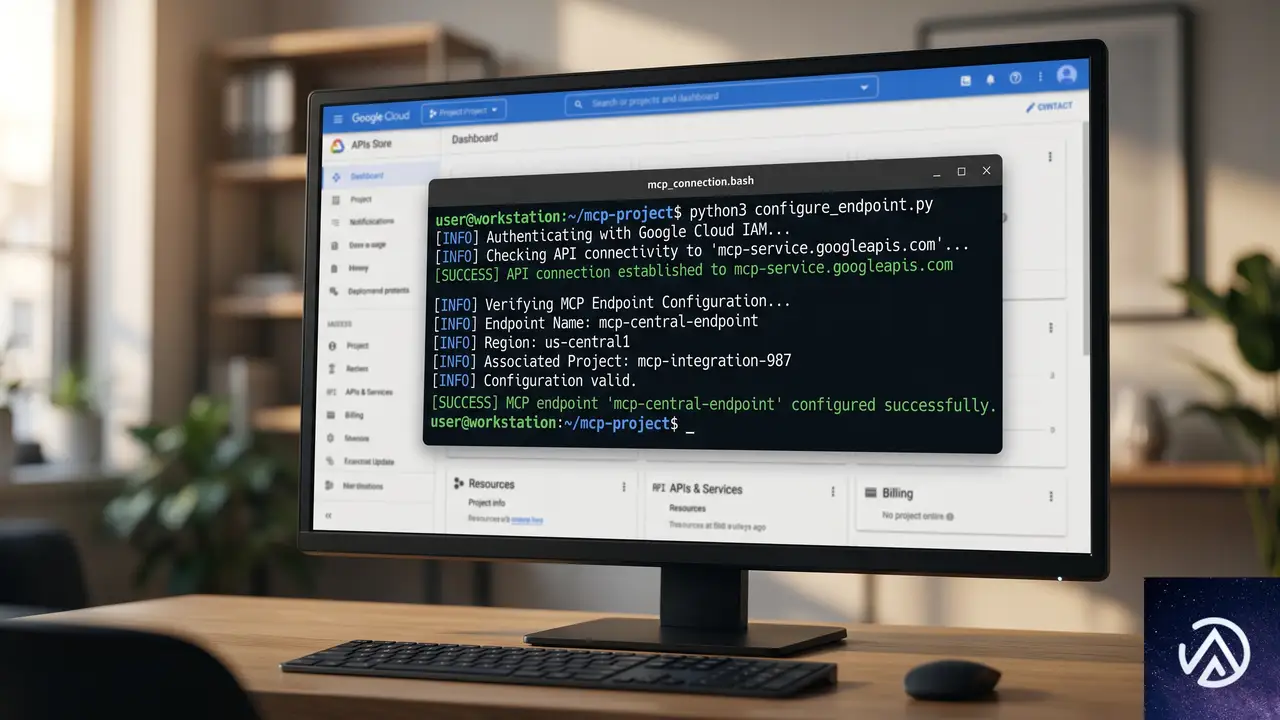
Google Cloudは今回のGA発表にあわせて、Codelab(ハンズオン形式のチュートリアル)を公開した。導入手順は以下の4ステップに整理されている。
接続が確立すると、エージェントは自動的にデータベースのスキーマを把握する。テーブル名やカラム名をイントロスペクションクエリで取得し、ユーザーの質問に応じて適切なJOINや集計クエリを組み立てられる。たとえば「過去24時間で最も遅延が発生している配送ルートは?」という質問に対して、エージェントが配送テーブルと車両テーブルをJOINし、リアルタイムの位置情報と組み合わせて回答する。
AIエージェントが実行できる操作の範囲
リモートMCPサーバー経由でエージェントが実行できる操作は、単なるSELECTクエリにとどまらない。AlloyDBのツールセットを使うと、以下のような運用操作も可能になる。
- データのエクスポートとインポート
- バックアップの作成とリストア
- クラスタの設定更新
- AI Functionsを使ったテキストのランキング(AI.RANK())
もちろん、これらの操作はIAM権限の範囲内でのみ実行される。読み取り専用のSQLツールを選択していれば、データ定義や変更を伴う操作はブロックされる。本番環境での安全な運用を第一に設計されている点が重要だ。
導入時に検討すべきポイント
リモートMCPサーバーのGAは、AIエージェントとデータベースの統合を大きく前進させる。しかし導入にあたっては、いくつかの点を事前に検討する必要がある。
まず、コスト構造の把握だ。AlloyDB自体がエンタープライズ向けのプレミアムデータベースであり、さらにMCPサーバーの利用にもGoogle Cloudの料金が発生する。30日間の無料トライアルが提供されているので、まずは小規模なクラスタで検証し、ワークロードに応じたコストを見積もることを推奨する。
次に、IAMポリシーの設計だ。エージェントに必要最小限の権限を付与する「最小権限の原則」を徹底する必要がある。テーブル単位、カラム単位でのアクセス制御が可能だが、データベースの規模が大きくなるとポリシー管理が複雑化する。事前にアクセス制御のルールを整理しておくことが重要だ。
最後に、プロンプト設計の重要性も変わらない。MCPサーバーがデータへのアクセスを提供しても、エージェントが適切なクエリを生成できるかどうかはプロンプトの質に依存する。スキーマの説明やクエリの方針をプロンプトに含めることで、より正確な結果を得られる。
この記事のポイント
- AlloyDB向けリモートMCPサーバーがGAとなり、HTTPエンドポイント経由でAIエージェントが安全にデータベースへアクセス可能になった
- IAMによるテーブル単位の権限制御と、Model Armorによるプロンプトセキュリティで本番運用に耐える設計
- AlloyDBのベクトル検索性能とAI Functionsの組み合わせにより、RAGアプリケーションの構築が効率化される
- 30日間の無料トライアルとCodelabが提供されており、小規模な検証から始められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験