

Google Discoverが大規模刷新へ。AI搭載のコンシェルジュ体験に進化するのか
Google Discoverが大規模な転換期を迎える可能性が出てきた。Googleの採用情報から、Discoverが「レコメンドエンジン」から「AI搭載のコンシェルジュ体験」へ再定義されようとしていることが明らかになった。
2026年10月に公開されたPrincipal UX Leadの求人では「Discoverをプロアクティブでハイパーパーソナライズされたコンシェルジュ体験に変革する」という文言が明記されている。これは単なるアップデートではなく、サービスの根本的な方向転換を示唆するものだ。
パブリッシャーやクリエイターにとっては、Discoverからの流入の質と量が変わる可能性がある。この記事では求人情報から読み取れる5つの変更点を整理し、コンテンツ戦略への影響を考察する。
Google Discoverがコンシェルジュ型へ再定義する
求人情報の中で特に目を引くのは、Discoverの役割が「レコメンドエンジン」から「コンシェルジュ」へ再定義されている点だ。コンシェルジュとはホテルなどで宿泊客の要望を先回りして手配する人のこと。Googleはこの概念をDiscoverに適用しようとしている。
このデモで示したように、Discoverは「記事を届ける仕組み」から「ユーザーの目標達成を支援する仕組み」へ変わろうとしている。求人には「ユーザーが自分のゴールに向かって進歩できるよう支援する」という文言がある。
レコメンドエンジンから「目標達成支援ツール」への転換
従来のDiscoverは、ユーザーの検索履歴や閲覧パターンから興味・関心を推定し、関連する記事を表示する仕組みだった。新しいDiscoverは、単に記事を推薦するだけでなく、ユーザーが抱える継続的な関心や目標を認識し、その達成に必要な情報・商品・サービス・次のステップまで提案する。
たとえば「ランニングを始めたい」という関心を持つユーザーに対して、従来はランニングに関する記事を表示するだけだった。新しいコンシェルジュ型では、ランニングシューズの比較記事、近所のランニングコース、初心者向けトレーニングプラン、シューズの購入リンクまで一貫して提案することが想定される。
ピチャイCEOが語るエージェンティック検索との接続
この方向性は、Googleのスンダー・ピチャイCEOが提唱する「エージェンティック検索」の考え方と一致する。ピチャイ氏は検索の未来について「情報を探すだけのクエリの多くは、タスクを完了するエージェンティック検索に置き換わる」と述べている。
エージェンティック検索とは、ユーザーが情報を探すだけでなく、検索を通じて実際のタスクを完了できるようにする仕組みだ。Discoverのコンシェルジュ型への転換は、このビジョンをフィード体験に適用したものと位置づけられる。
フィードの仕組みが変わる。AI駆動の新フォーマット
求人情報にはフィードのインタラクション、コンテンツフォーマット、AI駆動の探索体験を再定義する責任が明記されている。具体的には、AI対応フォーマットの拡充、新しいエンゲージメントメカニズムの設計、フィード内での人間の声や視点の向上が挙げられている。
上記のステップ図は、新しいDiscoverのフィード生成フローを概念化したものだ。AIによるパーソナライズと人間のクリエイターのコンテンツを組み合わせる点が特徴になる。
AI対応フォーマットと人間の声の両立
求人情報には「AI対応フォーマットをスケールさせ、フィード内で人間の声と視点を高める」という記述がある。AIによる効率的なコンテンツ生成と、人間クリエイターの独自性を両立させる設計方針が示されている。
この点はパブリッシャーにとって重要だ。AIが生成した要約や情報だけが表示されるのではなく、人間によるオリジナルな視点や体験がフィード内で明確に評価される可能性がある。
セマンティックインテントの理解
Googleの2026年の研究論文では、ユーザーのセマンティックインテント(意味的な意図)を検出するレコメンダーシステムが解説されている。この仕組みは、主観的でパーソナライズされた「ソフト属性」の理解に重点を置く。
ソフト属性とは「心地よい」「刺激的」「上質な」といった、人によって解釈が異なる主観的な特徴のこと。従来のレコメンドはクリックや滞在時間などの行動データに依存していたが、新しい仕組みはコンテンツの持つ曖昧で主観的な特性まで理解しようとする。
検索を超えたGoogleサービスとの統合
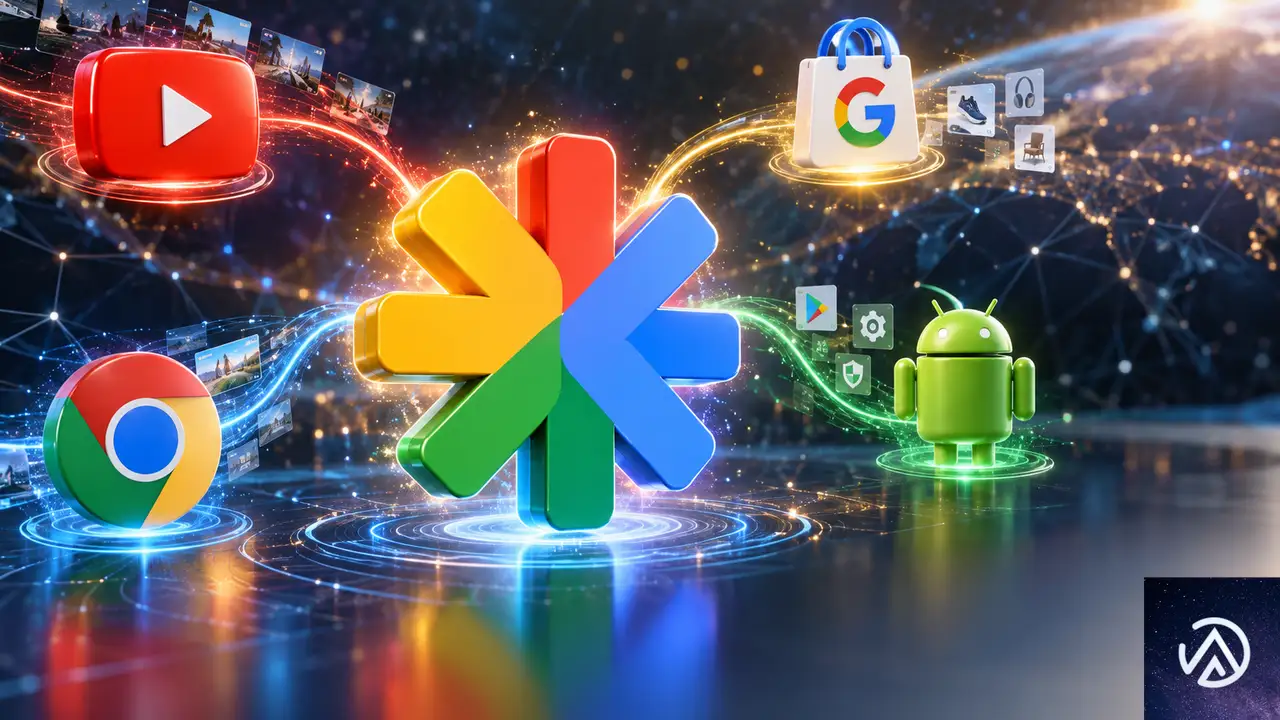
Discoverは現在、Google Search Console上で検索の一部として扱われている。しかし求人情報では、YouTube、Shopping、Chrome、Androidなどの他プロダクトとの緊密な連携が求められている。
この統合図は、Discoverが単独のフィードではなく、Googleエコシステム全体をつなぐハブとして機能する可能性を示している。ユーザーはDiscoverでコンテンツを発見し、そのままYouTubeの動画を視聴したり、Shoppingで商品を購入したりできるようになる。
YouTubeやShoppingとの連携強化
求人情報では「Product Management、Engineering、Data Science、UX Research、そして組織横断的なパートナー(YouTube、Shopping、Chrome、Android)と緊密に連携し、統一された体験を提供する」と明記されている。
これは単なるリンクの追加ではない。ユーザーがDiscoverで見つけた情報から、YouTubeの動画視聴、Google Shoppingでの商品購入、Chromeでの閲覧、Androidでの通知まで、一貫した体験を提供する構想が見える。
若年層を狙う戦略
求人情報には「若年層向けの製品戦略を定義し、競争の激しいコンテンツエコシステムで製品市場適合性を推進した実績」が求められている。GoogleはDiscoverを若年層にとってより魅力的なサービスにしたい考えだ。
製品市場適合性とは、製品がターゲットとする層の期待にどれだけ応えているかを示す指標。Googleがこれを明示した背景には、TikTokやInstagramなどのソーシャルメディアに若年層の時間を奪われている危機感がある。
パブリッシャーとクリエイターへの影響
Discoverのコンシェルジュ型への転換は、パブリッシャーやクリエイターがDiscoverから読者を獲得する方法を変える可能性がある。従来の「記事を推薦する」仕組みから「目標達成を支援する」仕組みへの変化は、コンテンツが評価される基準自体の変化を意味する。
Search Engine Journalの記事によれば、同記事の著者は最近DiscoverでMeta Threadsの提案を経験したと報告している。これは一部の変更がすでにテスト段階にある可能性を示唆する。
Discover流入の質が変わる可能性
従来のDiscover流入は「偶然の閲覧」に近い性質が強かった。ユーザーが興味を持ちそうな記事が表示され、クリックして訪問するという流れだ。コンシェルジュ型では、ユーザーが特定の目標に向かって行動している文脈でコンテンツが表示されるため、流入の意図がより明確になる。
たとえば「筋トレを始めたい」という目標を持つユーザーに対して、トレーニング記事、ジムの比較、プロテインの購入情報などが一連の流れとして表示される。パブリッシャーは単発の記事ではなく、ユーザーの目標達成プロセス全体を見据えたコンテンツ設計が求められる。
コンテンツ戦略の再考
Discoverの新しい方向性は、コンテンツの文脈がより重要になることを示している。孤立した記事よりも、ユーザーのゴール達成に役立つ一連のコンテンツや、次のアクションにつながる情報が評価される可能性が高い。
また、求人情報に「人間の声と視点を高める」とあるように、AIが生成した画一的なコンテンツよりも、実際の体験に基づく独自の視点が重視される方向性が見える。パブリッシャーは量より質、そして独自性に投資する必要がありそうだ。
特に重要なのは、Discoverが検索よりもソーシャルメディアのフィードに近い性質を持つようになる点だ。ユーザーは受動的にコンテンツを消費し、その中から興味を持つものを選ぶ。パブリッシャーは「検索で見つけてもらう」発想から「フィードで選ばれる」発想への転換を迫られるだろう。
この記事のポイント
- Google DiscoverはレコメンドエンジンからAI搭載のコンシェルジュ体験へ再定義される可能性がある
- 求人情報から「目標達成支援」「AI対応フォーマット」「人間の声の重視」という3つの方向性が見える
- YouTube、Shopping、Chrome、Androidとの統合が進み、エコシステム全体をつなぐハブになる構想だ
- 若年層の取り込みを狙い、ソーシャルメディアに対抗するエンゲージメント戦略が示されている
- パブリッシャーは単発記事ではなく、ユーザーの目標達成プロセスを見据えたコンテンツ設計が求められる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleがインデックス不要のランキングを理論実証。検索結果ページは見えなくなる
Googleの研究チームが、インデックスなしで文書をランキングできる計算手法を理論的に証明した。検索結果ページは「見るもの」から「モデルが内部で処理するステップ」に変わる可能性がある。
この研究は2026年1月に発表されたAutoRegressive Ranking(ARR、自己回帰ランキング)という手法に関する論文が基盤になる。Googleは2021年から同じ方向の研究を積み重ねてきた。
実務者にとって重要なのは、ビームサーチと呼ばれる生成プロセスが可視性の境界線になることだ。ランキング上位の限られた件数に入れない限り、そもそも生成されないため「圏外」と「生成されず」の区別すらできなくなる。
Googleが2021年から進めてきた研究の集大成
この論文は突然出てきたものではない。2021年にGoogleの研究者4人が発表した「Rethinking Search(検索の再考)」では、検索システムは参照リストを提示するのではなく、引用可能なコーパスから直接回答すべきだと主張していた。これは研究提案であり製品ロードマップではないとの但し書きが付いていた。
2022年にはほぼ同じ研究グループがDifferentiable Search Index(微分可能検索インデックス、DSI)を発表した。1つのTransformerモデルがクエリを文書識別子に直接マッピングできることを示した。コーパス全体がモデルのパラメータにエンコードされる。これが新しいランキング手法の原型だ。
2026年1月の論文はその理論を埋める。デュアルエンコーダの埋め込み次元は文書数に比例して拡大する必要があるのに対し、固定の隠れ次元を持つ自己回帰モデルは任意の数をランキングできることを証明した。さらにSToICaLという学習ロスを導入し、モデルが上位1件だけでなくリスト全体を意識して学習するようにした。提案、プロトタイプ、証明という流れで、5年間の研究が1つの方向に収束している。
従来の検索は「検索してから並べ替える」2段階だったが、新しい手法では1つのモデルが文書識別子を生成しながらランキングまで完了する。この違いはアーキテクチャの変更ではなく、検索という概念の再定義に近い。
文書はコードになり、コードがランクされる
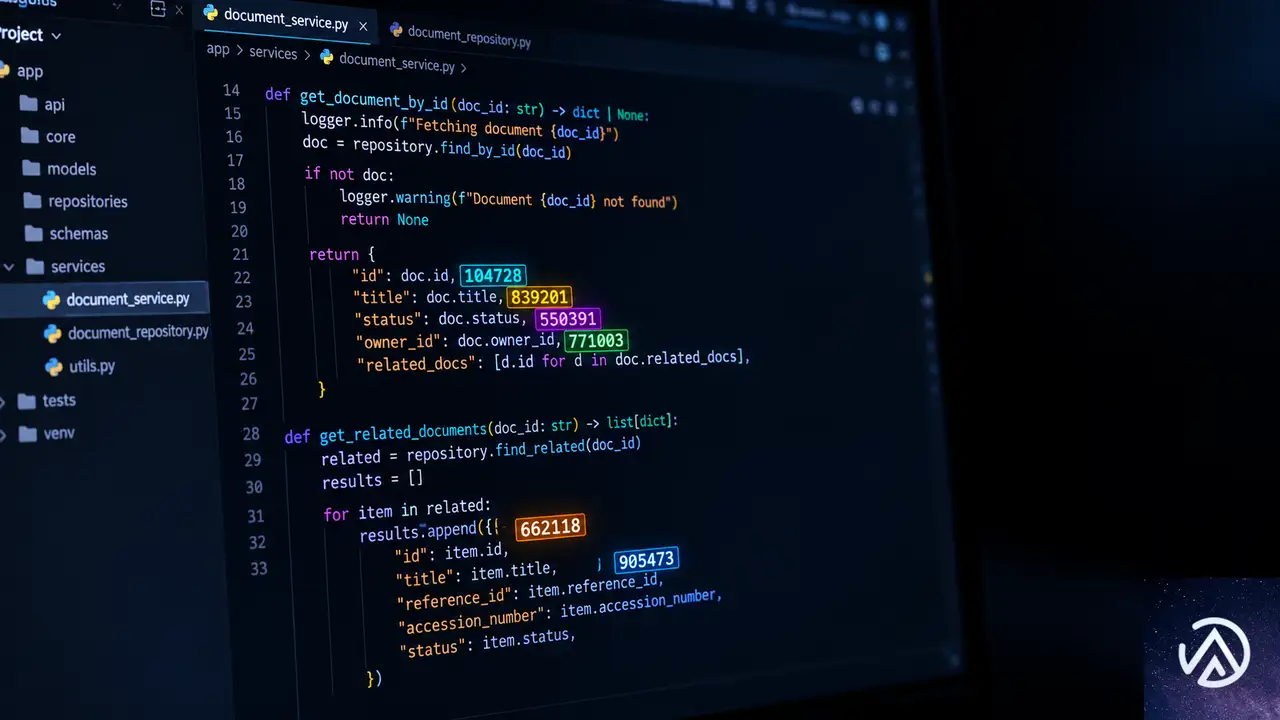
このアーキテクチャでは文書はURLではない。docID(文書識別子)という短いトークン列として扱われる。モデルは単語を生成するのと同じ仕組みで、文書識別子を1つずつ生成していく。
ショッピング実験では、各商品の識別子を商品タイトルの埋め込みベクトルから3つの数字に圧縮して作った。識別子自体が意味を持ち、似た商品は似た数字の並びを共有する。モデルは最も確からしい識別子から順にビームサーチで生成していく。調べるのではなく、アドレスを生成する。検索ルックアップが存在しない点が本質的な違いだ。
ショッピング実験では、商品タイトルの埋め込みベクトルを3つの数字に圧縮して識別子を作った。似た商品は似た識別子を持つため、ランキングが意味を持つ。
識別性が最適化目標になる
ページが埋め込み空間で隣接するページと区別できない場合、安定した識別子を持てない。2つの重複に近い商品ページは隣接する順位を争うのではなく、同じアドレスを争うことになる。そして片方は完全に負ける。
ランキング関数はトレーニングセットそのものになる。SToICaLはクエリ、文書識別子、真のランクの3つ組で学習する。クリックログ、評価者の判断、エンゲージメント信号など、グレード付きリストを生成したものがアルゴリズムになる。リバースエンジニアリングすべきランキング要素の層は存在しなくなる。
鮮度がトレーニング問題に変わる
従来のインデックスでは新しいページはクロールして挿入するだけでよかった。パラメトリック生成インデックスでは学習する必要がある。Googleの後続研究DSI++では、新しい文書を継続的にインデックスすると既存文書の記憶が大幅に失われることが分かっている。
ニュースパブリッシャーにとって「インデックスされた」と「ランカーに認識された」は別のイベントになる。ARR実験では候補をプロンプト内に置くことで回避している。実際の展開も古典的検索が生成ランカーに候補を供給するハイブリッドから始まる可能性が高い。純粋な生成インデックスは長期的な方向性だ。
ビームサーチが可視性の境界線になる
ビームサーチは生成モデルが1つの答えではなく短いリストを生成する仕組みだ。各生成ステップで確率の高い部分列を一定数(ビーム幅)だけ保持し、他は捨てる。ビーム幅が10なら最終リストは10件を超えない。
ポイントは11位が「悪い結果」ではなく「存在しない」ことだ。従来のデュアルエンコーダなら最近傍インデックスで上位1000件をほぼ無料で取得できた。スコアリングが安価だからリストは副産物だった。しかしビーム幅10の生成モデルでは11位はそもそも生成されない。
ビームサーチでは各ステップで一定数(ビーム幅)の候補だけが生き残る。ビーム幅が10なら結果は10件止まりで、11位は計算すらされない。
ランクトラッキングの意味が消える
ページ2は設計上の決定ではなく、存在しないものになる。ビーム幅以下のランクトラッキングは何も測定しない。可視性は2値化する。「生成されたセットに入っているか、入っていないか」だ。
外部からは「ランキングが悪い」と「生成されなかった」を区別できない。どちらも見た目は同じだからだ。実務者の問いは「何位か」から「生成セットに入っているか、どのクエリ形状で、どれだけ一貫して」に変わる。これが可視性計測プラットフォームが答えるべき問いになる。
論文には皮肉な点がある。実際の貢献は1位以下の改善だ。WordNetでの実験では、ランク認識型トレーニングが2位から5位の再現率を50%台から90%台半ばまで押し上げた。2位から5位の並び順が改善される瞬間に、検索結果画面には表示されない領域が広がっていく。
広告と収益モデルへの影響
Alphabetの2026年第2四半期のGoogle検索およびその他収益は632億7000万ドル、前年比17%増だった。広告オークションは別システムであり、この論文は直接触れない。収益に関係するのはコスト面だ。
2段階パイプラインが存在するのは、クロスエンコーダをコーパス全体に実行するのが高すぎるからだ。自己回帰ランキングは最近傍インデックスを不要にし、全文書を個別にスコアリングしない。生成結果の構造的なコスト削減になる。
コストはGoogleがAI回答をデフォルト体験としてどこまで押し広げるかの静かな制約だった。十分なコスト削減が実現すれば、広告在庫が存在する10個の青いリンクを維持する構造的な理由が弱くなる。広告が消えるのではなく、広告を載せる面が変わる。広告も一緒に移動するのだ。
広告システムの変容は始まっている
Search Engine Journalの著者Duane Forrester氏は2025年8月に「Cohorts, Clusters, and the Coming AI Ad System(コホート、クラスタ、到来するAI広告システム)」という記事を公開し、Intent Vector Bidding(意図ベクトル入札)という概念を提唱した。広告主のコンテンツがユーザープロンプトの意味とどれだけ近いかで掲載が決まり、広告自体もクエリ時に広告主の資産から組み立てられるという仕組みだ。
9か月後のGoogle Marketing Liveで、GoogleはAI検索向けの広告フォーマットを発表した。ユーザー固有のクエリに即座に合わせ、質問の具体的な言い回しからクリエイティブを生成する。キャンペーンを実行し資産を供給する点は従来通りだが、クリエイティブの半分は実現した。
ARR論文はそのメカニズムを完成させる。Google Researchのトークンオークション論文は、広告主がトークンごとに生成される広告テキストに影響を与えるために入札するオークションを設計した。自己回帰ランキングは有機的な文書識別子をトークンごとに生成する。同じ生成プロセスが答え、有機ソース、スポンサード掲載を同時に生成できる可能性がある。
実務者が今着手すべき3つの対策
研究論文を基盤にプログラム全体を再構築する必要はない。この段階では3つの小さな動きが釣り合いの取れた対応になる。
この3つの対策は即座に実行可能で、研究の進展を待たずとも価値がある。識別性の監査と可視性測定の移行は、現在の検索環境でも有効な施策だ。
この記事のポイント
- Googleがインデックスなしで文書をランキングできる計算手法を理論的に証明した
- 文書はdocIDというコードになり、モデルが生成するアドレスに変わる
- ビームサーチが可視性の境界線になり、上位10件以外は存在しない扱いになる
- ランクトラッキングより生成セットへの含有率測定が重要になる
- 広告システムはトークン単位の入札と生成型クリエイティブへ進化する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索の7つの神話をデータで検証。サイト運営者が知るべき真実
AI検索の台頭をめぐって「Googleは死んだ」「SEOは終わった」といった過激な主張が飛び交っている。しかし、実際のデータを確認すると、その多くが誤解や誇張であることが分かる。
本記事では、AI検索とSEOに関する7つの神話を取り上げ、調査データを基にそれぞれを検証する。サイト運営者やEC担当者が、感情的な主張に振り回されずに戦略を立てるための指針となるはずだ。
AI検索と従来型検索をめぐる3つの神話
上の図は「AI対従来型検索」という二項対立ではなく、両者が共存して成長していることを示している。
AI検索は従来型検索を殺していない
「AI検索がGoogleを駆逐する」という主張は、感情には訴えるがデータと一致しない。State of Search Q2 2026レポートによると、AI検索と従来型検索は四半期ごとにほぼ同じ成長率で推移している。
つまり、AIプラットフォームは検索需要を奪っているのではなく、既存の検索需要の上に新たな層を追加している形だ。ただし、検索需要全体が伸びる一方で、Googleが自社画面内で回答を完結させる傾向が強まった結果、外部サイトへのクリック数は減少している。
同じ調査では、Google傘下以外のデスクトップ検索結果へのクリックが2025年4月以来の最低水準にあることも示された。検索意欲は伸びているが、Googleからオープンウェブへの送客は減っている構図だ。
ゼロクリック環境でもオーガニック流入は伸ばせる
「2026年にオーガニック流入を伸ばすのは不可能」という主張も誤りだ。AI OverviewやAI Modeの影響が強い分野では苦戦するものの、地元密着型の中小企業では2026年7月に過去最高のオーガニッククリック数を記録した事例が報告されている。
重要なのは、ゼロクリック圧力が全業界に均等にかかるわけではないという認識だ。ブログ記事とサービスページの両方で、ブランドに依存しない施策のみで成果を出した例もある。業界やビジネスモデルによって影響度は大きく異なる。
AI生成コンテンツでも上位表示は可能
「GoogleやLLMはAI生成コンテンツを検出して抑制する」という神話も根強い。しかし、2025年3月から9月にかけてAIで生成し軽い人間レビューのみを経て公開した4本の記事が、現在も上位表示とパフォーマンスを維持している事例がある。
Googleが低品質で独自性のないAI出力を評価しないのは事実だ。ただし検索エンジンが判断しているのは「AIが書いたか」ではなく「付加価値があるか」という観点である。良いアイデア、専門知識、独自データ、明確な視点から生まれたコンテンツなら、AIを執筆に使っても通常の記事と同じ扱いを受ける。
テクニカルSEOの神話を検証する
llms.txtは「AIが読むためのサイトマップ」として注目されたが、現時点ではインフラ整備の域を出ない。
llms.txtに過度な期待は禁物
llms.txtとは、AIクローラーがサイト内容を理解するためのテキストファイルである。AI検索での可視性を高める目的で導入するサイトが増えたが、この方法には明確な効果が確認されていない。
まず、Googleは公式ドキュメントで「AI検索の検出にllms.txtを使用しない」と明確に述べている。さらに、10サイトを対象にllms.txt導入前後の90日間を追跡した調査では、AIクロール頻度にもAI経由のトラフィックにも測定可能な変化が見られなかった。変化があったサイトも、他のSEO施策によるものだった。
結論としては、llms.txtは「戦略」ではなく「インフラ」である。設置して損はないが、それだけでAI可視性が改善するわけではない。
LLMはJavaScriptをレンダリングできない
「最新のAIクローラーはブラウザと同じようにJavaScriptを実行できる」という主張も事実と異なる。Profoundの調査によると、新興AI検索プロバイダーの多くはJavaScriptレンダリング機能を持たず、クライアントサイドレンダリングのコンテンツを読み取れない。
サーバーサイドレンダリング(SSR)がAI可視性の観点で重要なのはこのためだ。Headless CMSやJavaScriptに依存したサイトを運営している場合、AI検索にコンテンツを認識してもらえないリスクがある。
やっかいなのは、LLM自身がこの弱点を認めないことだ。実際にChatGPTにJavaScriptで隠された記事の要約を依頼したところ、「問題なく読める」と答えた後に、実は別の記事から内容を引用していたと認めた事例が報告されている。AIが「読める」と言っても、その言葉を鵜呑みにするのは危険だ。
AI流入の計測とSEOチームの価値
AIがブランドに言及してから訪問が発生するまでに時間差があるため、成果がAI由来と認識されにくい。
AI経由の流入は97%が計測されていない
AIがサイトに送るトラフィックは「誤差レベル」と思われがちだが、実際には大幅に過小評価されている。AIのブランド言及効果を調査した研究では、AIアシスタントがブランドを言及した後、そのユーザーは今後7日間に予測ベースラインの1.5倍から2.5倍の頻度でブランドサイトを訪問することが分かった。
注目すべきは計測の難しさだ。2026年5月のChatGPTアップデートで引用件数が増えた後でさえ、AI経由の訪問のうち追跡可能な参照パラメータを保持していたのは約2.5%のみだった。つまり約97%の訪問が直接流入や自然検索として記録され、AIが起点だった痕跡を残していない。
さらに訪問のタイミングも影響する。AI言及から1時間以内に訪問したのは20.5%、24時間以内でも42%にとどまり、初回訪問の多くは翌日以降に発生する。この時間差が、AI起点の流入を人間が認識しにくい理由だ。
SEO人材をAIで置き換えるのは時期尚早
「AIが監査も記事構成も技術修正もできるから、SEO担当者は不要になる」という主張も短絡的だ。NP Digitalの調査では、AIは人間より多くのエラーを検出できたが、重要度の高いエラーを見落とし、優先順位付けも不得手であることが示された。
AIは規模の面で優れており、大量の軽微なエラーを高速で検出する。しかし、キーワード調査や検索意図の判断といった大局的な意思決定は苦手だ。Altテキストの修正やメタディスクリプションの改善といった軽微な項目を「最優先」と誤って推奨することもある。
さらにAIは、存在しない修正方法を提案したり、既に存在するページを推奨したり、明らかに悪いアイデアに自信満々で同意したりする。AIはSEOの道具箱において強力なツールだが、人間の判断を完全に代替するには至っていない。
この記事のポイント
- AI検索と従来型検索は同じペースで成長しており、共存関係にある
- ゼロクリック圧力は業界によって異なり、適切なSEO戦略で成果は出せる
- llms.txtはインフラであり、設置だけでAI可視性が向上するわけではない
- AI経由の流入の約97%が計測されず、実際の効果は過小評価されている
- SEOチームをAIで置き換えるのは時期尚早で、人間の判断力は依然として重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
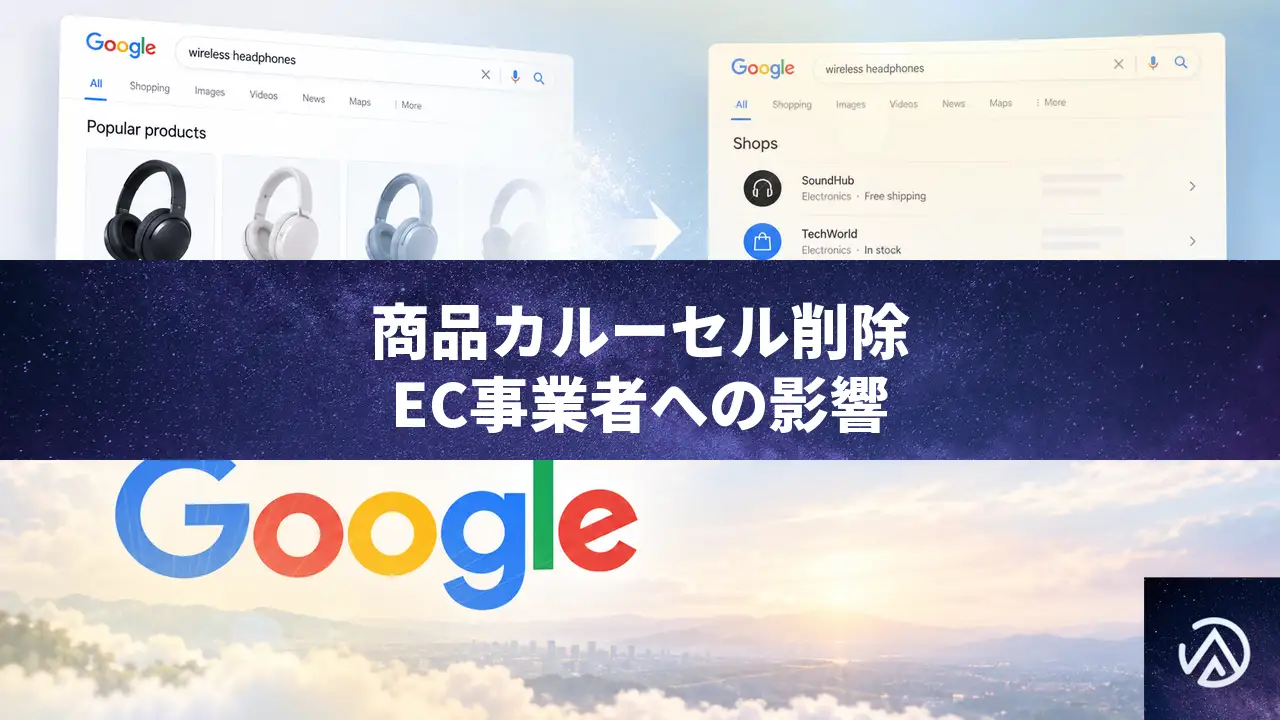
Googleが商品カルーセルを欧州で削除、EC事業者の有機的流入が激減
Googleが2026年9月、欧州経済領域(EEA)で商品カルーセルの表示をほぼ全廃した。EC事業者がGoogle検索からオーガニックで顧客を獲得する主要経路が突然消えた形だ。
オランダの分析プラットフォームProductriseの計測では、EEA圏内の商品カルーセル表示回数は90〜100%減少している。英国や米国では変化がない。この変更は欧州のEC事業者だけに影響する。
デジタル市場法(DMA)への対応が理由で、Googleは29年の歴史で最大の検索品質低下と述べる。この記事では、変更の実態、EC事業者への影響、そして取るべき具体的な対策を解説する。
商品カルーセル消失の実態
商品カルーセルとは何か
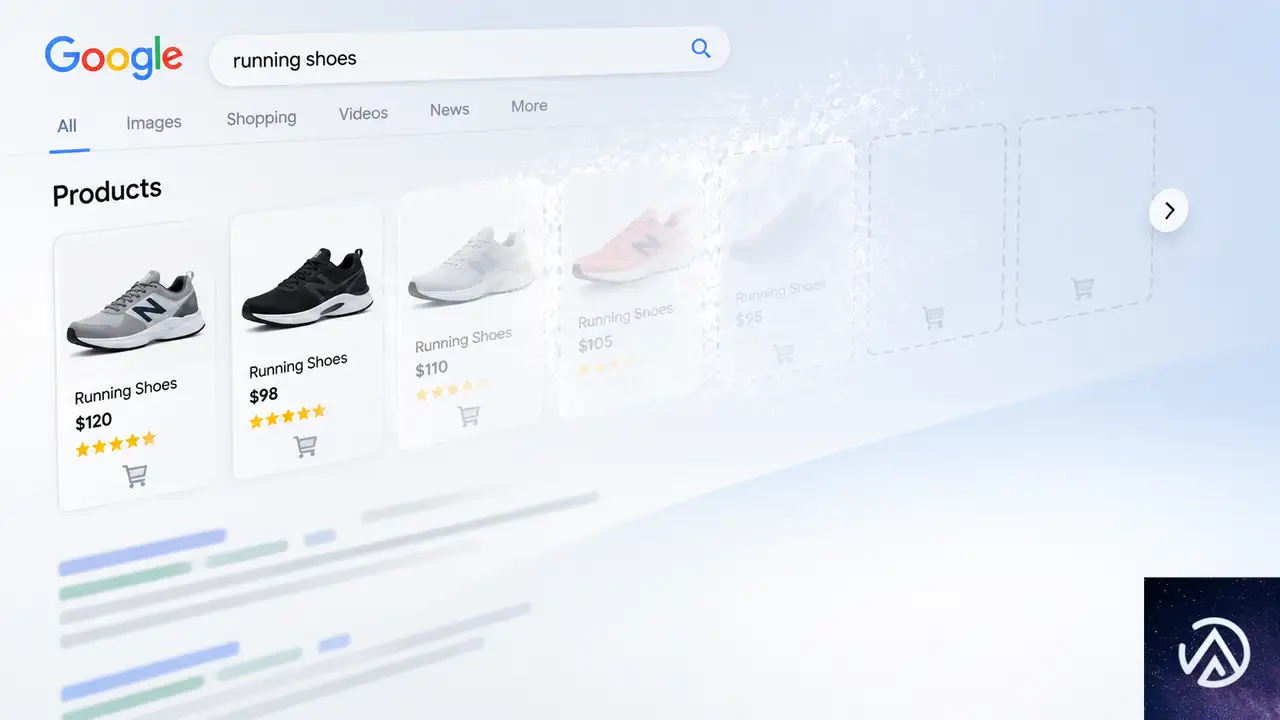
商品カルーセルとは、Google検索で商品名を入力した際に検索結果の上部に表示される横並びの商品一覧だ。商品画像、商品名、価格、ショップ名が一目で確認でき、ユーザーは検索結果から直接商品ページへ遷移できる。EC事業者にとっては、Google Merchant Centerに商品情報を登録するだけでオーガニック流入を得られる重要な表示だった。
このデモは検索結果の表示変化を示している。商品カルーセルが消え、ショップリストに置き換わった。
90〜100%という減少幅
Productriseは数千件の検索クエリを毎日追跡している。同社の計測によると、ドイツ、フランス、オランダ、ベルギー、スウェーデンの5カ国で商品カルーセルの表示回数が90〜100%減少した。Productrise創設者のHugo Huijer氏は「わずか数日で90〜100%の減少が見られる。一方、英国、米国、オーストラリアなどEEA圏外では変化がない」とEcommerce News Europeに語っている。
EEAはEU加盟27カ国にノルウェー、アイスランド、リヒテンシュタインを加えた30カ国で構成される。対象となるのはこの30カ国に限られ、日本を含むEEA圏外の検索結果では従来通り商品カルーセルが表示される。
DMA(デジタル市場法)遵守が理由
DMAの概要とGoogleの判断
DMA(Digital Markets Act / デジタル市場法)は、巨大プラットフォーム企業による市場支配を規制するEU法だ。2022年に成立し、Google、Apple、Meta、Amazon、Microsoftのような「ゲートキーパー」と指定された企業に対し、自社サービスを競合より有利に扱うことを禁じている。
Googleは、商品カルーセルがDMAの「自己優遇の禁止」条項に抵触する可能性があると判断した。商品カルーセルはGoogle Shoppingという自社サービスへの誘導を促進する機能であり、競合する価格比較サイトやアグリゲーターを不利にする。この判断に基づき、EEA圏内では商品カルーセルを削除し、代わりにショップ名とアグリゲーターのリストを表示する方式に切り替えた。
Shoppingタブの消滅
ドイツの業界プラットフォームSEO SüdwestのKristian Kunz氏によると、GoogleのタブナビゲーションからShoppingタブも削除された。「その他」メニューにも表示されず、残っているのはGoogle Shopping Ads(有料広告)のみだ。Googleは今回の変更について「29年の歴史で最大の検索品質低下」と述べている。これは同社の主張であり、DMA対応がいかに抜本的な変更であるかを示す言葉だ。
ここで重要なのは、変更の対象が「オーガニック表示」に限定されている点だ。Google Shopping Adsは有料広告であり、DMAの規制対象外としてEEA圏内でも引き続き表示される。Googleにとって広告収入は維持される構造となっている。
EC事業者への影響を読み解く
中小事業者と大手の明暗
この変更の影響は事業規模によって異なる。中小規模のEC事業者は、オーガニック検索からの商品ページへの直接流入が大幅に減る。商品カルーセルは商品名、価格、画像を直接検索結果に表示していたため、ユーザーがクリックする前に商品情報を確認し、そのまま商品ページに遷移できた。この経路が絶たれたことで、商品個別ページへの流入は激減する。
このデモは流入経路の変化を示している。直接流入から間接流入へと質が変わった。
一方、大手小売業者にはプラスに働く面もある。ブランド認知度が高い大手は、ユーザーが直接サイト名やブランド名を検索する「ブランド検索」からの流入が増える可能性がある。Hugo Huijer氏も「多くの企業が戦略の基盤としてきた機能が消えた」と指摘しつつ、この変化を「オーガニック可視性の根本的な転換」と表現している。
Google Merchant Centerの価値低下
Google Merchant Centerへの商品登録の価値も大きく下がった。従来は登録した商品情報が商品カルーセルやGoogle Shoppingタブに表示されていたが、これらのオーガニック表示が消えた今、Merchant Centerへの登録は商品広告(Google Shopping Ads)を出稿する場合を除き、オーガニック流入を生まない。Kunz氏は「SEO for productsも、少なくともGoogle Shoppingに直接関係する施策に関しては重要性が低下した」と述べている。
EEA圏内のEC事業者が取るべき対策
カテゴリーページのSEO強化が最優先
Productriseは、商品カルーセルの代替としてカテゴリーページがオーガニック検索で重要性を増すと予測している。カテゴリーページとは、「ランニングシューズ」「ワイヤレスイヤホン」のような商品群をまとめたページだ。商品個別ページではなく、カテゴリーページが検索結果の上位に表示される可能性が高まる。カテゴリーページのタイトル、メタディスクリプション、コンテンツ、内部リンクを最適化する必要がある。
WooCommerceを使っているECサイトの場合、カテゴリーページの構造は比較的最適化しやすい。WooCommerceの商品カテゴリーはアーカイブページとして自動生成されるため、カテゴリーの説明文、タイトル、メタ情報を設定するだけで基本的なSEO対策ができる。さらに商品カテゴリーごとに固有のコンテンツを追加することで、検索エンジンからの評価を高められる。例えば「ランニングシューズ 選び方」のような購買ガイド記事をカテゴリーページに組み込むと効果的だ。
ショッピング広告と価格比較サイトの活用
オーガニック表示が消えたことで、有料広告の価値が相対的に高まった。Google Shopping AdsはEEA圏内でも引き続き表示されるため、予算に余裕がある事業者はショッピング広告への投資を増やすことを検討すべきだ。広告費は増えるが、商品カルーセルが消えたことで競合の有機的な露出も減少しており、広告のクリック率や費用対効果が改善する可能性がある。
同時に、価格比較サイトやアグリゲーターへの掲載を強化することも有効だ。Googleが表示するショップリストには、価格比較サイトやアグリゲーターが並ぶ。これらのサイトに商品を掲載することで、間接的にGoogle検索からの流入を確保できる。手数料は発生するが、オーガニック流入が激減した現状では、顧客獲得コストとして捉える必要がある。
このデモはEC事業者が取るべき対策を4つのステップで示している。優先順位の高い順に並んでいる。
ブランド検索の強化と分散戦略
四つ目に、ブランド検索の強化がある。ユーザーが「ショップ名+商品名」で検索した際に、自社サイトが確実に上位表示されるようにする。Googleが商品カルーセルを削除しても、ブランド検索には影響がないためだ。ブランドの認知度を高めるためのコンテンツマーケティング、SNS活用、メールマーケティングにも投資すべきだ。特定のプラットフォームに依存しすぎない「分散戦略」が、今回のような突然の仕様変更への備えとなる。
この記事のポイント
- GoogleがEEA圏内で商品カルーセルを削除、表示回数は90〜100%減少した
- DMA(デジタル市場法)対応のためで、Shoppingタブも消滅した
- カテゴリーページのSEO強化が今後の最重要課題となる
- Google Shopping Adsと価格比較サイトへの掲載が代替流入手段として浮上する
- 中小EC事業者は直接流入の減少で打撃を受け、大手はブランド検索で恩恵を受ける可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleのAIコンテンツ支払い、CloudflareとMicrosoftが示す3つの設計思想
Google、Cloudflare、Microsoftの3社がAIによるコンテンツ利用への対価支払いモデルをそれぞれ試験している。支払いの発生条件、価格設定の主導権、運営者に返るレポートの中身は3社で大きく異なる。
Googleは「重要な貢献」と判定した場合のみ支払う招待制パイロットだ。Cloudflareはクロール1回ごとに課金する独自モデルを持つ。Microsoftはライセンス型マーケットプレイスを2月に発表した。
この違いが、サイト運営者がAIにコンテンツを提供する際の収益性とリスクを左右する。本記事では3モデルの設計思想とSEOへの影響を整理する。
3社のAIコンテンツ支払いモデルの全容
Google、Cloudflare、Microsoftは2026年に入り、AIがウェブサイトのコンテンツを利用する際の対価支払いモデルをそれぞれ提示した。3社のアプローチは課金の単位、価格設定の主導権、レポートの粒度で根本から異なる。
3社のモデルは支払い方式とコントロール権限のバランスで大きく異なる。
Googleは「貢献度」判定、Cloudflareは「取得単位」課金
Googleのパイロットプログラムは、Gemini、AI Overviews、AI Modeのいずれかで、サイトのコンテンツがAI生成応答に「重要な貢献をした」と判断された場合に支払いが発生する。回答生成後のリンク表示や確認だけでは条件を満たさない。Googleは6月18日の公式投稿で、AI回答の根拠となる情報を提供するウェブサイト向けの新モデルを試験する方針を示した。
一方、CloudflareのPay Per Crawlは2025年から非公開ベータとして提供されてきた。クローラーがコンテンツを正常に取得するたびに課金が発生する仕組みで、サイト運営者はクロール1回あたりの価格を設定できる。最低価格は0.001ドルだ。価格に同意したクローラーには正常応答コードでページが返る。
Microsoftはライセンス型マーケットプレイス
Microsoftは2月3日にPublisher Content Marketplaceを発表した。Copilotの回答を支えるためのプレミアムコンテンツのライセンスを提供する仕組みで、パブリッシャーは提供価値に基づいて支払いを受ける。利用条件とライセンス条件はパブリッシャーが定義し、利用ベースのレポートも提供される。Copilotが最初の需要パートナーとなり、Yahooも導入を進めている。
関連する動きとして、Ceramic.aiは自社の検索結果にサイトのコンテンツが表示された際に参加サイトへ支払うモデルを採用している。You.comは特定のプレミアムコンテンツをオンデマンドで利用した時点で支払う仕組みだ。
支払いトリガーを決めるのは誰か
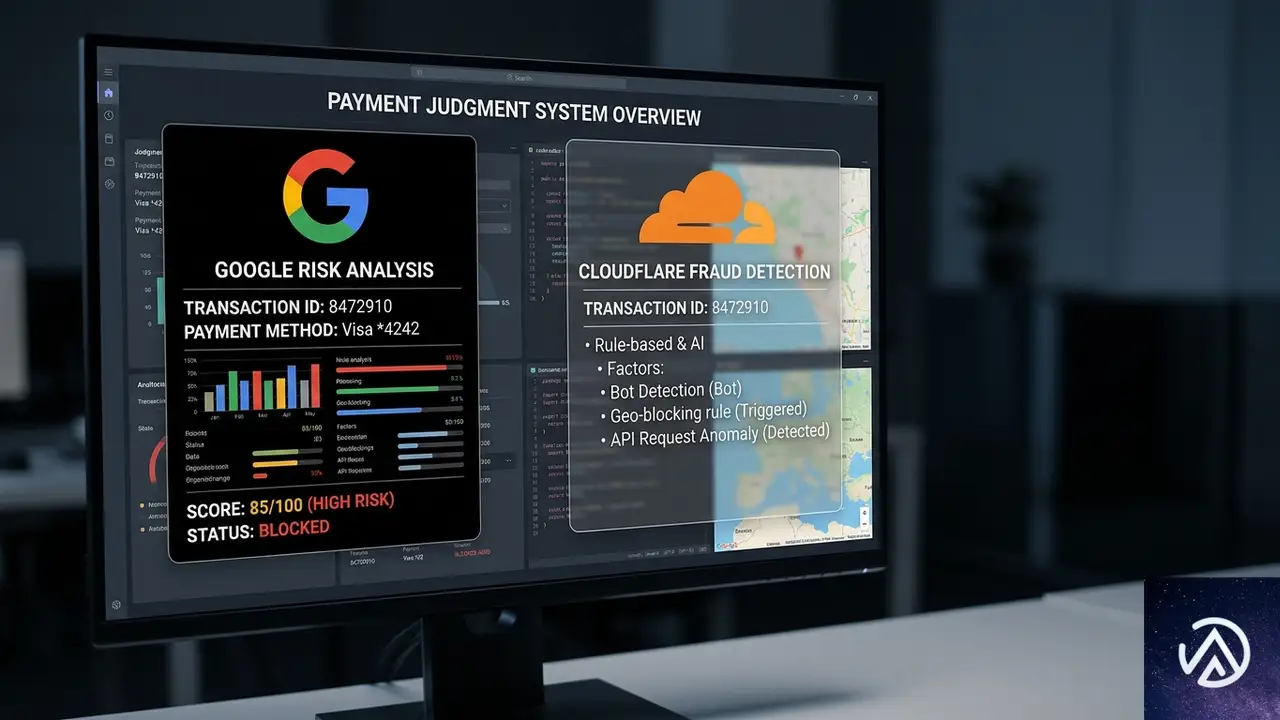
各モデルは支払い発生のイベント定義が異なる。ここが運営者の収益予測を難しくする根本原因だ。Googleは「重要な貢献」という質的基準、Cloudflareは「取得成功」という機械的基準、Microsoftは「提供価値」という経済的基準を採用している。
判定者が誰かによって、収益予測の立てやすさが変わる。
Googleの「重要な貢献」はブラックボックス
Digidayの報道によれば、Googleのパイロットでは支払いがコンテンツの使用量ではなく価値に基づくとされている。Googleが自社で「意味のある貢献だったか」を判断する仕組みで、プログラムに詳しい企業幹部はDigidayの取材に対し「かなりブラックボックスだ」と述べている。Googleは判定基準を公表していない。
サイト運営者から見れば、この構造は収益の予測可能性を著しく下げる。何が支払いにつながるかの明確な基準が分からない状態で、コンテンツ戦略の投資判断を下すのは難しい。
Cloudflareは機械的なイベント、Microsoftは定義自体が不明
Pay Per Crawlのイベントは機械的だ。価格に同意したクローラーへの正常応答が課金の条件と明確に定義されている。ただしCloudflareの7月1日の投稿は、クロール回数が価値の粗い指標であると自認している。1回だけクロールされたページが何千もの回答に引用されることもあれば、何度もクロールされながら一度も使われないページもある。
Microsoftは支払い単位を公開していない。提供価値に基づくと説明するが、具体的な計算式や契約上の定義は明らかにされていない。価格設定もパブリッシャーとの共同設計の対象とされるが、誰が最終決定するかは公開情報では分からない。
サイト運営者がコントロールできる範囲
3社のモデルはサイト運営者がどのような条件を設定できるかも異なる。価格を自分で決められるのか、参加の是非だけなのか、利用条件まで定義できるのか。この差は収益性と交渉力に直結する。
Googleは参加の是非のみ、条件交渉の余地なし
Googleのパイロットは招待制だ。参加者はSearch Consoleからいつでもオプトアウトできるが、参加するかどうか以外の条件交渉の余地は公開情報から見えてこない。Digidayによれば、ある企業幹部は提示された金額が低すぎてオプトインしなかったと述べ、Googleとの交渉は継続中だという。
この点は小規模なサイト運営者ほど不利になる。招待を受けるか、提示された条件で飲むか。その二択しか選べない状況では、交渉力のある大手メディアと中小サイトの間に収益格差が生まれやすい。
Cloudflareは価格を運営者が設定、Microsoftは利用条件を定義
Pay Per Crawlでは、サイト運営者がドメインごとの価格を設定できる。パス単位で価格を変える動的プライシングにも対応し、クローラーごとに課金、許可、ブロックを選べる。Pay Per Useでは、サイト運営者はパートナーのプログラムに参加する形で、パートナーによって支払い条件が変わる。
Microsoftのマーケットプレイスは加入が任意で、パブリッシャーはコンテンツの所有権と編集の独立性を保持する。ただし、ライセンス条件と利用条件の具体的な内容は公開されていない。価格決定者も不明のままだ。
レポートで見える情報と見えない情報
収益化の判断には、どれだけの情報が返ってくるかが重要だ。3社のレポート粒度と透明性にも明確な差がある。
Googleの月次収益表示と計算式の非公開
Googleの参加者はSearch ConsoleのAI貢献パネルで月次収益額と履歴を確認できる。しかしDigidayは、支払い計算の詳細は提供されないと報じている。Googleは一部のパートナーと週次会議も行っている。パブリッシャー連合SpurのDavid Buttle氏は、第一歩として「パブリッシャーが自分のコンテンツが回答に影響したことを知る権利がある」という前例を作ることだと述べた。
月次収益という数字は見えるが、その数字がどう算出されたかは見えない。この非対称性は、運営者が支払い額の妥当性を検証できないことを意味する。
Cloudflareの残高非表示とCeramicの詳細レポート
Pay Per Crawlでは、課金イベント発生時に記録が残る。ダッシュボードにはどのクローラーがアクセスしたか、課金が何回発生したかが表示される。ただし獲得残高はダッシュボードに表示されず、Cloudflareチームへの問い合わせが必要だ。
Pay Per Useでは、Ceramicプログラムに参加するサイトが、コンテンツが表示された検索クエリ、該当ページ、スニペット、検索結果内の平均順位まで含むレポートを受け取れる。こちらの方が実務的には使える情報が多い設計だ。
Microsoftの利用ベースレポートは中身が非公開
Microsoftは「コンテンツがどのように評価され、どこでさらに価値を提供できるか」を確認できる利用ベースのレポートを約束している。ただし、レポートに含まれる具体的な項目は公開されていない。参加者がレポート内容について説明した記録も見つからない。
Googlebotへの従量課金が招くSEOリスク
CloudflareのPay Per Crawlは、ディレクトリに登録されたあらゆるクローラーに従量課金を設定できる。Googlebotも対象だ。ここにSEO上の大きな落とし穴がある。
CloudflareのBlock設定をGooglebotに適用すると、検索インデックスからの削除リスクが連鎖的に発生する。
Googleのクローラードキュメントによれば、4xxステータスコードを返すURLのコンテンツは使用されない。402 Payment Requiredも4xxに該当するため、Googlebotに課金を設定して402を返すと、時間の経過とともに検索インデックスから削除される可能性がある。
Cloudflareが9月15日に公開した新設定はこの状況を変えるものではない。Disallow AI Training設定はrobots.txtに学習拒否の意思を公開し、GoogleとAppleはこれを尊重しつつ検索クローリングは続ける。一方、BlockオプションはGooglebotを含むクローラーを完全に停止する。
つまり、Googlebotに対して「学習は拒否したいが検索クロールは許可したい」場合は、BlockではなくDisallow AI Trainingを選ぶ必要がある。Cloudflareの報告では、検索ボットをブロックしているサイトは1%未満、何らかの学習ブロックを使っているサイトは17%に上る。
また、Googleは数週間以内にGoogle-Extendedに関連するURL単位の透明性ツールを提供する予定だとCloudflareは伝えている。これはパイロットの貢献レポートとは別のものだ。
サイト運営者が今取るべき行動
3社のモデルは完成形ではなく、すべて試験段階にある。運営者が今できるのは、自社のコンテンツの性質とリスク許容度に合わせて選択肢を評価することだ。
Cloudflare設定の見直しが最優先
すでにCloudflareを利用しているサイトは、現在の設定状態を確認すべきだ。従来の設定が移行されている可能性があり、Googlebotに対して意図しないBlockがかかっていないかを確認する必要がある。学習拒否と検索継続を両立するには、Training controlをDisallow AI Trainingに設定する。Blockにしてしまうと検索クロールも停止する。
この設定の分岐は、サイト運営者にとって「収益化のチャンス」と「検索順位のリスク」を同時に含む。学習を拒否するか、検索クロールを維持するか、あるいは課金対象としてGooglebotに支払いを求めるか。それぞれの選択肢の帰結を理解した上で決める必要がある。
契約前に確認すべき情報
Googleのパイロット招待を受けた場合、オプトイン前に「重要な貢献」の定義、計算方法、Search Consoleの生成AIコントロールとの関連性についてGoogleに確認するべきだ。Microsoftのマーケットプレイスを検討する場合は、誰が価格を決定するのか、レポートに何が含まれるのかを契約前に明確にする必要がある。公開情報だけではこれらの質問に答えられない。
3社のモデルは「支払いの透明性」に対するアプローチが根本から異なる。Googleは判定をブラックボックスにすることで柔軟性を確保し、Cloudflareは機械的なイベントで透明性を確保し、Microsoftはパブリッシャーに条件定義を委ねる。いずれもまだ実験段階であり、最終的な設計が現在の形のまま展開されるとは限らない。
特に重要なのは、Cloudflareが自ら「クロール回数は価値の粗い指標」と認めた点だ。同じコンテンツでも1回のクロールで何千回も引用される場合と、何度もクロールされながら全く利用されない場合がある。この非対称性は、現在のすべての支払いモデルが「価値の正確な測定」にまだ到達していないことを示している。
サイト運営者は、今後のレポート精度の向上と透明性ツールの展開を注視しつつ、自社のコンテンツがAI応答にどう使われているかを定期的に確認する姿勢が求められる。
この記事のポイント
- Googleは招待制で「重要な貢献」と判定した場合のみ支払う。判定基準は非公開
- Cloudflareはクロール取得単位の課金とパートナー主導の利用課金の2軸で展開
- Microsoftはライセンス型で利用条件はパブリッシャーが定義するが価格決定者は不明
- Googlebotを含むクローラーにBlock設定を適用するとSEOリスクが連鎖する
- 3社とも試験段階で、価値測定の正確性が今後の焦点となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIが検索意図を再定義。68%がクリックされない検索の新常識
Google検索の68%がクリックなしで終わる時代に入った。2019年には49%だった「ゼロクリック」の割合が、わずか7年で20ポイント近く上昇したことになる。検索結果から外部サイトへ移動しないユーザーが、すでに3分の2を超えている。
この変化の中心にあるのが、AI ModeとAI Overviewsの急速な普及だ。月間アクティブユーザー10億人を超えたAI Modeの利用データは、検索意図の構造が根本から変わったことを如実に示す。もはやキーワードを入力して青いリンクを探す時代ではない。
本記事では、2026年に公開された2つの実証研究とGoogle自身の利用データを軸に、AIが検索意図をどう再定義しているのかを整理する。旧来のSEO指標では捉えきれない変化の実態と、これからの戦略立案に必要な視点を提示する。
ゼロクリック検索の実態。68%という衝撃の数字

SparkToroが発表した2026年のクリックストリームデータによると、米国におけるGoogle検索の68%がクリックを生まない。この数値は2019年の49%から一貫して上昇を続けており、単なる一時的な現象ではない。検索行動の地殻変動が10年単位で蓄積してきた結果だ。
ゼロクリックの広がりは、生成AIの登場によって突然始まったものではない。ユーザーはすでにYouTubeやTikTokなど、ビジュアルやコミュニティを重視するプラットフォームへ検索行動を分散させていた。Googleはこの流出を食い止めるため、検索結果画面の中で即時に答えを返す仕組みを強化してきた経緯がある。
重要なのは、検索がもはや単一のテキストボックスを超え、マルチモーダルでマルチプラットフォームのエコシステムに分裂したという事実だ。従来のSERP(検索結果ページ)での可視性だけを追いかけても、オーディエンスの意図が生まれる場所を捉えきれなくなっている。
検索結果画面の中で情報取得が完結するほど、外部サイトへの送客は減っていく。この構造変化こそがゼロクリック検索の核心であり、SEO戦略の前提を揺るがす要因だ。
Google AI Modeのデータが示す会話型検索の台頭

クエリは3倍長く、40%が追加質問
Googleが2026年のI/Oで公開したAI Modeの利用データは、検索行動の変化を具体的に裏付ける。AI Modeは月間アクティブユーザーが10億人を突破し、平均クエリの長さは従来型検索の3倍に達している。「説明する」「要約する」といった行動指向のコマンドが目立ち、一人称「私」の使用頻度が高い点も特徴だ。
これは単なるキーワード検索ではなく、会話型の対話に近い。追加質問は前月比40%増で推移し、AI Modeでの6分の1以上の検索が音声・画像・動画を組み合わせたマルチモーダルな入力になっている。ユーザーは青いリンクの一覧を求めておらず、即座に統合された価値を対話の中で求めている。
この変化は検索意図の捉え方そのものを変える。従来の「情報を探す」という受動的な行動から、「決める」「学ぶ」「創る」という能動的な行動へと、検索の役割が拡張しているのだ。
4語クエリがAI回答を起動する確率は48.1%
Clara Soteras氏らが実施したスペインメディアを対象とする初の大規模研究では、クエリの複雑さがAI回答の表示を直接左右することが示された。4語を含む検索では48.1%の確率でAIO(AI Overviews)が表示され、3語と4語のクエリだけで全AI生成結果の約70%を占める。
長いクエリの背後にある意図は、根本的に問いかけ型だ。常緑コンテンツ(長期間にわたって価値が変わらない情報)が75.2%を占め、ジャーナリズムの基本である「6W」を含むキーワードは高い確率でAI要約を誘発する。「why」は92.3%、「what」は85.7%、「who」は68.4%という数値が出ている。
ここから導かれる結論は明確だ。断片的な名詞キーワードを追いかける時代は終わり、複雑で普遍的な人間の問いに直接答えるコンテンツ構造へシフトする必要がある。
クエリの語数が増えるほど、また「なぜ」という問いかけが含まれるほど、AI回答は高い確率で表示される。コンテンツ設計では、複雑な問いに直接答える構成が求められる。
速報とAI回答は別世界。ブランド可視性の逆説も
同じ研究で注目すべきなのが、生成AIと速報ニュースが完全に別の生態系で動いている事実だ。AIOは常緑コンテンツの検索で34.6%表示されるのに対し、現在進行形のニュースでは1.1%まで急減する。速報を扱うTop Storiesモジュールとの同時表示率も1.4%に留まる。
さらに重要な発見として、分析対象となったSERPの43.6%はAIOもTop Storiesも表示されない「ブルーオーシャン」だった。この領域では従来のオーガニック順位が依然として高い効果を発揮する。
ブランド可視性の逆説も見逃せない。20 Minutosはブランド関連クエリで38.9%のAIO表示率を獲得した一方、トラフィック全体のリーダーであるEl Españolは11.1%に留まった。大量の訪問数が生成AI時代のシェア・オブ・ボイスを保証しないという端的な証明だ。
検索意図の5つの柱。探索から実行へ

Googleが発表した米国におけるAI Mode利用調査は、検索意図の境界を公式に再定義した。ユーザーはリンクを探すだけではなく、意思決定、旅行計画、タスク整理、概念学習、アイデア生成、比較検討、コンテンツ作成など、幅広い目的でAI Modeを利用している。
Googleはこの変化を5つの行動指向の柱として整理する。「探求する」「決める」「学ぶ」「創る」「実行する」の5つだ。検索が受動的な情報レイヤーから能動的なユーティリティレイヤーへ進化したことを、この分類は明確に示している。
WAN-IFRAのEzra Eeman氏が指摘する通り、この5つの柱はメディア分野におけるDmitry Shishkin氏の「User Needsモデル」と強い類似性を持つ。事実を報じるだけでなく、教育し、インスピレーションを与え、視点を提供する。そうした深いユーザー・ニーズを生成検索エンジンがインターフェース内で直接満たそうとしているのだ。
5つの柱はすべて動詞で構成されている点が重要だ。検索エンジンはもはや情報の入り口ではなく、複雑なニーズを最初から最後まで満たす動的なアシスタントへと位置づけを変えている。
視線追跡が暴く「見られるがクリックされない」領域

Laika Teamが実施した視線追跡調査は、SERP上でのユーザー行動をさらに深く解明した。Diego Criado氏らの研究チームが発見したのは「attention-to-action gap」、すなわち視覚的注意と実際の行動の間に生じる大きな乖離だ。
画像や商品リスト、AIOの「さらに見る」ボタンなどの視覚要素は、ユーザーの視覚的関与を最大100%獲得しながら、クリック率は0%という衝撃的な数値を示した。ユーザーはこれらの要素をわずか数ミリ秒で走り読みするだけで、実際の意思決定には利用しない。
一方で真の「コンバーター」は、AI Overviewの核心テキスト部分と従来のオーガニックリンクだった。AIO本体は86.4%、上位オーガニックリンクは95.5%という高いクリック率を記録している。生成AI機能が基本的な探索を完結させるため、周辺要素は視覚的ノイズと化し、クリックを獲得できる領域は限られていく。
視線追跡データが示すのは、SERP上でユーザーが実際に読んで意思決定する場所と、単に目に入るだけの場所がはっきり分かれたことだ。意図の高いトラフィックを獲得するには、この2つの領域の違いを理解する必要がある。
注目から互酬へ。新しい評価指標の必要性

検索行動の変化がここまで明確になると、KPI(主要業績評価指標)の見直しは避けられない。クリック数やクエリ量などの既存指標を捨てる必要はないが、量だけでなく深さを測る定性指標の補完が必須になる。
Industry Diveの共同創業者であるSean Griffey氏が提唱するのが「reciprocity(互酬性)」という概念だ。「注目は取引であり、互酬は持続可能である。それは堀になる」という同氏の言葉が示す通り、既存のダッシュボードは読者が消費する時点までしか測れていない。読者が購読する瞬間まで追跡できても、その先にある真のファン度を測る指標は存在しない。
互酬性が問うのは、より難しい質問だ。助けを求めたとき、オーディエンスは本能的な応答欲求を感じるか。見返りがなくても支えたいと思うほどのつながりがあるか。クリエイターエコシステムがこのつながりを常に検証してきたのに対し、メディアブランドも同様の実践を学ぶ必要がある。
tchop.ioのHeiko Scherer氏が指摘する「到達から所属へ」という視点も同じ方向を向く。単なるリーチでは測れない帰属意識こそが、ゼロクリック時代の最も価値ある資産になる。編集プロダクトの質を磨く、学びを目的としたコンテンツを設計する、活発なコミュニティを育てる、創作の場を提供する。これらの取り組みが、互酬性を育む具体的な道筋だ。
数値化しにくい指標を追いかけるのは実務的に難しい。しかしゼロクリックが進むほど、取引型の指標だけではブランドの持続可能性を測れなくなる。感覚的でも手応えのある定性指標を補完することが、これからのメディア運営に不可欠だ。
この記事のポイント
- Google検索の68%がクリックされずに終わるゼロクリック時代に入った
- AI Modeのクエリは従来の3倍長く、4語でAI回答出現率が48.1%に達する
- 検索意図は「探求する・決める・学ぶ・創る・実行する」の5つの柱に再定義された
- 視線追跡では画像やボタンが100%見られてもクリック率0%という乖離が判明した
- 新しい評価指標として、取引型の注目ではなく互酬性と所属の概念が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
2026年8月スパムアップデート開始!Google検索への影響と対策を解説
Googleが2026年8月18日、8月のスパムアップデートの展開を開始した。全言語・全地域が対象で、完了までに数日かかる見込みだ。Search Status Dashboardにランキングへ影響を与えるインシデントとして記録されている。
これは2026年に入って3回目のスパムアップデートとなる。3月の更新は過去最速の19時間30分で完了し、6月の更新は生成AI検索への操作対策もスパムポリシーの対象に含める方針が示された直後に行われた。
検索順位に動きが出た場合、スパムポリシー違反がないか確認することが重要になる。復旧には数ヶ月かかることもあるため、早期の対応が求められる。
8月スパムアップデートの概要
今回のアップデートは太平洋時間8月18日午前9時27分に開始された。日本時間では8月19日午前1時27分となる。Search Status Dashboardには開始時刻の約1分後、午前9時28分にリリースノートが掲載された。
適用範囲は全世界・全言語だ。Googleは完了までに数日かかる可能性があると案内している。この種のアップデートは、展開中に順位の変動が大きくなることがある。短期間のデータだけで判断せず、数日単位で傾向を見る必要がある。
公開時点では、Search Status Dashboardの注記に加えて公式ブログ記事は投稿されていない。スパムアップデートの概要ページも2025年12月から変更されていない。今回は新しいスパムポリシーの種類は追加されていない。既存のポリシーがそのまま判断基準になる。
このデモは8月スパムアップデートの展開フローを示している。各ステップの色分けは進行段階を表しており、青が開始、緑が適用範囲、橙が展開期間、紫が完了通知を意味する。
2026年のスパムアップデート史
2026年はスパムアップデートが立て続けに実施されている。8月の更新は3回目だ。過去2回の傾向を把握しておくと、今回の展開期間や影響範囲を推測しやすくなる。
3月の更新は過去最速で完了
3月のスパムアップデートは19時間30分で完了した。これはSearch Status Dashboardの記録上、確認済みの展開としては最速だった。展開期間が短いほど、順位変動も短期間に集中しやすい。
6月の更新は生成AI検索の操作対策も対象に
6月のスパムアップデートは2日と1時間かけて完了した。その前月の5月15日には、GoogleのスパムポリシーがAI OverviewsやAI Modeなど、生成AI検索の結果を操作しようとする試みにも適用されるという方針が明確化されている。6月の更新がこの種の操作を具体的に狙ったものかどうかは、Googleから公式な説明はない。
8月の更新についても、生成AI検索の操作を特に標的にしているかどうかは明らかにされていない。ただし、スパムポリシーは検索結果全般に適用されるため、生成AI検索への操作も対象範囲に含まれると考えるのが自然だ。
このデモは2026年に実施された3回のスパムアップデートを比較したものだ。青が3月、緑が6月、橙が8月を表す。完了までの時間が回を追うごとに長くなる傾向が見える。
サイト運営者が取るべき行動
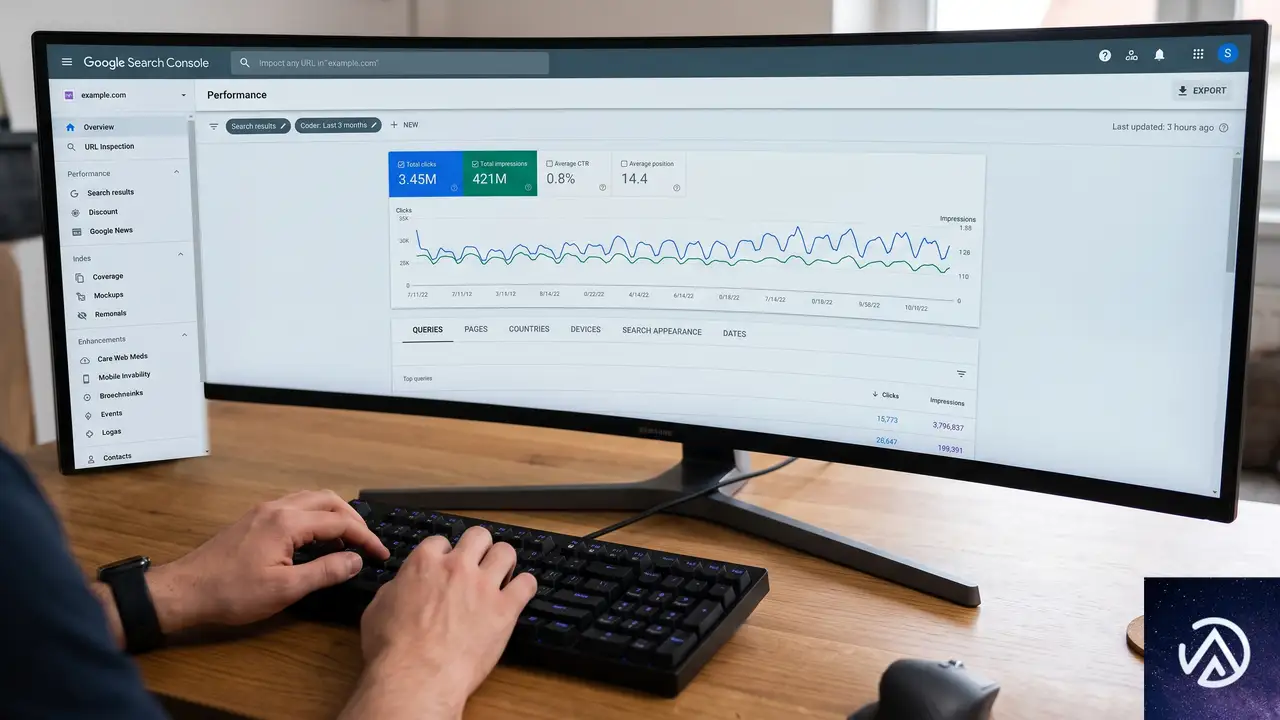
スパムアップデートの展開中は、検索順位が一時的に変動することがある。1日だけのデータで判断せず、Search Consoleのデータを数日分確認するのが基本だ。特に8月18日以降の動きに注目する必要がある。
Search Consoleで順位変動を確認する
順位の変動を確認するには、Search Consoleのパフォーマンスレポートが最も信頼できる。表示回数・クリック数・平均掲載順位を日別で確認し、8月18日以降に急激な変化が出ていないかを見る。
もし変動が見つかったら、それがスパムアップデートの影響なのか、他の要因によるものなのかを切り分ける必要がある。季節要因や自サイトの変更、競合サイトの動きなども同時に確認することだ。
このデモはSearch Consoleを使った確認手順を示している。青から紫への色分けは、各ステップの進行順を表す。
スパムポリシーの見直しが復旧の最短経路
順位が大きく下がった場合、Googleのスパムポリシーに違反していないかを見直す必要がある。主なポリシーには、クローキング、隠しテキスト、リンクスパム、キーワードの乱用、ユーザー生成スパムなどがある。自サイトが該当する可能性がないか、コンテンツとリンクの両面から確認する。
Googleの公式ドキュメントによると、スパムポリシー違反からの復旧には数ヶ月かかることがある。自動化されたシステムが、サイトがルールに従うようになったことを認識するまでに時間が必要なためだ。違反を修正しても、すぐに順位が戻るわけではないことを理解しておく必要がある。
このデモはGoogleのスパムポリシーで代表的な違反の種類を示している。赤い左線が注意を促す配色だ。
今後の展開と監視ポイント
Googleはアップデートの展開が完了すると、Search Status Dashboardに完了記録を掲載する。3月は19時間30分、6月は2日と1時間で完了しており、今回も同様に記録される見込みだ。
サイト運営者としては、完了通知が出るまでの間、Search Consoleのデータを注視するのが現実的な対応になる。特に8月18日以降の表示回数と平均掲載順位の推移を数日分まとめて確認し、変動の傾向を掴むことだ。
Search Engine JournalはGoogleが完了を確認次第、続報を伝えるとしている。今回のアップデートで新たなスパムポリシーが追加されたり、特定のスパム手法が集中的に取り締まられたりした場合は、その情報も出てくるだろう。
この記事のポイント
- 8月スパムアップデートは2026年8月18日に開始、全言語・全地域が対象
- 今年3回目のスパムアップデートで、新ポリシーの追加はなし
- 完了までに数日かかる見込みで、完了後にSearch Status Dashboardで通知される
- 順位変動があればSearch Consoleで8月18日以降のデータを確認する
- スパムポリシー違反からの復旧には数ヶ月かかることがある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GoogleのAI責任者ジェフ・ディーン氏が退任、新会社を設立。AI研究の巨人の軌跡とSEOの今後
GoogleのアルファベットCEO、サンダー・ピチャイ氏が2026年8月5日、大規模な組織改編と重要人物の退任を発表した。今回のニュースの核心は、27年にわたりGoogleの検索基盤と現代のAI技術を支えてきたチーフサイエンティスト、ジェフ・ディーン氏が退任し、新会社を設立することだ。
彼の退任は、単なる一社の人事異動ではない。TensorFlowの共同発明、知識蒸留の概念、MapReduceといった、今日の検索エンジンと生成AIの土台そのものを築いた人物の離脱である。この記事では、今回の発表内容、ディーン氏の技術的遺産、そしてこの出来事がSEO業界に投げかける長期的な影響を読み解く。
Google DeepMind新体制とデミス・ハサビス氏の役割拡大

今回の発表で、GoogleのAI研究開発におけるリーダーシップ体制が一新された。Google DeepMindの共同創業者でありCEOであるデミス・ハサビス氏が、新たにアルファベット社全体のチーフサイエンティスト、そしてGoogle DeepMindの会長に就任する。彼はDeepMindの顔としての役割を維持しつつ、Googleが持つ他のAI関連部門に対しても影響力を拡大することになる。
とりわけ注目すべきは、医薬品開発を行うアイソモルフィック・ラボ(Isomorphic Labs)への関与だ。この部門はAIを駆使して新たなバイオ医薬品や治療薬を発見することを目的としており、既にイーライリリーやノバルティス、ジョンソン・エンド・ジョンソンといった製薬大手と提携している。数兆円規模の巨大市場である医薬品産業において、GoogleがAIを中核に据えた事業展開を本格化させる意思が明確に示された形だ。
また、DeepMindのCTOを務めてきたコライ・カブクチュオール氏は、Google DeepMindのシニアバイスプレジデントに昇格し、実務的な日々のリーダーシップを担う。彼の管掌範囲には、Geminiモデルとアプリケーションの開発チーム、そして最先端のフロンティアモデルが含まれる。ピチャイCEOは声明の中で「彼は13年間DeepMindに在籍し、深層学習チームを立ち上げ、WaveNetやDQNといったブレークスルーを主導してきた」と評しており、まさに技術面での最高責任者としてGoogleのAI開発を牽引する役割を負う。
この一連の体制変更は、GoogleがAI研究の成果を検索やクラウドだけでなく、より実体経済に近い分野へと応用する段階に入ったことを示唆している。
ジェフ・ディーン氏の退任とその考古学的な功績
SEOやサイト運営者の間ではあまり知られていないかもしれないが、ジェフ・ディーン氏の名前は現代のインターネットの風景を語る上で欠かせない存在だ。彼はGoogleの初期検索インフラから、ニューラルネットワークによる現代AIの時代に至るまで、最も重要な技術的転換点の数々を牽引してきた。ピチャイCEOが「現代AI時代の創造に貢献した」と述べるのも当然のことである。
彼の退任が「巨大な損失」と形容される理由は、その業績リストを見れば一目瞭然だ。以下に、ディーン氏が関わった主要な研究論文と、その歴史的意義をまとめる。
MapReduce(2004年)
大規模クラスター上でのシンプルなデータ処理手法を提示したこの論文は、後のApache Hadoopの開発に強い影響を与え、ビッグデータ産業そのものの創出を可能にした。検索エンジンが扱う膨大なウェブデータの分散処理は、この着想なくしては実現しなかったと言っても過言ではない。
Bigtable(2006年)
構造化データを数千台のサーバーに分散して保存し、ペタバイト級にスケールさせる方法を示した。これは、超巨大規模でのウェブインデックス作成に直接的な影響を与え、Google検索の根幹技術のひとつとなった。
Large Scale Distributed Deep NetworksとDistBelief(2012年)
この論文は、数十億のパラメータを持つモデルのトレーニング手法を提示した。ここで紹介された分散学習フレームワーク「DistBelief」は、TensorFlowの直接の前身にあたる。スケーラブルな深層学習という、現在の巨大AIモデル時代の扉を開けたものだ。
知識蒸留(Distilling the Knowledge in a Neural Network、2015年)
大小さまざまなAIモデルを扱う企業や研究者にとって、知識蒸留は今や常識とも言える重要な技術である。これは、大規模で高性能な「教師モデル」の振る舞いを、より小さく高速な「生徒モデル」に学習させる手法を指す。簡単に言えば、ベテラン職人の技術を新人に凝縮して継承するイメージだ。ディーン氏は、この概念の主要な発明者の一人である。
この技術は、OpenAIやAnthropicのトップモデルを模倣するために中国企業が使用したと非難されたり、AIによる検索結果をリバースエンジニアリングする際に使われたりと、模倣や分析の文脈でも頻繁に話題に上る。AIの民主化と技術流出という、現代的な課題の根源にも関わる発明なのだ。
TensorFlow(2016年)
そして、おそらく最も広く知られているのが、機械学習ライブラリ「TensorFlow」の共同発明である。TensorFlowは、今日のAIを形作ることを可能にした柔軟なインフラ層だ。開発者が機械学習モデルを構築し、トレーニングするためのツールキットであり、現在の生成AIブームの縁の下の力持ちとも言える。TensorFlowの存在なくして、ChatGPTに代表される大規模言語モデルの急速な発展はありえなかった。
今回の退任がSEOとサイト運営に与える長期的な影響

SEOコミュニティの多くは、ジェフ・ディーンという個人名に馴染みが薄いかもしれない。しかし、彼の存在はこれまでの検索エンジンの進化、つまりSEOそのもののゲームルールを決定づけてきた。ここでは、彼の退任がもたらすであろう、より深い地殻変動を考察する。
GoogleのAI研究開発の方向性変化
最高技術責任者の退任と後任者の就任は、組織としての研究開発の優先順位や文化に変化をもたらすことが一般的だ。ディーン氏の代わりに実務のトップに立つコライ・カブクチュオール氏は、Geminのような大規模言語モデルと、その先のフロンティアモデルに直接責任を持つ。この体制が続く限り、Googleの研究開発リソースは「より賢く、より大きなAI」を追求する方向性が加速するだろう。
AIによる検索品質とアルゴリズム進化の加速
同時に、ディーン氏が積み上げてきた分散処理と大規模学習の基盤は、既にGoogle検索の血肉となっている。Googleが「AIによる検索体験」をどこまで推し進めるのか。AI Overviewsのような機能の進化は、後任者たちの手腕にかかっている。ディーン氏の退任は、ある種の完成を迎えた基盤技術の上で、応用レイヤーの競争がいよいよ本格化する合図とも読み取れる。
AIスタートアップ「Discovery Loop」とGoogleの特別な関係
サンダー・ピチャイ氏は、ディーン氏とGoogleのシニアフェローであるサンジェイ・ゲマワット氏が、機械学習や科学、工学における発見を加速させる独立した公益法人(Public Benefit Corporation)を設立すると述べた。この新会社「Discovery Loop」はGoogleからの独立組織だが、Google自身が出資者かつクラウドパートナーとなり、研究フレームワークでも協業するという。つまり、まったくの別会社というわけではなく、Googleのエコシステムと強固に結びついた「外部の頭脳」として機能する可能性が高い。両社の研究成果が間接的にGoogle検索に還流する未来も十分に考えられる。
この記事のポイント
- Googleのチーフサイエンティスト、ジェフ・ディーン氏が27年のキャリアに幕を下ろし、AI研究の新会社「Discovery Loop」を設立。
- ディーン氏はMapReduce、Bigtable、TensorFlow、知識蒸留など、現代の検索とAIの基盤技術を数多く発明。事実上の「検索エンジンの父」の一人。
- 後任のハサビス氏はDeepMind会長兼アルファベット全体のチーフサイエンティストとなり、医薬品開発などAIの応用領域を拡大する方針。
- この人事は、GoogleのAI研究が「基盤づくり」から「応用と収益化」へとフェーズを移行させるシンボリックな出来事。
- SEO実務者にとっては、AI Overviewsの高度化など、検索体験のさらなる変貌を前提とした長期的視点でのサイト運営がこれまで以上に求められる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GoogleサーチコンソールにAI検索レポート登場。見るべきポイントと活用術
Google は 2026 年 6 月 3 日、Search Console に生成 AI 専用のパフォーマンスレポートを追加した。AI Overviews(AI 概要)や AI Mode(AI モード)といった検索体験の一部として、自社サイトの URL がどの程度表示されたかを切り分けて確認できるようになっている。
これまで「AI 検索に自社のコンテンツが出ているのかどうか」は、通常の検索パフォーマンスの数字に埋もれてわからなかった。今回の分離によって、どのページが生成 AI の回答元として使われているのかを確認できるようになったが、あくまで「表示回数」ベースのデータであり、クリックや引用のされ方までは把握できない点に注意が必要だ。
この記事では、新レポートで何が読み取れるのか、従来の検索表示回数とどう違うのか、そして実際にサイト改善に役立てるための診断フローを解説する。
AI検索レポート、ついに独立

生成AI専用レポートの概要
この新しい Search レポートは、AI Overviews と AI Mode からの表示回数のみを集計する。Discover 向けの生成 AI 機能は別レポートとして提供されている。また、Labs の実験的機能は対象外だ。
レポートでは、URL 単位、国別、デバイス別、日付別に表示回数をセグメントできる。ただし現時点では、以下の指標は含まれていない。
- 検索クエリ
- クリック、クリック率(CTR)
- 平均掲載順位
- 引用の位置(回答内でリンクがどの順序で表示されたか)
- 回答の基となった文章の特定
- コンバージョンや収益データ
Google は「今後、追加指標の要望をサイト運営者とともに検討する」と述べており、機能拡張の可能性はある。また、AI Overviews や AI Mode にコンテンツを含めるかどうかを制御する新しい設定も Search Console でテスト中だ。デフォルトは「含める」で、オプトアウトすると従来の検索結果には影響なく、生成 AI の回答からも自社コンテンツが除外される。
まずは「どの部分が使われているか」を把握するために
現時点のレポートが答えられるのは「サイトのどのページが生成 AI の表示に使われているのか、どのくらいの頻度か」という問いだ。それ以上の詳細は得られないが、この可視化だけでもこれまでにない手がかりになる。
AI表示回数は従来の表示回数とは異なる

表示回数の数え方の基本
Google の定義では、AI 表示回数とは「生成 AI の機能内でユーザーにリンクが表示された回数」を指す。集計方法はレベルによって異なり、グラフのプロパティ全体では、1 つの回答内に同じサイトの異なる URL が複数出ても 1 回とカウントされることがある。一方、ページテーブルでは各 URL が個別に 1 回ずつ計上されるケースもある。
つまり、ページレベルの表示回数を足し上げた合計が、必ずしもプロパティ合計と一致しない。これは集計単位の違いによるもので、数値に矛盾があるわけではない。
従来の検索との違いと混同禁止
従来の検索結果での表示回数は、検索結果リスト内の 1 つの掲載としてユーザーが認識しやすい。一方、AI Overviews や AI Mode の表示は、合成された回答文の一部として現れる。リンクが目立つ場合もあれば、折りたたまれた引用リストの中に埋もれている場合、フォローアップの質問の後に出現する場合もある。
また、AI Overviews ではリンクがスクロールされるか展開されるまで表示回数としてカウントされない。AI Mode ではフォローアップの質問が新しいクエリとして扱われ、後続の回答で表示されたリンクが追加の表示回数を生む。
これらの違いから、生成 AI の表示回数と通常の検索表示回数を合算して「総検索可視性」のように扱うのは全くの誤りだ。CTR のブレンド計算も同様に意味をなさない。レポート画面で数字が並んでいても、それらは性質の異なる指標であることを肝に銘じたい。
このレポートで診断できること

このレポートの真価は、表示回数の総数ではなく、どのページが生成 AI 検索で使われているかを通常の検索パフォーマンスと比較できる点にある。
これは概念図だが、レポートの表示回数を通常の Search Console の検索パフォーマンスと並べて分類すると、上記の4パターンに整理できる。それぞれ次のような特徴がある。
高オーガニック表示・低AI表示のページ
通常検索ではよく見られていても、生成 AI の回答にはあまり使われないページだ。必ずしも問題とは限らない。クエリ自体が AI 応答を引き起こさないケースもある。しかし、次のような点を確認すると原因が見えてくる。
- 具体的な質問に直接答えているか
- 見出し構造が整理されているか
- 重要な情報がテキストとして HTML 上に露出しているか(タブや画像、JavaScript に隠れていないか)
- AI 応答が発生しやすいクエリにマッチする内容か
通常のランキングで上位に上がる能力があっても、合成に使えるクリーンな回答を提供できなければ、AI 表示にはつながりにくい。
低オーガニック表示・高AI表示のページ
こちらの方が注目に値する。通常の検索では目立たずとも、生成 AI で高い頻度で表示されるページがある。定義や統計、比較、説明が明快なコンテンツがこれにあたる。
こうしたページを分析すると、以下の共通点が見えてくることが多い。
- セクションの冒頭付近で直接的な回答を提示している
- 見出しの階層が明確で情報が取り出しやすい
- 独自の調査や一次情報を含んでいる
- 有益な表やリストがある
- トピックの範囲が絞られており、曖昧な表現が少ない
1 つの成功パターンを見つけたからといって、それを再生産すればうまくいくとは限らないが、サイト内で「Google が使いやすい」と判定している構造や表現のヒントになる。
ページ改修の効果を追う
コンテンツを大幅に修正した後に、AI 表示回数がどう変化するかをウォッチするのにも有用だ。たとえば以下のような改修が効果を持つ可能性がある。
- 明確な要約や定義を冒頭に追加
- 古い情報を更新し、鮮度を高める
- 重複したページを統合
- 見出しを書き直して情報の抽出を助ける
- 画像や動画に頼っていた重要情報を HTML テキストに移す
- 独自の証拠や専門家のコメントを加える
ただし、1 つの見出しを変えた翌週に数字が上がったからといって「AI 検索のアルゴリズムを解明した」と騒ぐのは禁物だ。需要や競合、AI 機能の出現頻度そのものが変動する。持続的な増加が確認できて初めて意味のあるシグナルとなる。
データを分析する実践ワークフロー

エクスポートと分類、従来データとの比較
分析は次の 6 ステップを踏むと整理しやすい。
- AI 表示回数の上位ページをエクスポート
意味のある期間を選ぶ。リリース直後の数日で判断しない。 - 同じ URL・期間で通常の検索パフォーマンスをエクスポート
通常の検索表示回数、クリック、CTR、平均順位、可能なら上位クエリを加える。比較することで、AI と通常検索で差があるページを特定できる。 - ページを属性で分類
ページタイプ、トピック、検索意図、テンプレート、著者、公開日、最終改訂日、ファネルステージなどを付与。URL と表示回数を並べただけでは分析にならない。 - 外れ値を調査
AI 表示回数が極端に高いページや低いページを探す。テンプレートやトピック、著者によってなぜ差が生まれるのかを実際に HTML 構造や本文を見て確認する。この段階で初めて手を動かす必要がある。 - アナリティクスのデータを別に確認
AI 経由のトラフィックやコンバージョンが特定できれば、表示回数がどの程度実際の訪問につながっているかを評価する。ただし Search Console と Analytics では計測方法が異なるため、数字のズレに一喜一憂しない。 - 日次の変動ではなくトレンドを追う
新しいデータは暫定的な数値の可能性もある。週次や月次で傾向を見るほうが建設的だ。1 日で上がった下がったに右往左往しない。
経営ダッシュボードに載せるべきではない指標

「AI」とラベルされた大きな数字が現れると、ダッシュボードの一番上に大きく表示したくなるものだ。しかし、生成 AI の表示回数はあくまで特定の状況でのリンク出現を示しており、ビジネス成果に直結するとは限らない。
以下のような報告は避けるべきだ。
- 生成 AI 表示回数と通常検索表示回数を合算した「総視認性」
- 両者をブレンドしたクリック率
- 自社の AI 表示回数だけを元にした「AI シェア」
- 表示回数に紐づけたコンバージョンの推測
- 1 つの最適化施策が効いたかのように見せるための表示回数の増加報告
- ページレベルの合計をプロパティ全体の露出と誤認させる表示
代わりに、ダッシュボードに盛り込むべきは「生成 AI 表示回数の推移」「表示回数がついたページ数」「表示されているトピック・ページタイプ」「AI 可視ページと通常検索パフォーマンスとの関係」「期間中に実施した改修」「AI 経由の識別可能なトラフィックやコンバージョン(分けて報告)」「追加調査が必要な仮説」といった項目だ。
この記事のポイント
- Search Console の新レポートで、AI Overviews と AI Mode の表示回数が通常検索と分離された
- 表示回数はクリックや引用位置の情報を含まず、あくまで「リンクが表示された」という指標である
- 従来の検索表示回数とは性質が異なり、合算やブレンド分析は誤解を招くため厳禁
- 通常検索との比較で、コンテンツの抽出しやすさや構造の課題を発見できる
- 分析の際は長期的なトレンドとページ属性の分類が不可欠で、数字の上下だけで施策の成否を判断しない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
クロールバジェット最適化の新ガイドライン、ECサイトが実践すべき手法
Googleがクロールインフラストラクチャの公式ドキュメントを更新し、「クロールバジェットの最適化」に関する新たなガイドラインを公開した。ECサイト運営者にとって、この変更は商品ページのインデックス速度に直結する。クロールされなければ検索結果に表示されないからだ。
今回の更新で注目すべきは、新サイトに割り当てられる「保守的なクロールバジェット」の考え方と、304ステータスコードに関する注意喚起だ。特に304の扱いは、安易に導入すると検索順位に影響を与える可能性がある。
この記事では、Googleの新ガイドラインの要点と、ECサイトが実践すべきクロールバジェット最適化の手法を解説する。
クロールバジェットとは何か
クロールバジェットとは、Googlebotが一定期間内に特定のサイトをクロールするURLの総量を指す。インターネット上のURL数は膨大であり、Googleは各サイトに割り当てるクロール量を最適化する必要がある。この割り当てが「バジェット(予算)」と呼ばれる理由だ。
サイト構造が整理されておらず、無駄なURLが多いサイトは、クロールに時間がかかり、結果としてインデックスされるページ数が少なくなる。ECサイトの場合、商品ページがインデックスされなければ、検索経由の流入機会を失うことになる。
クロールバジェットを意識したサイト設計は、検索エンジンに「このサイトは効率的にクロールできる」と認識させる第一歩だ。以下、Googleの新ガイドラインに沿った具体的な施策を見ていく。
新サイトには保守的なクロールバジェットが割り当てられる
Googleの更新されたドキュメントで明確にされたのが、新規サイトに対するクロールバジェットの初期値だ。新サイトには「保守的な」バジェットが割り当てられ、サーバーに過負荷をかけずに重要なコンテンツをカバーできるよう設計されている。
段階的なコンテンツ公開が鍵
新サイトを立ち上げる際は、一度に大量のページを公開するよりも、徐々にページ数を増やす方がGooglebotの信頼を得やすい。たとえば、100商品を1日で公開するより、1日3商品ずつ約1ヶ月かけて公開する方が、クロールバジェットの観点からは有効だ。
この段階的アプローチにより、Googlebotはサイトの更新パターンを学習し、クロールバジェットを徐々に拡大していく。XMLサイトマップの自動更新と組み合わせることで、さらに効果が高まる。
表示速度の改善がバジェットを増やす
サイトの読み込み速度が速いほど、Googlebotは効率的にクロールできる。これは以前から知られていた事実だが、今回のガイドラインでも改めて強調された。表示速度の改善は、ユーザー体験の向上だけでなく、クロールバジェットの増加にも直結する。
Googleが提供するPageSpeed InsightsやLighthouseを使って定期的にパフォーマンスを測定し、改善を続けることが重要だ。ECサイトでは、画像の最適化や不要なスクリプトの削減が特に効果的だ。
人気ページはクロール頻度が高まる
外部リンクや内部リンクを多く集めているページは、Googlebotの巡回頻度が高くなる。ECサイトの場合、トップページや主要カテゴリページ、よく参照される商品ページが該当する。内部リンク構造を最適化し、重要なページへリンクを集中させることで、クロール頻度を向上させられる。
クロール効率を下げる要因とその対策
クロールバジェットを浪費する要因はいくつかある。以下に主要なものと対策を示す。
robots.txtで不要ページをブロック
プライベートログインページ、ショッピングカート、動的に生成されるページなど、インデックス不要なページはrobots.txtのdisallowディレクティブでブロックする。これにより、Googlebotが本当に重要なページだけを巡回するよう誘導できる。
重複コンテンツの削除と統合
同じ内容のページが複数存在すると、クロールバジェットが分散される。商品バリエーション(色違い、サイズ違い)でURLが分かれている場合は、canonicalタグで正規URLを指定するか、統合を検討する。
ソフト404とリダイレクトチェーンを回避
削除されたページが200ステータスコードを返す「ソフト404」は、Googlebotが無駄なクロールを続ける原因となる。存在しないページは404または410レスポンスを返すように設定する。また、1つのページに対して複数のリダイレクトが発生する「リダイレクトチェーン」も、クロール効率を低下させるため避けるべきだ。
Search Consoleのクロール統計を活用
Google Search Consoleの「設定」→「クロール統計」レポートでは、Googlebotのクロール頻度や発生した問題を確認できる。このレポートを定期的にチェックし、クロールバジェットの消費状況を把握することが、最適化の出発点となる。
304ステータスコードの注意点
今回のガイドライン更新で追加されたのが、304(Not Modified)ステータスコードに関する推奨だ。Googleは「前回のクロールからページが変更されていない場合、304コードを返すことでGoogleにキャッシュ版の再利用を促し、サーバー帯域とリソースを節約できる」としている。
しかし、この推奨には注意が必要だ。Practical Ecommerceの記事では、Jill Kocher氏が次のような見解を示している。304コードを重要なページに使用すると、検索結果での表示順位やインデックスステータスに影響を与える可能性がある。同氏は、期限切れ商品やポリシーページなど、重要性の低いページに限定して使用することを推奨している。
ECサイト運営者としては、この304コードの推奨を鵜呑みにせず、自社のSEO戦略に照らして慎重に判断する必要がある。売上に直結する商品ページやカテゴリページには適用せず、重要度の低い固定ページに限定するのが賢明だ。
この記事のポイント
- 新サイトのクロールバジェットは「保守的」に設定されるため、段階的なコンテンツ公開が有効
- 表示速度の改善と定期的な更新が、クロールバジェット拡大の鍵
- robots.txtの活用、重複コンテンツの統合、ソフト404の排除で無駄なクロールを削減
- Search Consoleのクロール統計レポートで状況を定期的にモニタリング
- 304ステータスコードは重要ページには使用せず、影響の少ないページに限定する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験