

AI時代のブランド監査、ローカルビジネスに必要なSEO戦略とは
AIがビジネスの評判を決める時代に入った。検索窓に質問を打ち込むユーザーは、もはやリンクのリストをクリックしない。AIが瞬時に要約した「答え」だけを見て、店を選び、サービスを予約する。この変化はローカルビジネスの集客構造を根底から揺るがしている。
GatherUpが2025年秋に集計したデータによると、消費者の55%がGoogleやBingのAI要約を参照し、48%がChatGPTに地域ビジネスについて質問した経験を持つ。さらに31%は複数回質問している。問題は、AIが提示する「おすすめ」が、必ずしも最高評価の店舗ではないことだ。
実際の検索で起きた象徴的な事例がある。バージニア州ノーフォークで「SUVが入る非接触洗車機」をGoogleに尋ねたユーザーに対し、AIは評価3.3の店舗を提示した。検索クエリとのマッチ度が、星評価より優先されたのである。この事実は、AI時代のローカルSEO戦略が星集めだけでは成立しないことを示している。
AIは地域ビジネスをどう探すようになったか

従来のローカル検索は「近くのラーメン」という短いキーワードが主流だった。ユーザーはMapPackやオーガニック検索結果から複数店舗を見比べた。AI検索ではこの流れが完全に変わる。ユーザーは「子供連れでも入れて、駐車場があって、あっさり系の醤油ラーメンが人気の店」のように、自然言語で条件をすべて盛り込んだ質問を一度に投げる。
質問型クエリが標準になった
この変化を端的に表すのが洗車場の事例だ。検索クエリは「no-touch car wash for my SUV in Norfolk, VA」。車種、洗車方式、場所、すべてが1文に含まれている。Googleは保有する3億件の施設データと5億人のレビュー投稿者情報を即座に処理し、1件の店舗を返した。
注目すべきは、この店舗の評価が3.3だった点である。GatherUpのアニー・ジャクソン氏(収益オペレーション&成長担当ディレクター)はSearch Engine Journalの記事で「Googleは私の質問に答えましたが、このビジネスは3.3つ星なのです。星評価よりクエリの文脈が優先されたのです」と指摘している。
※AI検索では1回の質問で店舗決定まで完結する
検索の文脈には時間帯やユーザーの属性も含まれる。Search Engine Journalの記事でジェイソン・ワーサム氏(レビューディフェンス運営担当VP)が警告しているように、LLMが「ユーザーはSUVを持っている」「大型犬を飼っている」といった情報を学習すると、以降の検索では毎回その文脈が適用される。ユーザーが再び条件を入力しなくても、AIは過去の対話を覚えている。
AIはレビューをどう読んでいるのか
多くのマーケティング担当者が誤解している点がある。GoogleビジネスプロフィールやYelpに投稿されたレビューは、AIが直接読み取れるわけではない。これらの主要ディレクトリは、LLMクローラーがビジネスプロフィール上のレビューをスクレイピングするのをブロックしている。
レビューがAIに渡る経路
ワーサム氏はこのメカニズムを明確に説明している。「ChatGPTやClaudeなどのLLMツールは、GoogleやYelpといった主要ディレクトリ上のレビューデータをクロールできません。実際、AIが特定のレビューを引用しないのはこのためです」。
しかし同じレビューでも、一度Web上に再掲載されると状況が一変する。レビューを自社サイトのウィジェットで公開したり、SNSに投稿したりした瞬間、その情報はLLMのクロール対象になる。ワーサム氏の言葉を借りれば「その時点でLLMツールの餌食になる」のだ。
※「人気の店」を尋ねるユーザーにはクロール可能なレビューが回答を左右する
この仕組みは、AI検索でどのクエリに勝てるかを決定的に左右する。ユーザーが「人気の」「高評価の」ビジネスを尋ねたとき、LLMはアクセス可能なレビューテキストを検索する。ディレクトリ内に閉じ込められたレビューは、回答に一切貢献しない。
そのため実務上の優先順位は明確だ。レビューを自社サイトやSNSで定期的に再発信し、AIが参照できる形でWeb上に存在させることが、AI時代のローカルSEOでは必須になる。ディレクトリ任せでは不十分だとワーサム氏も強調している。
星評価はAI検索で通用しなくなる
これまでのローカルSEOは星の数を増やすことが目標だった。しかしAI検索において、平均星評価の重要度は急速に低下している。Search Engine Journalが報じた監査事例では、AIが平均星評価を引用したケースはゼロだった。代わりに参照されたのはすべて、具体的なレビュー本文の内容である。
AIが重視するのは「鮮度」と「量」
消費者データも同じ傾向を示す。45%のユーザーが星評価よりレビューの新しさを優先し、60%が評価点だけのレビューより詳細な文章レビューを信頼する。さらに70%が、購入後72時間以内のレビュー依頼を好むというデータもある。
ワーサム氏はこの変化を明確に言語化している。「星5の30件より、星3.9で1,000件の店に行く。古い高評価より、現在も続く安定したレビューの流れの方が価値が高い」。Googleのデフォルト表示が「最も関連性の高い」レビューであっても、ユーザーの多くはわざわざ「新しい順」に並べ替える。それは最新のレビューが、自分がこれから受ける体験を最も正確に予測するからだ。
※ユーザーはGoogleの表示順を「新しい順」に切り替える傾向がある
対策は3つの柱に整理できる。構築(リスティングの一貫性とレビュー量の確保)、管理(72時間以内の返信とモニタリング)、防御(ポリシー違反レビューの削除依頼とレビューの埋没対策)。この3つを同時に回すことで、AIが参照する情報の質と量をコントロールできる。
AIの回答が毎回違う理由
LLMが生成する回答は確率的な出力だ。同じ質問をしても、デバイスやアカウント、時間帯によって結果が変わる。SparkToroの調査では、異なるユーザーが同じ質問をLLMに投げたところ、結果の順序が一度も同じにならなかった。
スロットマシンのような仕組み
ジャクソン氏はこの性質を「AIへの質問はスロットマシンのようなものだ」と表現している。毎回似たデータが返ってくるが、その都度少しずつ異なる。この特性を理解しないまま「AI検索で1位」を目標にするのは無意味だ。
AI検索における正しいKPIは順位ではない。評価すべきは引用総数、つまりAIの回答に自社情報がどれだけ使われているかである。ブランドが特定の端末で回答から完全に除外されることもあれば、次の検索ではトップに立つこともある。重要なのは、どの検索でも「存在する」ことだ。
※異なるデバイスや時間帯で結果が変わる前提の測定が必要
監査の際には必ずシークレットモードやテンポラリーチャットを使用する。保存されたコンテキストが結果を歪めるからだ。さらに定期的な再実行が不可欠で、月次での定点観測によって、AI上のブランド認知が実際に改善しているかを評価する。
緊急ブランド監査 4つのプロンプト
GatherUpのセッションでは、多店舗ブランドが今すぐ実行できる4段階の監査プロンプトが紹介された。目的は、ChatGPTやGoogleのAI Overviews、Ask Mapsが自社について何を答えているかを可視化することだ。
自社把握から店舗別診断まで
監査はブランド名の単純な質問から始まり、徐々に深掘りしていく。最終段階では店舗ごとにAIがどう説明しているかをチェックする。Search Engine Journalの記事に掲載された監査ハンドアウトには、この4段階の具体的なプロンプト例が含まれている。
注目すべきは、Googleが今月更新したAI最適化ガイドの変更点だ。Search Engine Journalの記事でワーサム氏が指摘しているように、GoogleはAI生成の低品質コンテンツを検出し、ペナルティを科し始めている。汎用的なAIブログ投稿やFAQスクレイピングは、もはや無視されるだけでなくマイナス評価の対象になる。
※GoogleはAI生成の低品質コンテンツへのペナルティを開始している
この記事のポイント
- AI検索では星評価よりクエリとのマッチ度とレビューテキストが優先される
- LLMはGoogleやYelp上のレビューを直接クロールできず、自社サイトやSNSへの再掲載がAIの情報源になる
- 星評価よりレビューの鮮度と量がAIの回答を左右する。評価が3.9でも1,000件ある店舗が星5の30件より強い
- AIの回答は確率的で毎回変わるため、順位ではなく引用総数で評価する
- 4段階の監査プロンプトを月次実行し、AIが自社をどう説明しているかを把握することがブランド防衛の第一歩

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleがrobots.txtを無視する理由とSEOへの悪影響を解説
GoogleのJohn Mueller氏が、robots.txtに関する見落としがちな設定ミスについて回答した。このミスは、SEOやサイトのインデックス目標に悪影響を及ぼす可能性があり、特に検索ボックススパムへの対策を複雑化させる。なぜrobots.txtが正しく機能しないのか、その根本原因と具体的な解決策を解説する。
「無視されるrobots.txt」が生まれる仕組み
robots.txtは、検索エンジンのクローラーに対して「どのページをクロールしてよいか」を指示するためのファイルだ。しかし、設定の書き方を誤ると、その指示が完全に無視され、意図しないページがGoogleにインデックスされる事態を引き起こす。
Disallow: /search
Disallow: /private
Disallow: /admin
Disallow: /search
Disallow: /private
Disallow: /admin
Disallow: /
User-agent別ルールと優先順位の落とし穴
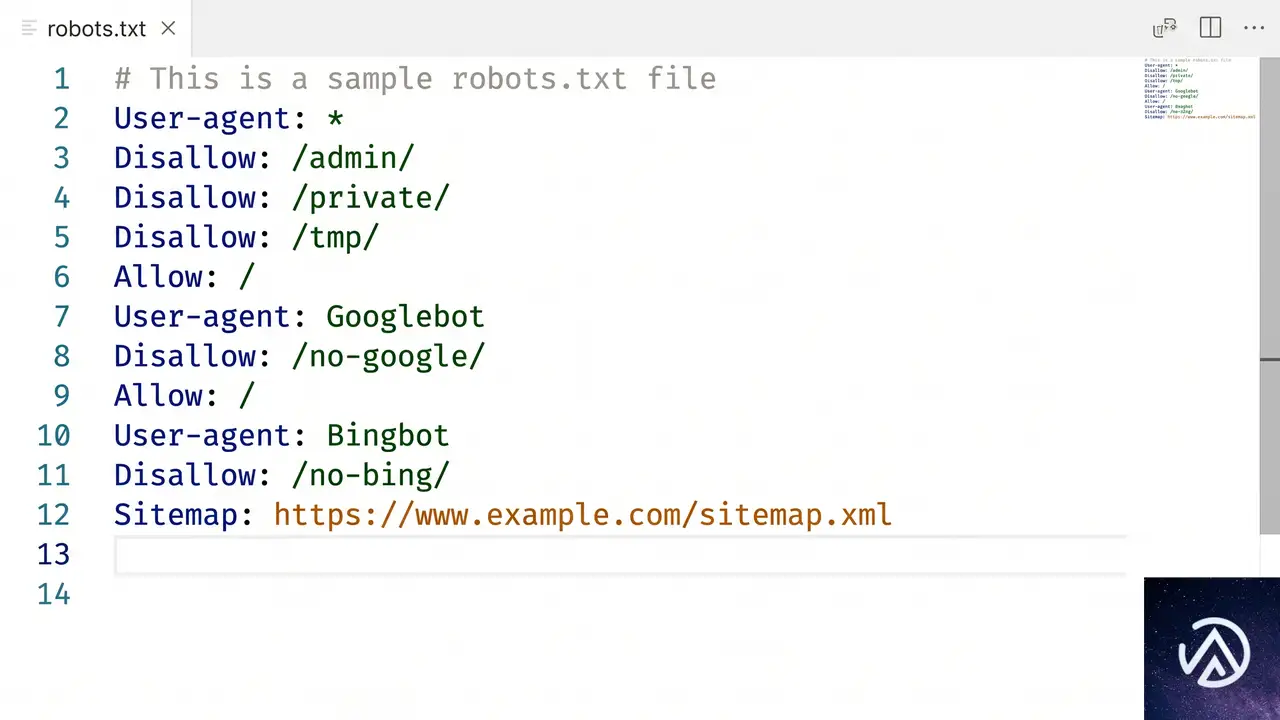
問題の核心は、robots.txtの「より具体的なルールが優先される」という仕様にある。一般的なクローラー向けの User-agent: * セクションと、Googlebot専用の User-agent: googlebot セクションが同じファイル内に存在する場合、Googlebotは自身に直接関係するセクションのみを参照する。
Search Engine Journalの記事によると、あるShopifyサイトでは検索ボックススパム対策として Disallow: /search を User-agent: * 内に記述していたが、別途 User-agent: Googlebot セクションが存在したため、この禁止指示がGooglebotに無視されていた。結果として、スパムによって生成されたURLがGoogleのインデックスに残り続けることになった。
これはrobots.txtの設計に起因する合理的な動作だ。特定のクローラーにだけピンポイントで指示を出し、それ以外のクローラーには別のルールを適用できる柔軟性を持たせるための仕組みである。しかし、この「柔軟性」が、設定の分断と見落としを生み出す。
■ クローラーの動作
■ 発生した問題
robots.txtが制御するのは「クロール」であって「インデックス」ではない
もう一つの重要な前提として、robots.txtはページのクロールを制御するものであり、インデックスを直接制御するものではない。robots.txtでブロックしたページでも、何らかの理由でGoogleがそのURLを知り得た場合、コンテンツをクロールせずにインデックスすることがある。この仕様は、robots.txtだけに依存したインデックス制御が根本的に不完全であることを示している。
robots.txtとnoindexの正しい使い分け

インデックスそのものを確実に防ぎたい場合、robots.txtよりも meta robots タグによる noindex 指定の方がはるかに効果的だ。robots.txtはドアの前に立つ警備員のようなもので、部屋の中のものを「知らない」ままでいられるが、部屋の存在自体を消し去ることはできない。noindex は、その部屋に「公開禁止」の札を貼るようなもので、検索エンジンに直接「これを検索結果に表示しないでほしい」と伝える。
Disallow: /search
noindexを確実に適用するための注意点
noindex を適用する際、robots.txtでそのページをクロール禁止にしてしまうと、Googlebotはそもそもそのページを読みに行けず、noindex タグを発見できない。結果として、いつまでもインデックスから削除されないという、本末転倒な事態を招く。クロールを許可した上で、noindex を指示することではじめて、意図したインデックス制御が機能する。
ShopifyとWordPressにおける具体的な対策
検索ボックススパムは、どのようなCMSでも発生しうる問題だが、幸いShopifyとWordPressの両方には、比較的簡単に実装できる緩和策が用意されている。
Shopifyでの検索ページnoindex設定
Shopifyでは、テーマの theme.liquid ファイルを編集することで、すべての検索結果ページに自動で noindex タグを追加できる。これにより、スパムクエリによって生成された無意味なページが検索結果に表示されることを防ぐ。
{% if template contains 'search' %}
  <meta name="robots" content="noindex">
{% endif %}
このコードをテーマの <head> セクションに追記するだけで、すべての検索ページへのnoindex適用が完了する。robots.txtによる制御と異なり、検索結果ページのURLを確実にインデックスから除外できるため、より根本的なスパム対策となる。
WordPressでの検索スパム対策
WordPress環境では、主要なSEOプラグインを導入するだけで検索結果ページへの noindex がデフォルトで有効になる。Yoast SEO、Rank Math、All In One SEO Packといったプラグインは、インストールしたその日から検索スパムに対する基本的な防御壁として機能する。
さらに、Diviをはじめとする一部のテーマやページビルダーは、スパムワードを含む検索クエリに対して、結果を表示する代わりに「該当する結果がありませんでした」というメッセージを返す仕組みを備えている。これにより、スパムURLそのものが生成されにくくなるという副次的な効果も期待できる。
robots.txtの正しい知識がサイトを守る
robots.txtは強力なツールだが、その仕様を正しく理解していないと、かえってサイトの健全性を損なう原因になりうる。特に、User-agent別のルールの優先順位や、クロール制御とインデックス制御の違いといった基礎知識は、サイト運営者にとって必須のリテラシーと言える。
この記事のポイント
- robots.txtでUser-agent: Googlebotの専用セクションがあると、一般的なUser-agent: *のルールはGooglebotに無視される。
- robots.txtはクロールの制御であり、確実なインデックス除外にはmeta robotsタグのnoindex指定が必要。
- 検索ボックススパム対策には、robots.txtよりnoindexの方が根本的な解決策となる。
- ShopifyやWordPress(SEOプラグイン利用)では、テンプレートや設定を少し修正するだけで検索スパムを効果的に緩和できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google LSAがGoogle広告に統合、2026年8月から段階移行へ
GoogleがLSA(Local Services Ads / ローカルサービス広告)の管理画面をGoogle広告に統合する。2026年8月から一部の米国広告主を対象に移行が始まり、2027年にかけて段階的に拡大される予定だ。
移行後はGoogle広告内でキャンペーン管理やリード対応が完結する。ただし入札方式やレポートの扱いが変わるため、事前の準備が欠かせない。本記事では移行のスケジュールや変更点、広告主が取るべき対応を3つのポイントに絞って解説する。
LSAのGoogle広告統合で何が変わるのか
LSA(ローカルサービス広告)は、もともとGoogle検索やマップの上部に表示される問い合わせ獲得型の広告だ。ユーザーが「近くの電気工事業者」などと検索すると、電話やメッセージでのリード獲得を主目的とした事業者一覧が表示される仕組みである。
今回の統合により、LSAはGoogle広告の管理画面から操作する形へと一本化される。従来のLSA専用ダッシュボードは廃止され、キャンペーンの作成からリード対応までをGoogle広告内で処理できるようになる。
移行スケジュールは2026年8月から段階的に
Googleが公開したスケジュールによると、最初の移行対象は米国の一部広告主であり、ペットケアやホームサービス、ウェルネス、教育関連の業種が含まれる。2026年8月にこの第1陣の移行が始まり、同年後半に米国内の対象が拡大される見込みだ。
米国以外のアカウントや残りの業種については2027年に対応が進む。アカウント管理者には移行の14日前と7日前に通知が届き、移行完了時にも確認の連絡があるため、突然ダッシュボードが使えなくなる事態は避けられる。
管理フローの一元化によって作業負荷は減る一方で、従来のLSA専用画面に慣れた事業者や代理店には操作変更への対応が求められる。
新しいLSAキャンペーンの仕組み
統合後のLSAは、Google広告のP-MAX(Performance Max)キャンペーンとして配信される。ただし名称こそP-MAXだが、配信面や課金方式は従来のLSAと変わらない点に注意が必要だ。
配信面と課金方式は変更なし
LSAは今後もキーワードの入札なしで、Google検索とマップにのみ表示される。クリック課金ではなく、電話、メッセージ、予約といった有効リードに対して料金が発生する仕組みも維持される。P-MAXと聞くとディスプレイ広告や動画広告まで配信対象が広がるイメージがあるが、LSAの場合はあくまで検索とマップに限定される形だ。
Google広告内で完結するキャンペーン管理
広告主はGoogle広告の管理画面でLSAキャンペーンの設定、リードの確認、返信をすべて行えるようになる。従来のLSA専用ダッシュボードは移行後に利用できなくなるため、操作に不慣れな場合は早めにGoogle広告の画面構成を確認しておくとスムーズだ。
キャンペーン管理で変わる5つのポイント
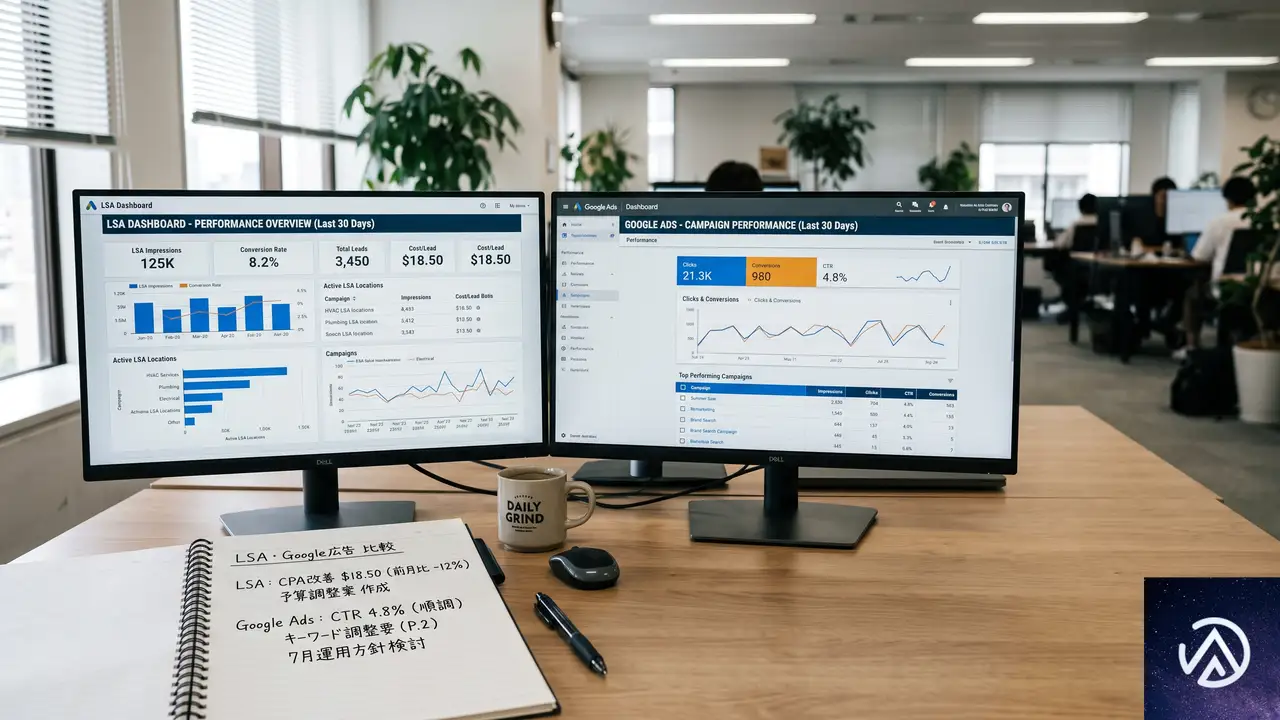
統合に伴い、予算の考え方や入札、レポートの扱いが一部変更される。Search Engine Journalの記事で挙げられた主な変更点を整理する。
予算は週単位から日単位へ
従来のLSAは週平均の予算で運用されていたが、移行後はGoogle広告の他のキャンペーンと同様に日額予算での管理に変わる。1日あたりの支出上限が設定されるため、週単位のざっくりした予算配分からより細かい調整が必要になる。
手動入札が廃止され目標CPAがキャンペーン単位に
これまで一部の広告主は「リード1件あたりの上限単価」を手動で設定できたが、この機能は使えなくなる。代わりに、Googleが算出するキャンペーン単位の目標CPA(リード獲得単価の目標値)が適用される。
サービスカテゴリごとに異なる目標CPAを設定することもできなくなる。たとえば配管工事と空調工事の両方を1つのキャンペーンで広告している事業者の場合、双方のリードコスト差にかかわらず1つの目標CPAに統一される。この点は業種によって影響が大きいため、キャンペーン分割の要否を検討する必要がある。
ビジネス情報はGBPと自動同期
事業者名や住所、営業時間といった基本情報はGBP(Google Business Profile / グーグルビジネスプロフィール)から自動で同期される。これまではLSAとGBPで別々に情報を更新する手間があったが、統合により片方だけ変更するリスクは減る。ただし、大幅な名前や住所の変更を行うと24〜48時間の確認プロセスが入り、キャンペーンが一時停止する可能性がある。
レポートとリード管理の拠点が切り替わる
過去のパフォーマンスレポートはGoogle広告に引き継がれない。リードの履歴は移行されるものの、レポートデータへのアクセスは移行完了と同時に失われる。年度比較や顧客報告に必要なデータは事前にダウンロードしておくことが必須だ。リード対応についても、Google広告内のLead Manager(リード管理画面)に切り替わる。
広告主が移行前後に取るべき対策
移行をスムーズに進めるために、広告主や代理店が今から着手できる準備を整理する。移行の通知を受け取ってから慌てないよう、以下の2点を押さえておきたい。
履歴レポートのダウンロードを最優先に
最も重要なのは、LSAダッシュボードに保存されている過去のパフォーマンスデータをエクスポートすることだ。移行後はレポート画面自体がなくなるため、後から取り出すことはできない。
複数アカウントを管理する代理店は、通知を受け取る前にバックアップ作業を始めておくと安全だ。前年比較レポートを作る予定のある事業者も、今のうちに必要な期間のデータを保存しておくことを推奨する。
移行後の設定を丁寧に確認する
Googleがキャンペーン設定を自動で移行するが、広告主自身で以下の項目を再確認すべきである。
- 日額予算が事業計画と合っているか
- キャンペーン単位の目標CPAが過去のリード単価と大きく乖離していないか
- サービスカテゴリや配信地域が正しく設定されているか
- 広告スケジュールが想定通りか
- リード転送先の電話番号や写真、訴求文に誤りがないか
事業者名や住所に大きな変更があると、前述の通り審査が入りキャンペーンが止まる可能性がある。配信再開までに数日かかるケースもあるため、移行直後の大口変更は避けたほうが無難だ。
Googleは移行後すぐに広告が表示される場合もあるとしているが、パフォーマンスが安定するまで最大2週間をみておく必要がある。
統合がもたらす影響と今後の見通し
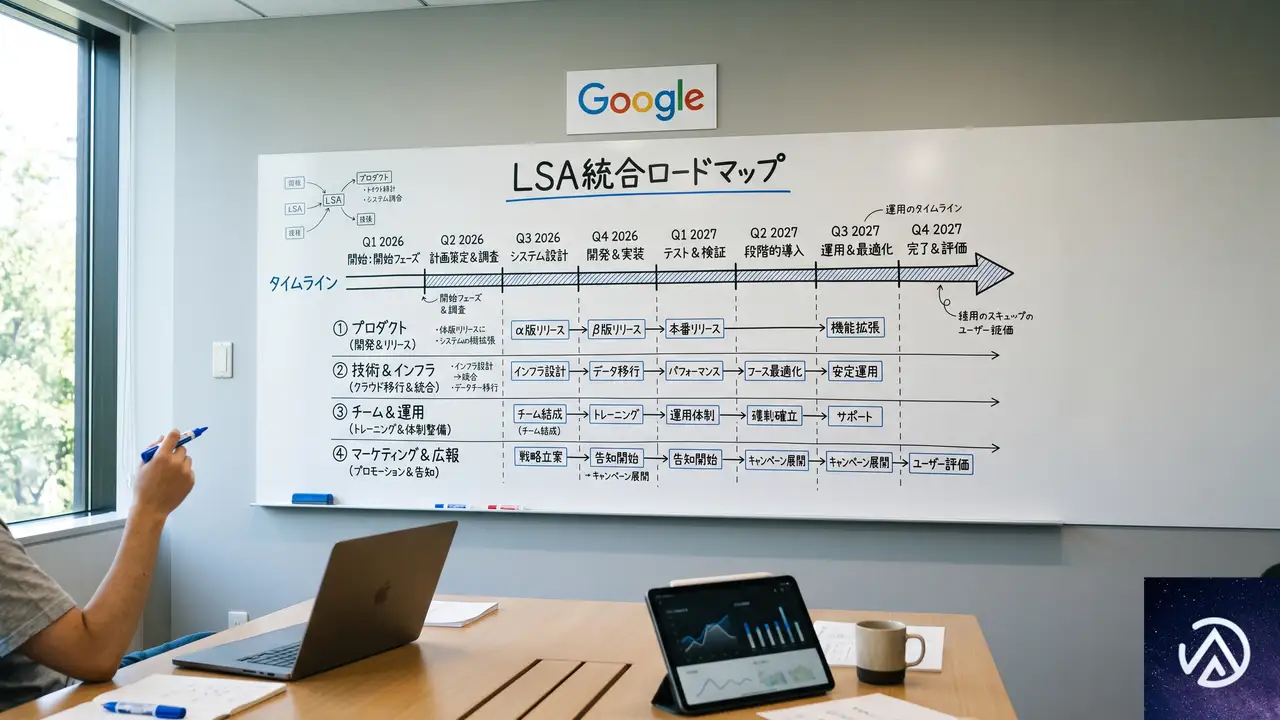
今回の統合の最大の焦点は、カテゴリ別の目標CPAが廃止される点にある。リード単価の大きく異なる複数サービスを1つのキャンペーンで運用してきた事業者は、キャンペーンを分割するか、まとめたまま自動入札に任せるかの判断を迫られる。
分割すれば入札のコントロールは細かくなるが、各キャンペーンのコンバージョンデータが少なくなり、Googleの自動最適化が働きにくくなる面もある。リード数の多い事業者は分割、まだボリュームの少ない事業者は統合したまま様子を見るという選択肢が現実的だ。
初期移行グループの状況を見ながら、Googleは追加のガイダンスを出すとみられる。とくに日本国内の広告主が対象となるのは2027年以降と見込まれるため、まずは米国の事例を参考にしつつ、自社のLSAデータを整理しておくのが賢明だろう。
この記事のポイント
- LSAの管理画面が2026年8月からGoogle広告に統合される
- 配信面とリード課金の仕組みは変わらないが、予算管理や入札方式が変更される
- カテゴリ別目標CPAの廃止が事業者に与える影響は大きく、キャンペーン分割の要否を検討する必要がある
- 過去レポートは移行前に必ずダウンロードしておくこと
- 日本国内の移行は2027年以降の見込みだが、今からデータ整理を始めておくとよい
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google、匿名化検索データを競合と共有へ EUのDMA決定の全容
EUの欧州委員会が2026年7月16日、Googleに対して2つの拘束力のある決定を下した。検索データを匿名化した上で競合他社と共有すること、そしてAndroidの一部機能を競合AIアシスタントに開放することだ。いずれもデジタル市場法(DMA)に基づく措置である。
この決定の影響は検索エンジンにとどまらない。AIチャットボットも対象に含まれており、検索とAIが融合しつつある現在の状況において、今後の競争環境を左右する転換点となる可能性が高い。
DMAに基づく2つの決定の全体像
今回の決定は、欧州委員会が2026年4月に公開協議を経て暫定的な見解を示していたものを最終化した形だ。2つの柱で構成されている。
- 検索データの共有義務。Googleの検索結果に関するクエリ、クリック、閲覧、ランキング位置の匿名化データを、公正かつ非差別的な条件で競合に提供すること
- AndroidのAI相互運用性の確保。競合AIアシスタントが音声起動やアプリ内操作を実行できるよう、OSレベルの機能を開放すること
違反時の罰金を伴う独占禁止法の案件とは異なり、DMAに基づく今回の措置は構造的な是正を目的とする。欧州委員会は、Googleの現在のデータ共有の取り組みは不十分だと明確に指摘している。
この図で示した通り、データ共有の枠組みが整うことで、競合検索エンジンやAIチャットボットはGoogleが長年かけて蓄積してきた規模の検索インタラクションデータを活用できるようになる。
検索データ共有の具体的な仕組みと対象範囲
共有されるデータの内容
共有対象となるのは、Google検索の無料・有料を問わずすべての検索結果から生成される匿名化データである。具体的には以下の情報が含まれる。
- 検索クエリ(ユーザーが入力した検索語句)
- メタデータ(使用言語、デバイスの種類)
- 表示されたURL一覧
- ユーザーのクリックや閲覧といったインタラクション情報
- 検索結果内での表示位置(ランキング)
一方で、Googleのランキングアルゴリズムそのものは共有対象外だ。また個人を特定できる情報(アカウント詳細、検索履歴、タイムスタンプ、極端に稀または長大なクエリ)は除外される。
利用資格と審査プロセス
このデータを利用できるのは誰でもない。欧州委員会が定めた要件を満たす必要がある。
- EU圏内で月間5万人以上のユーザーを持つこと
- 2年以上の事業運営実績があること。新規参入企業の場合は投資実績による代替審査を受けること
- セキュリティ審査と独立監査を通過すること
これらの条件をクリアした事業者のみが、Googleとライセンス契約を結びデータの提供を受けることができる。データ価格は市場レートではなくコスト回収ベースで算定される。
AIチャットボットについても、DMA上でオンライン検索エンジンと見なされるものは利用資格がある。ただしデータの用途は、自社の検索・ランキングシステムの改善に限定され、汎用AIモデルの学習やGoogleの検索結果の複製には使用できない。
AI検索時代におけるデータの重要性
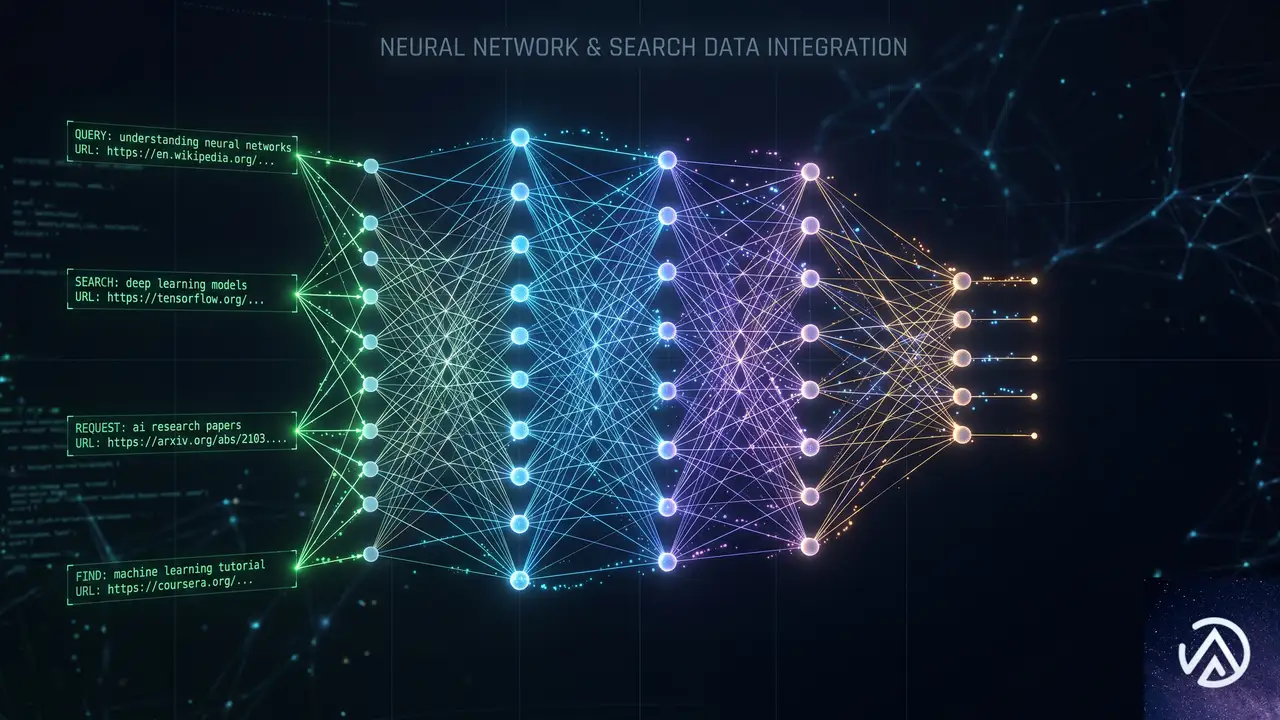
この決定が単なる検索エンジン間の競争を超えた意味を持つのは、AIチャットボットが回答を生成する仕組みと深く関わるからだ。
グラウンディングと検索データ
AIチャットボットが正確な回答を返すためには「グラウンディング(事実確認のための根拠付け)」と呼ばれるプロセスが欠かせない。最新のWebデータを参照し、回答の確からしさを検証する仕組みだ。
Googleは自社のAIに対して「FastSearch」というシステムでグラウンディングを行っている。これはGoogle自身の検索ランキング信号に依存する仕組みであり、当然ながら競合には提供されていなかった。
今回の決定で共有される匿名化データ(クエリ、クリック、閲覧、結果位置)は、競合各社が独自の情報検索・ランキングシステムを構築するための材料となる。グラウンディングもこの用途の一つとして認められている。
検索トラフィックへの影響は限定的か
短期的に見れば、Webサイト運営者が感じるトラフィックへの影響は限定的だろう。SE Rankingのデータによると、2026年1月時点で全AIプラットフォームを合わせた紹介トラフィックは、世界のインターネットトラフィック全体の約0.24%に過ぎない。
データへのアクセスが改善されれば競合エンジンやチャットボットの開発が進む可能性はあるが、それだけでユーザーの検索行動が一気に変わるわけではない。重要なのは、このデータを実際に製品開発に活かせるかどうかだ。
AndroidのAIアシスタント開放
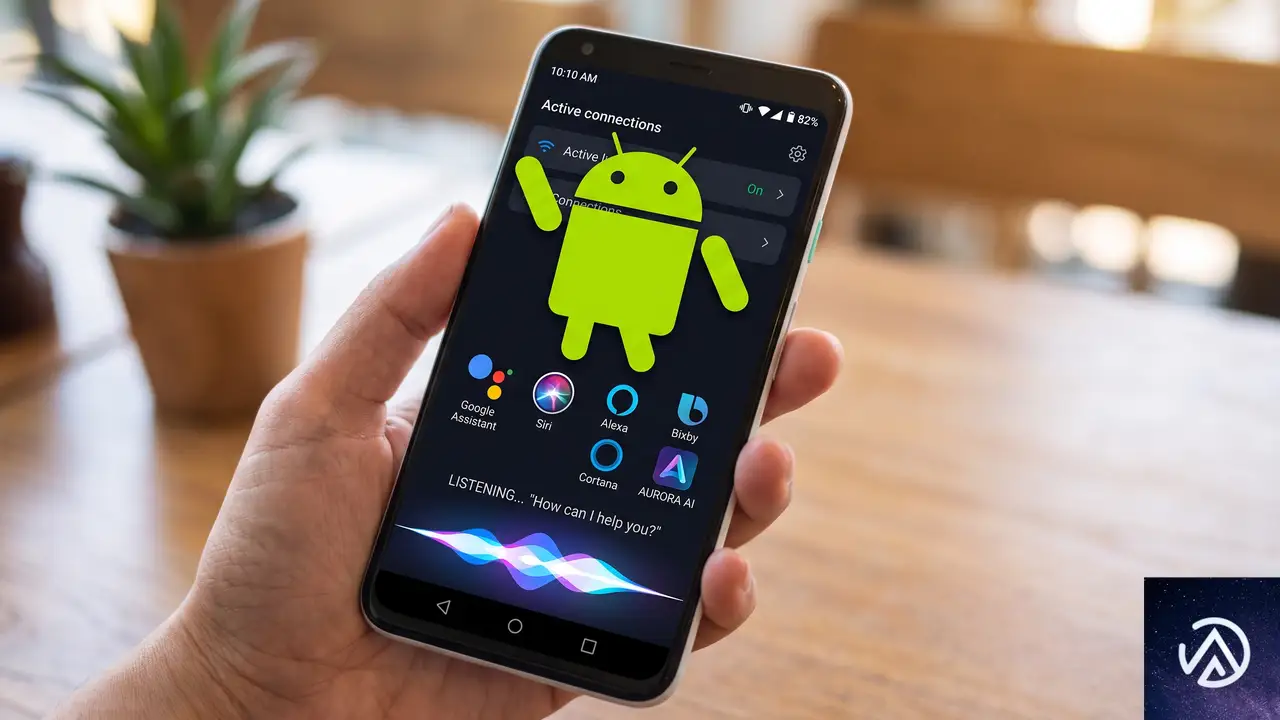
2つ目の決定はAndroidに関するものだ。GoogleはOSレベルの機能を競合AIアシスタントに開放する義務を負う。
- ユーザーが「Hey Google」のような音声コマンドで競合アシスタントを起動できるようにすること
- 競合アシスタントがアプリ内で動作し、タクシーの予約や返信文の作成といった操作を実行できるようにすること
Google自身のGeminiアシスタントはすでにこのレベルのアクセス権を持っている。今回の決定はこの非対称性を是正するものだ。
主な機能の実装期限は次期メジャーリリースのAndroid 18、遅くとも2027年8月1日までとされている。複数のアシスタントが異なるウェイクワードで同時応答できる機能にはさらに1年の猶予が与えられ、2028年8月1日が期限となる。
Googleの反応とプライバシーをめぐる議論
Googleは両方の決定に反対の立場をとっている。Alphabetのグローバル問題担当プレジデントであるKent Walker氏は公式ブログで、「数百万人の欧州市民にとって不可欠なプライバシーとセキュリティの防御線を損なうリスクがある」と表明した。
同氏はまた、GoogleがDMAの目的に沿った解決策を繰り返し提案してきたことも強調している。検索データの共有については、適切な匿名化やユーザーの知識・同意なしに、欧州の検索データが見知らぬ企業に開示されることへの懸念を示した。
これに対し欧州委員会は、匿名化のプロセスが多層的な技術処理と契約上の保護措置で構成されており、内部および外部のプライバシー専門家の関与のもとで開発されていると説明する。Googleはデータ共有前にサイバーセキュリティやデータ保護の基準に基づいて申請者を審査できる。独立したテストで保護措置が不十分と判明した場合は、措置の見直しも可能だ。
今後の展開とスケジュール
2026年後半は、Googleがデータセットの整備と提供条件の策定に費やす期間となる。価格提案の期限は遅くとも2027年1月だ。各事業者はライセンス契約と価格合意を経て、それぞれのスケジュールでデータ提供を受けることになる。
Android側の主な変更は2027年8月1日、複数アシスタントの同時音声起動は2028年8月1日が期限だ。欧州委員会はこれらの措置を2年ごとに見直し、匿名化が不十分と判断されれば再検討を行うとしている。
この決定が実際に検索エンジンやAIチャットボットの多様化を促すかどうかは、資格審査を通過する事業者の顔ぶれと、提供されたデータをどれだけ製品開発に活かせるかにかかっている。すぐに目に見える変化はないが、中長期的には検索とAIの競争環境を変える可能性を秘めた決定と言えるだろう。
この記事のポイント
- EU欧州委員会がDMAに基づき、Googleに匿名化検索データの共有とAndroidのAIアシスタント開放を義務付ける決定を下した
- 共有対象はクエリ・クリック・閲覧・結果位置のデータで、ランキングアルゴリズム自体は対象外。AIチャットボットも利用資格あり
- Googleはプライバシーとセキュリティへの懸念を表明しているが、欧州委員会は多層的な匿名化と審査プロセスで対応
- 短期的な影響は限定的だが、中長期的には検索とAIの競争環境に変化をもたらす可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google NotebookLMがGemini Notebookに改称、AIスクレイピング対策の緊急対応
Googleが研究支援ツールNotebookLMをGemini Notebookに改称した。実体は同じだが、このタイミングでユーザーエージェントの表記が「Google-NotebookLM」から「Google-GeminiNotebook」に変更される。旧ユーザーエージェントは2026年8月をもって廃止されるため、サイト運営者は数週間のうちにスクレイピング対策の見直しを迫られている。
今回の変更は単なる名称の刷新にとどまらず、AIによる自動コンテンツ収集と再利用のリスクを改めて浮き彫りにする。本記事では、Gemini Notebookのスクレイピング機能の実態、robots.txtを無視するユーザートリガー型フェッチャーの仕組み、そして具体的なブロック手法を簡潔にまとめる。
NotebookLMがGemini Notebookに改称、機能は変わらず
名前変更の背景と影響
2026年7月18日、Googleはユーザートリガー型フェッチャーのドキュメントを更新し、NotebookLMをGemini Notebookに置き換えた。ブランド統合の一環であり、既存のNotebookLMユーザーにとって使い勝手に違いは生じない。
しかし、サイト運営者にとって重大なのは、旧ユーザーエージェント「Google-NotebookLM」が2026年8月で無効になる点だ。ファイアウォールや.htaccessにこの文字列を直書きしている場合、猶予期間内に新しいユーザーエージェントへ切り替えなければ、ブロックが機能しなくなる。
Gemini Notebookの主な機能
Gemini Notebookは、ユーザーが提供した文書やURLを「グランドトゥルース(信頼できる基盤情報)」として扱い、AIが調査や学習を支援するマルチモーダルツールだ。YouTubeの動画や音声ファイルを取り込んで分析することも、逆にアップロードされた資料を音声ポッドキャストや動画解説に変換することもできる。
この「資料をもとに新しいコンテンツを自動生成する」という特徴が、後述するスクレイピング問題の根本にある。生成された音声や動画がオンラインで公開されれば、元の記事と直接競合する可能性があるからだ。
Gemini Notebookが引き起こすスクレイピング問題
Discover Sourcesによる自動スクレイピング
Gemini Notebookの「Discover Sources」機能は、ユーザーが設定したクエリやテーマに沿って最大10件のオンライン記事を自動で収集し、AI要約を生成する。問題は、サイト所有者の許可を一切取らずにクローリングが行われ、参照元へのリンクも一切発生しない点だ。
従来の検索エンジンであれば、クローラーが収集した情報は検索結果としてユーザーをサイトへ誘導する。しかしGemini Notebookの要約はクローズドな環境で完結し、トラフィックの恩恵は元サイトに還元されない。SEOの観点からは、コンテンツが無断で「搾取」される構造といえる。
音声・動画コンテンツの自動生成と競合
さらに、アップロードした資料からポッドキャストや動画解説を生成できる点も看過できない。仮に自社サイトの記事が材料に使われ、第三者が公開すれば、同一テーマでオリジナルと競合する二次コンテンツが無数に生まれる危険がある。
Googleのドキュメント上、これらは「ユーザー調査のための機能」と位置づけられているが、実質的には許可なきスクレイピングとリパーパス(再利用)を自動化する仕組みにほかならない。コンテンツを資産とするウェブサイト運営者にとって、対策は急務だ。
緊急対応すべきブロック手法
ユーザートリガー型フェッチャーとは
Gemini Notebookのクローラーは「ユーザートリガー型フェッチャー」に分類される。これは、ユーザーが明示的に指示(URL貼り付けやDiscover Sourcesの実行)をトリガーとして起動するため、robots.txtの指示に従わない。robots.txtはあくまで紳士協定であり、一般的なクローラーは自発的に従うが、ユーザートリガー型には適用されないのだ。
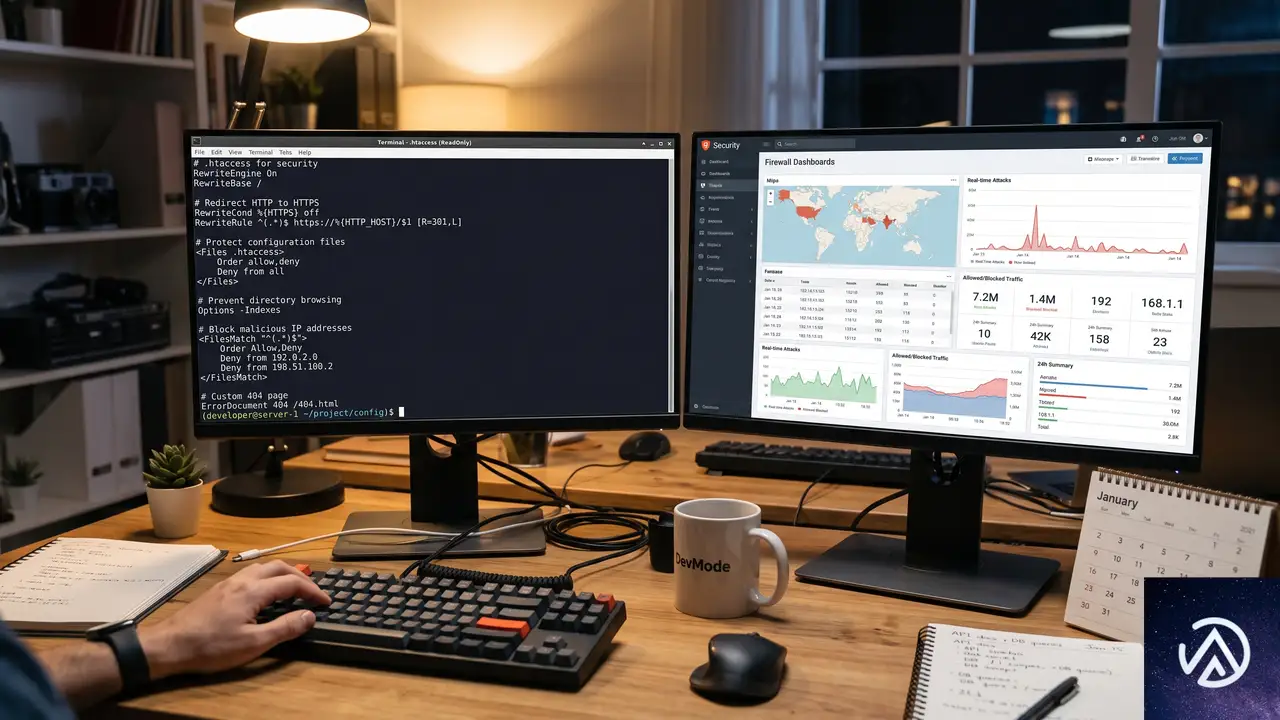
ただし、robots.txtが効かないからといって手立てがないわけではない。サーバー側でHTTPリクエストのユーザーエージェント文字列を検査し、該当するアクセスを拒否することは可能である。
.htaccessによる具体的なブロック例
多くのレンタルサーバーで使えるApache環境であれば、.htaccessに以下のルールを追記するだけでGemini Notebookのアクセスを遮断できる。
RewriteEngine On

# Gemini Notebookのユーザーエージェントをブロック
RewriteCond %{HTTP_USER_AGENT} Google-GeminiNotebook [NC]
RewriteRule ^ - [F,L]
この設定により、該当のユーザーエージェントを含むすべてのリクエストに対して「403 Forbidden」が返される。Nginxを利用している場合は、if ($http_user_agent ~* "Google-GeminiNotebook") { return 403; } のような記述で同様の制御が可能だ。
重要なのは、新旧両方のユーザーエージェントをカバーするか、あるいは直ちに新UAのみに移行することである。2026年8月以降、旧UAはGoogle側で廃止されるが、それまでにサイト側のルールを更新しておかなければ、一時的にブロックがすり抜けるリスクが生じる。
旧ユーザーエージェントの猶予期間と注意点
Googleはドキュメント内で、旧ユーザーエージェント「Google-NotebookLM」を2026年8月までサポートすると明記している。ハードコードしているサイト運営者は、この期間内に新しい文字列へ切り替える必要がある。
なお、合わせて「Project Mariner」に関する記述がドキュメントから完全に削除された。同プロジェクトは2026年5月に終了しており、混乱を避ける意味でも、ユーザーエージェント周辺の情報は最新版を参照すべきである。
この記事のポイント
- NotebookLMはGemini Notebookに改称され、ユーザーエージェントが変更された
- Discover Sources機能が許可なく記事を収集し、AI要約や音声コンテンツを生成する
- ユーザートリガー型フェッチャーはrobots.txtを無視するが、ファイアウォールや.htaccessでブロック可能
- 旧UA「Google-NotebookLM」は2026年8月に廃止、既存のルールを直ちに更新する必要がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google AI OverviewsにTop Stories表示、米国モバイルで本格展開
Google AI Overviewsにニュース表示機能が本格実装、Top Storiesが米国モバイルで展開開始
Googleが2026年7月中旬、検索結果のAI Overviews内にニュースとTop Storiesを表示する機能の本格展開を開始した。米国モバイルユーザー向けに完全展開されており、今後対象地域が拡大される見込みだ。
この機能は2026年5月にGoogleが発表した「AI Overviewsにおける新鮮な視点、最新情報、目立つリンク」構想の一環として導入された。発展中のトピックに関する質問に対し、タイムリーな記事をより目立つ形で表示するキャッセル形式を採用する。
Googleの広報担当者はこの展開が米国モバイル向けに完全にライブであることを確認している。AI OverviewsとAI Modeといった検索機能からサイトへのトラフィックが増加する可能性を示す重要なアップデートといえる。
AI OverviewsのTop Stories表示とは、何が変わるのか
これまでAI Overviewsは主にGoogleが収集した知識グラフや静的コンテンツから回答を生成していた。そこにニュースや最新情報のカルーセルが統合されたことで、リアルタイム性の高い情報がAI生成回答と並列で表示されるようになった。
表示の仕組み、カルーセル形式でニュースを可視化
AI Overviewsのセクション内に、水平スクロール可能なカルーセルとしてニュース記事が表示される。各項目にはニュースメディア名、見出し、アイキャッチ画像が含まれ、ユーザーは回答文に加えてリアルタイムの情報をワンタップで確認できる。
このカルーセルは「Preferred Sources」と呼ばれる、Googleが信頼性を評価したソースを優先的に表示する仕組みと連動する。ニュースメディアにとっては、検索結果ページ内での露出機会を大幅に拡大するチャンスとなる。
Preferred Sourcesの影響力がさらに拡大
Googleは2026年5月の発表時に、Preferred Sourcesをニュースカルーセルでも優先表示すると明言していた。今回の本格展開により、Googleに信頼できる情報源として認識されるメディアは、AI Overviews経由のトラフィックをより多く獲得できる環境が整った。
この仕組みは単なるアルゴリズム評価だけでなく、メディア側のE-E-A-T(経験、専門性、権威性、信頼性)をより重視する検索エコシステムへの移行を加速させる。検索結果の質を担保しつつ、タイムリーなニュースを適切に届けるための設計といえる。
AI Overviews経由のクリック、メディアへのトラフィック増加が期待される
Googleは2026年7月、AI検索機能がウェブサイトに毎週数十億回のクリックを送っていると発表した。AI OverviewsやAI Modeを含むこれらの機能は、従来の検索結果とは異なる経路でユーザーをオンラインコンテンツに誘導する役割を果たす。
AI検索とトラフィックの関係、新しい導線設計
AI Overviews内のニュースカルーセルは、従来の検索結果よりも目立つ位置に配置される。テキスト回答の直下または横に表示されるため、スクロールなしでニュース記事にアクセスできる。これは単なるクリック率向上にとどまらず、発展中のニューストピックにおける情報鮮度と発信者評価を結びつける設計だ。
AI Modeとの統合がもたらす波及効果
AI ModeはGoogleが提供するAI専用の検索モードで、会話形式の対話と情報探索を組み合わせた機能だ。Top Stories表示はAI OverviewsだけでなくAI Mode内でも有効であり、ユーザーが対話的にニュースを掘り下げる際にもメディアの記事が提示される。
これにより、キーワード検索だけに依存しない多層的な導線が形成される。ユーザーが自然言語で質問を重ねるたびに新たなニュースが表示される可能性があり、メディアにとってはAI検索最適化が新たなSEO領域として重要性を増す。
ニュースメディアのSEO戦略、AI Overviews対応が急務に
AI OverviewsにTop Storiesが統合されたことで、メディアのSEO戦略は新たな段階に入った。従来のテキスト検索向け最適化に加え、AI Overviews内で優先表示されるための対策を講じる必要性が高まっている。
Preferred Sourcesとしての評価を高める施策
Googleが示すPreferred Sourcesの評価基準は完全には公開されていないが、一般的にE-E-A-Tが重視されることは明白だ。メディアは記事の正確性、著者の専門性、サイト全体の信頼性を継続的に向上させる必要がある。
- 著者情報の充実 執筆者の経歴、専門分野、過去の実績を明確に提示する
- 事実確認のプロセス可視化 情報源の明示、訂正ポリシーの公開、編集基準の提示
- 構造化データの適切な実装 NewsArticle、Article、Authorなどのスキーマを正確にマークアップする
- サイト全体のページ速度とモバイル対応 コアウェブバイタルの基準を満たし、ユーザー体験を最適化する
AI可視性を高めるコンテンツ戦略
AI Overviewsで表示されるためには、GoogleのAIが質問の意図を理解し、回答の情報源として適切と判断するコンテンツ設計が求められる。具体的には、明確な見出し構造、簡潔な要約文、信頼性の高い統計データの提示が有効だ。
今後の展開と検索エコシステムへの影響
現時点では米国モバイルユーザー向けに限定されているが、Googleは今後デスクトップや他地域への拡大を示唆している。AI Overviewsの機能拡張は段階的に行われるため、日本のメディア関係者も早期の準備が重要だ。
Googleの継続的なAI検索改善とメディアの対応
Search Engine Landの記事によれば、GoogleはAI検索機能からオープンウェブへのクリックを改善する方針を継続している。Top Stories表示はその一環であり、検索とメディアの関係を再構築する取り組みと位置づけられる。
メディア企業はAI Overviewsでの表示を単なるトラフィック獲得手段としてだけでなく、コンテンツの質と信頼性を問われる新たな評価指標として捉えるべきだ。AI検索時代のSEOは、キーワード密度や被リンク数から、情報の正確性と権威性の証明へと重心を移している。
この記事のポイント
- Google AI OverviewsにTop Stories表示機能が米国モバイル向けに本格実装された
- ニュースカルーセルはPreferred Sourcesを優先表示し、メディアのAI可視性を高める
- AI検索機能はサイトに週数十億回のクリックを送り、新たなトラフィック導線を形成
- メディアのSEO戦略はE-E-A-T強化と構造化データ実装によるAI Overviews対応が急務
- AI Overviews展開は他地域やデスクトップにも拡大予定で、早期の対策準備が重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google、悪質な住宅用プロキシネットワークNetNutを継続的に破壊
NetNutとは何か、住宅用プロキシの仕組み

今回Googleが措置を取ったNetNut(別名Popa)は、世界最大級の住宅用プロキシネットワークだ。住宅用プロキシとは、一般家庭が契約するISP(インターネットサービスプロバイダ)のIPアドレスを経由してトラフィックを中継する仕組みである。大規模なボットネットによって実現され、NetNutは少なくとも200万台のデバイスを出口ノードとして抱えていたと見られている。
住宅用プロキシの大きな特徴は、一見すると正当な住宅回線からの通信に見える点だ。攻撃者はこの特性を悪用し、実際の位置や身元を隠蔽する。データセンター経由のプロキシとは異なり、ブラックリストに載りにくいため、アカウント不正アクセスやパスワードスプレー攻撃などに利用される。
■ 家庭のデバイスが踏み台にされる
Google Threat Intelligence Group(GTIG)の推計によると、NetNutには世界で200万台以上のデバイスが接続されていた。このボットネットは主にスマートテレビやストリーミングボックスなど、家庭に常時設置されるデバイスに潜むSDKを通じて構築される。KrebsOnSecurityの報道やGoogle自身の調査により、NetNutがこうしたデバイスを悪用してプロキシネットワークを肥大化させていた実態が明らかになっている。
Googleが取った具体的な対策とその効果

Googleは2026年7月2日、FBIやLumenなどのパートナーと連携し、NetNutの運営基盤に対して以下の施策を実施した。
Googleアカウントとサービスの無効化
NetNutがマルウェアのC2(コマンド&コントロール)に使用していたGoogleアカウントと関連サービスを、利用規約違反として無効化した。これにより、攻撃者がボットネットを制御する主要な通信路が遮断された。
技術情報の共有とエコシステム全体への働きかけ
NetNutが利用していたSDKやバックエンドのC2インフラに関する技術情報を、プラットフォーム事業者や法執行機関、研究機関と共有した。この情報に基づき、各組織が同様のネットワークを監視・遮断できるようになり、より広範な防御が可能になった。
Google Play Protectによる自動防御
Androidの組み込みセキュリティ機能であるGoogle Play Protectが、NetNutのSDKを組み込んだアプリを検出し、ユーザーに警告を発するとともに自動で無効化する措置を取った。今後も新たなインストール試行に対して保護を継続する。これによって、一般ユーザーが意図せずボットネットの一部になるリスクが大幅に低減された。
これらの連携措置により、NetNutのプロキシネットワークから数百万台のデバイスが切り離され、可用性が著しく低下した。NetNutにはホワイトラベル(再販)プログラムも存在し、多くの有名住宅用プロキシブランドが実態としてNetNutのボットネットを利用していたことが分かっている。そのため、今回の措置はプロキシ業界全体に波及効果をもたらすと見られている。
ただしGTIGは、過去のIPIDEAネットワークの事例から、個別のネットワークが一見復元力を持つように見えることもあると指摘している。プロキシ事業者は自前のボットネットが弱体化すると競合からキャパシティを購入し、事実上の再販業者に転じる傾向がある。持続的な抑止には、複数の相互接続されたネットワークを同時に標的とするスケールした取り組みが不可欠だ。
なぜ住宅用プロキシがここまで危険なのか

NetNutのような住宅用プロキシは、攻撃者にとって理想的な隠れ蓑になる。2026年6月の1週間だけでも、GTIGはNetNutの出口ノードを疑われるIPから316もの異なる脅威クラスタを観測した。これにはサイバー犯罪グループだけでなく、国家支援が疑われるスパイ活動グループも含まれていた。
デバイス所有者への直接的な被害
感染したデバイスが出口ノードになると、その家庭のIPアドレスから不正な通信が行われる。最悪の場合、同じホームネットワーク内の他のプライベートデバイスにもアクセスされ、外部の脅威に晒される。ユーザーが気付かないうちに自宅の回線が犯罪に利用され、プロバイダからフラグを立てられ通信を制限されるなどの二次被害も発生する。
大規模DDoS攻撃の踏み台としての利用
SynthientやSpur、Nokia Deepfieldなどの公開レポートによれば、NetNutのインフラはMirai亜種などのDDoSボットネットにデバイスを感染させる経路としても使われていた。住宅用プロキシは単なる匿名化ツールにとどまらず、より破壊的なサイバー攻撃の温床になっている。
正規の住宅IPに見えるため、ログイン試行のブロックを回避
出口ノード化したデバイス経由で同一LAN内の機器にアクセス
多数の住宅デバイスから一斉にトラフィックを送り標的を圧迫
ISPに不正通信として検知され、正規の通信がブロックされる可能性
こうしたリスクは、一般消費者のデバイスが知らぬ間に犯罪インフラの一部と化す構造的な問題だ。「無料VPN」や「帯域を共有するだけで報酬」といった甘い言葉でインストールを促すアプリが、実は住宅用プロキシのSDKを仕込んでいるケースが後を絶たない。
一般消費者が今すぐ取るべき3つの対策

NetNutのような脅威から自分や家族のデバイスを守るために、以下の点に注意したい。
「未使用の帯域を共有する」アプリを警戒する
「帯域を貸すだけで収入が得られる」とうたうアプリは、悪質なプロキシネットワークへの参加を促す典型的な手口だ。こうしたソフトウェアは、意図せず自宅のIPを犯罪者に貸し出す結果になる。Googleは公式アプリストアの利用と、サードパーティVPNやプロキシの権限を厳格に確認するよう呼びかけている。
Google Play Protectを有効に保つ
Androidスマートフォンやテレビデバイスでは、Play Protectが自動的にNetNut関連の不正アプリを検出・無効化する。設定から保護機能が有効になっているか確認することが第一歩だ。Play Protect認証を受けていないデバイスは、セットトップボックスなどでも注意が必要だ。
信頼できるメーカーのデバイスを選ぶ
特にスマートテレビやストリーミング端末を購入する際は、公式のAndroid TV OSを搭載し、Play Protect認証を受けているかどうかを確認すべきだ。Android TVの公式サイトではパートナーメーカーの最新リストが公開されており、購入前のチェックに役立つ。
今後の展望と持続的な対策の必要性

今回のNetNut無効化は、2026年1月のIPIDEAネットワーク対策に続くGoogleの断固たる意思表示だ。しかし住宅用プロキシ業界は急速に拡大しており、単発の措置だけでは長期的な解決にならない。事業者同士がボットネットを再販し合う流動的なエコシステムでは、1つのネットワークを潰しても別のネットワークがカバーする。
GTIGも認めるように、持続的な抑止には複数の主要プロバイダのインフラを同時に標的とし、モバイルプラットフォーム、ISP、テクノロジー企業が継続的に情報を共有し、悪意あるC2サーバーをブロックする取り組みが必要だ。Googleは「業界全体の協調努力なくして根本的な解決は難しい」との立場を明確にしている。
我々一般消費者も、知らぬ間にサイバー攻撃の一端を担わされないよう、デバイスの購入元とアプリの権限に対して常に敏感でありたい。技術的な防御だけでなく、ユーザーリテラシーの向上が、悪質な住宅用プロキシの成長を鈍化させる最後の砦になる。
■ 技術的対策の要(プラットフォーム)
■ 法執行・インフラレベルでの遮断
Googleはこの発表の中で、同様の取り組みを加速させる意向を示しており、今後の脅威インテリジェンス共有の枠組みがさらに重要になるだろう。
この記事のポイント
- GoogleがNetNut(Popa)と呼ばれる世界最大級の住宅用プロキシネットワークをFBIなどと協力して無効化
- アカウント無効、SDK情報共有、Play Protectによる自動防御で数百万台のデバイスをネットワークから切り離し
- 住宅用プロキシは一般家庭のデバイスを踏み台にし、アカウント乗っ取りやDDoS攻撃の温床に
- 消費者は「未使用帯域の共有」アプリを避け、Play Protectの有効化や信頼できるデバイス選びが重要
- 業界全体での継続的な情報共有と協調した遮断が、長期的な対策には不可欠
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleが6月スパムアップデート公開、AI応答の操作もスパム対象に
Googleは2026年6月24日、新しいスパムアップデートの展開を開始した。今回のアップデートでは、生成AIの応答を意図的に操作しようとする行為もスパムポリシー違反とみなされることが明確化された。
同時期に、サーチコンソールのAIレポートにおけるインプレッションの数え方について新たな情報が公開された。また、Advanced Web Rankingの調査ではデスクトップのCTRが上昇する一方、モバイルのトップポジションでクリック率が低下していることが判明。Similarwebのレポートからは、AIの推奨がブランド検索を経由してサイト訪問につながる構図が浮かび上がった。
この記事では、これらの動きを一つひとつ整理し、今後のSEO戦略にどう活かすかの視点を提供する。
AI応答の操作行為もスパムポリシーの対象に
6月24日より展開が始まったスパムアップデートは、従来のリンクスパムやキーワードスタッフィングのような旧来型の不正だけでなく、AI OverviewsやAI Modeといった生成AI検索機能に対する操作行為にも範囲を拡大した。
Googleは2026年5月にスパムポリシーを改定し、生成AIの回答に表示される引用やリンクを不正に購入する行為、情報を書き換える行為がスパムに該当すると明示していた。今回のアップデートはその方針に沿ったアルゴリズムの強化にあたる。
ランキング変動への向き合い方
スパムアップデートは数日かけて完全に適用されるため、ランキングの上下が一過性のものかそうでないかを見極める必要がある。突然順位が下がったとしても、それだけでコンテンツが「質の低いスパム」と判定されたわけではない。
SEOコンサルタントのShushrita M.氏は、変動が起きた際にはまず影響を受けたページタイプやクエリ、ディレクトリを特定し、一貫したパターンを見つけることが回復への第一歩だと指摘している。パニックに陥らず、データに基づいた診断を進める姿勢が求められる。
AIインプレッションはリンクの表示回数、クリックデータはまだない
サーチコンソールの生成AIレポートで示されるインプレッションは、AI OverviewsやAI Modeの中で自社ページへのリンクが表示された回数を指す。ただし、回答内で折りたたまれているリンクは、ユーザーが開かない限りカウントされない仕組みである。
Googleのサーチ アドボケートJohn Mueller氏が明らかにしたところによると、現時点ではこのレポートにクリック数は含まれておらず、純粋に表示機会の指標として扱う必要がある。AI回答の中で自社コンテンツが参照されていても、必ずしもユーザーがクリックするとは限らない点を考慮しなければならない。
低い数値が問題とは限らない
折りたたまれたリンクのインプレッションが少ないからといって、コンテンツがAIに無視されているわけではない。ユーザーが積極的に展開しなければカウントされないため、実際の露出機会よりも数字が小さく見える可能性がある。インプレッション数はあくまで最低限の目安として捉え、他の指標と組み合わせて評価することが重要だ。
デスクトップCTRが上昇、モバイルはトップで減速
Advanced Web Rankingが公開した2026年第1四半期のベンチマークによると、デスクトップ検索のクリック率は上昇傾向にある一方、モバイル検索では1位のCTRが約2.2ポイント低下した。デスクトップの伸びは3位以下のポジションで顕著に見られた。
これは単純な「復調」ではない。モバイルの軟調が続いているなかでのデスクトップの一時的な上昇であり、両者を合算した数値だけを見ると実態を見誤る恐れがある。自社のデータをデバイス別に切り分けて分析し、それぞれの傾向を別々に把握することが欠かせない。
デバイス別の分析が必須
モバイルでCTRが下がる背景には、AI Overviewsの拡大や検索結果画面の構成変化が影響している可能性がある。デスクトップとモバイルではユーザーの行動や画面占有のされ方が異なるため、両方を一緒くたに評価せず、施策もデバイスごとに最適化していく姿勢が有効だ。
AIの推奨がブランド検索を呼び、サイト訪問数が2.5倍に増加
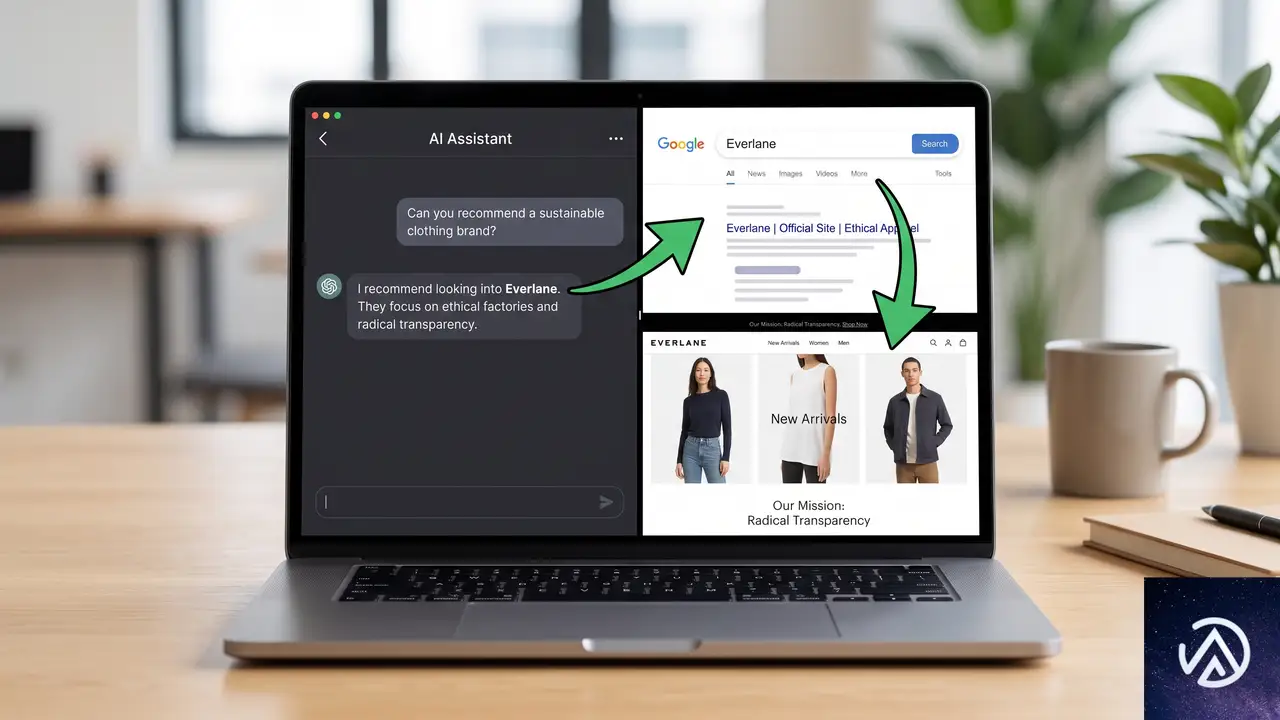
Similarwebのレポートは、ChatGPTなどのAIが特定のブランドを推奨した場合、その後のユーザー行動の55.9%がブランド検索を経由してサイト訪問につながっていると示した。AIが直接リンクをクリックされる以上に、ブランド名を覚えさせて後から検索させる流れが主流になりつつある。
ここで、AI推奨がもたらすユーザー導線の変化をBefore/Afterで視覚化してみる。
上記の図のAfter側では、AIがブランドを推奨した後にユーザーが改めて検索し、最終的にサイトを訪れるという2段階のプロセスが示されている。この流れが全体の55.9%を占めているというデータは、AI検索時代のブランド力の重要性を裏付けるものだ。
ブランド検索ボリュームをKPIに加える
AIが自社名に言及した際、ユーザーはリンクを直接クリックするよりも、ブランド名を検索してからサイトを訪れる傾向が強い。そのため、従来のオーガニック検索の流入数だけでなく、ブランド検索のボリュームそのものを追跡することがAI時代の重要指標になる。
SEOコンサルタントのAleyda Solís氏も、AIの影響はクリックを伴わない形で現れるため、AIリファラルだけを見ていては実態を捉えきれないと警鐘を鳴らしている。ブランド名での検索数や、直接流入・検索流入の増加をAIの露出と結びつけて評価する視点が不可欠だ。
Googleは外部SEOツールを評価せず、内部指標へのアクセスもない
Googleの検索・コマース担当VPであるBrendon Kraham氏は、効果的なSEOの取り組みはそのまま生成AI検索(GEO)にも通用すると述べた。同時に、Googleは第三者のSEOツールやベンダーを評価しておらず、そうしたツールがGoogle内部の指標にアクセスすることも一切ないと明言している。
この発言は、一部のツールが「AI検索に特化した独自のランキング指標」を謳うことに対して釘を刺すものだ。AIが絡む検索環境でも、基本はこれまで通り、ユーザーにとって価値あるコンテンツを提供するというSEOの原則に立ち返る必要がある。
「良いSEOは良いGEO」だが逆は成り立たない
Zyppy SEOの創設者Cyrus Shepard氏は、この「良いSEOは良いGEO」というスローガンにおおむね同意しつつも、AIが存在しなければ絶対にしなかったであろう施策をAIに詳しいSEO担当者がすでに行っていると指摘している。生成AI検索に過度に最適化することは、検索エンジンの変化に振り回されるリスクを高めるため、注意が必要だ。
この記事のポイント
- 6月のスパムアップデートはAI応答の操作行為もスパムと認定。ランキング変動は数日間の経過を見守りながらパターン分析を
- サーチコンソールのAIインプレッションはリンク表示回数のみでクリックデータは未提供。低い数値は過小評価の可能性も
- デスクトップCTRは上昇したがモバイルはトップで低下。デバイス別の分析と施策の切り分けが重要
- AI推奨の55.9%がブランド検索を経由して訪問。ブランド検索ボリュームをAI時代の重要KPIに
- Googleは外部SEOツールの評価や内部指標へのアクセスを否定。AI検索でも基本は質の高いコンテンツ作り
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ドイツ裁判所、GoogleのAI回答に責任認定。SEO業界に衝撃
ドイツのミュンヘン地方裁判所が2026年5月28日、GoogleのAI Overviewが生成した虚偽の内容についてGoogle自身に責任があるとの仮処分を下した。AIが生成した回答は「プラットフォーム自身の発言」であり、単なる検索結果の羅列ではないという判断だ。この判決はSEOの前提を変える可能性を秘めている。
問題の核心は「AIがビジネスについて語るとき、誰が責任を負うのか」という問いだ。今回の判断は、AI回答が単なる情報の仲介ではなく「独自の編集行為」であると認定した点で画期的だ。つまり検索エンジンは自らが生成した文章に対して法的責任を問われうる時代に入った。この変化は企業のAI対策に根本的な再考を迫る。
裁判所がAI回答を「独自の編集物」と認定した意味
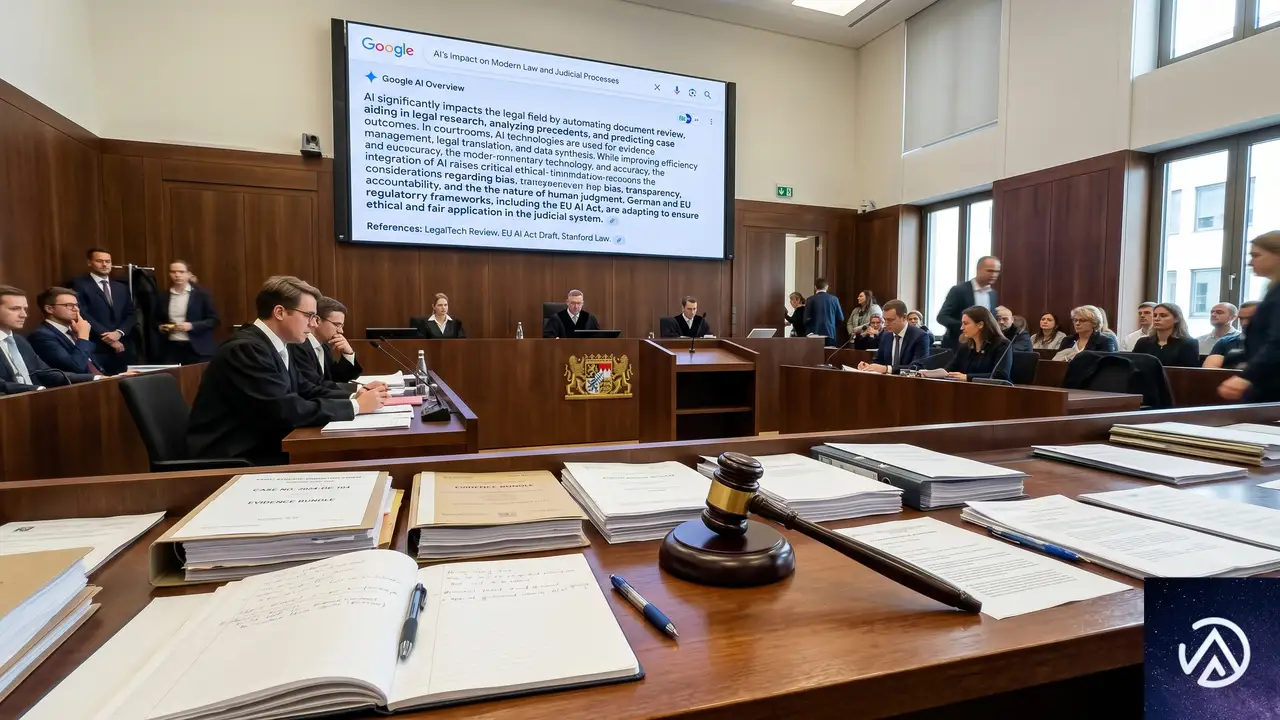
ミュンヘン地方裁判所が下した仮処分(事件番号26 O 869/26)は、GoogleのAI Overviewが2つの地域出版社について虚偽の説明を生成したことを問題視した。AI Overviewはこれらの出版社を詐欺やサブスクリプション詐欺と結びつける文章を生成していたが、引用元として示された情報源のどこにもそのような記述は存在しなかった。
AI Overview(AIによる検索結果の概要表示)とは、検索クエリに対してGoogleが従来のリンク一覧ではなく、AIが生成した要約文を画面上部に表示する機能だ。複数の情報源を読み込んで独自の文章を合成する仕組みで、2024年から本格展開が始まっている。
裁判所はこのAI Overviewについて「独立した新規の実質的な主張を生成している」と評価し、通常の検索結果一覧に適用される免責保護の対象外だと判断した。Google側は「ユーザー自身が回答の正確性を確認すべき」と主張したが、裁判所はこれを退けた。機械が文章を書くなら、その機械の所有者が責任を負うという理屈だ。
このデモが示すように、AI Overviewは従来の検索結果一覧とは法的な位置づけが根本的に異なる。裁判所は情報を「編集し合成する行為」を著作行為とみなし、そこに責任を紐づけたのだ。
この判決が持つ射程の広さ
今回の判断はあくまでドイツの一地裁による仮処分であり、EUの法的枠組みの中で下されたものだ。米国の裁判所が同じ事案を扱えば、プラットフォームを免責された仲介者とみなす従来の考え方から異なる結論に至る可能性は十分にある。ただ方向性は明確だ。AIが自律的に文章を生成する時代において、単なる「情報の受け渡し役」という位置づけは成立しなくなりつつある。
Search Engine Journalの記事では、この判決を1週間前に発表された別の調査結果と並べて論じている。その調査とは「AIに名前を挙げられることと、AIに信頼されることは別である」という分析だ。AI回答におけるビジネスの表現は、信頼の問題であると同時に説明責任の問題でもある。両方の視点が重なったとき、企業に求められる対応の輪郭が浮かび上がる。
責任を負うAIは「慎重になる」という構造的変化
法的責任を問われる可能性があるAIは、リスクを避けるために振る舞いを変える。これが今回の判決がもたらす最大の二次的影響だ。
AI回答が自社の発言として扱われるなら、プラットフォームが取る合理的な行動は「突然正確になること」ではない。「慎重になること」だ。確実に裏付けが取れるビジネスだけを安全圏として提示し、曖昧な存在は言及そのものを避けるようになる。この変化はすでに兆候を見せている。小規模な企業や評価が分かれる事業についてAIに質問すると、回答が急に歯切れが悪くなり、公式情報源に委ねたり、企業の特徴づけを完全に回避したりするケースが増えている。
AI回答「複数の情報源がありますが、公式な確認が取れません。ご自身での確認をお勧めします」
AI回答「△△社は〇〇を提供しています。公式サイトではXXと記載されています」
この変化は「どうやってAIに正しく自社を引用させるか」という問いを「AIが自信を持って名前を出せるビジネスかどうか」という一段上の問いに引き上げる。機械可読なアイデンティティの整備は、もはやSEOの一手ではなく参加資格そのものに近づく。
AIがビジネスを「疑う」4つの原因
Search Engine Journalの記事でCarlo Daniele氏が指摘するように、大半のビジネスはAIに疑念を抱かせる材料を少なくとも一つは抱えている。具体的には以下の4パターンだ。
- 法的実体の不一致:自社サイト、SNSプロフィール、過去のプレス記事で会社名や事業者名が微妙に異なる。AIはどれが正規情報か判断できない
- 役職表記のズレ:会社概要ページと過去のインタビュー記事で創業者の役職表記が食い違っている
- テキスト化されていない重要情報:製品の具体的な機能説明が画像やPDFの中にしか存在せず、AIのパーサーが読み取れない
- カテゴリの曖昧さ:人間が読めば事業内容が明確でも、マークアップ上でカテゴリが明示されておらず機械が判断できない
これらはいずれも従来のコンテンツSEOの発想では見過ごされてきた問題だ。記事が指摘するように、これはコンテンツの問題ではなくアイデンティティの問題である。1万語のコンテンツがあっても自己矛盾した情報を発信していればAIはそのビジネスを「検証困難」と判定する。一方で簡潔でもあらゆる読み取り経路で同一の事実を返すビジネスはAIにとって「引用可能」と判断される。
AIに「確信されるビジネス」になるための実践手順
この変化に対応するために法律家は必要ない。必要なのはAIに「このビジネスは確かだ」と判断させるための基盤整備だ。Search Engine Journalの記事で提示された3ステップを具体的に見ていく。
ステップ1 AIが自社をどう語っているか監査する
まずは自社ブランド名、製品名、事業カテゴリを実際に顧客が使うAI検索エンジンに投入し、生成される回答を第三者の目で読む。AI OverviewだけでなくChatGPTやClaudeなど複数のエンジンで確認することが重要だ。エンジンごとに回答は異なり、そのズレの大きさこそが自社のアイデンティティ監査の出発点になる。
チェックすべき項目は以下の4つだ。AIが自社のカテゴリを正しく述べているか、正しい製品を帰属させているか、正しい人物名を挙げているか、そして実際には無関係なネガティブ情報と結びつけていないか。Search Engine Journalの記事によれば、大半の企業はこのような監査を一度も実施したことがないという。
この監査は企業のAI上の立ち位置を可視化する最初の一歩だ。自社がどのように語られているかを把握せずに対策を立てることはできない。
ステップ2 AIが判断の根拠にする事実情報を整備する
監査で発見されたズレを修正するには、AIが参照する基盤情報の整備が不可欠だ。Search Engine Journalの記事で提唱されているMachine-First Architecture(機械優先アーキテクチャ)の考え方では、以下の3つが中核となる。
第一に、Organization構造化データの実装だ。自社が誰で、何をしており、どこで確認できるかを機械可読な形式で明示する。構造化データ(Schema.orgに準拠したマークアップ)とは、HTMLに埋め込む形で検索エンジンに情報の意味を伝える仕組みであり、AIが情報を正確に抽出するための土台となる。
第二に、全情報発信チャネルでの表記統一だ。自社サイト、Googleビジネスプロフィール、主要SNS、業界ディレクトリで社名・住所・事業内容の表記を完全に一致させる。バリエーションがあるたびにAIは「どれが正しいか」の判断を強いられ、リスク回避のために言及を控える方向に傾く。
第三に、テキスト化の徹底だ。画像やPDFに埋め込まれた重要情報をHTMLテキストとしても提供し、AIのパーサーが確実に読み取れる形にする。特に事業内容の明示的な説明は、人間向けのデザイン性よりも機械向けの明快さを優先すべき局面に入っている。
ステップ3 監査を習慣化する
企業情報は時間とともに変化し、周囲のウェブ環境も変わり、AIモデルも再学習を繰り返す。一度整備して終わりではなく、定期的にAIが自社をどう語っているかを確認する習慣が必要だ。Search Engine Journalの記事はこれを「自社のアナリティクスを確認するのと同じ感覚で」行うべきだと提案している。
訴訟そのものは稀であり管轄も限られる。しかし構造的な影響はゆっくりと確実に広がる。AI回答にリスクが伴うとき、エンジンは慎重になり、慎重なエンジンは裏付けの取れるビジネスだけを積極的に提示する。企業に求められるのは「機械に確信される存在」になるための継続的な努力だ。
この記事のポイント
- ミュンヘン地方裁判所がAI OverviewをGoogle自身のコンテンツと認定し免責を否定した
- AI回答に法的責任が生じるとプラットフォームは「慎重になり言及を避ける」方向に動く
- 企業名・役職・事業内容の表記不一致がAIの信頼を損ねる主要因である
- 構造化データの実装と全チャネルでの情報統一がAI時代の基盤対策となる
- AIによる自社の語られ方を定期的に監査する習慣が不可欠だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleとMicrosoftがAIエージェント共通仕様ARDを公開、11社が賛同
GoogleとMicrosoftを含む11社が、AIエージェントがウェブ上のツールやスキルを自動検出するための共通仕様「ARD(Agentic Resource Discovery)」を2026年6月17日に公開した。
GitHubやHugging Face、NVIDIA、Salesforceも名を連ねるこの仕様は、各社が公開するAIエージェント向け機能を、事前の手動接続なしに実行時に見つけ出せる仕組みだ。Apache 2.0ライセンスで公開され、同日に複数の参照実装もリリースされた。
この仕様が実用化されれば、AIエージェントは必要なツールを自ら探し出して接続できるようになる。開発者やサービス提供者にとっては、自社のAPIやエージェント機能をAIシステムに自動的に見つけてもらうための新たな方法が生まれることになる。
ARDとは何か
ARD(Agentic Resource Discovery)は、AIエージェントがウェブ上で「使えるツールや機能」を自動的に見つけ出すための共通ルールを定めた仕様だ。Linux Foundationのワーキンググループが管理するAI Catalogデータモデルを基盤に構築されている。
現在のAIエージェントは、あらかじめ各ツールやMCPサーバー、APIとの接続を手動で設定する必要がある。企業が公開する機能が増え続けるなか、この「事前配線」方式では拡張性に限界があった。ARDはこの問題に対処するために設計されている。
ARDの仕組みは、企業が自社ドメインに公開するカタログと、それを収集してインデックス化するレジストリの2層構造で成り立っている。人手による接続設定を実行時の検索に置き換えることで、AIエージェントが自律的に機能を発見できる世界を目指している。
ARDの技術的な仕組み
カタログとレジストリの2層構造
ARDの中核は「カタログ」と「レジストリ」という2つの要素だ。まず、ツールやエージェントを提供する企業は、自社ドメインの定められたパスにai-catalog.jsonというファイルを設置する。このファイルには、公開するツール、MCPサーバー、エージェント、APIの一覧が記述される。
次に「レジストリ」がこれらのカタログを巡回(クロール)してインデックス化する。AIエージェントが「この処理に使えるツールはないか」と自然言語で問い合わせると、レジストリが該当するカタログ情報を返す仕組みだ。
ai-catalog.json を設置カタログが公開者の自社ドメインに置かれることで、ドメイン所有権が公開者の検証手段として機能する。本番運用では、暗号化された信頼メタデータを付与し、接続前に公開者の身元を確認することも可能だ。ツールが選定された後は、ARDの役割は終了し、実際の接続は各ツール固有のプロトコルで直接行われる。
誰に向けた仕様なのか
ARDが主に対象とするのは、APIやMCPサーバー、エージェントといった「呼び出し可能な機能」を提供する企業だ。ツールを公開する企業には、AIエージェントに見つけてもらい、信頼してもらうための明確な方法が提供される。
一方、一般的なコンテンツサイトにとっては、現時点で直接的な活用方法は示されていない。Search Engine Journalの記事でも「典型的なコンテンツサイトに今日すぐ取るべきアクションはない」と指摘されている。
公開当日に登場した参照実装
ARDの草案公開と同日に、複数の参加企業が実際に動作するツールをリリースした。
- GitHub Copilot向けに「Agent Finder」を導入。選択したレジストリからMCPサーバー、スキル、ツール、エージェントを検出し、ユーザーが接続対象を制御できる仕組みだ。
- Hugging Face ARDサービス全体からスキルやMCPサーバーを検索する「Discover Tool」を公開した。
- Cisco Linux Foundation傘下のオープンソースプロジェクト「AGNTCY Agent Directory」にARDを統合した。
GitHubのAgent Finderは特に関心を集めている。Copilotのユーザーがレジストリから必要な機能を見つけ出し、自分の判断で接続を許可できる設計は、エージェントの自律性とユーザー制御のバランスを取る試みといえる。
この流れは、ウェブの「機械可読層」を整備する一連のオープン仕様の延長線上にある。GoogleはARD公開の2日前にも、AIシステム間で組織知識を共有するための「Open Knowledge Format」仕様を発表している。いずれも自社ドメインに構造化ファイルを設置するだけで、AIシステムが人手の配線なしに情報を利用できるようにする考え方だ。
Googleの立ち位置と今後の展開
GoogleはARDにおいて、Gemini Enterprise Agent Platformの一部である「Agent Registry」を中心的な役割として位置づけている。これはエージェント向けリソースのホスティングと検索、企業向けのガバナンス管理を担う基盤だ。
Search Engine Journalの記事によれば、Agent RegistryへのネイティブARD対応は数カ月以内に予定されている。これが実現すれば、組織は内部レジストリを広域ネットワークに接続できるようになる。
ただし現時点でこの対応は稼働しておらず、ARDはあくまで「仕様」であってGoogle検索の機能ではない。検索エンジンとしてのGoogleがARDカタログを直接検索結果に反映するわけではない点は、区別して理解しておく必要がある。
コンテンツ制作者が今考えるべきこと
ARDがもたらす影響は、ビジネスの性質によって大きく異なる。ツールやAPIを提供する企業には、AIエージェントに発見されるための具体的な手段が用意された。一方で、一般的なコンテンツサイト運営者にとっての即効性は限定的だ。
この仕様の価値については業界内でも議論がある。GoogleのJohn Mueller氏は、LLMシステムがllms.txtのようなファイルでサイトを区別することはできないと指摘し、将来のエージェント向け戦略よりも現在のニーズに注力するよう助言している。ARDが対象とするのはツールやエージェントであり、コンテンツではないという点は、こうした議論の背景として押さえておきたい。
仕様はまだv0.9草案であり、GitHubリポジトリで変更提案を受け付けている段階だ。実用性を左右するのは、カタログを大規模にクロールしてインデックス化できるレジストリのエコシステムだが、それもまだ初期段階にある。
エコシステムが成熟した場合に最も恩恵を受けるのは、他者が必要とするツールやエージェントを提供する企業だ。GoogleがUlrtaユーザー向けに展開し始めたエージェント主導の検索機能も、この方向性を示唆している。今すぐ取るべき現実的なアクションは、自社が使っているプラットフォームやツールがARDに対応するかどうか、そして対応時にどのような公開情報が求められるかを注視することだ。
この記事のポイント
- ARDはAIエージェントがツールやAPIを実行時に自動発見するためのオープン仕様である
- カタログ(ai-catalog.json)とレジストリの2層構造で、ドメイン所有権が信頼の基盤となる
- GitHubやHugging Faceが公開初日から参照実装を提供しており、実用化に向けた動きは速い
- 一般的なコンテンツサイトよりも、ツールやAPIを公開する企業に直接的な恩恵がある
- v0.9草案段階であり、レジストリのエコシステム構築が今後の鍵を握る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験