

GoogleがFAQリッチリザルト廃止、AhrefsがスキーマのAI引用価値を否定
2026年5月、スキーママークアップの価値に冷や水を浴びせる二つの動きが重なった。GoogleはFAQリッチリザルトを廃止し、Ahrefsは構造化データがAI引用を増やさないとするレポートを公開した。
この連続パンチは、SERPでの視認性向上とAI引用獲得というスキーマの二大セールスポイントを直撃する。本記事では、今回の動きが持つ意味と、データが示すスキーマの未来像を掘り下げていく。
Googleがスキーマ特典を絞り込んだ5年間
FAQリッチリザルト廃止の最終決定
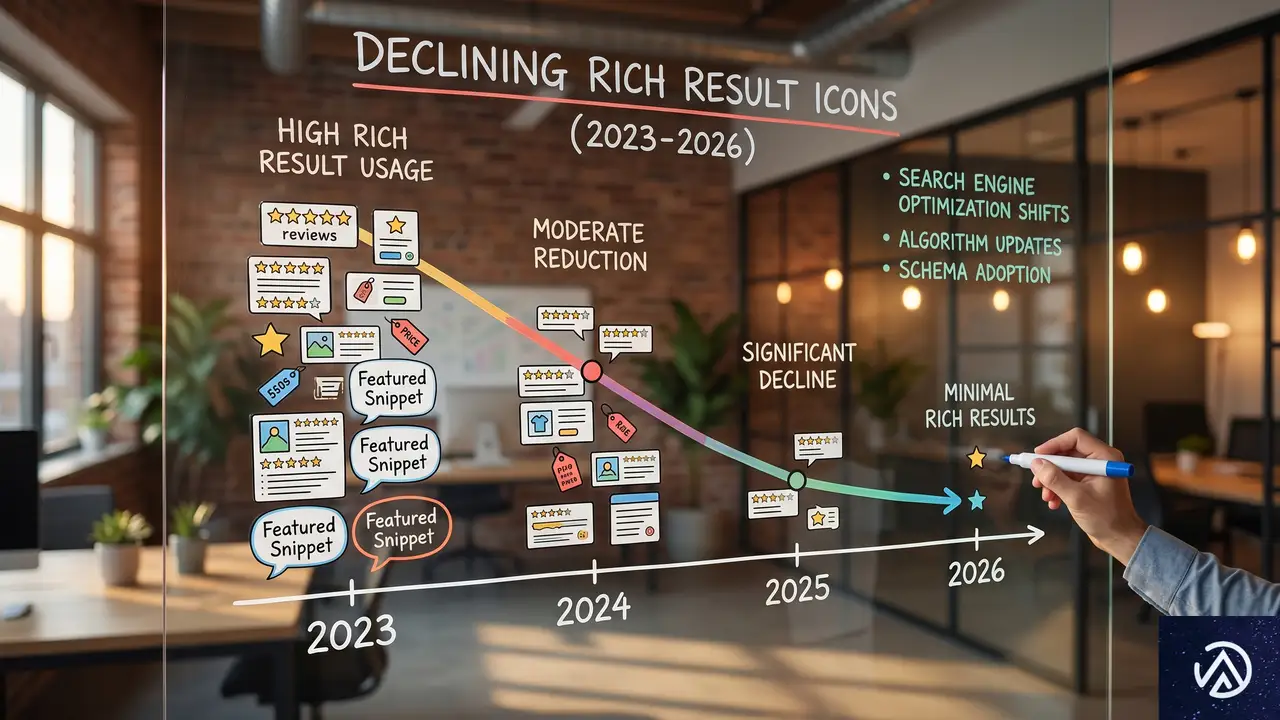
2026年5月12日、GoogleはFAQページ向けの構造化データを正式に廃止した。FAQリッチリザルトは検索結果上に質問と回答を展開表示する機能で、多くのサイトがクリック率向上のために導入してきた。Googleはこの廃止について「検索結果を簡素化し、ユーザーにとって本当に価値のある情報だけを表示するため」と説明している。
この決定は突然ではない。2023年8月にはFAQリッチリザルトの表示対象を政府機関や医療サイトなどの権威的サイトに限定していた。その時点で、一般的な商業サイトやブログでのFAQ表示はすでに停止されていた。今回の完全廃止は、その延長線上にある最終決定といえる。
GoogleのJohn Mueller氏はReddit上で「マークアップの種類は登場と消滅を繰り返すが、ごく一部の重要なものだけは残り続ける」とコメントしている。これはスキーマ全般を否定する発言ではないが、特定のリッチリザルトを戦略の柱に据えることのリスクを暗に示している。
可視的報酬のパターン
過去5年間の動きを振り返ると、明確なパターンが浮かび上がる。新しい構造化データが導入される。SEO業界がその使い方を検証し、広く導入する。数年のうちにGoogleがその表示特典を縮小または廃止する。そして業界は次の新しいスキーマタイプに注目を移す。
重要なのは、マークアップ自体が無効になるわけではない点だ。Googleのシステムは引き続きFAQ構造化データを読み取り、ページ内容の理解に活用する。しかし検索結果上での目に見える特典、つまりリッチリザルト表示という形での直接的なSEO効果は消滅した。
Ahrefsレポートが示したAI引用とスキーマの関係
1,885ページのA/B比較から見えたもの
Ahrefsは2026年5月16日、構造化データとAI引用の関係を検証した大規模レポートを公開した。調査対象はJSON-LD形式のスキーマを追加した1,885のウェブページ。各ページに対し、スキーマを追加しなかった同条件のコントロールページを用意し、Google AI Overviews、Google AI Mode、ChatGPTの3つのAIシステムで引用数の変化を計測した。
結果は次のとおりだ。
- Google AI Modeで引用が2.4%増加
- ChatGPTで引用が2.2%増加
- Google AI Overviewsで引用が4.6%減少
AI ModeとChatGPTの増加率は統計的な誤差の範囲内であり、スキーマの効果とは言い切れない数値だった。AI Overviewsの減少は統計的に有意だったが、Ahrefs自身が「この減少をスキーマが原因と断定することはできない」と慎重な見解を示している。
データが明かさなかった二つの前提
この調査結果を読む上で、二つの前提を見逃してはならない。
第一に、調査対象の全ページはスキーマ追加前からすでにAI Overviewsで100件以上の引用を獲得していた。つまり、これらのページはAIシステムによって十分にクロールされ、認識され、引用されていた。まだAIに認識されていないページでスキーマがクローリングやインデックス登録を助ける可能性は、このデータでは検証されていない。
第二に、この調査では全スキーマタイプを一括りにしている。Article、FAQ、Product、HowTo、Organizationなど種類の異なるスキーマがまとめて「スキーマあり」とラベル付けされた。タイプ別の効果は未検証であり、特定の種類で引用増加が起きる可能性は否定されていない。
Ahrefsのコンテンツマーケティング責任者であるRyan Law氏はLinkedIn上で「スキーママークアップを追加すればAI検索での引用が増えるか?おそらくノーだ」と端的に総括した。Law氏は「スキーマはAI引用を改善する魔法の解決策ではない」とも付け加えている。
業界内で広がった議論の温度感
「FAQスキーマはAI訓練用だった」という仮説
今回のFAQリッチリザルト廃止に対して、業界内ではさまざまな見解が飛び交った。なかでも注目されたのが、Marie Haynes ConsultingのMarie Haynes氏が提示した仮説だ。
Haynes氏は「GoogleはAIを訓練するためにFAQデータが必要だったので、リッチリザルトという形でインセンティブを与えた。そして今、もうそのデータは不要になった」という見方を示した。この説はGoogle自身によって確認されたものではないが、FAQスキーマ導入から廃止までのタイムラインを説明する一つの解釈として、多くの実務者の関心を集めた。
GEO業界への波紋
SEOの専門家であるLily Ray氏(Amsive社、SEO・AIサーチ担当VP)はLinkedIn上で「FAQスキーマはGEOにとって重要」というフレーズが約16万8000ページで使われていることを指摘し、「SEOでスパム可能なものは必ずスパムされる」と述べた。Ray氏は2019年にFAQスキーマが初めて導入された際のMoz記事でこのサイクルを予見していた。
Yoastの創業者であるJoost de Valk氏は、この事態を「GEO業界は初期SEOの歴史を高速で再現している」と表現し、「FAQスキーマの廃止はそのサイクルが再起動した最初の具体的な証拠だ」と自身のブログで述べた。de Valk氏はSchema.orgに対して、FAQSectionという新しいタイプを提案するissueも提出している。これは「このページにFAQセクションがある」という情報と「このページ自体がFAQである」という情報を構造的に分離するための提案だ。
データが答えられなかった問い
■ スキーマタイプ別の効果(Article/Product/FAQを個別検証していない)
■ 30日を超える長期的効果
■ Bing/Copilot/Perplexity/Claude での挙動
■ JavaScript経由で注入したスキーマの効果
検証されていない経路
Ahrefsの計測対象はGoogle AI Overviews、AI Mode、ChatGPTの3システムに限られる。BingやCopilot、Perplexity、Claudeなど他のAI検索システムがスキーマをどのように扱うかは未検証だ。これらのシステムはGoogleとは異なるクローリングやパースの仕組みを持つ可能性がある。
また、searchVIU(2025年)の実験では、5つのAIシステムがページを直接取得する段階で、表示テキスト(HTML)を参照し、JSON-LDやMicrodata、RDFaなどの隠されたマークアップは使用していなかったと報告されている。これは取得段階に限った話であり、インデックス登録やエンティティ理解の段階でスキーマが役立つ可能性を否定するものではない。
計測期間とタイプ混在の問題
Ahrefsの調査期間は30日間である。スキーマ追加の効果がさらに長期間かけて現れる可能性や、スキーマ追加と同時に行われた他のページ変更の影響を分離できていない点も、解釈上の注意が必要だ。
GoogleはFAQスキーマの廃止告知の中で、構造化データを「ページをよりよく理解する」ために使い続けると述べている。この「よりよく理解する」という表現が具体的に何を指し、どのような測定可能な結果につながるのかは、現時点では明らかになっていない。エンティティ理解やソース選定への間接的な影響を測定したデータは、まだ誰も公表していない。
SEO実務者がいま取るべき戦略
■ 「スキーマを追加すればAI引用が増える」というGEOの売り文句はデータで裏付けられていない
■ Organization、Person、Article スキーマ → エンティティ記述としての価値は残る
■ 見出し構造の明確化、本文での直接的な回答提示 → AI引用に効く可能性が高い
特定スキーマへの過度な依存を避ける
まず確認すべきは、今回のFAQリッチリザルト廃止がスキーマ全体の否定ではないという点だ。Product、Review、Event、Videoといった一部の構造化データは、引き続きアクティブなリッチリザルト機能をサポートしている。Organization、Person、Articleマークアップも、エンティティやコンテンツの記述手段として価値を持ち続ける。
問題は、特定のスキーマタイプを戦略の柱にしてしまうことだ。過去5年間のパターンが示すように、Googleは普及したマークアップの表示特典を段階的に縮小する傾向がある。スキーマは検索エンジンにとっての「水道管」であり、一度敷設すれば特定の蛇口(リッチリザルト)が閉まっても、別の形で水(データ)を運び続ける可能性は残る。
AI引用を狙うならHTML構造を見直す
searchVIUの調査が示したのは、AIシステムがページ取得時にJSON-LDではなく表示テキスト(可視HTML)を参照しているという事実だ。この結果は、AI引用を増やすためにはスキーマよりもコンテンツ自体の構造が重要である可能性を示唆する。
具体的には、見出しを階層的に整理すること、質問に対して本文中で直接的な回答を示すこと、情報を明確なセクションに分けること、といった基本的なコンテンツ設計が、マークアップよりもAI引用に効くかもしれない。スキーマの導入を否定するデータではないが、スキーマだけでAI引用が増えるという期待はデータで裏付けられなかった。
この記事のポイント
- Googleは2026年5月にFAQリッチリザルトを完全廃止し、可視的スキーマ特典の縮小傾向が続いている
- Ahrefsの調査(1,885ページ)では、JSON-LD追加によるAI引用の増加は統計的に確認されなかった
- GEO業界で広がった「スキーマでAI引用が増える」という売り文句は、データによる裏付けを欠いている
- ProductやOrganizationなどリッチリザルトが現役のスキーマタイプは引き続き価値を持つ
- AI引用を狙うなら、スキーマ以上にHTML構造の明確化と本文での直接回答が重要になる可能性が高い

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleがAEOとGEOを「依然としてSEO」と公式見解、新ガイド公開
Googleは2026年5月15日、生成AI検索機能(AI OverviewsやAI Mode)に向けたウェブサイト最適化の公式ガイドを公開した。名称は「Optimizing your website for generative AI features on Google Search」である。
このドキュメントでGoogleは、AEO(Answer Engine Optimization)やGEO(Generative Engine Optimization)と呼ばれる一連の手法について、はっきりとした立場を示した。すなわち「それらは依然としてSEOの一部である」という公式見解だ。同時に、llms.txtファイルの作成やチャンキング(コンテンツの細分化)、不自然な言及の獲得といった、一部で推奨されてきた施策に対しても「必要ない」と明言している。
記事では、この新ガイドのポイントを具体的に紹介しつつ、実務者がAI検索時代に本当に注力すべき施策を整理する。
新ガイド公開の背景と位置づけ
今回のガイドは、2025年に公開されたAI機能の仕組みに関するドキュメントを大幅に拡充したものだ。従来版ではAI機能の動作原理や検索パフォーマンスの測定方法が中心だったが、新ガイドは「何をすべきか」という最適化アドバイスに踏み込んでいる。特に「神話打破(Mythbusting)」というセクションを新設し、業界で流布している誤解に対してGoogleの立場を直接的に表明した点が目を引く。
Googleの生成AI検索機能は、RAG(Retrieval-Augmented Generation / 検索拡張生成)とクエリファンアウトを基盤としており、基本的には既存の検索インデックスからコンテンツを引き出す仕組みだ。このため、コアとなるランキングシステムや品質評価の仕組みは従来と大きく変わらない。ガイドはその点を強調しつつ、AIならではの特性を踏まえた最適化の方向性を示している。
新旧ガイドの差分を見ると、Googleがサイト運営者に対して「何を気にしなくてよいか」を明確に伝えようとしていることがわかる。生成AI検索の登場以降、さまざまなサービスが独自の最適化手法を提唱してきたが、Googleはその多くを不要と断じた形だ。
AEO・GEOは「依然としてSEO」という公式見解
用語の定義とGoogleの立場
ガイドでは、AEOを「Answer Engine Optimization」、GEOを「Generative Engine Optimization」と定義した上で、「Google検索の観点から言えば、生成AI検索のための最適化は検索体験のための最適化であり、したがって依然としてSEOである」と明記した。
この見解は、Googleの検索担当者であるGary Illyes氏やCherry Prommawin氏が過去のカンファレンスで発言してきた内容を公式文書化したものだ。両氏はSearch Central Liveにおいて、GEOやAEOに個別のフレームワークは不要であると述べていた。今回のガイド公開により、その立場が正式な参照可能なドキュメントとして記録されたことになる。
RAGとクエリファンアウトの仕組み
GoogleのAI機能は、RAG(検索拡張生成)という仕組みを使っている。これは、ユーザーの質問に対してまず検索インデックスから関連コンテンツを取得し、その情報をもとに生成AIが回答を構成する方式だ。クエリファンアウトは、ひとつの質問を複数の関連クエリに展開して広範囲の情報を収集する技術を指す。いずれも既存の検索インデックスに依存しているため、ベースとなるSEO対策が効いてくる構造は変わらない。
この点を踏まえると、「AI向けに別の最適化が必要」という発想そのものが、Googleの検索システムの実態と乖離していることになる。
上図のように、AI検索においても検索インデックスが情報取得の起点であることに変わりはない。つまり、クローラビリティやコンテンツ品質といった従来型SEOの基盤が、そのままAI検索のパフォーマンスに直結する。
Googleが必要ないと明言した5つの施策
新ガイドの「神話打破」セクションでは、以下の施策について明示的に「Google検索においては不要」と記載されている。
llms.txtファイルや特殊マークアップ
機械可読なファイルやAI向けテキストファイル、特別なマークアップ、Markdownなどを用意する必要はない。GoogleはHTML以外のさまざまなファイル形式を検出しインデックス登録できるが、それはファイル形式が特別扱いされることを意味しない。
チャンキング(コンテンツの細分化)
AIシステム向けにコンテンツを細かく分割する必要はない。Googleのシステムは「ページ内の複数トピックのニュアンスを理解し、ユーザーに関連する部分を表示できる」能力を持つ。Search Engine Journalの記事によれば、GoogleのDanny Sullivan氏も2026年1月に同様の見解を示しており、社内エンジニアからもチャンキングを推奨しない意見が出ているという。
AI向けの文章リライト
AIシステムは類義語や一般的な意味を理解できるため、すべてのロングテールキーワードバリエーションを網羅したり、生成AI検索向けに特別な文体で書いたりする必要はない。過剰な最適化はむしろ不自然なコンテンツを生むリスクもある。
不自然な言及(メンション)の獲得
AI機能はブログや動画、フォーラムなどで語られている製品やサービスに関する言及を表示することがある。しかし、不自然な形で言及を集めようとする行為は「思われているほど有益ではない」とガイドは指摘する。中核のランキングシステムは品質に焦点を当てており、スパム的な言及は別の仕組みでブロックされる。
生成AI検索向けの専用構造化データ
生成AI検索のために特別なschema.orgマークアップを追加する必要はない。構造化データはリッチリザルトの表示資格を得るために従来通り活用するのがよいとしている。
上記の施策はいずれも、一部のGEO関連リソースやAI検索最適化ガイドで推奨されてきたものだ。しかしGoogleの公式見解は真逆であり、こうした「AI専用対策」にリソースを割くことの費用対効果は極めて低いと言わざるを得ない。
代わりに注力すべき最適化の要点
では実際に何をすべきか。ガイドの推奨事項は、多くのSEO担当者にとって馴染み深い領域に集約されるが、AI検索ならではの文脈も含まれている。
非コモディティコンテンツの重視
ガイドが特に強調するのが「非コモディティコンテンツ」の概念だ。コモディティコンテンツとは、「初めて住宅を購入する人への7つのヒント」のような、どこにでもある一般知識の寄せ集めを指す。対する非コモディティコンテンツの例としてGoogleが挙げるのは「なぜ我々は検査を放棄して節約したのか——下水管内部の実例」のような、独自の経験や視点に基づく記事である。
この区別は、AIが既存の知識を要約して回答を生成できる時代において、人間の独自体験や専門的判断が差別化要因になることを示唆している。単なる情報の列挙ではなく、実際に経験したこと、検証したこと、独自に分析したことを盛り込む姿勢が求められる。
クローラビリティとインデックス
生成AI機能にコンテンツが表示されるには、ページがインデックス登録され、スニペット表示の対象となっている必要がある。具体的には、クロールのベストプラクティスに従うこと、可能な限りセマンティックHTMLを使用すること、JavaScript SEOの基本を守ること、良好なページエクスペリエンスを提供すること、重複コンテンツを減らすことなどが推奨されている。
ローカルビジネスとECの最適化
ローカルビジネスやECサイト向けには、Merchant CenterフィードとGoogleビジネスプロフィールの活用が推奨されている。また、Business Agentという、ユーザーがGoogle検索上でブランドとチャットできる会話型体験についても言及があった。これは、実店舗や商品を持つ事業者にとってAIエージェント経由の接点が増える可能性を示している。
非コモディティコンテンツの作成 独自の経験・分析に基づく記事
クローラビリティとインデックス管理 従来のテクニカルSEO対策
構造化データの適切な活用 リッチリザルト用途として継続
エージェント対策(UCP対応など) ビジネス関連性と余力がある場合
整理すると、AI検索対策の本質は「強いコンテンツを作り、検索エンジンに正しく読み取らせる」という原点に立ち返ることだ。特別なテクニックや抜け道を探す段階は、少なくともGoogleにおいては終わったと言える。
エージェント体験とUCPの初期ガイダンス
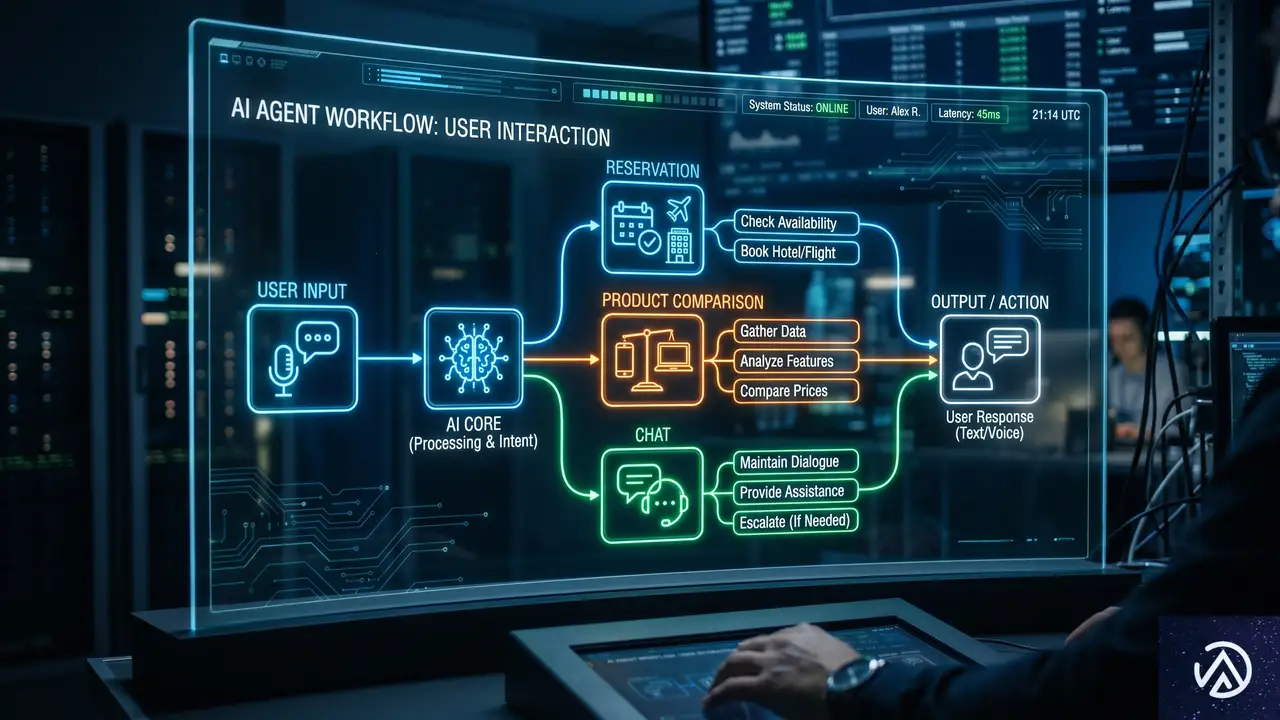
新ガイドでは、エージェント体験についても独立したセクションが設けられた。AIエージェントを「予約の手配や製品仕様の比較など、人に代わってタスクを実行できる自律システム」と定義し、ブラウザエージェントがスクリーンショットの分析、DOMの検査、アクセシビリティツリーの解釈を通じてウェブサイトにアクセスする可能性に言及している。
この文脈で紹介されているのが、web.devの「エージェントフレンドリーなウェブサイトのベストプラクティス」ガイドと、UCP(Universal Commerce Protocol)だ。UCPはGoogleが2026年初頭に発表した新興プロトコルで、Shopifyと共同開発され、すでに20社以上が支持を表明している。Vidhya Srinivasan氏の年次レターでも紹介された。
ただしGoogleは、このセクションについて「ビジネスに関連性があり、余力がある場合に検討するもの」と位置づけている。エージェント最適化は将来的な投資であり、今すぐ取り組まなければ検索順位が下がる性質のものではない。
実務への影響と今後の展望
このガイドの最大の価値は、Googleの立場を一つの文書に集約したことにある。これまでカンファレンスやポッドキャスト、ブログ投稿に分散していた見解が、公式ドキュメントとして参照可能になった。「神話打破」セクションは特に重要で、AEOやGEOのサービスを展開する業界が推奨してきた施策の多くを、Google自身が否定した形だ。
ただし注意すべき点もある。このガイドはあくまでGoogleのAI検索機能に特化したものであり、ChatGPTやPerplexityなど他プラットフォームのAI検索には適用されない可能性がある。これらのサービスは異なるシグナルを重視しているかもしれず、マルチプラットフォーム戦略をとる場合は別途検証が必要だ。
Googleは文書の締めくくりで、「このガイドのすべてを達成しなくても成功できる」と述べている。「多くのコンテンツは、明白なSEO対策を一切施さなくてもGoogle検索(生成AI体験を含む)で成果を上げている」というコメントからは、技術的な最適化よりもコンテンツの本質的な価値が優先されるというメッセージが読み取れる。
SEO担当者やサイト運営者にとって、このガイドは戦略的なリソース配分を見直す良い契機になるだろう。「AI専用の対策」に時間と予算を割くよりも、独自の情報価値を持つコンテンツの制作と、堅実なテクニカルSEOの維持に集中する。それが、Googleの生成AI検索において最も確実なアプローチだと公式に示されたのである。
この記事のポイント
- Googleが生成AI検索最適化の公式ガイドを2026年5月に公開し、AEOやGEOは「依然としてSEOの一部」と明言した
- llms.txt、チャンキング、AI向けリライト、不自然な言及獲得、専用構造化データの5施策を「不要」と断定
- 代わりに非コモディティコンテンツ、クローラビリティ確保、構造化データの適切な活用を推奨
- エージェント体験とUCPに関する初期ガイダンスも含まれるが、優先度は相対的に低い
- ガイドの適用範囲はGoogleに限られるため、他プラットフォームでは別途戦略の検証が必要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google AI Overviews、リンク表示拡大へ。ゼロクリック検索に変化の兆し
GoogleがAIによる検索結果表示「AI Overviews」内のリンクを拡充するアップデートを2026年5月6日に発表した。この変更は「ゼロクリック検索」の割合がわずかながら低下傾向にあるという業界レポートと同時期に重なり、ECサイト運営者にとっては見過ごせないシグナルだ。
Semrush傘下のDatosが発表した「State of Search Q1 2026」レポートによると、米国におけるゼロクリック検索の割合は2025年12月の24.5%から2026年3月には22.4%へと縮小した。オーガニック検索からのクリック率は同期間に42.0%から44.9%へと上昇している。
今回のGoogleの動きは、AIに代替され続けるウェブサイトへの流入経路に新たな選択肢が生まれる兆しだ。特に、商品ページへの直接的な流入が生命線となるECサイトにとって、この変化への適応は売上を左右する。
ゼロクリック検索の減少が示す潮目の変化

ゼロクリック検索とは、ユーザーが検索結果ページ内で目的の情報を得てしまい、どのウェブサイトにも遷移せずに検索を終えることだ。定義のハイライトやAIによる要約がこれに該当する。ECサイトにとってゼロクリック検索の増加は、検索順位が高くても実際の訪問者や売上に結びつかない状態を意味するため、長らく懸念材料だった。
この変化が意味するのは、AI Overviewsが単なる「流入を阻害する壁」から「新たな流入経路」へと徐々に進化している可能性だ。ゼロクリックが減少に転じたとはいえ、以前と比較すれば高止まりしているのが現状であり、油断は禁物だが、風向きはわずかに変わってきている。
Googleが追加した新たなリンクとその仕組み

Googleの発表によれば、今回のアップデートではAI OverviewsおよびAI Mode内に以下の2種類のリンクが追加される。
- 信頼できる著者やブランドの引用。SNSでの議論も含む。
- 「さらに読む」ための詳細な記事や分析。
加えて、リンク先のソース名とタイトルが検索結果上に明示されるようになった。有料購読が必要なコンテンツの場合、ユーザーが購読者かどうかも表示される。この変更は、ユーザーがどのような情報源をクリックしようとしているのかを事前に判断できるようにする意図がある。
このリンクは、Search Consoleの検索パフォーマンスレポートでは「平均掲載順位 1」としてカウントされる。つまり、AI Overviews内に自社コンテンツが引用されれば、検索結果の最上部に表示されているのと同じ扱いを受けることになる。
EC担当者が監視すべきSearch Consoleの指標
AI Overviews専用のレポートがSearch Consoleに実装される計画は、現時点では確認されていない。しかし、既存の検索パフォーマンスレポートを活用することで、ある程度の状況把握は可能だ。
- 平均掲載順位が1のクエリ群を定期的にチェックする。
- クリック率が急上昇したページがあれば、AI Overviewsに取り上げられた可能性が高い。
- 新規に表示されるようになったクエリをカテゴリ別に整理し、どのテーマのコンテンツがAIに評価されているのかを分析する。
ECサイトの場合、商品名や比較キーワードで突然流入が増えた場合は、AI Overviewsに商品情報が引用されたシグナルと捉えてよい。
ECサイトが取るべきコンテンツ戦略の転換点

Practical Ecommerceの記事では、今回のGoogleの動きから読み取れる方向性として、以下の3点が挙げられている。
- GoogleはAI Overviewsの実験を継続しており、サイトへのクリックを促す方向に舵を切りつつある。
- 新設された「さらに読む」セクションは、データ駆動型のレポートや調査記事を訴求する場になる。
- UGC(ユーザー生成コンテンツ)やSNSでの議論がAI Overviews内での可視性を高めている。
特に注目すべきは3つ目だ。SNS上の口コミやRedditのスレッドがAI Overviewsに直接引用されるケースが増えている。商品の評判が可視化されることで、ECサイト運営者は自社サイト外でのブランド管理にも注力する必要がある。
データドリブンコンテンツがリンク獲得の鍵
AIに要約されるだけの情報ではなく、「リンクをクリックしなければ全体像が理解できない」コンテンツこそが、今後の検索流入を維持するために有効だ。具体的には、独自調査データを含む記事や、比較検証レポート、専門家による詳細な分析がこれに該当する。
たとえば、ショッピングカートの放棄率に関する業界平均データと自社の改善施策を組み合わせたレポートや、特定商品カテゴリの価格推移を可視化した調査記事は、AI Overviewsの「さらに読む」リンクに選ばれやすい傾向がある。
伝統的なSEO施策を捨てるべきではない

今回のレポートとGoogleの動きは「希望のシグナル」ではあるが、従来のSEO戦略を即座に放棄する理由にはならない。ゼロクリック検索がやや減少したとはいえ、全体としてのオーガニック検索流入は依然として厳しい状況が続いている。
むしろ、以下のような複合的なアプローチが求められる。
- 従来のSEO施策(技術的SEO、コンテンツ最適化)は継続する。
- YouTubeやRedditなどのプラットフォームでの情報発信を拡大する。購買意思決定に直結するチャネルとして重要性が増している。
- AI Overviewsに引用されることを目的としたデータドリブンコンテンツを新たに制作する。
- SNS上でのブランド評判を定期的にモニタリングし、ネガティブな口コミには誠実に対応する。
検索の世界は確実に変化しているが、基本に忠実でありつつ、新しい潮流に適応していく柔軟性がECサイトの明暗を分けることになるだろう。
この記事のポイント
- ゼロクリック検索は米国で24.5%から22.4%に減少し、オーガニッククリック率は44.9%に上昇した。
- GoogleはAI Overviews内のリンクを拡充し、信頼できる情報源への誘導を強化している。
- ECサイトはデータドリブンな独自コンテンツを制作し、AIに引用される質の高い情報を提供する必要がある。
- SNSやUGCプラットフォームでのブランドプレゼンスが検索可視性に直結する時代に入った。
- 従来のSEO施策を継続しつつ、YouTubeやRedditなど複数チャネルでの展開を強化するのが得策だ。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Chromeが同意なく4GBのAIモデルをダウンロードする問題
Google Chromeがユーザーの明示的な許可なく、約4GBに及ぶGemini Nanoのモデルデータをダウンロードしている事実が明らかになった。このデータは「Prompt API」と呼ばれる新機能のためのものだが、その配信方法と利用規約をめぐって、Web標準の専門家から強い懸念が示されている。
CSS-Tricksの記事によれば、このダウンロードはChromeの標準アップデートの一部として扱われ、ユーザーが削除してもブラウザが自動的に再ダウンロードする仕様だという。2025年5月現在、すでに多くのユーザーのデバイスに配信済みの状態だ。
Chromeが密かにダウンロードするGemini Nanoとは
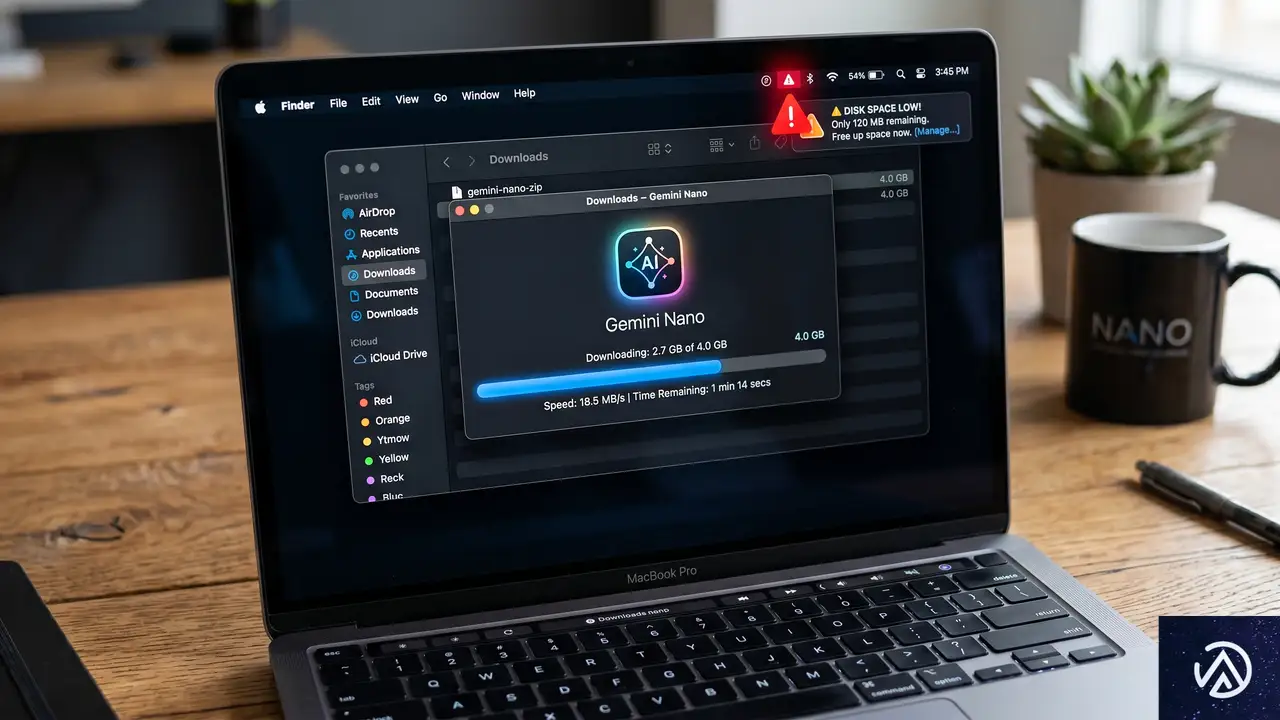
Gemini NanoはGoogleが開発した軽量AIモデルで、デバイス上で直接テキスト生成や要約などのタスクを実行する。クラウドにデータを送信せず、端末のCPUやGPUのみで推論を行うため、プライバシー保護の観点では優れた設計といえる。
問題はその配信方法だ。CSS-Tricksの著者であるMat Marquis氏が指摘したところによれば、この約4GBのデータはChromeの通常アップデートの一部として、ユーザーに何の通知もなく転送される。U2のアルバムがiTunesライブラリに強制的に追加された過去の事例になぞらえ、同意なき配信の奇妙さを強調している。
Gemini Nano(同意なし・通知なし)
削除してもChromeが再ダウンロードを実行するため、ユーザーに実質的な拒否権はない。Chromeの内部機能として扱われているが、実際にはブラウザに統合されたわけではなく、独立した製品が同梱されている状態に近い。Mat Marquis氏は、かつてスパイウェアとして批判されたBonzi Buddyがブラウザに同梱されていた事例を引き合いに出し、その類似性を指摘している。
Prompt APIの仕組みとGoogleの利用制限
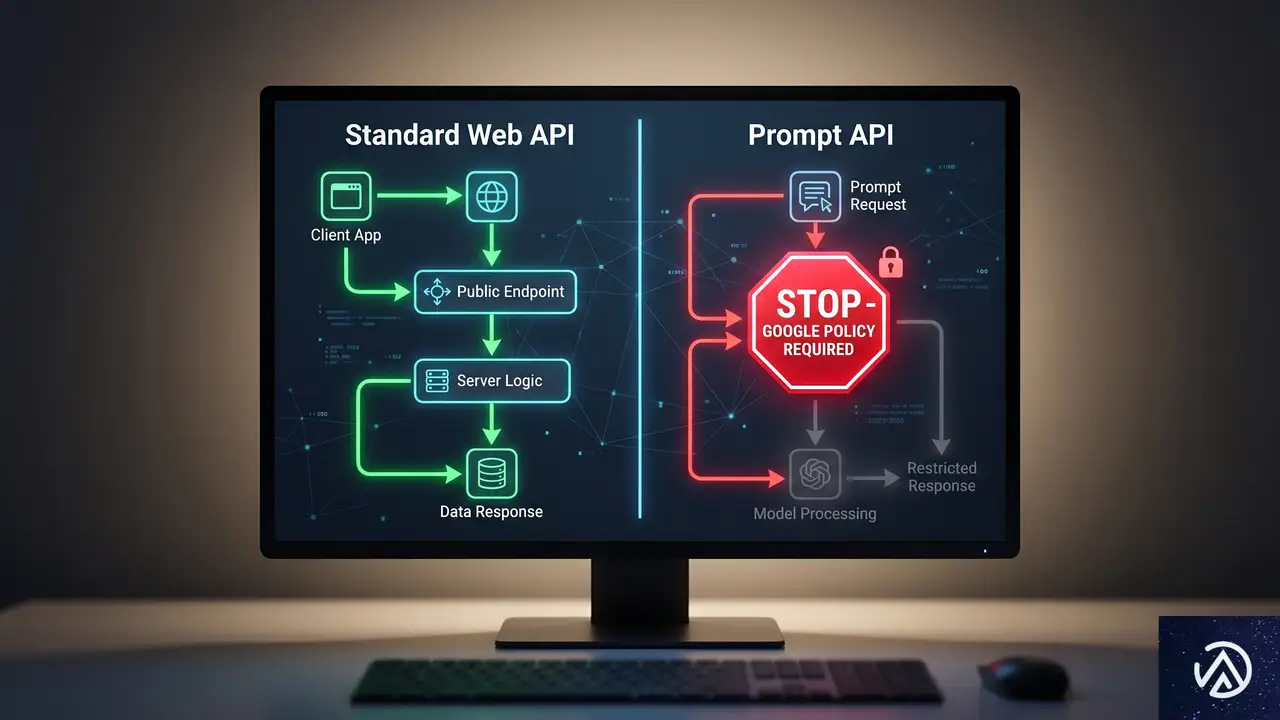
Prompt APIは、Web開発者がChromeの組み込みAIモデルに直接アクセスできるJavaScript APIだ。ユーザーのデバイス上でテキストの要約、文章の言い換え、質問応答といった処理を実行できる。Chromeの開発者向けドキュメントでは、すでに1年以上前から公開されている。
このAPIを利用するには、Googleが定める「Generative AI Prohibited Uses Policy」への同意が必須となる。Mozillaが公式に懸念を表明したのは、この利用ポリシーの内容がWeb標準の原則と相容れないからだ。
Web APIに付随する利用ポリシーの問題点
MozillaのGitHub上のコメントによれば、Googleの禁止事項ポリシーは法律の範囲を超えた制限を含んでいる。具体的には、性的に露骨なコンテンツの生成や配布の禁止、誤情報や政府・民主的プロセスに関する誤解を招く主張の促進禁止などが盛り込まれている。
これらの制限はWebプラットフォームのAPIとしては異例だ。通常、ブラウザAPIは技術的な仕様のみを定義し、その使途を特定企業のポリシーで制限することはない。Mozillaは「これはWebプラットフォームにとって悪しき方向性であり、UA(ユーザーエージェント)固有の使用ルールを持つAPIが増える前例となる」と警告している。
この構造は、Webのオープン性を損なう可能性がある。特定のブラウザベンダーがAPIの利用条件を自由に設定できるなら、Webの相互運用性は徐々に崩れていく。Mozillaの反対表明は、単なる競合他社の立場表明ではなく、Web標準の基本原則を守るための警鐘と受け止めるべきだ。
Web標準プロセスにおけるGoogleの影響力
Mat Marquis氏は、GoogleのWeb標準への関与姿勢を痛烈に批判している。同氏の比喩によれば「GoogleのWeb標準プロセスへの参加は、クマがキャンプに参加するようなものだ」という。つまり、表面上は協調しているように見えても、実質的には自社の都合でプロセスを支配しているという指摘だ。
Googleは「開発者のポジティブな感情」を根拠にPrompt APIの推進を正当化しようとしたが、実際に引用された場所にはポジティブな感情など存在しなかった。この矛盾した説明は、同社がWeb標準を「不可避なもの」として語る際の常套句と重なる。
ブラウザAPIとWeb APIの混同が生むリスク
ここで重要なのは、すべてのブラウザAPIがWeb APIではないという事実だ。Chromeだけが実装するAPIは、事実上の標準として扱われるリスクをはらむ。MicrosoftのIEが独自拡張で市場を支配した過去の過ちを、形を変えて繰り返す可能性がある。
Alex Russell氏が繰り返し指摘しているように、ブラウザの選択肢が限られている現状はすでに問題含みだ。その状況下でGoogleがChrome限定のAI APIを推進することは、Webの多様性をさらに損なう。ブラウザの多様性が生態系に与える影響について、CSS-Tricksでも過去に取り上げられているテーマだ。
ユーザーが取るべき対応と無効化手順
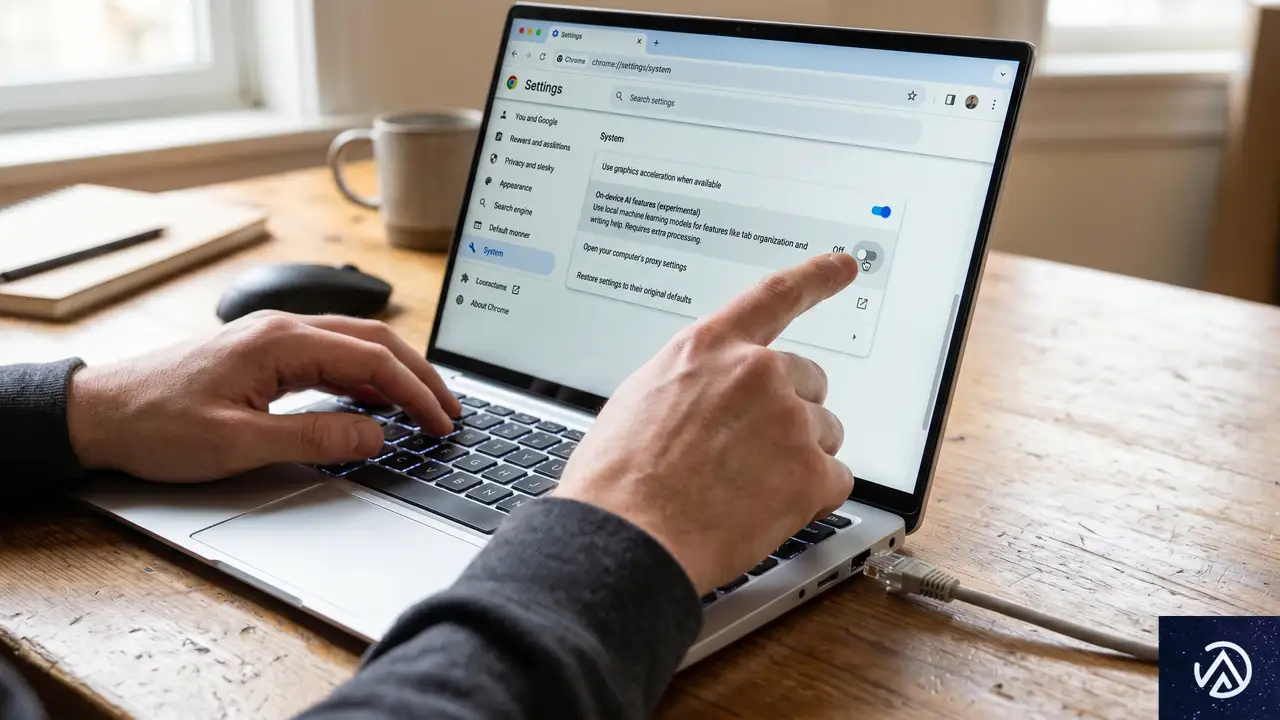
この問題に対して、現時点でユーザーが取れる対応は限られている。Chromeの設定画面で「オンデバイスAI」の項目をオフにすることは可能だが、すでにダウンロードされた4GBのモデルデータを完全に削除し、再ダウンロードを防ぐ方法は提供されていない。
この問題に関する報道は複数のメディアで取り上げられている。Engadgetは「Chromeがユーザーの同意なく4GBのAIファイルをダウンロード」と報じ、Cybernewsは「Chromeが我々のデバイスに静かに4GBのAIモデルをインストールしている」と警告した。Android Authorityでは、このダウンロードがスパイウェアに該当するかどうかの議論まで展開されている。
この記事のポイント
- Google Chromeがユーザーの同意なく約4GBのGemini Nanoモデルをダウンロードしている
- 削除しても自動的に再ダウンロードされ、実質的な拒否手段が提供されていない
- Prompt APIの利用にはGoogle独自のコンテンツポリシーへの同意が必須で、MozillaがWeb標準の観点から反対を表明
- ブラウザベンダー固有のAPI利用制限は、オープンなWebの原則を損なう前例となる危険性がある
- Chrome設定の「オンデバイスAI」から機能自体はオフにできるが、データ削除の確実な方法は提供されていない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google 3月コアアップデートで何が変わったか、集約サイトに逆風で自社サイトに追い風
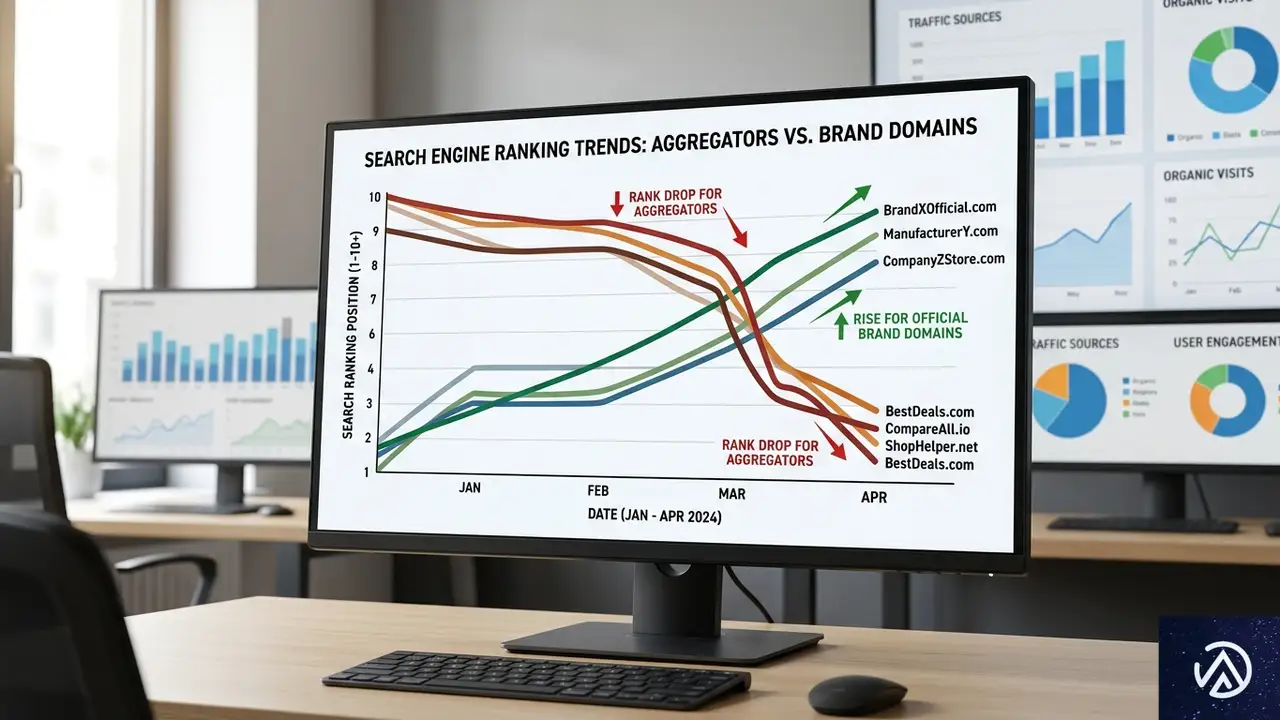
2026年3月に実施されたGoogleのコアアップデートで、検索結果の可視性に大きな地殻変動が起きた。特に影響を受けたのは、YouTubeやRedditに代表される「集約サイト」や「ユーザー投稿型プラットフォーム」だ。これらが軒並み可視性を落とす一方で、ブランドの公式サイトや政府機関ドメインが上昇した。
デジタルマーケティング企業Amsiveの分析によれば、YouTubeは可視性スコアを567ポイントも失い、全ドメイン中最大の下落を記録した。TripAdvisorも45ポイント減、Redditも64ポイント減と、多くの有名サービスが影響を受けている。こうした動きは「情報の一次発信者をより重視する」というGoogleの姿勢を反映したものだと受け止められている。
この記事では、Amsiveの調査データの詳細に加え、業界別の勝ち組・負け組、そして復活パターンまでを解説する。3月のアップデートで自社サイトがどう評価されたかを振り返り、今後のSEO戦略を練るための材料としてほしい。
3月コアアップデートで何が起きたのか
AmsiveはSISTRIX Visibility Indexを用いて、2,000以上のドメインを分析した。分析対象期間は2026年3月27日(ロールアウト開始日)から4月8日(完了日)までである。さらにDataForSEO APIを使い、各ドメインにGoogleの商品分類タグを付与して、業界別の傾向を浮き彫りにした。
ここで言う「可視性スコア」とは、SISTRIXが算出するキーワード単位の表示機会の指標であり、実際のオーガニックトラフィックそのものとは異なる。ただ、大規模なランキング変動を捉えるには十分なデータセットだ。
「情報の一次発信者」を優遇する流れ
Amsiveは今回の変化を「過度にインデックスされていたUGCやアグリゲーターコンテンツに対する是正」と位置づけている。つまり、「ある物事について人々が話し合うプラットフォーム」よりも、「その物事を実際に提供・所有する企業や組織」のサイトを上位に表示しようという補正だ。
この傾向は、旅行、求人、健康など複数の業界で一貫して見られた。たとえば旅行分野では、OTA(オンライン旅行代理店)が集客力を落とし、ホテルチェーンや空港の公式サイトが上昇した。これは、単なるアルゴリズムの一時的な揺らぎではなく、意図的な方向修正である可能性が高い。
このデモで示したように、単なる口コミや他者コンテンツの再掲載ではなく、自社サービスや公式情報そのものを発信するサイトが検索上で優位に立つ構図が鮮明になった。
ドメイン別の勝者と敗者
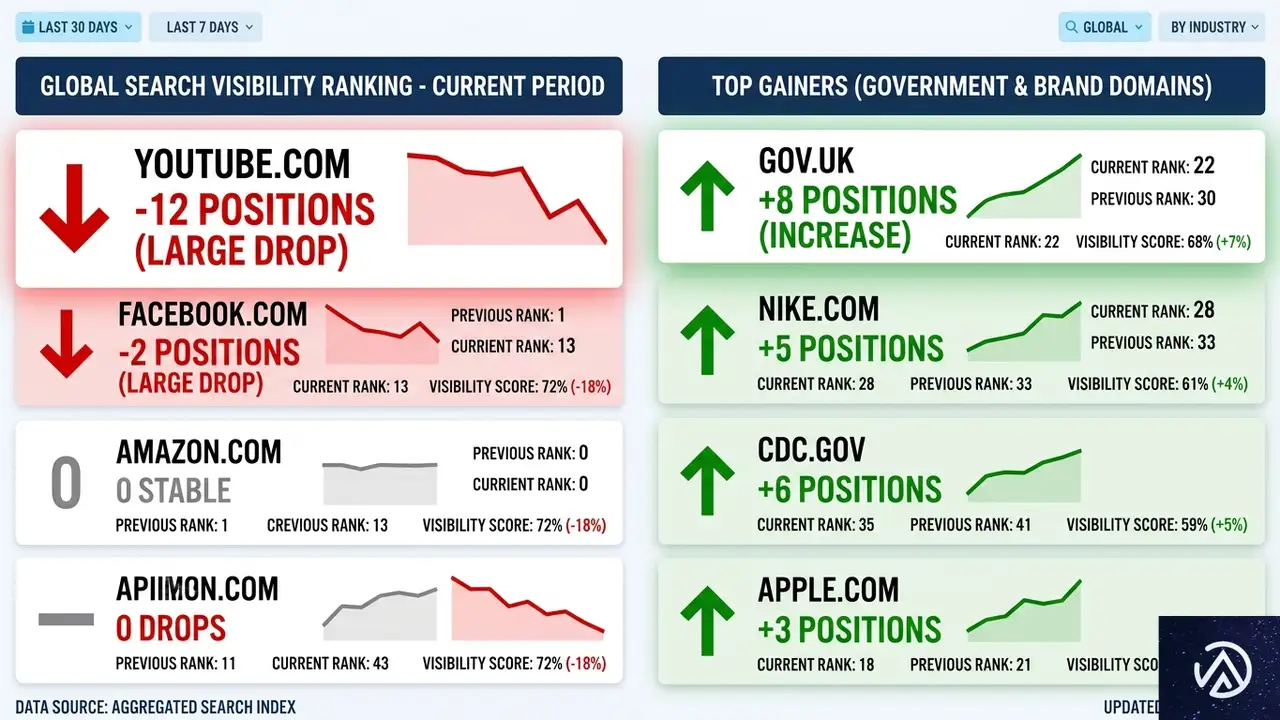
Amsiveのデータセットで最も激しい動きを見せたのはYouTubeだった。可視性スコアを567ポイントも下げており、これは全ドメイン中最大の下落幅である。比較対象として、2025年12月のコアアップデートでWikipediaが経験した435ポイント減よりも約30%大きい。
主要ドメインのスコア変動
以下のリストは、AmsiveがSISTRIXデータから抽出した可視性変動の一部である。
- YouTube 567ポイント減(最大の下げ幅)
- Reddit 64ポイント減
- Instagram 48ポイント減
- X(旧Twitter) 46ポイント減
- TripAdvisor 45ポイント減
- Yelp 33ポイント減
- Expedia 33ポイント減
注目すべきは、YouTubeの下落が「過去の一時的な急騰の反動」である可能性だ。AmsiveのLily Ray氏は、YouTubeの可視性は3月初旬の急上昇前の水準に戻ったに過ぎず、過去最低を更新したわけではないと補足している。つまり、異常値の補正と見ることもできる。
一方で、RedditやXといったテキスト系UGCプラットフォームの低下は構造的だ。これらは2024年から2025年にかけて大幅に検索可視性を伸ばしてきた経緯があり、今回のアップデートはその反動という見方が強い。
この視覚化からもわかるとおり、減少幅ではYouTubeが突出している。それでも、複数のUGC系プラットフォームがまとまってスコアを落とした点が、今回のアップデートの特徴と言える。
業界別の影響 旅行、求人、健康
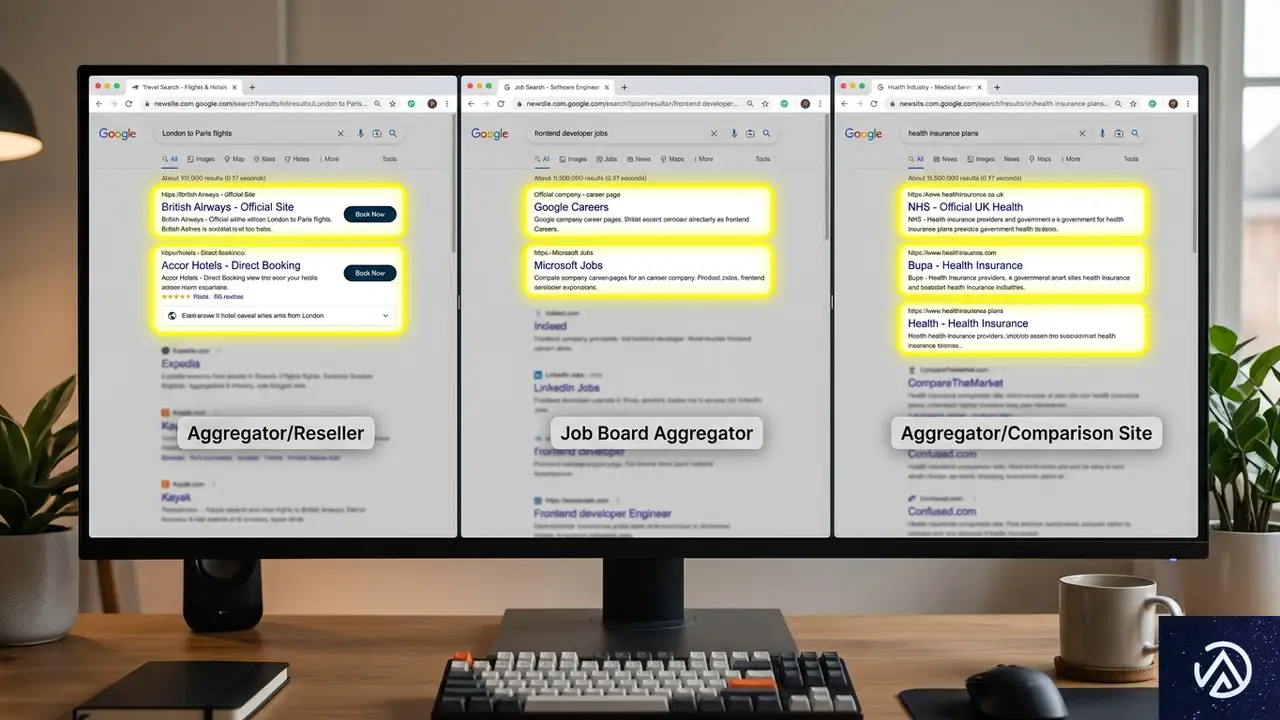
ドメイン単位の分析に加えて、業界カテゴリ別のパターンも明確になった。AmsiveはDataForSEOのAPI経由でGoogle商品分類タグを各ドメインに割り当て、旅行、求人、健康の3分野を重点的に分析している。
旅行分野 OTAが後退しホテル公式が台頭
旅行業界では、TripAdvisor(45ポイント減)、Yelp(33ポイント減)、Expedia(33ポイント減)がそろって下げた。代わりに上昇したのは、ヒルトンの公式サイト(4ポイント増)、Hotels.com(3.6ポイント増)、Trivago(3.2ポイント増)だった。さらに、米国国立公園局のNPS.govが9.9ポイント増、複数の空港公式サイトも大幅に上げている。
これは「旅行先を探す」という行動において、Googleが「個人のレビューを集めたサイト」よりも「宿泊施設や交通機関の公式情報」を優先するようになったことを示唆する。OTAのマーケティング担当者にとっては、SEOの前提を見直す転換点になるかもしれない。
求人分野 雇用主のキャリアページが評価上昇
求人・教育カテゴリでも、Indeed(18ポイント減)、ZipRecruiter(13ポイント減)といった求人アグリゲーターが下げた一方で、米国労働統計局のBLS.gov(5.4ポイント増)、米国政府求人サイトのUSAJobs.gov(16%増)、Disney Careers(59%増)、CVS Health Careers(45%増)といった雇用主直轄のキャリアページや政府系ドメインが目立って上昇した。
求職者が「特定の企業で働きたい」と考えたとき、検索結果の上位に企業の公式採用ページが表示されやすくなった形だ。これにより、求人専門サイト経由での応募導線に依存していた企業は、自社キャリアページのSEO強化が急務となっている。
健康分野 信頼できる公的機関が選ばれる傾向
健康分野では、処方薬割引サービスのGoodRxが55%増(9.5ポイント増)と大幅に伸び、米国国立衛生研究所(NIH.gov)も9.3ポイント増えた。その一方で、クリーブランドクリニックは12ポイント減、WebMDは9ポイント減、メイヨークリニックは6ポイント減と、有名な消費者向け健康情報サイトが軒並み下げた。
ここでの解釈は慎重を要するが、「権威性の高い公的機関の情報」をより重視する動きの一環と見ることができる。医学情報のように正確性が求められるジャンルでは、この傾向が今後も強まる可能性がある。
回復パターンと注意点
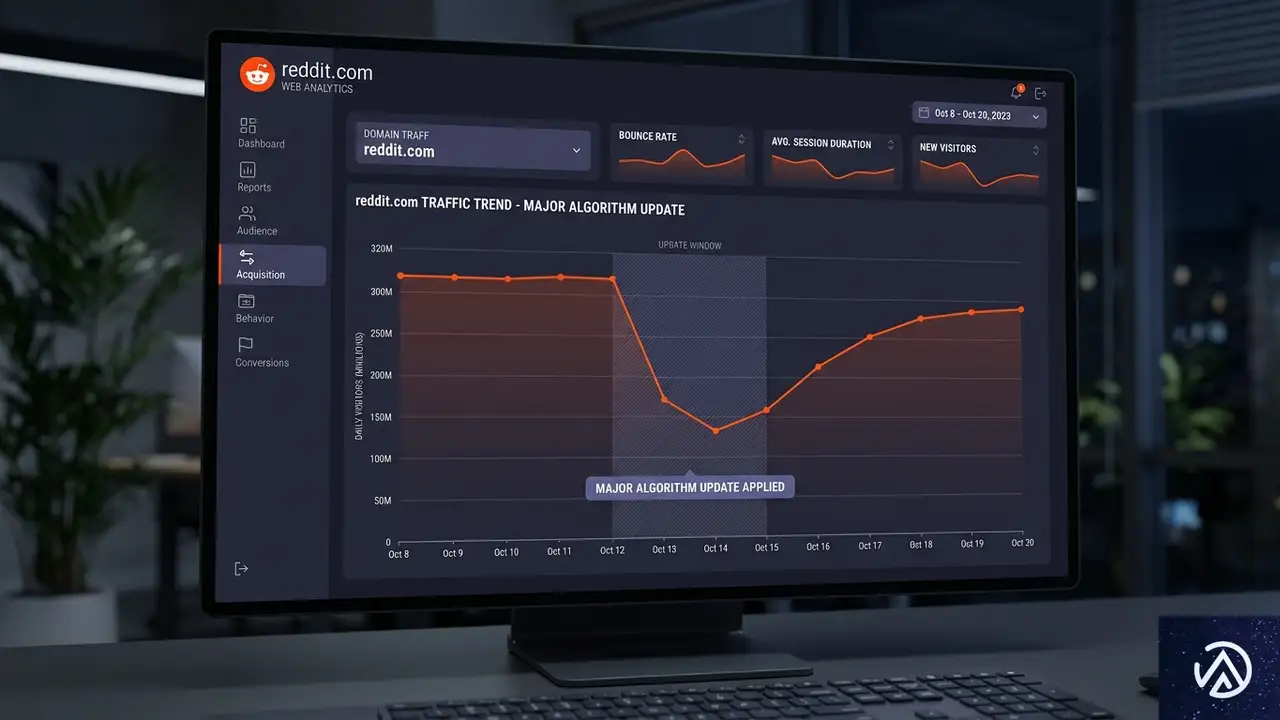
今回の分析で興味深いのは、一部の「敗者」ドメインがアップデート直後に可視性を急回復させた点だ。RedditとIndeedは、ロールアウト完了からほどなくしてスコアを取り戻した。このことから、アップデート期間中のスナップショットだけを見て「負けた」と判断するのは早計であることがわかる。
AmsiveのLily Ray氏も、今回の敗者リストはあくまで「アップデート期間中」の変動を捉えたものであり、その後に各ドメインがどこに落ち着いたかまでは示していないと強調している。SEO担当者は、ランキング変動を確認する際に、少なくともロールアウト完了後1〜2週間のデータを見て判断することが重要だ。
Zyppyの先行分析とも整合
今回のAmsiveによる発見は、同月に公開された別の分析結果とも整合している。ZyppyのCyrus Shepard氏が400以上のサイトを調査したレポートでは、「タスクを完了させる製品・サービスを提供するサイト」がオーガニックトラフィックを伸ばす傾向が示されていた。
手法は異なる。Shepard氏はサードパーティのトラフィック推計データとの相関を測定したのに対し、AmsiveはSISTRIXの可視性スコアをアップデート期間で追跡した。それでも、到達した結論はほぼ同じで、「情報の受け売りではなく、本物の価値を提供するサイト」が評価されるという方向性は確からしい。
さらに、ドイツのデータを用いたSISTRIX独自の分析でも同様の結果が得られている。オンラインショップや便利系サイトが可視性を下げ、公式サイトやブランドドメインが相対的に強かった。この世界的な共通傾向は、Googleがグローバルに同様の評価軸を適用している可能性を示す。
自社サイトへの示唆と対策
今回の一連のデータは、あくまでGoogleが内部で何を変更したかを確定するものではない。しかし、旅行、求人、健康、金融、エンターテインメントという異なる業界で同じパターンが繰り返された事実は重い。これは単発の異常値ではなく、検索エンジンの評価基準に構造的なシフトがあったことを示唆している。
つまり、「他人のコンテンツを集めて並べるだけのサイト」や「ユーザーが自発的に投稿したレビューに依存するサイト」よりも、「その分野の専門知識や実サービスを持つサイト」が優遇される方向へとかじが切られたのだ。
上記の診断フローは、今回のアップデートで評価されたサイトの特徴を整理したものだ。たとえば、自社商品の技術仕様を詳述したページを持っているか、実際の導入事例データを公開しているか。そうした「自社ならではの資産」をコンテンツ化できているかどうかが、これまで以上にSEOの成否を分ける。
また、Cyrius Shepard氏の分析が示す「タスク完了型サイトの優位性」も見逃せない。ユーザーが情報を得たあとに、そのまま資料請求、購入、予約へと進める流れをサイト内で完結させることが、オーガニック検索からの流入増加につながっている。
この記事のポイント
- 2026年3月のGoogleコアアップデートでは、YouTubeやRedditなどの集約サイトが可視性を大幅に下げた
- 旅行、求人、健康の各分野でブランド公式サイトや政府ドメインが評価を上げた
- 一部ドメインはアップデート後に急回復しており、短期的なスコアだけで判断するのは危険
- 自社の一次情報を強化し、タスクをその場で完了できる体験を提供することが今後のSEOの軸になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AI OverviewのCTRが61%減少 クリック数は横ばいという新データ
AI Overview(旧SGE)に自社ページが引用されるとCTR(クリックスルーレート/表示回数に対するクリック率)が大きく下がる。Search Engine Journalが紹介したSeer Interactiveの分析によれば、2025年第4四半期にブランド引用ページのCTRが前期比61%減少した。ところがクリック数そのものはほとんど動いていない。
一見すると深刻な数字だが、ダッシュボードの数字をどう読み解くかで評価は変わる。CTRが下がったからといって、すぐに「検索パフォーマンスが落ちた」と判断するのは早計だ。547万クエリを対象にしたSeerの分析をもとに、数字の裏側にある構造を整理する。
Q4に起きた数字の動き

10月のインプレッション急増がCTRを押し下げた
2025年9月時点で、AI Overview内にブランド引用されたページのインプレッション数は1,580万回、クリック数は398,798回、CTRは2.52%だった。これが10月になるとインプレッションが3,310万回へと倍増する。一方でクリック数は400,271回と微増にとどまり、CTRは1.21%に半減した。
CTRが急落した原因は、クリック自体が減ったわけではない。インプレッションの伸びがクリックの伸びを大きく上回ったことで、計算上のCTRが割り算の結果として下がったにすぎない。Search Engine Journalの記事でも「これはパフォーマンスの崩壊ではなく、クリックより速くインプレッションが成長したことによる数学的な問題だ」と指摘されている。
11月は別のパターン
11月になると傾向が変わる。インプレッションは3,950万回へさらに増えたが、クリック数は301,783回に減少し、CTRは0.76%まで落ち込んだ。インプレッションが増えているのにクリックが減る。10月とは異なる動きだ。
Seerのデータではこの原因を特定できていない。Search Consoleのデータを月ごとに分けて分析することの重要性がここにある。四半期でまとめて「CTR61%減」とだけ見ると、10月の数学的要因と11月の実質的なクリック減が混ざってしまう。
CTR低下に隠れた2つの解釈

Seerの分析が明確に切り分けられなかった点がある。10月のインプレッション急増が「GoogleがAI Overviewを表示するクエリを増やしたから」なのか、「各ブランドがSEO施策で引用を獲得したから」なのかは、集計データだけでは判断できない。
前者なら、検索結果の表示形式が変わっただけで、自社の実力とは関係ないノイズだ。後者なら、SEOの成果として素直に評価できる。多くのサイト運営者はこのどちらかに直面しているはずだ。ダッシュボードのインプレッション増加をどう読むかは、アカウント単位でクエリを掘り下げないとわからない。
CTRが下がったときに確認すべきは、同じ期間のインプレッション数だ。インプレッションが増えているなら、表示機会自体は拡大している。クリック数が横ばいか微増であれば、問題の本質はCTRの低下ではなく、表示回数あたりのクリック効率が薄まったという話になる。
これまでのAI Overview CTR研究との整合性

AI Overview表示時のクリック率は軒並み低い
AI Overviewが表示されるとオーガニック検索結果のCTRが下がることは、複数の調査で報告されている。Ahrefsが1億4,600万件の検索結果を分析した調査では、AI Overviewの表示トリガー率が20.5%に達し、特に情報検索や質問形式のクエリで高いとされた。
ドイツで実施されたSISTRIXの分析では、AI Overview表示時に検索順位1位のCTRが59%低下した。Pew Researchの調査でも、米国ユーザーのクリック率はAI Overview表示時に8%、非表示時は15%だった。AI Overviewが上位を占有することで、その下にある従来の検索結果へのクリックが奪われる構造は、国やクエリタイプを問わず共通している。
引用の有無がクリック効率を左右する
Seerのデータでは、AI Overview内でブランド引用されたページは、引用されていないページよりインプレッションあたりのクリック数が約120%多い。AI Overviewに自社ページが表示されること自体には、一定のクリック獲得効果がある。
ただし、AI Overviewが表示されない通常の検索結果と比べると、引用ページのクリック効率は38%低い。引用は「ないよりはマシ」だが、かつての1位表示の代替にはなっていない。Search Engine Journalはこの点を「引用は助けになるが、以前の順位を取り戻すものではない」と総括している。
実務にどう活かすか

AI Overview関連のCTR低下に直面したとき、まず確認すべきはクリック数の絶対値だ。CTRが下がっていても、クリック数が維持または微増しているなら、それは表示機会の拡大に伴う希釈であり、検索パフォーマンスの低下ではない。
Seerが指摘しているように、ベンチマークはあくまで傾向を示す参考値であり、自社データの実数を見るのが基本になる。インプレッションとクリックの増減を月単位で分解し、CTRだけを追わない分析習慣が求められる。
また、2025年12月から2026年2月にかけてAI Overview表示時のオーガニックCTRが1.3%から2.4%へ上昇したというデータもある。ただしSeerはこれを「回復というより横ばいへの落ち着き」と評価しており、2か月分のデータで先行きを予測するのは避けるべきだとしている。
この記事のポイント
- AI Overviewのブランド引用ページCTRはQ4で61%減少したが、クリック数はほぼ横ばい
- 10月はインプレッション急増による数学的CTR低下、11月は実質的なクリック減と原因が異なる
- インプレッション増がGoogleの仕様変更か自社SEOの成果かは、アカウント単位の分析が必要
- CTRだけを見ず、インプレッションとクリックの絶対数を月別に追うことが実務では重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleへのスパム報告に新ルール。個人情報を含むと処理されない理由
Googleがスパム報告に関する公式ドキュメントを更新し、報告プロセスにおける重要な変更を明らかにした。今後、報告内容に個人を特定できる情報が含まれている場合、Googleはその報告に基づいた調査や対処を行わない方針だ。
この変更は、スパムサイトに対して「手動対策(マニュアルアクション)」が実施される際、報告内容の一部がサイト所有者に共有される仕組みに起因している。Googleはプライバシー保護と法規制への対応を優先し、不適切な情報を含む報告をあらかじめ排除する決断を下した。
SEO担当者やサイト運営者にとって、この変更は単なる手続きの修正ではない。悪質なサイトを排除するための正当な報告が無効化されるリスクを避けるため、報告の作法を再確認する必要がある。
Googleスパム報告の仕様変更。個人情報の記載が「無効」に
Googleは検索結果の品質を維持するため、ユーザーからのスパム報告を受け付けている。しかし、2026年4月に更新されたドキュメントによれば、報告フォームの自由記述欄に個人情報が含まれている場合、その報告は処理されなくなった。これは、報告者が意図せず自身の身元を相手に明かしてしまうリスクを防ぐための措置だ。
なぜ個人情報が含まれると処理されないのか
最大の理由は、Googleがスパムサイトの所有者に送る通知の仕組みにある。Googleが報告に基づいて手動対策を下した場合、その根拠となった情報をサイト所有者に伝えることがある。この際、報告者が記述したテキストがそのまま引用される可能性があるためだ。
もし報告文の中に、報告者の名前や会社名、あるいは特定のサイト運営者であることを示唆する情報が含まれていれば、スパムサイト側に報告者の正体が筒抜けになってしまう。Googleはこのような事態を避けるため、個人情報が含まれる報告自体を「破棄」するというルールを明文化した。
ドキュメントから削除された「匿名性」の記述
以前のドキュメントでは、自由記述欄に個人情報を書かない限り、報告は匿名に保たれるという主旨の記述があった。しかし、今回の更新でこの文言は削除された。代わりに「法規制を遵守するため、手動対策の文脈を理解させる目的で、提出されたテキストをサイト所有者に送信しなければならない」という強い表現が追加されている。
これは、Googleが報告者の匿名性を保証する努力をするのではなく、報告者自身に「特定される情報を一切書かないこと」を義務付けたことを意味する。ルールを守らない報告は、どれほど証拠が揃っていても無視されることになるため、注意が必要だ。
手動対策通知の仕組みと報告者が負うべきリスク
手動対策(マニュアルアクション)とは、Googleの担当者が目視でサイトを確認し、ガイドライン違反と判断した場合に検索順位を下げたり、インデックスから削除したりする処置を指す。このプロセスにおいて、ユーザーからの報告は重要な判断材料の一つとなる。
報告内容がそのまま相手に届くという事実
Googleが違反サイトの運営者に送る通知には、どのような違反があったのかを説明するテキストが含まれる。このテキストに、報告者がフォームに記入した内容が「原文のまま」転載されるケースがある。これは、違反者が自サイトのどこに問題があるのかを正確に把握させ、修正を促すための透明性を確保する目的で行われる。
しかし、この透明性が報告者にとってはリスクとなる。例えば「私のサイトの画像を盗用している」といった文言で報告すれば、相手は即座に報告者が誰であるかを特定できる。このような情報の流出は、報告者への逆恨みやさらなる攻撃を招く恐れがある。
情報の流れを視覚化する
スパム報告がどのように処理され、どの段階で情報が共有されるのかを整理しておくことは重要だ。以下のデモは、不適切な報告と適切な報告で情報の伝わり方がどう変わるかを示している。
このデモのように、自分を特定する情報を削ぎ落とし、客観的な事実のみを伝えることが、報告を有効にするための鉄則だ。
プライバシー保護と透明性のジレンマ。Googleの狙い
Googleがなぜこのような厳しいルールを設けたのか。その背景には、欧州のGDPR(一般データ保護規則)をはじめとする、世界的なプライバシー保護規制の強化がある。個人データの取り扱いには極めて慎重な対応が求められており、検索エンジンも例外ではない。
法規制への対応とユーザー保護の両立
GDPRなどの法規制下では、データの主体(この場合はサイト所有者)は、自分に関するどのような情報が収集され、誰から提供されたのかを知る権利を持つ場合がある。Googleが「報告文を相手に送る」としているのは、こうした法的要求に応えるための苦肉の策とも言える。
一方で、報告者の身の安全を守る必要もある。そこでGoogleが導き出した答えが、「個人情報が含まれる報告は最初から受け取らない(処理しない)」というフィルタリングだ。これにより、法的義務を果たしつつ、報告者が不用意に特定される事態を未然に防いでいる。
「質の高い報告」を求めるGoogleの姿勢
今回の変更は、スパム報告の「質」を向上させる狙いもあると考えられる。感情的な訴えや個人的な利害関係を排除し、アルゴリズムやガイドラインに照らして何が違反なのかを論理的に説明する報告を、Googleは求めている。
報告が無効化される条件を明確にすることで、Google側の処理コストも削減される。明らかにガイドラインを理解していない報告や、嫌がらせ目的の報告を、情報の形式だけで自動的に弾くことができるからだ。
効果的なスパム報告を行うための実践的なアドバイス
スパムサイトによって検索順位を下げられたり、コンテンツを盗用されたりした場合、冷静に報告を行うのは難しい。しかし、確実にGoogleに対処してもらうためには、以下のポイントを意識してフォームを記入する必要がある。
匿名性を保ちつつ証拠を提示するコツ
まず、一人称(私、弊社など)や固有名詞を避けることだ。例えば「私のサイトのこの記事がコピーされた」と書くのではなく、「該当URLのコンテンツは、別のドメイン(URLを提示)のオリジナルコンテンツを無断で複製している」といった書き方にする。
次に、違反の種類を具体的に指摘することだ。単に「スパムだ」と主張するのではなく、「隠しテキストが使用されている」「リンクプログラムに参加している」「クローキングが行われている」など、Googleのスパムポリシーに基づいた用語を使うと、担当者の理解が早まる。
報告文のチェックリスト
送信ボタンを押す前に、以下の項目が含まれていないか確認しよう。一つでも当てはまる場合は、処理されない可能性が高い。
- 自分の氏名や会社名、部署名
- 自分のメールアドレスや電話番号
- 自分が管理しているサイトのドメイン名(証拠として必要な場合を除く)
- 相手を非難する感情的な言葉
- 過去のやり取りや個人的なトラブルの経緯
独自の分析。SEO担当者が今後意識すべき報告の作法
今回のGoogleの対応は、SEO業界における「スパム報告」の立ち位置を大きく変える可能性がある。これまでは「困った時の神頼み」のような側面もあったが、今後はより専門的で客観的な「証拠提出」の場へと変わっていくだろう。
競合への嫌がらせ対策としての側面
この新ルールは、競合サイトを陥れるための「虚偽の報告」に対する牽制にもなる。報告内容が相手に公開される可能性がある以上、安易な嘘や根拠のない誹謗中傷は、報告者自身の首を絞めることになるからだ。Googleは情報の透明性を高めることで、報告システム自体の健全性を保とうとしている。
AI時代におけるスパム報告の価値
AIによって生成された低品質なコンテンツが急増する中、Googleのアルゴリズムだけですべてを検知するのは難しくなっている。人間の目による「これはスパムだ」というフィードバックの価値はむしろ高まっていると言えるだろう。
だからこそ、私たちは「正しい報告の作法」を身につけるべきだ。適切な形式で、個人情報を排除し、事実に基づいた報告を行うことは、検索エンジンのエコシステムを守るための貢献にもなる。今回の仕様変更を機に、社内での報告フローやテンプレートを見直してみるのも良いだろう。
この記事のポイント
- Googleへのスパム報告に個人情報が含まれている場合、調査は行われず破棄される。
- 手動対策が実施される際、報告文がそのままサイト所有者に共有されるリスクがあるためだ。
- 報告文には自分の名前や会社名を入れず、客観的な事実と違反箇所のみを記述する。
- この変更は、プライバシー保護規制への対応と報告システムの健全化を目的としている。
- 正当な報告を有効にするため、送信前のセルフチェックがこれまで以上に重要となる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
生成AIの普及率は3年で53%に到達。PCやネットを超える速度がSEOに与える衝撃
スタンフォード大学の人間中心人工知能研究所(HAI)が、最新の調査報告書「2026 AI Index Report」を公開した。このレポートは400ページを超え、技術的パフォーマンスから投資状況、労働市場への影響まで多岐にわたるデータを網羅している。
報告書の中で最も大きな反響を呼んでいるのが、生成AIの普及スピードだ。ChatGPTのリリースからわずか3年で、世界人口の53%が生成AIを採用するに至った。これは、かつてのパーソナルコンピュータ(PC)やインターネットが辿った普及速度を大きく上回る数字である。
検索エンジン最適化(SEO)に携わる実務者にとって、この急速な変化は無視できない。ユーザーの検索行動が根本から塗り替えられつつある現状において、データの背後にある真実を理解することが、これからの戦略を左右するだろう。
生成AIの普及速度はPC・インターネットを凌駕
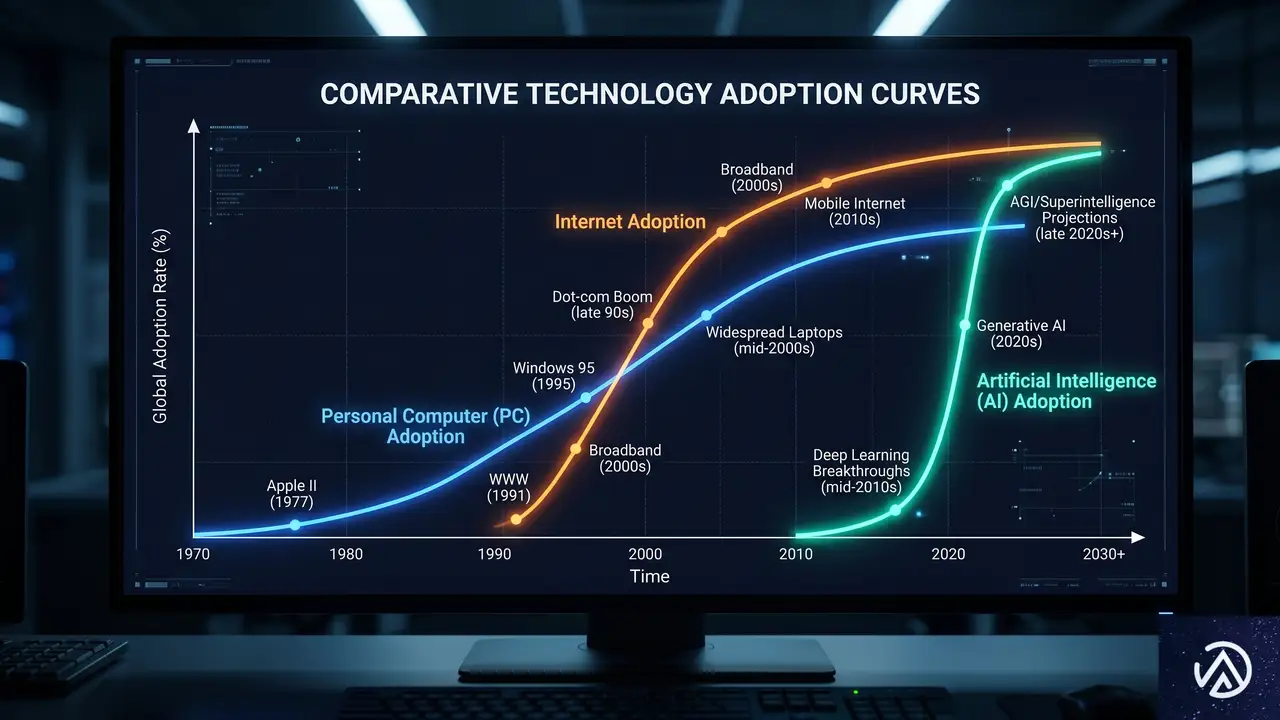
生成AIの普及は、過去のどの技術革新よりも速い。レポートによれば、主要なテクノロジーが一般に浸透するまでの期間を比較した際、生成AIの立ち上がりは際立っている。1981年のIBM PC登場や1995年のインターネット商用化と比較しても、普及曲線は急峻だ。
なぜこれほどまでに速いのか
この爆発的な普及には、先行したインフラの存在が大きく寄与している。ハーバード大学のデビッド・デミング氏は、AIが既存のPCやインターネットの上に構築されたツールであることを理由に挙げている。ユーザーは新しいハードウェアを購入する必要がなく、すでに手元にあるスマートフォンやPCから即座にアクセスできたためだ。
水道や電気が通っている家に、新しい蛇口を取り付けるような手軽さが、53%という驚異的な数字を支えている。インフラ整備の時間を飛び越えて、アプリケーションとしての利便性だけが先行して広がった結果といえる。
「普及」の定義と実態の差
ただし、この53%という数字を鵜呑みにするのは注意が必要だ。レポートでは、一度でもChatGPTなどのツールを試したユーザーも「採用者」としてカウントされている可能性がある。毎日8時間フル活用している専門家と、一度だけ挨拶を入力してみただけのユーザーが同列に扱われている側面がある。
また、国によっても普及率には大きな開きがある。スタンフォードのデータでは米国の普及率を28%としているが、セントルイス連邦準備銀行の調査では54%と、倍近い開きが出ている。これは調査の質問順序や定義の微妙な違いによるものだ。SEO担当者は、数字の大きさに圧倒されるのではなく、ユーザーが「どれほど深く、どのような文脈で」AIを使っているのかを注視すべきである。
能力の「ギザギザのフロンティア」と検索の不安定さ
AIの能力向上は目覚ましいが、その進化は均一ではない。レポートでは「ギザギザのフロンティア(Jagged Frontier)」という概念を用いて、AIの得意不得意が極端に分かれている現状を説明している。
高度な知性と単純なミスが同居する現状
最新のAIモデルは、博士レベルの科学問題や数学の難問で人間を凌駕するスコアを叩き出す。しかしその一方で、アナログ時計の針を正しく読み取るという単純なタスクにおいて、正解率が10%を切るようなケースも報告されている。複雑な推論は得意だが、直感的な視覚理解や多段階の計画立案には依然として課題が残っているのだ。
この「能力のムラ」は、検索体験にも直結している。特定の専門的な質問には驚くほど正確な回答を返す一方で、日常的な事実関係の確認で突拍子もない間違い(ハルシネーション)を犯す。AI Index運営委員会のレイ・ペロー氏は、ベンチマークテストの結果が必ずしも実世界の業務での信頼性を保証するものではないと警鐘を鳴らしている。
AI検索結果の不確実性をどう捉えるか
SEOの現場では、Googleの「AI Overviews(AIによる概要)」や「AI Mode」の挙動がクエリによって大きく変動することが確認されている。Ahrefsの調査によれば、同じクエリであってもAI OverviewsとAI Modeが参照するURLの重複率はわずか13%に過ぎない。システムごとに異なる情報源を選択しており、その基準は依然として不透明だ。
Googleのロビー・スタイン氏は、ユーザーが反応を示さない場合、AIによる回答を意図的に抑制していることを認めている。つまり、AI検索の表示は固定されたものではなく、ユーザーのエンゲージメントに応じて動的に変化する不安定なものだ。私たちは、特定のキーワードで「AIに選ばれる」ことの難しさと、その持続性の低さを認識しなければならない。
※既存の情報を要約しただけで、具体的な戦略や独自性がない。
※実体験と具体的な数字に基づき、AIには真似できない価値を提供している。
このデモは、AIによる一般的な要約と、人間が提供すべき独自情報の違いを視覚化したものだ。
低下する透明性とブラックボックス化するSEO
SEO業界にとって最も懸念すべきデータの一つが、AIモデルの「透明性の低下」だ。レポートによれば、主要なAIモデルの透明性指数は、1年間で58から40へと急落した。モデルが高度になればなるほど、その中身が隠される傾向にある。
公開されないトレーニングデータ
Google、Anthropic、OpenAIといった主要プレイヤーは、最新モデルのトレーニングデータセットのサイズや、トレーニングに要した期間の開示を停止している。2025年にリリースされた著名なAIモデル95個のうち、トレーニングコードを公開したのはわずか15個にとどまる。
これは、検索エンジンのアルゴリズムがかつてないほど「ブラックボックス化」していることを意味する。どのようなコンテンツが評価され、なぜそのURLが引用されたのかという根拠を、プラットフォーム側が説明しなくなっているのだ。最適化のヒントが減り、推測に頼らざるを得ない領域が増えている。
「説明できない」アルゴリズムへの対策
透明性が失われる中で、SEO担当者が取るべき道は「アルゴリズムのハック」から「ユーザー価値の構築」へのシフトだ。レポート内では、AIに対する一般市民の信頼が低下していることも示されている。特に米国の公的機関によるAI規制能力への信頼度は31%と低い。
プラットフォームが詳細を明かさない以上、私たちは「AIが何を好むか」ではなく、「ユーザーが何を信頼するか」に立ち返る必要がある。AIによる回答が不透明で説明責任を果たせないからこそ、発信者の顔が見え、根拠が明示されたコンテンツの価値が相対的に高まっていく。透明性の欠如を、自サイトの透明性向上で補う戦略が求められる。
労働市場の変化と「独自の価値」の再定義
AIの普及は、コンテンツ制作の現場にも直接的な影響を及ぼしている。レポートが指摘する労働市場の変化は、Web制作やSEOに携わるチームの構成にも示唆を与えている。
若手エンジニアの雇用減少が示唆するもの
22歳から25歳のソフトウェアデベロッパーの雇用が、2024年以降で約20%減少したというデータがある。一方で、経験豊富なシニア層の雇用数は維持、あるいは増加傾向にある。これは、AIが「ジュニアレベルの定型業務」を代替し始めている可能性を示唆している。
SEOやライティングの分野でも同様のことがいえる。既存の情報を整理し、無難な構成で記事を書くといったエントリーレベルの仕事は、AIによって急速に置き換えられている。20%の雇用減少という数字は、単なる不況の影響だけでなく、業務プロセスの構造的な変化を反映していると見るべきだ。
AIに代替されない「ゴールデン・ナレッジ」
こうした状況下で提唱されているのが、シェリー・ウォルシュ氏らが言及する「ゴールデン・ナレッジ(黄金の知識)」という概念だ。これは、AIのトレーニングデータには含まれていない、独自の調査データや実体験、深い洞察に基づくコンテンツを指す。
スタンフォードのレポートが示す「AIの普及」と「能力のムラ」は、この戦略の正しさを裏付けている。AIは広く普及したが、その回答は依然として不安定で、深みに欠ける。AIがどれほど速く情報を要約しても、その元となる「新しい事実」を作り出すことはできない。一次情報の発信者としての地位を確立することが、AI時代を生き抜くための構造的なアドバンテージとなる。
2026年以降のSEO戦略(独自の分析)
スタンフォードのレポートから読み解ける未来は、AIと共存しつつ、その「隙間」を埋める戦略の重要性だ。AI Overviewsが月間15億人のユーザーにリーチし、AI Modeが日常化する中で、従来の「検索順位」という指標だけでは不十分になっている。
まず、モニタリングの単位を細分化する必要がある。AIの能力が「ギザギザ」である以上、カテゴリー単位の分析では実態を見誤る。特定のクエリでは正確な回答が出るが、少し表現を変えるだけでハルシネーションが起きる。この不安定さを逆手に取り、AIが正しく答えられない「複雑で多面的な問い」に対して、人間が最高の回答を用意しておくべきだ。
次に、検索コンソールなどのツールに頼りすぎない姿勢も重要だ。現在のツールでは、AI Overviews経由のトラフィックと通常の検索トラフィックを明確に分離して把握することが難しい。不透明なプラットフォームに依存するリスクを分散するためにも、SNSやメールマガジンといった、ユーザーと直接つながる「脱検索エンジン」のチャネル強化を並行して進めるべきだろう。
最後に、AIの普及速度を脅威ではなく「機会」として捉え直したい。53%の人がAIを使うということは、それだけ多くの人が「迅速な回答」を求めている証拠だ。しかし、迅速さと正確さは必ずしも両立しない。人々がAIの回答に物足りなさを感じたとき、真っ先に参照される「信頼の拠点」になれるかどうかが、2026年以降の勝負を分けることになる。
この記事のポイント
- 生成AIはChatGPT登場から3年で53%の普及率に達し、PCやネットを凌駕する速度で浸透している。
- AIの能力は「ギザギザのフロンティア」と呼ばれ、高度な推論と初歩的なミスの同居が検索結果の不安定さを招いている。
- AIモデルの透明性は低下しており、トレーニングデータやアルゴリズムのブラックボックス化が加速している。
- 労働市場では若手の定型業務がAIに代替され始めており、SEOでも「独自の一次情報」の価値が相対的に高まっている。
- 今後のSEOは、AIが苦手とする領域を特定し、ユーザーとの直接的な信頼関係を構築する戦略への転換が不可欠だ。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

MetaがGoogleの広告収益を逆転へ!2026年に起きる歴史的転換の背景とSEO・広告戦略への影響
デジタル広告の世界で、長らくトップに君臨してきたGoogleの牙城がついに崩れようとしている。2026年、Metaの広告収益がGoogleを追い抜き、世界シェア1位に躍り出る見通しが明らかになった。これは単なる収益の逆転ではなく、広告の仕組みそのものが「検索」から「AIによる自動最適化」へとシフトしている現実を物語っている。
米調査会社のEmarketerが発表した予測によれば、2026年のMetaの広告収益は2,434億6,000万ドル(約37兆円)に達する見込みだ。対するGoogleは2,395億4,000万ドルにとどまり、僅差ながらも首位が入れ替わることになる。Googleがデジタル広告のトップから陥落するのは、同社が市場を支配して以来、初めての出来事だ。
この変化は、Webサイトを運営する企業や個人にとって無視できない兆候といえる。ユーザーの行動がGoogle検索から、InstagramやFacebook、WhatsAppといったSNS上の「発見」へと移り変わっているからだ。本記事では、この歴史的な逆転劇の背景と、今後のWebマーケティングに与える影響を深掘りしていく。
数字で見る広告市場の勢力図塗り替え

広告収益のシェアで見ると、その変化はより鮮明になる。2026年、Metaは世界のデジタル広告支出の26.8%を占めると予測されている。一方で、Googleのシェアは26.4%まで低下する見込みだ。かつてはGoogleが圧倒的な差をつけていたが、この数年でMetaが猛烈な勢いで差を詰めてきた結果である。
Googleの成長鈍化とMetaの加速
Googleの広告ビジネスが停滞しているわけではない。検索広告やYouTube広告は依然として巨大な収益源だが、その成長スピードが以前に比べて緩やかになっている。背景には、検索市場の成熟と、後述するAI検索の台頭による不確実性がある。既存の検索広告モデルが、かつてのような爆発的な伸びを維持できなくなっているのだ。
対照的に、MetaはAIを活用した広告運用の自動化に成功し、収益を飛躍的に伸ばしている。特に「Advantage+」などのAIツールが、広告主にとっての投資対効果(ROI)を劇的に改善させた。人間が細かくターゲットを設定しなくても、AIが最適なユーザーに広告を届ける仕組みが、企業の予算を引き寄せている。
マクロ経済が後押しするパフォーマンス広告
世界的な経済の先行き不透明感も、この逆転を後押ししている。景気が厳しくなると、企業は「認知」を目的としたブランディング広告よりも、直接的な「売上」につながるパフォーマンス広告を優先する傾向がある。Metaの広告プラットフォームは、ユーザーの興味関心に基づいた高精度なターゲティングが可能であり、より短いスパンで成果を証明しやすい。この「測れる成果」こそが、現在の市場で最も求められている価値だといえる。
なぜMetaがGoogleに競り勝つのか

Metaが勝利を収めつつある最大の要因は、広告運用の「手軽さ」と「精度の高さ」の両立にある。Google検索広告は、適切なキーワードを選定し、競合の入札状況を監視するなど、運用に一定のスキルと工数が必要とされる。しかし、Metaの最新の広告システムは、クリエイティブ(画像や動画)を用意するだけで、あとはAIがすべてを最適化してくれるレベルに達している。
AIによる「運用の民主化」
Metaは広告主に対し、AIを使ってターゲット設定やクリエイティブの生成を自動化する機能を次々と提供している。これにより、専門の広告運用担当者がいない中小企業でも、大企業に引けを取らない成果を出せるようになった。この「運用の民主化」が、Metaの広告主の裾野を大きく広げている。
● ターゲット層の細かな手動設定
● 入札単価の頻繁な調整
★ 画像・動画の自動バリエーション生成
★ リアルタイムでの予算最適化
この図は、広告運用の手間がAIによっていかに削減され、成果へと直結するようになったかを示している。
「検索」を必要としない発見のプロセス
Googleの強みは「ユーザーが何かを探している瞬間」を捉えることにある。しかし、Metaは「ユーザーが気づいていなかった欲しいもの」を提示することに長けている。SNSのタイムラインを流れるパーソナライズされた広告は、ユーザーにとって受動的な発見をもたらす。検索という能動的なアクションを必要としないこのプロセスは、スマホ時代の消費行動に極めて適合している。
Googleが直面する三重苦

王座を明け渡す形となるGoogleだが、同社は現在、非常に困難な舵取りを迫られている。主な要因は、AIによる検索体験の変化、法的な規制、そして主力事業の成熟という3つの課題だ。
AI検索(SGEなど)による広告モデルの破壊
PerplexityやChatGPTのようなAI回答エンジン、そしてGoogle自身が導入を進める「AI Overviews(旧SGE)」は、従来の検索広告のあり方を根底から変えようとしている。AIが直接回答を提示することで、ユーザーは検索結果のリンクをクリックする必要がなくなる。これは、クリック課金で収益を上げてきたGoogleにとって、自らのビジネスモデルを破壊しかねないリスクを孕んでいる。
独占禁止法を巡る法廷闘争
Googleは米国や欧州で、広告技術における市場独占を巡る厳しい監視下に置かれている。複数の訴訟が進行中であり、最悪の場合、広告事業の分割を命じられる可能性もゼロではない。こうした法的なリスクは、同社の積極的な事業拡大の足かせとなっており、投資家や広告主の心理に影を落としている。
YouTubeの競争激化
Googleのもう一つの柱であるYouTubeも、TikTokという強力なライバルの出現により、若年層の視聴時間と広告予算を奪われている。ショート動画市場での競争は激しさを増しており、かつてのような独走状態ではない。MetaもInstagramのリール(Reels)を通じてこの分野で強く対抗しており、動画広告の予算もMetaへと流れる要因となっている。
Web担当者が取るべき今後の戦略

広告収益のシェアが逆転するということは、ユーザーの関心がどこに集まっているかを示す指標でもある。これからのWebマーケティングでは、Google検索だけに頼るのではなく、プラットフォームの変化に合わせた柔軟な予算配分と戦略の構築が求められる。
マルチチャネルでの予算配分の再考
もし現在の集客をGoogle検索広告に依存しているなら、Meta広告への予算分散を検討する時期だ。特に、AIによる自動運用ツール(Advantage+など)を積極的に活用し、自社のデータとAIを組み合わせた最適化を試すべきである。Googleが弱体化するわけではないが、Metaの方が「安く、広く、正確に」リーチできるケースが増えている事実は無視できない。
「検索される」から「見つけられる」コンテンツ作り
SEO(検索エンジン最適化)の重要性は変わらないが、その定義は広がりつつある。これからはGoogleの検索窓に入力される言葉を狙うだけでなく、SNSのアルゴリズムに「おすすめ」として選ばれるためのコンテンツ作りが必要だ。視覚的に訴求力のある画像や、数秒で価値が伝わる縦型動画の制作は、もはやSNS担当者だけの仕事ではなく、Webマーケター全体の必須スキルとなっている。
独自の分析:広告は「意図」から「予測」へ

今回の逆転劇を分析すると、広告の本質的な価値が「ユーザーの意図に応えること」から「ユーザーの行動を予測すること」へと移行したことがわかる。Googleは、ユーザーが入力したキーワードという「明確な意図」を収益化してきた。しかしMetaは、膨大な行動データから「次に何に興味を持つか」をAIで予測し、意図が生まれる前に先回りして広告を提示する。
この「予測型広告」の勝利は、現代人が「探す」という手間を極限まで嫌っていることを示唆している。Webサイトの運営においても、ユーザーに検索させて情報を探させる構造よりも、パーソナライズされたおすすめを提示するような体験の提供が、今後のコンバージョン率を左右する鍵になるだろう。
この記事のポイント
- 2026年にMetaの広告収益がGoogleを上回り、世界シェア1位になる見通しだ
- Metaの勝因はAIによる広告運用の自動化であり、高いROIが広告主を惹きつけている
- GoogleはAI検索の台頭や独占禁止法の訴訟など、構造的な課題に直面している
- Web担当者は「検索」だけでなく、SNSでの「発見」を重視した戦略への転換が必要だ
- 今後のマーケティングは、ユーザーの意図を待つのではなく、行動を予測するアプローチが主流になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google特許が示す検索の新たな層——AI生成ランディングページの衝撃
Googleが取得した特許が、検索エンジンの未来像に大きな一石を投じた。特許の内容は、ユーザーの検索クエリとコンテキストに応じて、AIがその場でランディングページを生成するシステムだ。
この技術が実用化されれば、検索結果と従来のウェブサイトの間に、新たな「層」が出現することになる。EC事業者やコンテンツ発信者は、自社サイトのデザインやメッセージングをユーザーに直接届ける機会を、さらに奪われる可能性がある。
本記事では、特許の内容を詳細に読み解き、検索の進化の歴史に照らし合わせてその意味を考察する。さらに、この変化に対応するためにEC事業者が今から取り組むべき具体的な対策を提示する。
特許が描く「AI生成ランディングページ」の仕組み

ユーザーごとに最適化されたページを動的生成
2026年1月27日に米国特許商標庁から発行された特許「US12536233B1」は、AI生成コンテンツページに関するものだ。特許が示すシステムの核は、検索クエリとユーザー情報を基に、そのユーザー専用のランディングページを動的に生成する点にある。
システムはまず、検索クエリとユーザーのコンテキスト、そして従来のランキングアルゴリズムが選び出した候補となるランディングページ群を評価する。評価基準は多岐にわたり、商品情報の不足、コンテンツの薄さ、ナビゲーションの弱さ、ユーザーエンゲージメントの低さなどが低評価の要因となる。
評価の結果、既存ページが不十分と判断されると、システムはそれらのページを「素材」として使い、個々のユーザー向けに最適化された新たなバージョンのページを生成する。例えば、全く同じ「ランニングシューズ」というクエリを検索した二人のユーザーが、異なるランディングページに誘導される可能性がある。一人には商品比較表を中心にしたページが、もう一人には直接購入に導くページが表示されるかもしれない。
フィードバックループによる継続的改善
特許が示すもう一つの重要な要素は、フィードバックループだ。生成されたページは静的なものではない。ユーザーのクリック、ページ滞在時間、コンバージョンなどの行動データがシステムにフィードバックされ、将来生成されるページの精度を高めるために利用される。
この仕組みにより、Googleは膨大な数のユニークなページを生成し、それぞれの検索者をカスタマイズされたバージョンに誘導する動的な体験を提供できる。特に商品検索に関連するクエリでは、購入オプションを前面に押し出したページが生成される可能性が高い。
Practical Ecommerceの記事によれば、この動的ページ実現への現実的な経路は、既に導入されている「AIオーバービュー」を通じたものだと考えられる。AIオーバービューは情報を要約して提示するが、次のステップとして、その要約をインタラクティブな体験に拡張し、最終的には独立したウェブページとして展開する流れが想定される。
検索進化の歴史から見る「新たな層」の位置付け

検索とコンテンツの関係性の変遷
ECコンサルタントのGreg Zakowicz氏は、この特許の概念を「検索の経済学における新たな層」と表現した。この「層」という考え方は、検索エンジンとウェブサイト所有者の間の力関係の変化を理解する上で有効だ。
かつては、検索プラットフォームとコンテンツ所有者は相互依存の関係にあった。プラットフォームは質の高いコンテンツを必要とし、コンテンツ所有者はプラットフォームからのトラフィックを必要とした。しかし、検索産業の進化は、顧客と事業者を次第に引き離す方向に進んでいる。
この図が示すように、モノetization(広告)、Answers(ナレッジグラフ)、Evaluation(リッチリザルト)、Extraction(特集スニペット)、Interaction(垂直検索)、Synthesis(AIオーバービュー)と、各層が追加されるごとに、ユーザーが元のウェブサイトに直接アクセスする必要性は薄れてきた。AI生成ランディングページは、この流れの延長線上にある「最終的な層」と言えるかもしれない。
「検索の経済学」の変化が事業者に与える影響
Zakowicz氏が指摘する「検索の経済学」の変化とは、トラフィックと収益の流れの再分配を意味する。新しい層が出現するたびに、ウェブサイト所有者がレイアウト、メッセージング、商品提示をコントロールする影響力は弱まる。ユーザー体験は、ますますアルゴリズムによって組み立てられるものになる。
Practical Ecommerceの記事は、この状況を「サイトはGoogleの検索結果ページにおいてほとんどコントロールを失っている」と表現する。検索結果ページ自体が、外部サイトへの単なる入り口ではなく、完結した体験の場へと変貌しつつある。
EC事業者が取るべき具体的な対策

オウンドメディアと直接的な顧客関係の構築
アルゴリズムが仲介する体験の影響力が強まる中で、事業者が取るべき第一の対策は、自分自身でコントロールできるチャネルを強化することだ。具体的には、メールマーケティングやSMSなどのオウンドメディアが該当する。
ニュースレターやマーケティングメッセージを通じてサイトに訪れるユーザーは、アルゴリズムが組み立てたページではなく、ブランドそのものを選択して訪問している。検索プラットフォーム内で行われる発見が増えるほど、このような直接的な接点は「絶縁材」としての価値を高める。顧客との関係性を自ら所有することは、検索エンジンの変化に対する最も強力な防御策となる。
構造化データと高品質な入力情報の提供
第二の対策は、アルゴリズムが「読みやすい」データを提供することに注力する姿勢への転換だ。仮に特許のようなシステムが実装されれば、その生成体験は構造化された入力情報に大きく依存するだろう。
この場合、事業者の役割は、美しいランディングページをデザインすることから、正確で豊富な商品属性データ、Schema.orgマークアップ、整った商品フィードといった「高品質な入力情報」を提供することへとシフトする。ボットやプログラム、アルゴリズムが容易に理解し、利用できる形式で情報を提供することが、生成された体験の中に商品が表示され、クリックを獲得するための前提条件となる。
説得力のあるコピー、視覚的な階層、直感的なCTAボタンの配置など、人間のユーザーを説得するためのページ作りが中心だった。
正確な商品仕様、構造化されたレビュー、機械が解釈しやすい属性データなど、AIが「素材」として活用できる高品質な情報の提供が重要になる。
この変化は、SEOの本質的な作業が「検索エンジン向け」から「AI生成システム向け」に移行することを意味する。クリックを獲得する機会は残るが、その入り口の形と、そこに至るための最適化方法が根本から変わる可能性がある。
この記事のポイント
- Googleの特許は、検索クエリとユーザーごとにAIがランディングページを動的に生成するシステムを明らかにした。これは検索結果とウェブサイトの間に現れる「新たな層」となり得る。
- 検索は「発見」から「回答抽出」「統合」へと進化し、ユーザーが元サイトに到達する前の段階で体験が完結する方向にある。AI生成ページはこの流れの延長線上にある。
- この変化により、EC事業者はサイトのデザインやメッセージングを直接ユーザーに届けるコントロールをさらに失う可能性がある。
- 対策の二本柱は「オウンドメディアによる直接的な顧客関係の構築」と「構造化データなどアルゴリズム向けの高品質な入力情報の提供」である。人間向けのデザインから、機械が利用しやすいデータ提供への重心移動が求められる。
- 特許は必ずしも実用化を保証するものではないが、検索プラットフォームの長期的な方向性を示す重要なシグナルとして捉えるべきだ。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験