


Search Console「平均掲載順位」の正体——数字の裏側にある仕組みと活用術
Google Search Console(グーグル・サーチコンソール)は、Webサイトの検索パフォーマンスを把握するために欠かせないツールだ。しかし、管理画面に表示される「平均掲載順位」という指標を見て、その数字の低さに頭を抱える担当者は少なくない。
検索結果で1位を獲得しているキーワードがある一方で、全体の平均順位が「25位」や「40位」と表示されるのはなぜか。この数字は、サイト全体の評価が低いことを意味しているわけではない。むしろ、この指標の計算ロジックを正しく理解していないと、的外れなSEO施策にリソースを割いてしまうリスクがある。
本記事では、Search Consoleにおける平均掲載順位の仕組みを解説し、AI概要(AI Overviews)や画像パックといった最新の検索要素が順位にどう影響するのかを紐解く。数字の裏側にある事実を知ることで、実務に役立つデータ分析が可能になるはずだ。
全体の「平均掲載順位」が低くなる仕組み

Search Consoleの「検索パフォーマンス」レポートを開くと、まず目に飛び込んでくるのがサイト全体の「平均掲載順位」だ。この数字は、サイトがランクインしている「すべてのクエリ」の掲載順位を合算し、平均したものである。
全クエリの合算値という性質
Googleの検索結果は、通常1ページに10件のオーガニック検索結果(広告以外の通常の検索結果)が表示される。平均順位が25位であれば、平均して検索結果の3ページ目付近に表示されている計算になる。しかし、この数字には落とし穴がある。
元記事の著者であるアン・スマーティ氏は、この全体平均の数字にはほとんど洞察が含まれていないため、基本的には無視することを推奨している。その理由は、サイトが意図せずランクインしてしまった関連性の低いクエリや、100位近くに表示されているロングテールキーワード(複数の単語を組み合わせた検索ボリュームの少ないキーワード)まで、すべてが平均計算に含まれてしまうからだ。
なぜ「全体平均」は分析に向かないのか
例えば、主力商品で1位を獲得していても、何千ものマイナーなキーワードで80位に表示されていれば、全体の平均順位は大きく押し下げられる。これはサイトの健全性が損なわれているわけではなく、単にGoogleが膨大なキーワードに対してそのサイトをインデックス(検索エンジンに登録)している結果に過ぎない。
したがって、経営層やクライアントに報告する際は、サイト全体の平均順位を追うのではなく、主要なキーワード群や、特定のディレクトリ(URLの階層)に絞った平均順位を見るべきだ。全体平均の上下に一喜一憂することは、SEO戦略においてあまり意味をなさないと言える。
クエリごとの「平均掲載順位」の計算ロジック

全体平均とは異なり、個別のクエリ(検索語句)ごとの掲載順位は非常に重要な指標になる。ただし、この数字も「ある時点での絶対的な順位」ではなく、あくまで「平均値」であることを忘れてはならない。
ユーザーごとの変動と平均値
検索順位は、検索するユーザーの場所、使用デバイス、過去の検索履歴などによって動的に変化する。Search Consoleに表示されるクエリごとの順位は、実際にそのクエリで検索結果が表示された際の全セッションの平均だ。
仮に2人のユーザーが同じキーワードで検索し、1人には1位、もう1人には2位で表示された場合、Search Consoleでの平均順位は「1.5位」と報告される。このように、整数ではない順位が表示されるのは、複数ユーザーの結果を統計的に処理しているためだ。
特殊な検索要素の数え方
現在のGoogle検索結果(SERP / Search Engine Result Page)には、通常のテキストリンク以外にもさまざまな要素が含まれる。Googleの定義によれば、外部サイトへのリンクを持つ特別な要素はすべて「1つの順位」としてカウントされる。
- 画像パック: 検索結果の上部に表示される複数の画像。これが最上部にあれば1位とカウントされる。
- AI概要(AI Overviews): AIが生成した回答。ここに含まれるリンクも順位カウントの対象だ。
- 他の人はこちらも質問(PAA / People Also Ask): よくある質問のリスト。クリックして展開された中のリンクも、表示されれば順位に含まれる。
以下のデモは、検索結果画面における「掲載順位」がどのように割り振られるかを視覚化したものだ。通常のオーガニック検索結果が1位であっても、その上に画像パックがあれば、オーガニック結果の順位は「2位」になる仕組みがわかる。
このデモでは、画像パックが最上部にある場合の順位カウント方法を示している。このように、Webサイトがオーガニック検索で「実質1位」であっても、Search Console上の数字が「2位」や「3位」になるのは、こうした検索要素の介在が原因だ。
順位が確認できない・変動する要因

Search Consoleのデータと、実際に自分で検索した結果が一致しないことは珍しくない。これには、Googleの検索エンジンが持つ高度なパーソナライズ機能や、デバイスごとの最適化が関係している。
デバイスによる表示順の違い
Googleは、PC(デスクトップ)とモバイルで検索結果の並び順を変えることが多い。モバイル版では画面の制約上、特定の特殊セクション(画像パックなど)が表示されない場合があり、その分だけオーガニック検索結果の順位が繰り上がることがある。
Search Consoleのデフォルト画面では、これらのデバイスデータが混ざった状態で表示されている。正確な分析を行うには、「+新規」フィルタから「デバイス」を選択し、デスクトップとモバイルを分けて比較することが重要だ。特定のキーワードでモバイルの順位だけが低い場合、そのページのモバイルフレンドリー(スマートフォンでの見やすさ)に問題がある可能性も示唆される。
AI概要(AI Overviews)内のリンクの扱い
近年導入が進んでいるAI概要は、掲載順位の計測をさらに複雑にしている。AI概要の中に引用元としてリンクが表示された場合、そのリンクは「1位」としてカウントされることが多い。しかし、AI概要はすべてのユーザーに表示されるわけではなく、また生成される内容も検索のたびに変化する「流動的」なものだ。
記事によれば、AI概要に含まれるリンクが常にSearch Consoleに反映されるわけではないという。ユーザーがAI概要の「詳細を表示」をクリックして初めて露出するリンクなどは、インプレッション(表示回数)としてカウントされないケースもある。このため、平均順位が急激に変動した際は、AI概要の表示有無が影響していないか疑う必要がある。
実務で役立つ「掲載順位」の分析方法

平均掲載順位を単なる「成績表」として眺めるだけでは不十分だ。エンジニアやマーケターがこの数字をどう活用すべきか、独自の分析視点を交えて解説する。
「11位〜20位」のクエリを特定する
SEOにおいて最も効率的な改善ポイントは、平均順位が11位から20位(検索結果の2ページ目)に位置しているクエリだ。これらはGoogleから「ある程度の評価」を得ているものの、ユーザーの目には触れにくい状態にある。
これらのページに対して、コンテンツの加筆や内部リンクの強化を行うことで、比較的容易に1ページ目(10位以内)へ押し上げることができる。平均順位をフィルタリングして、この「あと一歩」のクエリを抽出することは、ECサイトなどの大規模サイト運営において非常に有効な戦略となる。
CTR(クリック率)との相関をチェックする
平均順位が上がっているのにクリック数が増えない、あるいは順位は低いのにクリック率(CTR / Click Through Rate)が高いというケースがある。これは、検索結果に表示されるタイトル(titleタグ)やディスクリプション(meta description)が、ユーザーの検索意図にどれだけ合致しているかを示している。
もし平均順位が3位以内なのにCTRが極端に低い場合、検索結果に表示されているスニペット(説明文)が魅力的でないか、あるいは広告や画像パックにユーザーを奪われている可能性がある。数字を単体で見るのではなく、順位とCTRをセットで分析することで、コンテンツ修正の優先順位を判断できるようになる。
この記事のポイント
- サイト全体の「平均掲載順位」は、全クエリの合算値であるため、分析指標としては重要度が低い。
- クエリごとの順位は、ユーザーのデバイスや場所による変動を平均化した数字である。
- 画像パックやAI概要などの特殊な検索要素も「1つの順位」としてカウントされる。
- 正確な分析のためには、デバイス(モバイル・デスクトップ)ごとのフィルタ活用が必須である。
- 順位だけでなくCTRと組み合わせて分析することで、真の改善ポイントが見えてくる。
出典
- Practical Ecommerce「Search Console’s Average Position, Explained」(2026年3月23日)

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GoogleがUCPを拡張——カート機能とID連携でAIショッピングがより実用的に
Googleは2026年3月、Universal Commerce Protocol(UCP)の機能を大幅に拡張した。今回のアップデートでは、新たに「カート(Cart)」と「カタログ(Catalog)」の仕様が追加され、Merchant Centerを通じた導入プロセスも簡素化される。
UCPは、AIエージェントがオンラインショップと直接やり取りするための標準規格だ。2026年1月の発表以来、初の大規模な更新となる。今回の変更により、AIが複数の商品をまとめて扱い、リアルタイムの在庫情報を参照することが可能になる。
このアップデートは、GoogleのAI「Gemini」や検索画面の「AI Mode」を通じたショッピング体験を、より自社サイトでの購入に近いものへ進化させる狙いがある。小売業者にとっては、AI経由の売上拡大が見込める一方で、顧客接点の変化という新たな課題も突きつけている。
UCPの拡張とショッピング体験の進化

UCP(Universal Commerce Protocol)は、AIがWebサイトの構造を解析することなく、直接商品情報を取得・決済するための「共通言語」のような役割を果たす。今回の拡張では、これまで1点ずつの決済に限られていた機能が大幅に強化された。
カート機能:複数商品の同時購入が可能に
新しく追加された「カート(Cart)」機能により、AIエージェントは単一の店舗から複数の商品をショッピングカートに保存、または追加できるようになった。これまでは「この靴を買って」という指示には対応できたが、「この靴と、それに合う靴下を一緒にカートに入れておいて」といった複雑な要望にも応えられるようになる。
UCPのドラフト仕様によれば、カート機能は購入前の「検討フェーズ」を支える設計だ。ユーザーが最終的な購入を決断する前に、AIがカートを構築し、準備が整った段階でチェックアウト(決済)セッションへと移行させる。これにより、ユーザーはAIとの対話を通じて、より自然な買い物ができるようになる。
カタログ機能:リアルタイム在庫の同期
「カタログ(Catalog)」機能は、小売業者の在庫システムからリアルタイムで商品詳細を取得するためのものだ。これには商品のバリエーション(サイズや色)、最新の価格、在庫の有無が含まれる。
従来のショッピング広告などで使われる「商品フィード」は、更新にタイムラグが生じることがあった。カタログ機能ではAIがライブデータに直接クエリを投げるため、タッチの差で売り切れるといったトラブルを防げる。検索と直接の商品検索の両方をサポートしており、精度の高い商品提案が可能になる。
ID連携(Identity Linking)がもたらす顧客体験の継続性

今回のアップデートで注目されているのが、すでに最新の安定版仕様に含まれている「ID連携(Identity Linking)」だ。これは、ユーザーが普段使っているショップのアカウントを、GoogleのAIプラットフォームと連携させる仕組みを指す。
ログイン情報の共有とロイヤリティプログラムの適用
ID連携には、標準的な認証プロトコルである「OAuth 2.0」が使用される。ユーザーが一度連携を許可すれば、AI ModeやGeminiを通じて買い物をする際にも、そのショップの会員特典が自動的に適用されるようになる。
例えば、会員限定の割引価格や、無料配送特典、ポイント付与などが、Googleのインターフェース上での購入でも維持される。これは、自社のロイヤリティプログラム(会員制度)を重視する小売業者にとって、AI経由の販売を受け入れる大きな動機付けとなる。Googleのブログによれば、この機能はすでに導入可能なオプションとして公開されている。
Merchant Centerを通じた導入の簡素化

Googleは、UCPの導入障壁を下げるために、Merchant Center(マーチャントセンター)でのオンボーディングプロセスを簡素化した。Merchant Centerは、Google検索やショッピングタブに商品情報を掲載するための管理ツールだ。
外部プラットフォーム(Salesforce, Stripe等)との連携
技術的なリソースが限られている中小規模の小売業者向けに、主要なEコマースプラットフォームとの連携も強化されている。Commerce Inc、Salesforce、Stripeの3社が、UCPの実装計画を個別に発表した。これらのサービスを利用している業者は、自前で複雑なAPIを構築することなく、AIショッピングの枠組みに参加できる可能性が高い。
ただし、Merchant Centerのヘルプページによれば、現時点でチェックアウト機能を利用できるのは一部のマーチャントに限定されている。参加を希望する場合は専用のフォームから申請が必要だ。また、商品データに `native_commerce` 属性を付与しているリスティングのみが、直接購入ボタンの表示対象となる点に注意したい。
独自分析:GoogleのAI戦略と小売業者の課題

GoogleがUCPを急速に拡張している背景には、ユーザーを自社のAIインターフェース内に留めたいという強い意図がある。AIが単なる「検索ツール」から、購買までを完結させる「購買代理人」へと進化しようとしているのだ。
自社サイトへの流入減少というリスク
小売業者にとっての最大の懸念は、自社サイトへの直接のトラフィック(訪問者数)が減少することだ。決済がGoogleの画面上で完結すれば、ユーザーはショップのトップページや他の商品ページを目にすることはない。これは、クロスセル(ついで買い)の機会減少や、ブランド体験の希薄化を招く恐れがある。
一方で、ID連携によってロイヤリティ特典を維持できるようになった点は、業者側の懸念を和らげる「妥協点」として機能するだろう。顧客データが適切にショップ側へフィードバックされるのであれば、販売チャネルの一つとしてAIを許容する動きは加速すると予想される。
2026年以降のSEOとコマース戦略の転換点
これからのSEOは、Webサイトの「見た目」を整えるだけでなく、AIが理解しやすい「データ構造」を整えることの重要性がさらに増す。UCPへの対応は、まさにその一環だ。従来の検索結果で1位を取ることと同様に、AIエージェントに「最も適切な購入先」として選ばれるための最適化が求められるようになる。
元記事の著者は、カートやカタログ機能の追加によって、UCPがGoogleのAIサーフェス(表面)内で完全なショッピング体験を再現することに近づいたと指摘している。今後数ヶ月以内にMerchant Centerでの展開が進むにつれ、多くの小売業者がこの新しい規格への対応を迫られることになるだろう。
この記事のポイント
- GoogleがUCPを更新し、複数商品を扱う「カート」とリアルタイム在庫を参照する「カタログ」機能を追加した。
- 「ID連携」により、GoogleのAI経由で購入してもショップ独自の会員特典や割引が適用可能になった。
- Merchant Centerでの導入が簡素化され、SalesforceやStripeなどの外部プラットフォーム経由でも利用しやすくなる。
- 小売業者はサイト流入減のリスクを考慮しつつ、AIエージェントを通じた新しい販売チャネルへの対応が求められている。
出典
- Search Engine Journal「Google Expands UCP With Cart, Catalog, Onboarding」(2026年3月19日)
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googlebotの正体は「数百のクローラー」の集合体。未公開システムの仕組みとSEOへの影響
Googlebotは単一のプログラムではなく、実際には数百もの異なるクローラーやフェッチャーが組み合わさった巨大なシステムの総称だ。GoogleのGary Illyes(ゲイリー・イリェーシュ)氏とMartin Splitt(マーティン・スプリット)氏が公開したポッドキャストにより、その複雑な内部構造が明らかになった。
2026年3月に公開されたこの情報によると、Googleが運用するクローラーの大部分は公開ドキュメントに記載されていない。これは、特定のチームが小規模な目的で使用するクローラーが膨大に存在するためだという。
Webサイト運営者やSEO担当者にとって、この事実はログ解析やクローラー制御の考え方を根本から見直すきっかけとなる。Googlebotという名称の裏側に隠された、巨大なクロール・インフラの実態を詳しく紐解いていく。
Googlebotは単一の存在ではない?クローラーの正体
一般的に「Googlebot」といえば、Webサイトを巡回してインデックスを作成する一つのロボットをイメージしがちだ。しかし、著者のGary Illyes氏によれば、現在のGooglebotは独立した一つのシステムではない。
「Googlebot」という名称の歴史的背景
Googlebotという名前が使われ始めた2000年代初頭、Googleには実際に一つのクローラーしか存在しなかった。当時は提供しているサービスも検索エンジンのみであり、単一のシステムで事足りていたからだ。しかし、AdWords(現在のGoogle 広告)などの新サービスが登場するたびに、専用のクローラーが追加されていった経緯がある。
現在では、ニュース、画像、動画、広告など、用途別に最適化された無数のクローラーが動いている。それでも「Googlebot」という名称が使われ続けているのは、歴史的な慣習によるものだ。実態としては、一つの巨大な「クロール・インフラ」を多くのクライアントが利用している状態に近い。
内部インフラとクライアントの関係性
Googlebotの本質は、クロール・インフラそのものではなく、そのインフラを利用する「クライアント」の一つである。これは、図書館(インフラ)に対して、本を借りに行く利用者(Googlebot)が複数いる状態に例えられる。利用者はGooglebotだけでなく、他にも何百人と存在するのだ。
この仕組みにより、Google内部の各開発チームは、共通の強力なクロール基盤を利用しながら、自分たちの目的に合わせた独自のクローラーを走らせることができる。私たちが普段目にしているGooglebotは、氷山の一角に過ぎないのである。
クロール・インフラの仕組みと「SaaS」的側面
Google内部で運用されているクロール・インフラには特定の名称があるが、Gary Illyes氏はその公開を控えた。彼はこのインフラを、ソフトウェアをサービスとして提供する「SaaS(Software as a Service)」のようなものだと説明している。
内部APIを通じたデータの取得プロセス
Googleのエンジニアがインターネット上のデータを取得したい場合、このインフラが提供するAPIエンドポイントを呼び出す。API(Application Programming Interface)とは、ソフトウェア同士が機能を共有するための窓口のことだ。エンジニアはこの窓口を通じて、「このURLのデータを取ってきてほしい」というリクエストを送る。
リクエストを受けたインフラ側は、クラウドやデータセンターのリソースを使い、対象のWebサイトに負荷をかけすぎないよう配慮しながらフェッチ(取得)を実行する。つまり、クローラーをゼロから開発する必要はなく、共通のAPIを叩くだけで高度なクロール機能を利用できる仕組みが整っているのだ。
パラメータ設定による柔軟な制御
APIを呼び出す際には、さまざまなパラメータを指定できる。例えば、データの返信を待つ時間(タイムアウト設定)、名乗る名前(ユーザーエージェント)、遵守すべきrobots.txtのルールなどだ。多くの場合はデフォルト設定が適用されるため、開発者は複雑な設定なしに利用できる。
ユーザーエージェントとは、クローラーがWebサーバーにアクセスする際に提示する「自己紹介文」のようなものだ。この設定を変更することで、特定のチーム専用のクローラーとして振る舞うことが可能になる。この柔軟性が、数百種類ものクローラーを生み出す要因となっている。
なぜ「未公開」のクローラーが数百も存在するのか
Googleの公式サイトには主要なクローラーの一覧が掲載されているが、そこに含まれないクローラーが圧倒的に多い。これには、ドキュメント管理の現実的な限界と、情報の重要度による線引きが関係している。
公開ドキュメントに記載される基準
Gary Illyes氏によれば、すべてのクローラーをドキュメント化することは事実上不可能だという。Googleは巨大な組織であり、数多くのチームがそれぞれの目的でクローラーを運用しているからだ。もし数百のクローラーをすべて詳細に記載すれば、開発者向けのドキュメントページは膨大な量になり、かえって利便性を損なうことになる。
そのため、Googleは「トラフィック量」という基準で線を引いている。インターネット全体に対して目に見えるほどの影響力を持つ、あるいは頻繁にサイトを訪れる主要なクローラーのみを公開対象としている。小規模なテスト用や特定の機能限定のクローラーは、あえて非公開のままにされているのだ。
内部チームによる多様な用途
未公開のクローラーは、検索以外の多種多様な目的で使用されている。例えば、新機能のプロトタイプ作成、内部的なデータ分析、あるいは特定のセキュリティチェックなどが考えられる。これらのクローラーは取得するURLの数が非常に少ないため、一般的なWebサイト運営者がその存在に気づくことはほとんどない。
ただし、特定のクローラーが一定の閾値を超えて大量のアクセスを行うようになった場合、Gary Illyes氏らはそのチームに連絡を取り、動作の正当性を確認した上でドキュメント化を検討するという。これにより、Webエコシステムへの悪影響を防ぐ監視体制が敷かれている。
「クローラー」と「フェッチャー」の決定的な違い
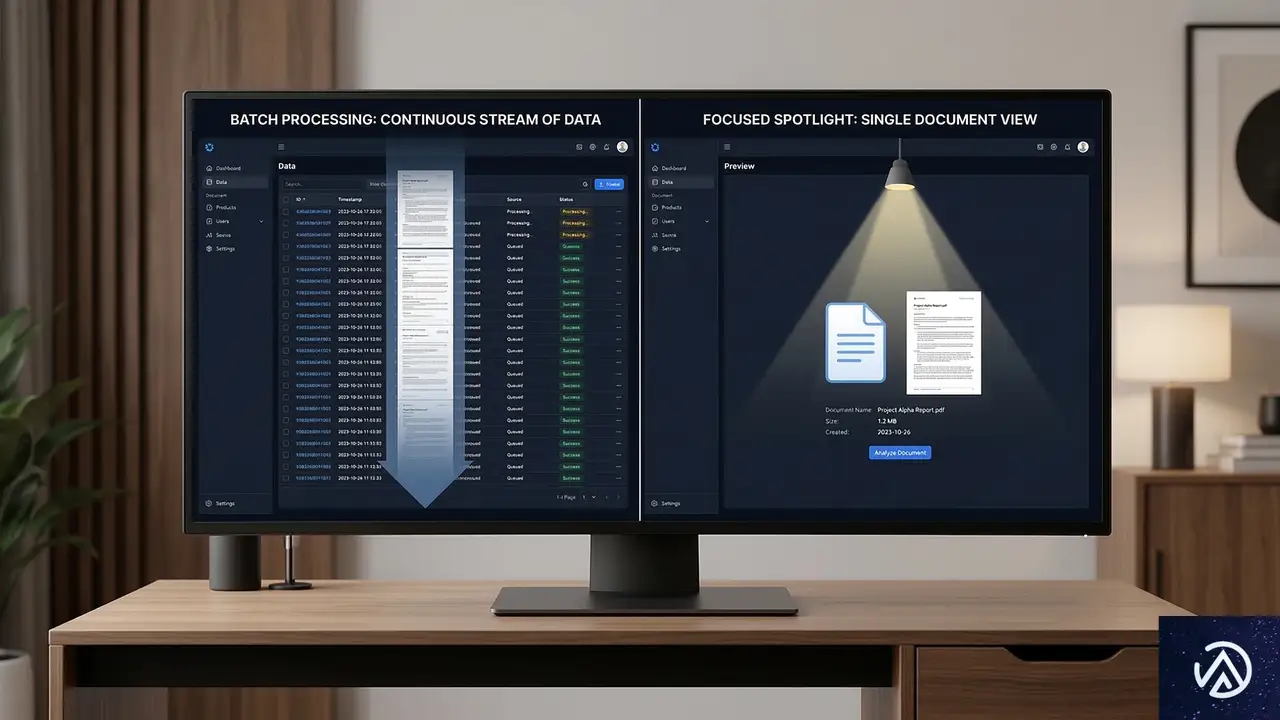
Google内部では、データを取得する仕組みを「クローラー(Crawler)」と「フェッチャー(Fetcher)」の2種類に明確に使い分けている。これらは動作の仕組みも、実行されるタイミングも大きく異なる。
バッチ処理と個別リクエストの使い分け
クローラーは「バッチ処理」で動作する。バッチ処理とは、大量のデータをまとめて一括で処理する方式のことだ。クローラーには常に巡回すべきURLのリストが供給され、24時間365日、システムが空いている時間に継続的にデータを取得し続ける。これが一般的な検索インデックス作成の仕組みだ。
一方、フェッチャーは「個別URL」単位で動作する。特定のURLを指定して、その1件だけを即座に取得するのが役割だ。クローラーが「広範囲を網羅する網」だとすれば、フェッチャーは「ピンポイントで狙う釣り竿」のようなものだと言える。
ユーザー操作がトリガーとなるフェッチ
フェッチャーが動く際の特徴は、多くの場合「ユーザーの操作」が起点となっている点だ。例えば、Search Consoleで「URL検査」を実行し、現在の状態をライブテストする場合などがこれに当たる。画面の向こう側に、結果を待っている人間がいる状態だ。
Googleの内部ポリシーでは、フェッチャーはユーザーの制御下にあるべきだと定められている。これに対してクローラーは、システムの都合に合わせて自律的に動く。この違いを理解しておくことは、サーバーログを見て「なぜ今このアクセスが来たのか」を推測する際の大きなヒントになる。
Webサイト運営者が知っておくべき実務上の注意点
Googlebotが数百のクローラーの集合体であるという事実は、実務においてどのような意味を持つのか。特にセキュリティやパフォーマンスの観点から、サイト運営者が意識すべきポイントを整理する。
未知のユーザーエージェントへの対応
サーバーログを分析していると、GoogleのIPアドレス帯域からのアクセスであるにもかかわらず、ドキュメントに載っていないユーザーエージェントを見かけることがあるかもしれない。これまでは「偽装されたボット」と判断して遮断していたケースもあるだろうが、その一部はGoogle内部の正当な未公開クローラーである可能性がある。
重要なのは、ユーザーエージェント名だけで判断せず、IPアドレスの逆引き(DNSルックアップ)を行って、本当にGoogleからのアクセスかどうかを確認することだ。正当なGoogleのインフラからのアクセスであれば、むやみにブロックせず、サイトのクロールバジェット(クローラーが巡回できる許容量)の範囲内で許容するのが賢明だ。
サーバー負荷とログ解析の視点
数百のクローラーが存在するということは、それだけ多様な目的でサイトがスキャンされる可能性があることを意味する。しかし、Gary Illyes氏が述べている通り、未公開のクローラーは通常、極めて低頻度でしか動作しない。もし特定のボットが大量のアクセスを行い、サーバー負荷を高めているのであれば、それは主要なクローラーであるか、あるいは設定ミスによる異常動作である可能性が高い。
また、robots.txtでの制御も、基本的には「Googlebot」というメインのトークン(識別子)で大部分をカバーできる。個別の未公開クローラーをすべて制御しようとするのは現実的ではなく、主要な指示系統を整理しておくことこそが、SEOにおけるクローラビリティ最適化の王道であることに変わりはない。
この記事のポイント
- Googlebotは単一のプログラムではなく、数百種類のクローラーやフェッチャーが共通のインフラを利用する集合体である。
- Google内部ではクロール機能を「SaaS」のように提供しており、APIを通じて誰でもフェッチリクエストを送れる仕組みがある。
- 公開ドキュメントに載っているのは主要なクローラーのみで、トラフィックの少ない小規模なものは非公開とされている。
- 「クローラー」はバッチ処理で継続的に動き、「フェッチャー」はユーザー操作などを起点に個別URLを取得する。
- サイト運営者は、ドキュメント外のクローラーも存在することを前提に、IPアドレスベースでの正当性確認を行うことが推奨される。
出典
- Search Engine Journal「Google Says Hundreds Of Their Crawlers Are Not Documented」(2026年3月13日)
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google AI Modeの自己引用が3倍に。検索・マップ・GSCの最新アップデートを解説
Googleの検索体験がAIによって急速に変容している。最新の調査報告によれば、AI ModeにおけるGoogle自身のプロパティへの引用率が、過去9ヶ月で大幅に増加したことが明らかになった。
2026年3月、GoogleはAIを活用した対話型検索「Ask Maps」の導入や、検索コンソールにおけるブランドクエリフィルタの全ユーザー開放など、重要なアップデートを立て続けに実施した。これらの変更は、Webサイトへのトラフィック流入経路に大きな影響を与える可能性がある。
本記事では、Google検索の責任者が語ったマルチモーダルAIによる音声・動画のインデックス化や、検索結果のパーソナライズ化の展望を含め、SEO担当者が今把握すべき重要事項を解説する。
Google AI Modeの自己引用率が21%に上昇
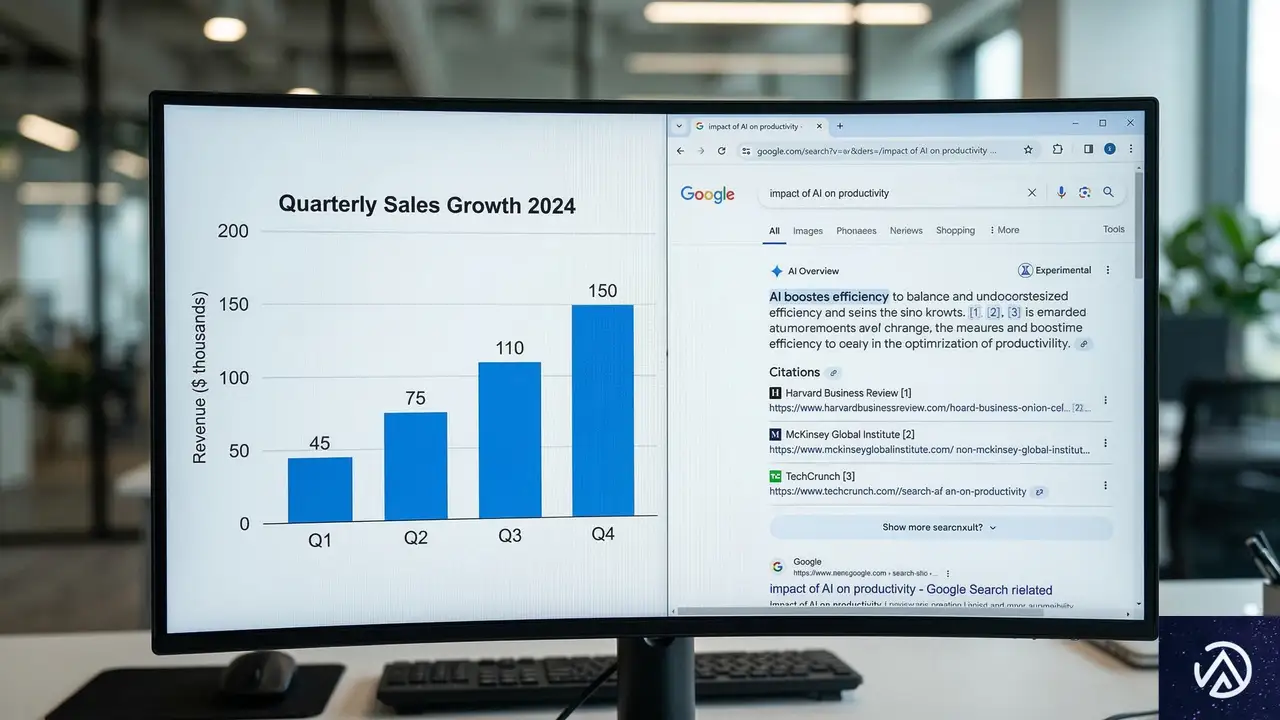
SE Rankingが発表した第3回「Google AI Mode引用レポート」によると、GoogleがAI Modeの回答内で自社プロパティへリンクを貼る割合が急増している。9ヶ月前には全引用の7%に過ぎなかった自己引用率が、現在は21%に達しているという。
外部サイトへの流入減少への懸念
AI Modeの引用のうち、5回に1回は外部のWebサイトではなく、Google自身のページに向けられている計算だ。これは、AI Overviews(AIによる概要表示)で見られた傾向と同様に、Googleがユーザーを自社のエコシステム内に留めようとする戦略を強化していることを示唆している。
SE Rankingのブランド責任者であるモーディ・オーバースタイン氏は、この現状を「巨大な循環」と表現している。同氏によれば、全引用の17%がGoogle自身に向けられており、他のどの情報源よりも高い割合を占めている。
ローカル検索からオーガニック検索への誘導シフト
以前の自己引用は、主にGoogleビジネスプロフィールのリスティング(店舗情報など)に向けられていた。しかし、今回の調査ではGoogle自身のオーガニック検索結果ページへのリンクが増加している。
これは、AIが回答の根拠として特定のWebサイトを個別に紹介するのではなく、「詳細はGoogleで検索してください」という形で自社の検索結果へユーザーを戻していることを意味する。結果として、個別のパブリッシャーが獲得できるトラフィックが減少するリスクがある。
GoogleマップにAI対話機能「Ask Maps」が登場
Googleは、Geminiを活用した対話型AI機能「Ask Maps」をGoogleマップに導入した。ユーザーは自然な言葉で場所について質問し、マップ上でおすすめの提案を受け取ることができる。
レビューとプロフィールの重要性が再定義される
Ask Mapsは、Googleが保有する膨大な場所のデータベースとユーザーレビューを基に回答を生成する。従来の「キーワード一致」によるリスト表示ではなく、文脈を理解した推薦が行われるのが特徴だ。
例えば「静かで作業に適した、Wi-Fiのあるカフェ」といった複雑な要望に対しても、レビュー内容を解析して最適な場所を提示する。店舗運営者にとっては、良質なレビューの獲得とビジネスプロフィールの充実が、AIに推奨されるための必須条件となるだろう。
パーソナライズ化による検索体験の変化
この機能は現在、米国とインドで提供されている。回答はユーザーの検索履歴や保存済みの場所に基づいてパーソナライズされるため、ユーザーごとに異なる結果が表示される。
ただし、Googleはどのような基準で特定のビジネスを優先的に推薦しているのか、その詳細なアルゴリズムは公開していない。また、将来的にこの推薦枠の中に広告(有料の配置)が含まれるかどうかも現時点では不明だ。
音声と動画の「直接理解」によるインデックスの進化
Googleの検索責任者であるエリザベス・リード氏は、AIがコンテンツをどのように理解し、インデックス(検索エンジンに登録すること)を行っているかの変化について言及した。
マルチモーダルAIが文字起こしを超越する
リード氏によれば、マルチモーダルLLM(大規模言語モデル)の導入により、Googleは音声や動画のコンテンツを直接処理できるようになった。マルチモーダルAIとは、テキストだけでなく画像、音声、動画など複数の種類の情報を同時に処理できるAIのことだ。
これまでのGoogleは、主に動画のタイトルや説明文、あるいは自動生成されたトランスクリプト(文字起こし)に頼って内容を把握していた。しかし現在は、動画内の視覚的な変化や音声のトーン、内容の深さをAIが直接「視聴」して理解しているという。これにより、これまで検索結果で過小評価されていたポッドキャストや動画コンテンツの露出が増える可能性がある。
サブスクリプション購読者向けの優先表示
リード氏は、将来的な展望として「サブスクリプションを認識したランキング」についても触れた。これは、特定のニュースサイトなどを有料購読しているユーザーに対し、そのサイトのコンテンツを検索結果の上位に表示する仕組みだ。
通常、ペイウォール(有料の壁)があるコンテンツは、多くのユーザーがアクセスできないため検索順位が上がりにくい傾向にある。しかし、購読者であることをGoogleが認識できれば、そのユーザーにとって価値の高い情報を優先的に届けることが可能になる。
サーチコンソールのブランドクエリフィルタが全ユーザーに開放
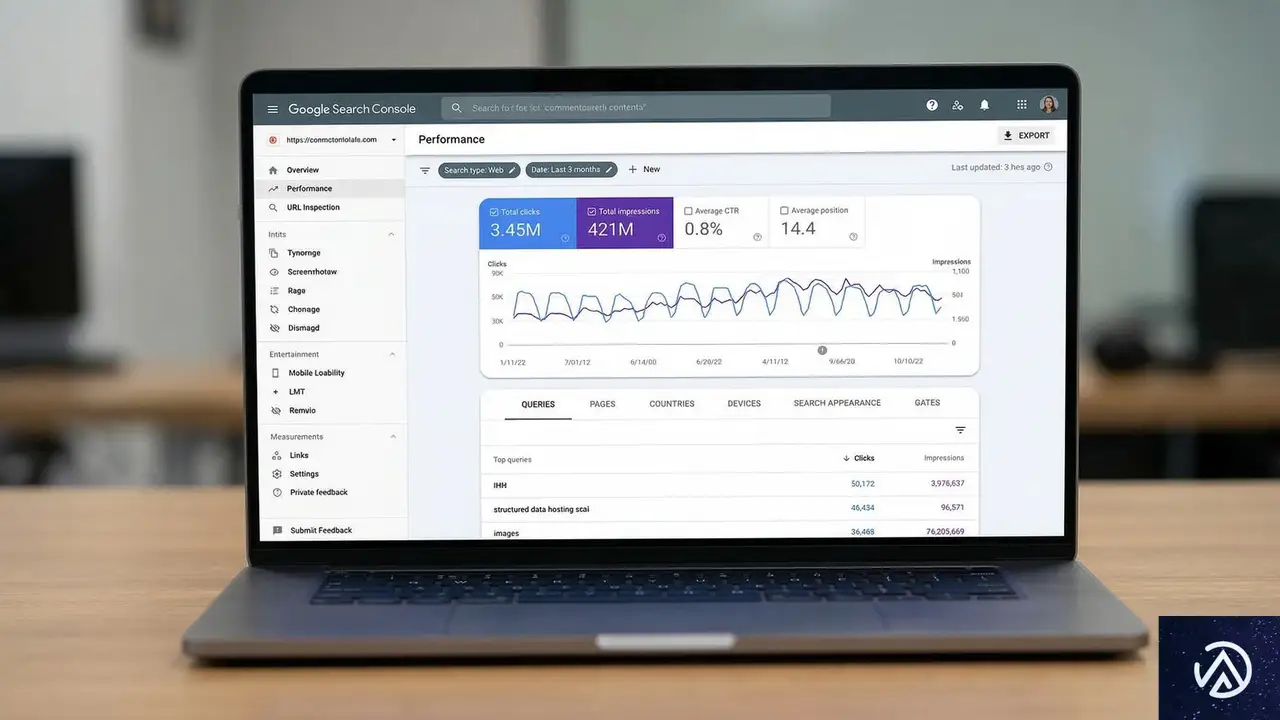
Google検索コンソール(GSC)において、ブランドクエリと非ブランドクエリを自動で分類するフィルタ機能が、すべての対象サイトで利用可能になった。
AIによる自動分類と精度の向上
このフィルタはAIを用いて、ユーザーの検索語句を「ブランド名を含むもの」と「それ以外」に自動で仕分けする。特筆すべきは、ブランド名のタイポ(打ち間違い)や、製品名のみの検索も自動的にブランドクエリとして認識する点だ。
これまでは、ブランドトラフィックを除外するためにREGEX(正規表現)を用いた複雑なフィルタ設定が必要だった。REGEXとは、文字列のパターンを指定して検索や置換を行う手法のことだ。新機能により、専門知識がなくても純粋な新規顧客の流入(非ブランドトラフィック)を正確に把握できるようになる。
戦略的なトラフィック分析の効率化
「Product-Led SEO」の著者であるイーライ・シュワルツ氏は、このアップデートによりSEOチームが「非ブランド領域での貢献」を明確に示せるようになると指摘している。
一方で、ブランドの知名度だけに頼ったトラフィック増加を「SEOの成果」として報告することが難しくなる側面もある。企業にとっては、純粋な検索需要(悩みや目的による検索)に対して自社サイトがどれだけ応えられているかを、より厳密に評価するツールとなるだろう。
独自分析:検索ユーザーとWebサイトの「距離」が広がる時代
今回の一連のアップデートを俯瞰すると、共通する一つのテーマが浮かび上がる。それは、ユーザーが検索を開始してからWebサイトに到達するまでの「距離」が物理的にも心理的にも遠くなっているという事実だ。
ゼロクリック検索の加速とブランド認知の重要性
AI Modeの自己引用率増加やAsk Mapsの導入は、ユーザーがGoogleのインターフェース内で完結する「ゼロクリック検索」を加速させる。ユーザーはWebサイトを訪れることなく、AIとの対話だけで解決策を得てしまうからだ。
このような環境下では、従来の「キーワードで上位表示してクリックを待つ」というモデルだけでは不十分だ。AIが回答の根拠として自社を「認識」し、推奨してくれる状態を作らなければならない。
今後は、直接的なトラフィックだけでなく、AIの回答に含まれる「ブランドの言及」や「推奨」をKPI(重要業績評価指標)に含める視点が必要になるだろう。また、リード氏が語ったように、動画や音声、さらにはサブスクリプションモデルとの連携など、テキスト以外のチャネルを統合したSEO戦略が、Webサイトの生存戦略において鍵となる。
この記事のポイント
- Google AI Modeの自己引用率が21%に上昇し、Google自身へのトラフィック誘導が強まっている。
- 「Ask Maps」の導入により、Googleマップでの検索が対話型かつパーソナライズされたものへ進化している。
- マルチモーダルAIの進化で、動画や音声コンテンツがテキストを介さず直接インデックスされるようになりつつある。
- 検索コンソールのブランドクエリフィルタにより、ブランド認知による流入と純粋なSEO成果の切り分けが容易になった。
- ユーザーがサイトへ到達する前にAIが回答を完結させる傾向が強まっており、ブランドの「言及」を増やす戦略が重要視される。
出典
- Search Engine Journal「AI Mode Data, Ask Maps & Branded Queries Go Live – SEO Pulse」(2026年3月13日)
- SE Ranking「Google Links in AI Mode Answers: Third Report」(2026年3月)
- Access Podcast「Interview with Elizabeth Reid, Head of Google Search」(2026年3月)
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験