
GPT-Live-1がAPIで提供開始。同時通話型音声AIで割り込み処理が大幅改善
OpenAIが2026年9月10日、音声対話モデル「GPT-Live-1」のAPI提供を開始した。このモデルは同時に聞いて話すフルデュプレックス方式を採用し、従来の音声AIが抱えていた会話の遅延や不自然な割り込みを大幅に改善する。音声フロントエンド部分の料金は1分あたり0.05ドルに設定されている。
GPT-Live-1はChatGPTでの先行導入を経て、今回API経由で開発者に開放された。音声認識と音声合成を単一モデルに統合した設計が特徴で、人間同士の会話に近い自然なインタラクションを実現する。この記事ではGPT-Live-1の技術的な仕組み、性能評価、料金体系、そして開発者にとっての活用可能性を解説する。
単一モデルで実現する同時対話の仕組み
従来方式の構造的な課題
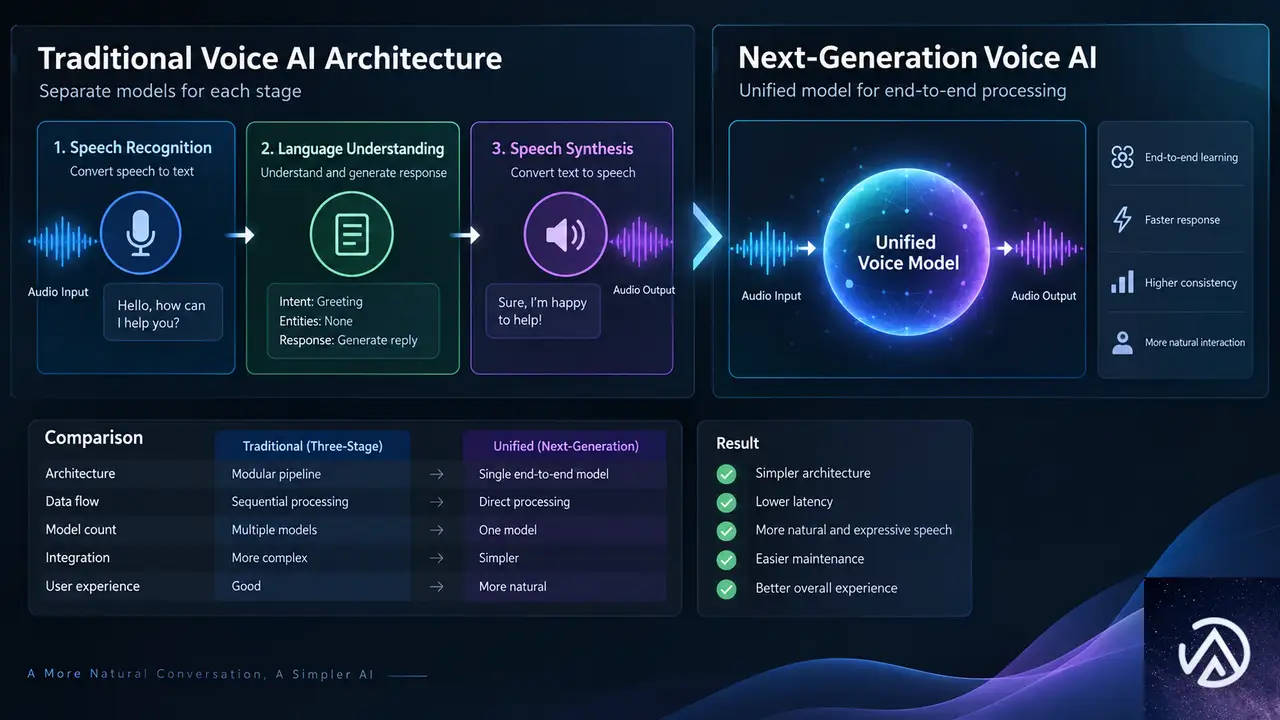
従来の音声AIは3つの工程を連結する方式が主流だった。まず音声をテキストに変換するSTT(音声認識)、次に内容を理解して回答を考えるLLM(大規模言語モデル)、最後にテキストを音声に戻すTTS(音声合成)だ。各工程が別々のモデルで処理されるため、段階ごとに処理待ちの遅延が積み重なる。
この構成では割り込みへの対応も難しい。ユーザーが話し始めるタイミングを検知するには、音声入力を常時監視しながら出力側の状態も把握しておく必要がある。3つのモデルをまたぐ情報の受け渡しにタイムラグが生じるため、人間同士の会話のような即時の割り込みは実現しづらかった。開発者は各段階のつなぎ目を手動で調整しなければならず、運用の手間も大きい。
単一モデルへの統合がもたらす変化
GPT-Live-1はSTTとLLMとTTSを単一モデルに統合する。入ってくる音声と出ていく音声を同じモデル内で同時に推論するため、段階間のつなぎ目が構造的に存在しない。これにより遅延が減るだけでなく、相手の言葉を遮って新しい質問を投げかけたり、相槌を打ったりする自然な会話のリズムを保てる。
背景ノイズや無音状態の扱いも改善された。従来方式では無音を「発話の終わり」と誤判定して会話を切ってしまう事態が起きやすかったが、GPT-Live-1は静寂を会話の一部として処理できる。ユーザーが考え込んでいる時間を待つ、周囲の雑音に反応しない、といった対話の質を左右する細かな制御がモデル側で吸収される。
3段階のモデルを連結する方式では、それぞれの処理待ち時間が会話のテンポを損なっていた。GPT-Live-1はこの問題を単一モデルへの統合で解決している。
割り込み処理の改善がビジネス効果を生む
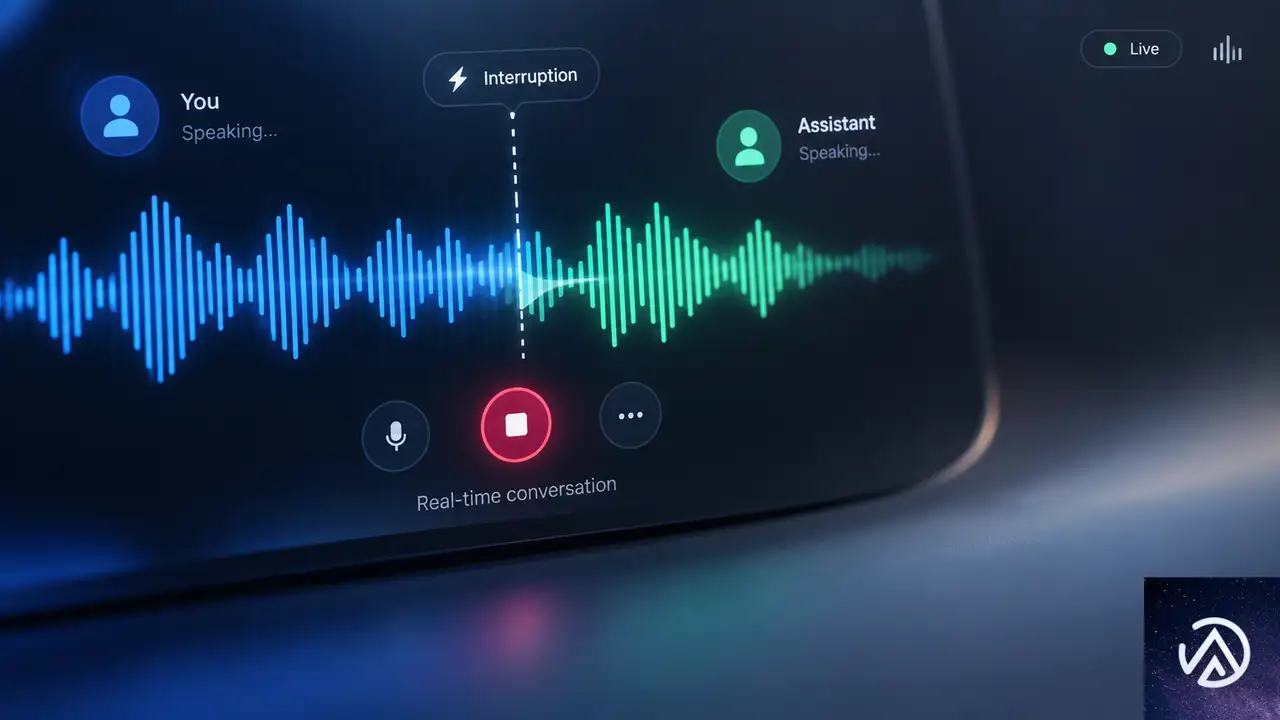
音声エージェントの実用化で最大の障壁が「割り込み」への対応だ。人間同士の会話では、相手の話の途中で情報を追加する、言い直す、短い相槌を打つ、といった行為が自然に発生する。従来のターン制システムではこの対応が難しく、一方が話し終えるのを待ってから返答する不自然な体験になりがちだった。
OpenAIの公開した早期評価では、語学学習プラットフォームのSpeakがGPT-Live-1を導入した結果、学習者が考える時間を確保できるようになり、割り込み回数が従来のターン制システムと比べて約80%削減された。この数字は、音声AIが教育分野で実用化できる水準に近づいていることを示している。学習者が発話を躊躇しても、AIが先回りして話し始めない。この「待つ」能力が学習体験の質を大きく左右する。
またGPT-Live-1は、短い笑い声や「うん」「ええ」といった相槌、近くにいる他者への短い話しかけなど、会話に混じる非定型的な音声を適切に処理できる。これらは従来の音声認識では誤検知や過剰反応の原因になりやすかったが、GPT-Live-1は文脈を踏まえて取捨選択する。
従来のターン制システムでは、STEP 2の割り込みを検知するまでにタイムラグが発生し、ユーザーが話し終えるのを待ってから処理を切り替える必要があった。GPT-Live-1は音声入力を常時監視しているため、この切り替えがほぼ即座に行われる。
バックエンド推論モデルへの委任という設計
タスクに応じたモデル選択
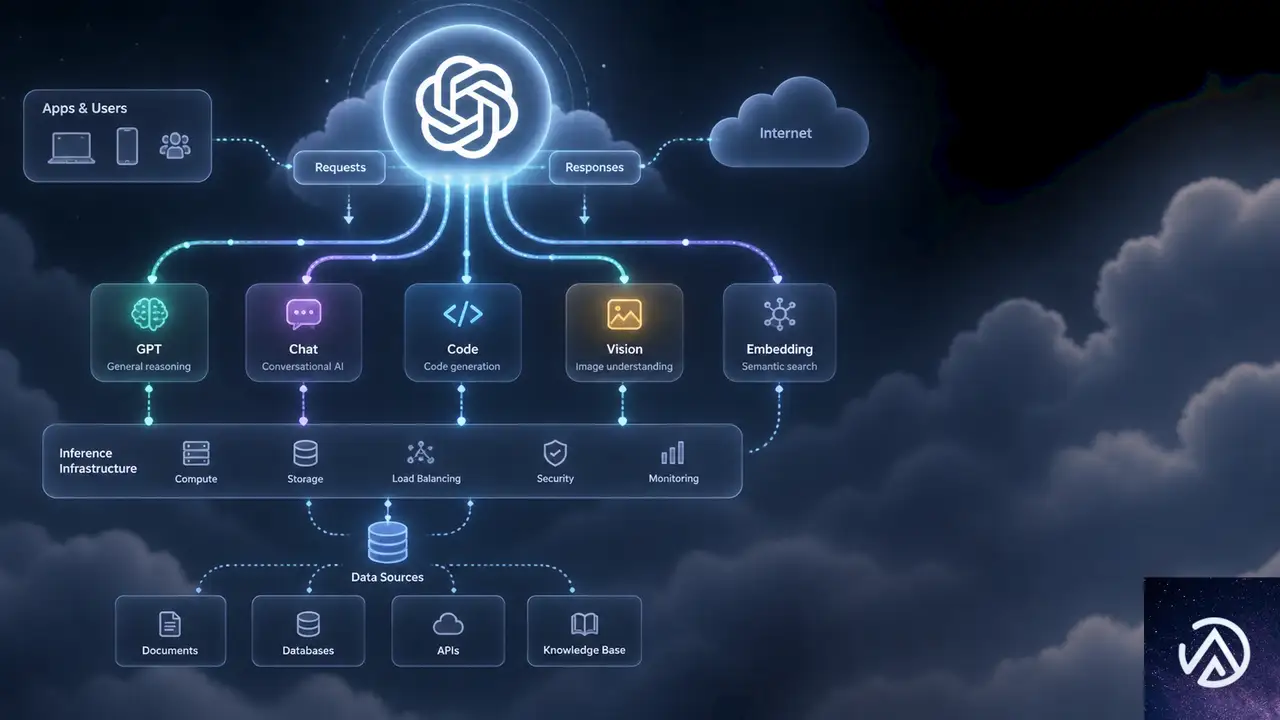
GPT-Live-1の設計で注目すべき点は、すべてを自身で解決するわけではないという姿勢だ。音声レイヤーと推論レイヤーを分離し、複雑な判断やツール呼び出しはバックエンドのテキストモデルに委任できる。開発者はGPT-6 Astraやサードパーティモデルを組み合わせ、タスクの難易度に応じて推論深度を使い分けられる。
たとえばレストランの予約確認や配送状況の案内といった定型的なタスクには軽量なモデルを使い、複雑な顧客対応には高性能なモデルを割り当てる構成が可能だ。推論深度と応答速度とコストをタスクごとに最適化できるため、大規模な音声エージェントの運用コストを抑えながら品質を維持できる。この柔軟性は、単一モデルですべてを処理する構成では得られない利点だ。
音声処理と推論を分離することで、タスクごとに最適なモデルを組み合わせられる。この柔軟性がGPT-Live-1の大きな特徴だ。会話を続けながらバックグラウンドで推論が進むため、ユーザーを待たせない体験も実現できる。
ネイティブ機能の充実
GPT-Live-1はASR(自動音声認識)のトランスクリプトと応答テキストをネイティブに提供する。英数字の認識精度が高く、特定のキーワードを優先的に認識させるキーワードバイアス機能も備える。ターン制モデルではないが、明示的な発話ターンの境界を検出するターン検出機能もネイティブサポートしており、既存のターン制ベースのワークフローからの移行も容易だ。
開発者はシステムプロンプトを通じてエージェントの声のトーン、話す速度、会話スタイルを制御できる。音声の選択肢も従来のリアルタイム音声から大幅に拡充され、アクセントや方言、言語のバリエーションが増やされる予定だ。音声オプションと言語の対応範囲は今後数か月にわたって継続的に拡大される。
評価指標と料金体系
ベンチマークで示された実力
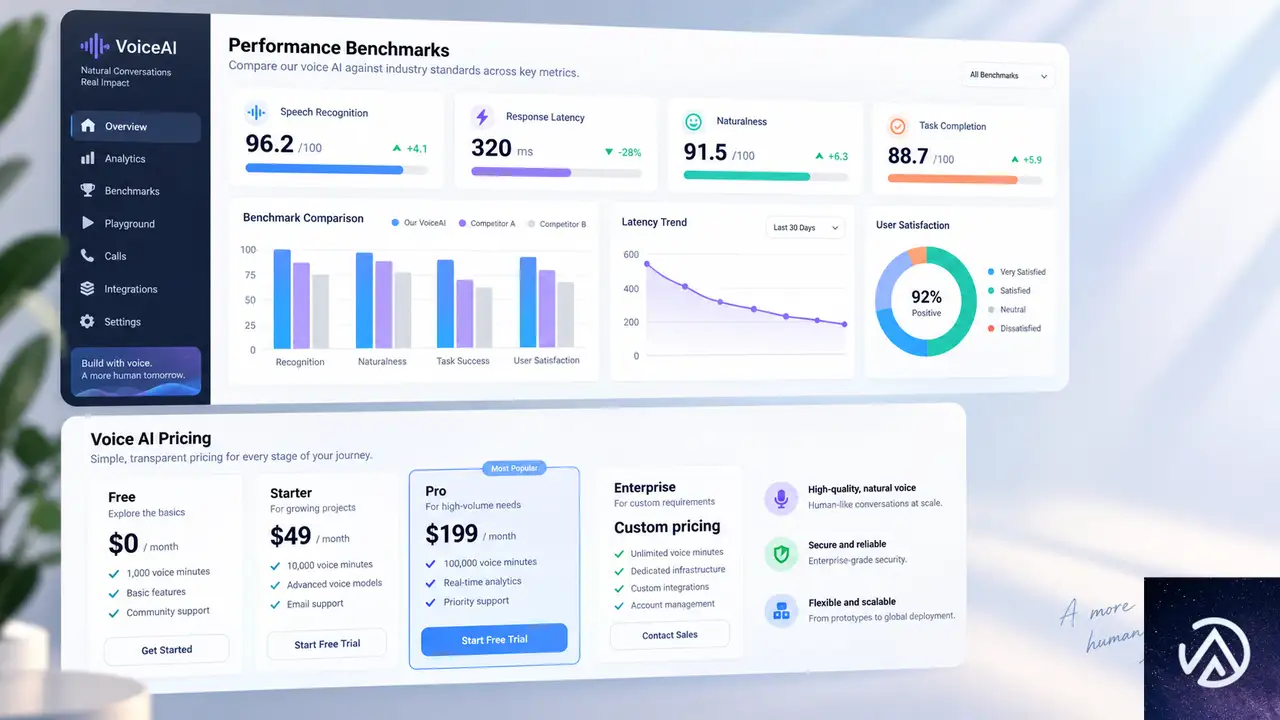
OpenAIの評価では、GPT-Live-1はFull Duplex BenchのスコアをGPT-Realtime-2.1から30ポイント改善した。特にターンテイクの遅延と対話的行動で大きな向上が見られた。GPT-6 Astra(中程度の推論エフォート)と組み合わせた構成では、音声エージェントの総合知能を測定するTau3ベンチマークで1位を獲得している。
評価対象は航空、小売、通信の各ドメインにおける音声カスタマーサービス対応、銀行業務の音声サポート、発話の一時停止への対応、ターンテイク、割り込み処理、バックチャネル(相槌や短い応答)への反応、自然な間や言い直しを含む音声経由のツール呼び出しなど多岐にわたる。満足度と完了率の両面で高いパフォーマンスを示した。
料金体系と展開オプション
GPT-Live-1の料金は、音声フロントエンド部分が1分あたり0.05ドルだ。バックエンドの推論モデルとエージェントハーネスは別途組み合わせる構成になる。推論深度の異なるモデルを使い分けることで、プロダクトの要件に合わせたコスト設計が可能だ。独自のカスタム音声へのアクセスは、OpenAIの営業チームへの問い合わせを通じて申請する。
電話回線を使ったフルデュプレックス音声エージェントの展開もサポートされている。レストラン予約からカスタマーサポートまで、従来は有人対応が必要だった領域に音声AIを導入できる。また、リアルタイム音声対話を企業内システムに統合する「OpenAI Presence」と組み合わせることで、社内システムへのアクセス、承認済みアクションの実行、必要時の人間へのエスカレーションまでを含むエンタープライズ向けの音声エージェントも構築できる。
音声AIの実用化が進む中で、GPT-Live-1のAPI提供は開発者にとって重要な転換点になる。フルデュプレックス方式の導入により、音声エージェントの体験品質が人間との自然な対話に近づくからだ。特に割り込み処理の改善は、教育、カスタマーサポート、ヘルスケアなど対話の質が成果に直結する分野で大きな意味を持つ。従来のターン制音声AIでは実現できなかった「考えながら話す」「話の途中で方向転換する」といった人間らしい対話が、API経由で誰でも利用できるようになった点が重要だ。
この記事のポイント
- GPT-Live-1がAPIで提供開始。同時に聞いて話せるフルデュプレックス音声モデルだ
- 単一モデルで音声入出力を処理し、STTとLLMとTTSをつなぐ従来方式の遅延を構造的に解消する
- Speak社の評価では割り込み回数が約80%削減された
- バックエンドのテキストモデルに推論を委任できる柔軟な構成が特徴だ
- 料金は音声フロントエンドが1分あたり0.05ドル。電話回線への展開も可能だ

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験