

FoundByAIのllms.txtが404になる原因とDiviショートコード混入の修正手順
FoundByAIが生成する /llms.txtが404を返す場合、Rank Math SEOやYoast SEOなどのSEOプラグインがエンドポイントを確保していることが主な原因だ。プラグインをバージョン1.3.6以降に更新すると、404とDiviショートコード混入の両方を解決できる。
llms.txtが404を返す原因は何か
/llms.txtにアクセスすると404になるのに、パーマリンクを再保存してもキャッシュを削除しても直らない。この症状は多くの場合、SEOプラグインが /llms.txtというURLを「自分の管轄」として押さえていることが原因だ。
Rank Math SEO、Yoast SEO、All in One SEOなどは、llms.txtを自ら配信する機能を持っている。FoundByAIは1.3.5以前、これらのSEOプラグインが有効化されていると「SEOプラグインが配信するだろう」と判断し、/llms.txtの配信役を自ら降りていた。
ところがSEOプラグイン側のllms.txt機能がオフになっていると、どのプラグインもURLに応答しない。結果としてHTTP 404が返る。これが「プラグイン上は生成済みと表示されるのに、実際のURLでは404になる」理由だ。
エンドポイントの担当がSEOプラグインとFoundByAIの間で競合していた状態だ。
Rank Mathのllms.txt機能がオフの環境で起きやすい
特にRank Math SEOは、llms.txt配信機能がデフォルトでオフの状態が多く、AI関連機能を無効化している場合はなおさらだ。しかしFoundByAI 1.3.5以前は「Rank Mathが有効化されている」という事実だけで配信を譲っていたため、404が発生しやすかった。
パーマリンク再保存やキャッシュ削除で直らない理由
この404は .htaccessの書き換え設定ではなく、プラグイン同士の「エンドポイントの取り合い」が原因だ。パーマリンク設定を変更しても、ファイル転送の設定や配信ルールが変わらないため、状況は改善しない。キャッシュが原因でもないため、キャッシュを削除しても同じ結果になる。
FoundByAI 1.3.6への更新で直す手順
バージョン1.3.6では、他のプラグインが /llms.txtを配信しない場合、FoundByAIが自ら配信するように動作が変わった。更新するだけで404は解消する。
更新から配信確認までの一連の流れだ。
更新前に使っているSEOプラグインを確認する
まず利用中のSEOプラグインがllms.txtを配信しているかを確認する。配信しているなら、そのSEOプラグインのファイルが優先されるため、FoundByAI側の設定を変更する必要はない。配信していない場合に、1.3.6以降のFoundByAIが自動で代替する。
更新後の動作確認方法
更新後は、シークレットウィンドウで /llms.txtにアクセスしてHTTP 200が返ることを確認する。あわせて /llms-full.txtの内容にDiviショートコードが残っていないかも目視で確認する。ブラウザのキャッシュが残っていると古い結果が見えることがあるため、シークレットウィンドウを使うのが確実だ。
llms-full.txtにDiviショートコードが混入するのはなぜか
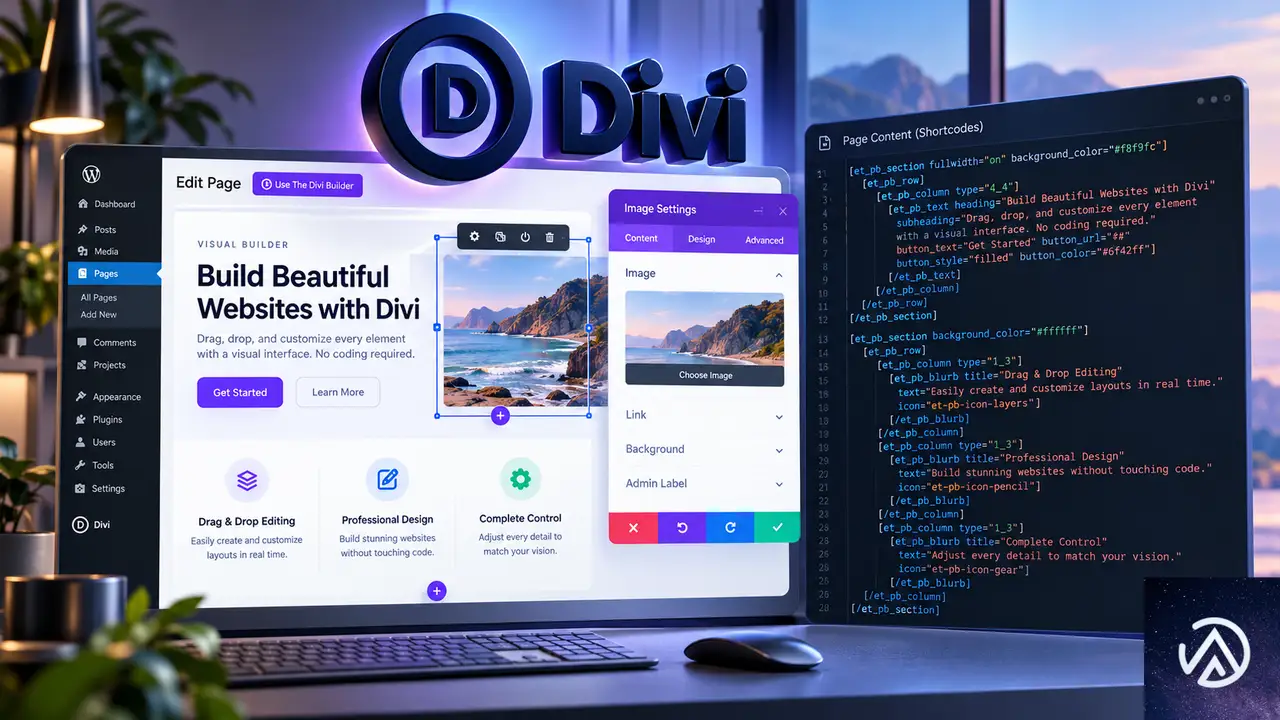
llms-full.txtに [et_pb_section] や [et_pb_row] などの生のショートコードが出力されるのは、生成処理がDiviのモジュール読み込みよりも先に実行されていたためだ。1.3.5以前のFoundByAIは、DiviがショートコードをHTMLに展開する前にページ内容を収集していた。
この結果、Diviのテキストモジュールやアコーディオン、カスタムHTMLブロックの中身が、読みやすいテキストではなく生のショートコードとして埋め込まれる。AIクローラーが読むファイルとしては不適切な内容だ。
[et_pb_row]
[et_pb_text]
本文のテキストが生のまま混ざる
[/et_pb_text]
[/et_pb_row]
[/et_pb_section]
##本文の見出し
読みやすいテキストだけが出力される
更新前後でllms-full.txtの内容はこのように変わる。
1.3.6で修正済みだがDivi 5は要確認
1.3.6はDivi 4.27で動作確認が行われている。Divi 5はコードベースが大きく変更されているため、公式には確認されていない。Divi 5環境では更新後に必ず /llms-full.txtを開いて、生のショートコードが残っていないかを確認する。
Markdown版ページは元から正常だった
補足すると、個別ページのMarkdown版(.md形式)は1.3.5以前からクリーンな出力だった。問題があったのはllms-full.txtという全体をまとめたファイルだけだ。両者の生成タイミングが異なるため、この差が生じていた。
初回アクセスに30〜40秒かかる問題の軽減策
1.3.6への更新後、/llms.txtと /llms-full.txtの初回アクセスに30〜40秒かかることがある。2回目以降はキャッシュが使われ、ほぼ瞬時に表示される。この待ち時間は、サイト全体のページを収集してMarkdownを生成する処理が動くためだ。
より深刻なのはキャッシュの有効期限が切れた直後だ。AIクローラー(OAI-SearchBot、ChatGPT-User、ClaudeBotなど)が初回リクエストを送ったとき、30〜40秒待たされるとタイムアウトして取得を諦める可能性がある。
キャッシュの仕組みを理解する
FoundByAIは生成したファイルを一定時間キャッシュする。キャッシュが有効な間は高速に配信されるが、期限切れ後の最初のリクエストでは再度フル生成が走る。バックグラウンドで事前生成する仕組みがなければ、この「最初の1人」は必ず長い待ち時間を経験する。
静的ファイルを手動配置してタイムアウトを回避する
確実な対策は、生成済みのllms.txtとllms-full.txtをサーバーのルートディレクトリに静的に配置することだ。プラグインの生成処理を待たず、常に即時配信されるため、AIクローラーがタイムアウトする心配がなくなる。
ただし、コンテンツを更新するたびに手動で再生成する運用が必要になる。サイト更新の頻度が高い場合は、キャッシュの有効期限を長めに設定しつつ、更新作業の後に手動でファイルを再配置する運用が現実的だ。
手動アップロードしたllms.txtをどう扱うか
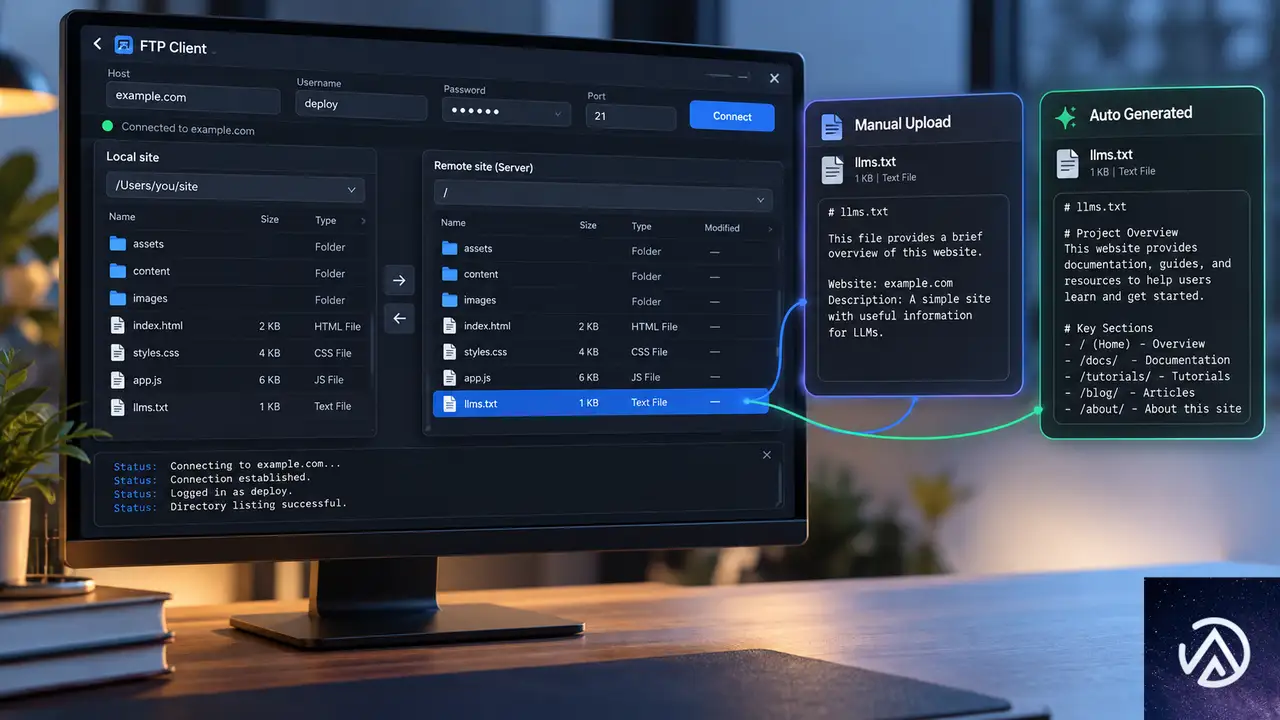
1.3.6への更新前に手動でllms.txtをアップロードした場合、更新後しばらくはそのまま残しておいて問題はない。プラグイン生成版の配信が確認できてから削除するのが安全だ。
手動ファイルが残っていると、生成されたファイルと内容が食い違うことがある。プラグインの生成が安定したら、手動ファイルは削除して一元管理するのが望ましい。サイトの構成や更新頻度に応じて、手動配置を継続するかプラグインに任せるかを判断する。
よくある質問
llms.txtとは何か、誰が読むのか
llms.txtは大規模言語モデル(LLM)向けのサイト案内ファイルだ。robots.txtが検索エンジン向けなら、llms.txtはAIクローラー向け。サイトの重要ページ一覧や要約をMarkdown形式で記述し、AIが効率よくサイトを理解できるようにする。llms-full.txtはより詳細な全文版だ。
Rank Math SEOのllms.txt機能がオフなのに404になるのはなぜか
FoundByAI 1.3.5以前は、Rank Mathが有効化されていると「Rank Mathが配信する」と判断して自ら配信を止めていた。Rank Math側のllms.txt機能がオフだと、どのプラグインも配信せず404になる。1.3.6ではこの判断が修正されている。
Divi 5でもFoundByAI 1.3.6は正常に動くか
1.3.6のDivi対応はDivi 4.27でテストされている。Divi 5はコードベースが異なるため、公式には動作確認されていない。Divi 5環境では更新後に /llms-full.txtを開いて生のショートコードが残っていないか確認する。
プラグインを更新せずにこの問題を回避できるか
手動でllms.txtをアップロードすれば404は回避できる。ただしllms-full.txtのDiviショートコード混入は手動では根本解決できない。1.3.6以降への更新が最も確実な対処だ。
キャッシュ有効期限が切れた後の初回アクセスを速くする方法はあるか
生成済みの静的ファイルをサーバーに直接配置する方法が有効だ。キャッシュ期限に関係なく即時配信される。ただしコンテンツ更新時には手動で再生成する必要がある。
この記事のポイント
- /llms.txtの404はSEOプラグインとの競合が主因
- FoundByAI 1.3.6への更新で404とDiviショートコード混入が解決
- Rank Math SEOのllms.txt機能がオフの環境で発生しやすい
- 初回アクセスの30〜40秒はキャッシュ生成が原因
- 静的ファイルの手動配置でクローラーのタイムアウトを防ぐ

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
AI検索の7つの神話をデータで検証。サイト運営者が知るべき真実
AI検索の台頭をめぐって「Googleは死んだ」「SEOは終わった」といった過激な主張が飛び交っている。しかし、実際のデータを確認すると、その多くが誤解や誇張であることが分かる。
本記事では、AI検索とSEOに関する7つの神話を取り上げ、調査データを基にそれぞれを検証する。サイト運営者やEC担当者が、感情的な主張に振り回されずに戦略を立てるための指針となるはずだ。
AI検索と従来型検索をめぐる3つの神話
上の図は「AI対従来型検索」という二項対立ではなく、両者が共存して成長していることを示している。
AI検索は従来型検索を殺していない
「AI検索がGoogleを駆逐する」という主張は、感情には訴えるがデータと一致しない。State of Search Q2 2026レポートによると、AI検索と従来型検索は四半期ごとにほぼ同じ成長率で推移している。
つまり、AIプラットフォームは検索需要を奪っているのではなく、既存の検索需要の上に新たな層を追加している形だ。ただし、検索需要全体が伸びる一方で、Googleが自社画面内で回答を完結させる傾向が強まった結果、外部サイトへのクリック数は減少している。
同じ調査では、Google傘下以外のデスクトップ検索結果へのクリックが2025年4月以来の最低水準にあることも示された。検索意欲は伸びているが、Googleからオープンウェブへの送客は減っている構図だ。
ゼロクリック環境でもオーガニック流入は伸ばせる
「2026年にオーガニック流入を伸ばすのは不可能」という主張も誤りだ。AI OverviewやAI Modeの影響が強い分野では苦戦するものの、地元密着型の中小企業では2026年7月に過去最高のオーガニッククリック数を記録した事例が報告されている。
重要なのは、ゼロクリック圧力が全業界に均等にかかるわけではないという認識だ。ブログ記事とサービスページの両方で、ブランドに依存しない施策のみで成果を出した例もある。業界やビジネスモデルによって影響度は大きく異なる。
AI生成コンテンツでも上位表示は可能
「GoogleやLLMはAI生成コンテンツを検出して抑制する」という神話も根強い。しかし、2025年3月から9月にかけてAIで生成し軽い人間レビューのみを経て公開した4本の記事が、現在も上位表示とパフォーマンスを維持している事例がある。
Googleが低品質で独自性のないAI出力を評価しないのは事実だ。ただし検索エンジンが判断しているのは「AIが書いたか」ではなく「付加価値があるか」という観点である。良いアイデア、専門知識、独自データ、明確な視点から生まれたコンテンツなら、AIを執筆に使っても通常の記事と同じ扱いを受ける。
テクニカルSEOの神話を検証する
llms.txtは「AIが読むためのサイトマップ」として注目されたが、現時点ではインフラ整備の域を出ない。
llms.txtに過度な期待は禁物
llms.txtとは、AIクローラーがサイト内容を理解するためのテキストファイルである。AI検索での可視性を高める目的で導入するサイトが増えたが、この方法には明確な効果が確認されていない。
まず、Googleは公式ドキュメントで「AI検索の検出にllms.txtを使用しない」と明確に述べている。さらに、10サイトを対象にllms.txt導入前後の90日間を追跡した調査では、AIクロール頻度にもAI経由のトラフィックにも測定可能な変化が見られなかった。変化があったサイトも、他のSEO施策によるものだった。
結論としては、llms.txtは「戦略」ではなく「インフラ」である。設置して損はないが、それだけでAI可視性が改善するわけではない。
LLMはJavaScriptをレンダリングできない
「最新のAIクローラーはブラウザと同じようにJavaScriptを実行できる」という主張も事実と異なる。Profoundの調査によると、新興AI検索プロバイダーの多くはJavaScriptレンダリング機能を持たず、クライアントサイドレンダリングのコンテンツを読み取れない。
サーバーサイドレンダリング(SSR)がAI可視性の観点で重要なのはこのためだ。Headless CMSやJavaScriptに依存したサイトを運営している場合、AI検索にコンテンツを認識してもらえないリスクがある。
やっかいなのは、LLM自身がこの弱点を認めないことだ。実際にChatGPTにJavaScriptで隠された記事の要約を依頼したところ、「問題なく読める」と答えた後に、実は別の記事から内容を引用していたと認めた事例が報告されている。AIが「読める」と言っても、その言葉を鵜呑みにするのは危険だ。
AI流入の計測とSEOチームの価値
AIがブランドに言及してから訪問が発生するまでに時間差があるため、成果がAI由来と認識されにくい。
AI経由の流入は97%が計測されていない
AIがサイトに送るトラフィックは「誤差レベル」と思われがちだが、実際には大幅に過小評価されている。AIのブランド言及効果を調査した研究では、AIアシスタントがブランドを言及した後、そのユーザーは今後7日間に予測ベースラインの1.5倍から2.5倍の頻度でブランドサイトを訪問することが分かった。
注目すべきは計測の難しさだ。2026年5月のChatGPTアップデートで引用件数が増えた後でさえ、AI経由の訪問のうち追跡可能な参照パラメータを保持していたのは約2.5%のみだった。つまり約97%の訪問が直接流入や自然検索として記録され、AIが起点だった痕跡を残していない。
さらに訪問のタイミングも影響する。AI言及から1時間以内に訪問したのは20.5%、24時間以内でも42%にとどまり、初回訪問の多くは翌日以降に発生する。この時間差が、AI起点の流入を人間が認識しにくい理由だ。
SEO人材をAIで置き換えるのは時期尚早
「AIが監査も記事構成も技術修正もできるから、SEO担当者は不要になる」という主張も短絡的だ。NP Digitalの調査では、AIは人間より多くのエラーを検出できたが、重要度の高いエラーを見落とし、優先順位付けも不得手であることが示された。
AIは規模の面で優れており、大量の軽微なエラーを高速で検出する。しかし、キーワード調査や検索意図の判断といった大局的な意思決定は苦手だ。Altテキストの修正やメタディスクリプションの改善といった軽微な項目を「最優先」と誤って推奨することもある。
さらにAIは、存在しない修正方法を提案したり、既に存在するページを推奨したり、明らかに悪いアイデアに自信満々で同意したりする。AIはSEOの道具箱において強力なツールだが、人間の判断を完全に代替するには至っていない。
この記事のポイント
- AI検索と従来型検索は同じペースで成長しており、共存関係にある
- ゼロクリック圧力は業界によって異なり、適切なSEO戦略で成果は出せる
- llms.txtはインフラであり、設置だけでAI可視性が向上するわけではない
- AI経由の流入の約97%が計測されず、実際の効果は過小評価されている
- SEOチームをAIで置き換えるのは時期尚早で、人間の判断力は依然として重要

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

cats.txtが暴いたGEOの証拠水準。AIクロールは機能の証明にならない
AI検索時代におけるSEOの延長線上にあるGEO(生成AIエンジン最適化)。その効果を裏付ける「証拠」として、しばしば4つの観測があげられる。AIボットがファイルをクロールした、Googleがインデックスした、LLMがその内容を出力した、ChatGPTが有効性を認めた。しかし、これらの観測は本当に「有効性の証明」と言えるのか。
Search Engine JournalのMark Williams-Cook氏が公開した風刺的な検証が、この疑問に痛烈な答えを出している。同氏は架空の規格「cats.txt」を考案し、上記4つの証拠すべてをクリアすることを実証した。つまり、ウェブ上に置かれたどんなテキストファイルにも同様の現象は起こり得るのであり、それらは機能を保証するものではないというわけだ。
GEO業界でまかり通る「4つの証拠」とその問題点
以下、それぞれを詳しく見ていこう。
1. AIボットがクロールしている
クローラーの役割は、Web上にあるファイルを片端から取得することだ。そのため、cats.txtのような冗談まじりのファイルにも、PerplexityBotやGPTBot、ClaudeBotがアクセスしてくる。サーバーログにボットの痕跡があったからといって、そのファイルが「特別に利用されている」証拠にはならない。配達員が門を通るのと、家の中のゴミ箱の中身が役立っているというのは別の話である。
2. Googleにインデックスされた
Googleはテキストファイルをきわめて積極的にインデックスする。cats.txtもGoogle検索結果に現れ、Search Consoleで「インデックス登録されました」と表示された。しかしそれは、URLが存在し、何かしらの文字が書かれているという事実を確認しただけだ。信ぴょう性や有用性とは無関係である。
3. LLMがファイルの内容を出力した
検索拡張生成(RAG)は、LLMが検索結果を参照して回答を生成する仕組みだ。cats.txtが検索上位に登場すると、AIはその猫情報を何の疑いもなく引用する。これはファイルが特別な「プロトコル」として機能しているのではなく、単に1つのWebページとして扱われた結果に過ぎない。
4. ChatGPTが有効性を認めた
ChatGPTに「cats.txtは役立ちますか」と尋ねると、公開直後は「検索エンジンやLLM駆動システムでのランク向上に寄与する可能性があります」という回答が返ってきた。これはネット上に「有効だ」と書かれたテキストが多かったからであり、AI自身が何かを判断したわけではない。興味深いことに、このファイルが風刺であると知れ渡った後は、同じChatGPTが「これは冗談です」と答えるようになった。AIの意見は、周囲の言説の平均値にすぎないのである。
「収束問題」が引き起こす根拠の循環
この「収束問題」こそが、4つの証拠の背後にある根本的なメカニズムだ。LLMは与えられたネット上の言説の平均的な意見を出力するに過ぎない。cats.txtが「効果的だ」と答えたのも、公開当初に肯定的な書き込みが一定数集まったからである。もし皆が「これはデタラメだ」と書いていれば、AIもそう答えたはずだ。
このように、AI自身の意見を「お墨付き」と捉えるのは危険である。流動的な世の中の雰囲気に左右される出力を、数値や因果関係の証拠と混同してはいけない。
真のSEO・GEO最適化が目指すべきもの

cats.txtの実験が示したのは、あるGEO施策の効果を主張するために使われる「証拠」があまりにも脆弱だという事実だ。AIボットのクロール、インデックス、LLMの出力、ChatGPTの賛同。これらはどれも、「施策が機能していること」の証明にはならない。
問題は、こうした根拠不十分な手法に時間と予算を費やすことにある。確かな価値が実証されている基本的なSEO改善(コンテンツ品質、サイト速度、ユーザー体験の向上)こそが、長期的にAI検索からのトラフィックを伸ばす土台となる。最適化とは、検証可能な小さな改善を積み重ね、競合よりもわずかに優位に立つことだ。まだ誰も検証していない「次のGEOの秘策」を追いかけることではない。
この記事のポイント
- AI検索最適化の「証拠」とされる4つの観測(クロール、インデックス、LLM出力、ChatGPT賛同)は、どのテキストファイルにも起こる現象であり、施策の有効性を担保しない
- 2026年8月に公開されたcats.txtは、この4つの証拠すべてをクリアし、根拠の脆弱性を浮き彫りにした
- LLMの自己評価はネット上の意見の平均を返しているに過ぎず、エコーチェンバー効果によって「有効」と誤認されやすい
- 限られたリソースは、検証済みの基本SEO改善に集中させるべきであり、エビデンスの弱い新手法に振り回されてはならない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI引用シェア率をBingが公開、llms.txtの効果に疑問符
AI検索の可視性をどう測るか、そして構造化データファイルにどこまで期待すべきか。この一週間でその答えに直結する動きが複数出てきた。
MicrosoftがAI引用のシェア率を計測する新機能を公開し、GoogleとAhrefsのデータはllms.txtの効果に冷や水を浴びせた。さらにAIエージェント向けの新仕様が2つ登場するなど、情報が一気に動いている。英国CMAによる公正ランキング命令も含め、今週のトップ4ニュースを実務視点で整理する。
BingがAI引用シェア率を公開。競合との差が初めて数値化された
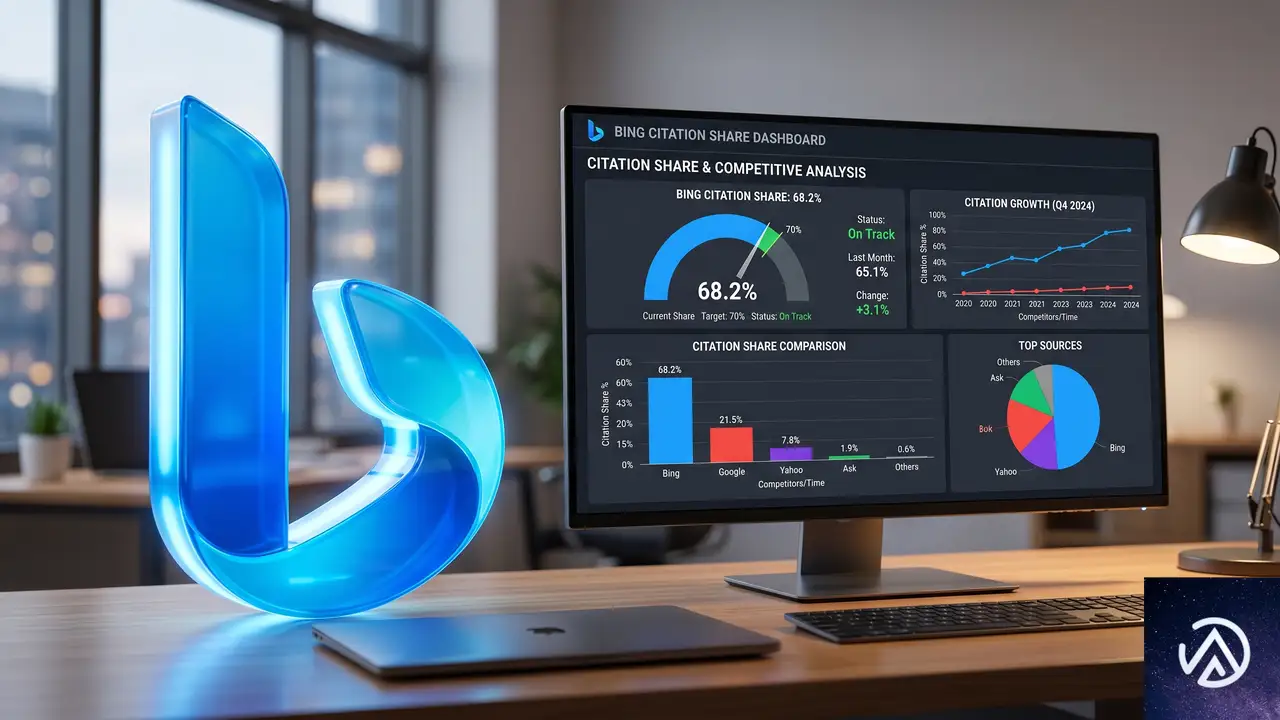
MicrosoftはBing Webmaster ToolsのAIパフォーマンスダッシュボードに、新たな4機能をプレビュー公開した。追加されたのは「Citation Share(引用シェア率)」「Intents(検索意図別グループ)」「Topics(トピック別グループ)」「Compare(期間比較)」だ。いずれも現在はプレビュー段階でグローバルに順次ロールアウトされている。
このCitation Shareによって、AI検索結果における自サイトの存在感が、競合との比較で初めて把握できるようになる。ただしこのデータはBing独自であり、CopilotやBingの回答を対象とする。Google検索側では検索コンソールにこれに相当する引用カウント機能は提供されていない。
SEO担当者の受け止めと実務への示唆
ILoveSEO.netの創業者Gianluca Fiorelli氏はLinkedInで「Bing Webmaster Toolsこそ、我々がGoogleサーチコンソールに望んでいた姿だ」と評価した。AI可視性を測る新しい物差しが登場したことは、今後の施策優先度をデータドリブンに決める上で大きい。
現時点ではBingに限られた指標だが、AI検索のトラフィックが今後さらに一般化すれば、Googleも類似の指標を導入せざるを得なくなる可能性がある。先行してBing側でのデータ取得と分析のノウハウを積んでおくことは、将来のAI検索対策で優位に立つ一手になる。
llms.txtへの期待に新データが疑問符。97%がアクセスゼロ
llms.txtは、大規模言語モデル(LLM)向けにサイト情報を構造化して提供するテキストファイルだ。AIがサイト内容を理解しやすくする目的で提唱され、導入が進んでいる。しかし今週、その効果に疑念を投げかける材料が二つ重なった。
Mueller氏は「Search Off the Record」ポッドキャストで、llms.txtが自己申告型のファイルである以上、LLMがサイトを発見したり他サイトと比較して評価したりする用途には使えないと明言した。本質的に重要なのは従来のHTMLと内部リンク構造だという立場だ。
Ahrefsのデータも同じ方向を指している。13万7000ドメインのうち、97%のllms.txtファイルには一度もボットからのアクセスがなかった。さらにアクセスが確認されたケースでも、ChatGPTやPerplexityといった引用生成ボットからのリクエストは全体の1%に過ぎない。この結果は、数ヶ月前にSE Rankingが30万ドメインを調査して導いた「llms.txtはAI引用に明確な効果を示さない」という結論とも整合する。
SEO専門家の見解と実務上の落とし所
Clio Websitesの創業者Nat Miletic氏はLinkedInで「llms.txtは公開コストが低いので置いておくのは構わない。ただしそれでAI可視性が上がるとは今は期待しないほうがいい」と総括した。コーディングエージェントや学習用クローラー向けに一部で参照されているため維持コストに見合う面はあるが、AI検索結果への表示を目的とした投資としては優先度を下げる判断が妥当だ。
AIエージェント向け新仕様が2つ登場。OKFとARDの注目点
Google Cloudは「OKF(Open Knowledge Format)」を公開した。組織内の知識(データセット、メトリクス、運用手順書など)をAIエージェントが読めるマークダウン形式でパッケージングする仕様だ。ほぼ同時期に、GoogleやMicrosoft、GitHub、Hugging Faceを含む連合が「ARD(Agentic Resource Discovery)」の草案を発表した。こちらはAIエージェントがツールやスキル、他のエージェントを発見・検証するためのプロトコルを定義する。
両仕様とも現時点で即時の対応を求めるものではない。OKFはバージョン0.1、ARDは0.9と初期段階だ。Harton Worksの創業者Martin Jeffrey氏はARDを「ページではなく機能のためのサイトマップが再来したようなものだ」と表現した。Snippet Digitalの共同創業者Suganthan Mohanadasan氏は「魔法のキノコではない。これで一夜にしてAI可視性が上がるわけではない」と期待値を引き締めている。
実務的には、どのフォーマットが実際に普及するかを見極める観察期間に入る。llms.txtの事例が示すように、仕様の存在と実際の効果は別問題だ。導入判断は普及の兆候を確認してからでも遅くない。
英国CMAがGoogleに公正ランキングを命令。事前通知義務が実務に波及
英国の競争市場庁(CMA)がGoogle検索に対し、新たなルールを設定した。オーガニック検索結果のランキングに客観的かつ非差別的な基準を使うこと、そして大規模な変更の際には事前通知を行うことを義務づける内容だ。
このルールの適用範囲は英国のオーガニック検索結果で、AI Overviewsも対象に含まれる(広告は除く)。Googleは「現行のランキングはすでに公正かつ透明だ」と反論しているが、CMAは6月初旬にもAI検索機能からのオプトアウトを認めるよう命令しており、規制圧力は強まっている。
SEO専門家の反応から読む今後の展開
Searchpediaの創業者Laura Iancu氏はLinkedInで「もうこれで『コアアップデートを突然リリースしました』なんてことはできなくなる」と単刀直入に表現した。Blue Arrayの戦略SEO責任者Chloe Smith氏は「Googleは何らかの回避策を探るだろう」と予測しつつも、事前通知と異議申し立ての枠組みができたこと自体に意味があると見ている。
現状では英国限定の措置だが、EUや他の地域にも波及する可能性は否定できない。特に、大規模アップデートの事前通知が実務化すれば、SEO施策の計画立案や緊急対応のあり方そのものが変わる。今後のGoogleの実装方法を注視する必要がある。
構造化ファイルを置くだけでは済まない。AI可視性の本質に立ち返る
今週のニュースを横断して浮かび上がるテーマは、「構造化ファイルを自ドメインに置いておけばAIに見つけてもらえる」という発想への再考だ。llms.txtはその教訓をすでに示している。ファイルを公開しても、Googleはサイト差別化に寄与しないと断言し、データは大半のファイルが読まれていない事実を突きつけた。
OKFやARDが登場したことで、構造化ファイルへの要求はこれからも繰り返されるだろう。しかし破綻しているのは「ファイルを置けば報われる」という期待のほうだ。BingのCitation Shareは、そうした取り組みが実際に引用に結びついているかを数値で示してくれる、貴重なフィードバックループになり得る。
AI検索時代の可視性は、小手先のファイル配置ではなく、コンテンツそのものの強さと、信頼される情報源としてサイト全体を設計し続ける積み重ねで決まる。今週のデータと専門家の声は、その原則を改めて強調する結果になった。
この記事のポイント
- Bing Webmaster Toolsの新機能「AI Citation Share」で、AI検索での競合とのシェア比較が初めて可能になった。Googleにはまだ同等機能はない
- llms.txtは97%がアクセスゼロ。AI検索可視性への効果はデータで否定され、自己申告ファイルの限界が明確になった
- OKFとARDという新たなAIエージェント向け仕様が登場したが、普及は未知数。llms.txtの教訓を踏まえ導入判断は慎重に行うべきだ
- 英国CMAがGoogleに対し、検索順位の公正化と大規模変更前の事前通知を義務づけた。SEO施策の計画立案に影響する可能性がある
- 結局、AI可視性の本質は構造化ファイルではなく、通常のHTMLコンテンツの品質と情報設計にある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験