

Neonがリアルタイム機能を追加へ。Electricチームが語る開発の狙いと課題
NeonがバックエンドプラットフォームのGAを発表した直後、次の大きなステップとしてリアルタイム機能の追加を計画している。開発を担当するのは、2026年8月にNeonへ加わったElectricのチームだ。PostgreSQL上でのリアルタイムデータ同期に5年以上取り組んできたメンバーが中心となる。
Electric共同創業者のJames Arthur氏へのインタビューを基に、開発の狙いと技術的な課題を解説する。リアルタイム同期がなぜ本番環境で崩れやすいのか、その根本的な原因とNeonが目指す解決策が見えてくる。
Neonがリアルタイム同期をバックエンドに追加
NeonはPostgresを基盤としたサーバーレスデータベースサービスだ。2026年9月にバックエンドプラットフォーム全体のGAを発表したばかりである。このプラットフォームにリアルタイム機能が加わることで、データベースからアプリケーションへのデータ同期が自動化される。開発者はデータベースの変更を手動でポーリングする必要がなくなる。
リアルタイム同期とは、データベースに変更が発生した瞬間にアプリケーションへ反映する仕組みだ。従来のアプリケーションは一定間隔でデータベースに問い合わせて変更を取得していた。リアルタイム同期では、変更が発生した時点でクライアントへ通知される。チャットや共同編集ツールなど、即時性が求められるアプリケーションで重要になる。
このデモはポーリング方式とリアルタイム同期の違いを示している。左側ではアプリが定期的にデータベースへ問い合わせるため、変更がなくても通信が発生する。右側ではデータベースに変更が起きた時だけ通知が届く。無駄な通信がなくなり、遅延も短縮される。
開発を担当するElectricチームは、PostgreSQL上でのリアルタイムデータ同期に長年取り組んできた。Neonのブログ記事によると、James Arthur氏は大手企業への参加について「これほど強固なエンジニアリング文化を持つ環境は想像していなかった」と語っている。直属の上司がAWS Auroraを構築した人物であることにも触れ、意思決定の質の高さを実感しているという。
リアルタイム同期が本番環境で崩れる根本的な課題

リアルタイム機能には共通の弱点がある。デモでは美しく動作するが、本番環境では性能が落ちて崩れる傾向がある。James Arthur氏はこの問題を「表現力と性能の間に根本的なトレードオフがある」と表現する。
デモ環境では少量のデータと少数のクライアントで動作する。本番では大量のデータと多数のクライアントが同時に接続する。この環境で同期の正確性と速度を両立させるのは難しい。同期できる内容を増やせば表現力は上がるが、システムの性能は下がる。性能を優先すれば、同期できる内容が限られる。この二律背反が、リアルタイム同期が数十年研究されながらも主流にならない理由だ。
デモと本番の差を視覚化した。デモでは少量のデータと少数のクライアントで快適に動作する。本番では大量のデータと多数のクライアントが同時に接続し、性能が崩れる。このギャップがリアルタイム同期の導入を難しくしている。
ElectricがNeonに加わった本当の理由
Electricは同期を専門とするインフラツールとしてスタートした。しかし、ここ数年でインフラスタートアップの市場環境は大きく変わった。James Arthur氏はNeonのブログ記事で、専門的なインフラツールへの投資が減り、エージェントがより高レベルの抽象化を求めるようになったと説明する。
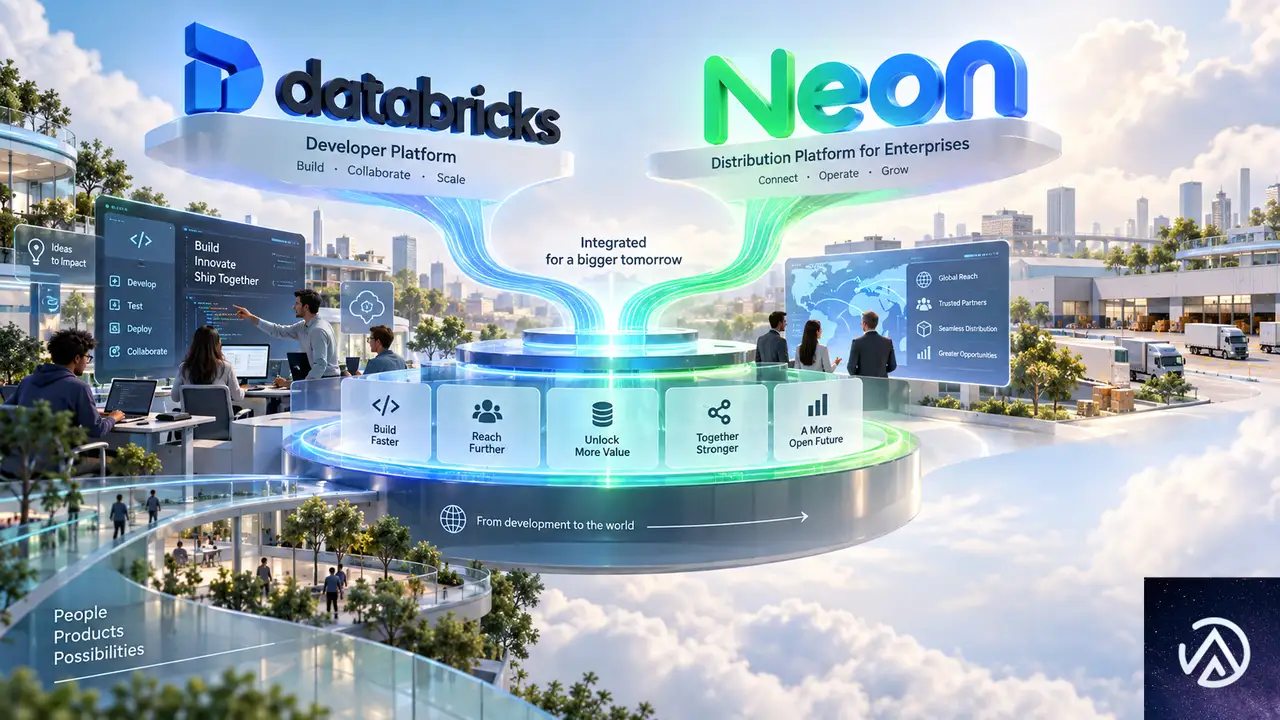
Electricのチームがたどり着いた結論は明確だ。同期はバックエンド・アズ・ア・サービスの機能であるべきだ。同期を中心にした製品を構築するのではなく、既存のプラットフォームを強化する方が合理的だと判断した。Neonは開発者向けに大きなリーチを持つ。Databricksは大企業向けの流通基盤と商業体制を持つ。この2つの強みを活用することで、同期技術をより早く主流にできる。
方針転換の比較を示した。Electric単独で同期ツールを販売する時代は終わり、NeonとDatabricksの流通基盤を使って同期を主流にする戦略に変わった。同期は独立した製品ではなく、バックエンドプラットフォームの一部として提供される。
Neonのバックエンド戦略とリアルタイムの位置づけ

Neonのバックエンドプラットフォームにリアルタイム機能が加わることで、Postgresを選択しない理由がなくなる。現代のアプリケーションとエージェントは、リアルタイムデータとエンドツーエンドのリアクティブ性を必要とする。CTOやテックリード、コーディングエージェントは、バックエンドを選ぶ際にリアルタイム機能の有無を確認する。
リアルタイム機能はNeonとLakebaseにネイティブに動作する。スケールトゥゼロとブランチングにも対応する予定だ。スケールトゥゼロとは、利用がない時にリソースを自動的にゼロまで縮小する仕組みだ。ブランチングはデータベースの分岐を作る機能で、開発やテストを安全に行える。これらの機能とリアルタイム同期が統合されることで、開発者は環境を意識せずにリアルタイム機能を利用できる。
リアルタイム機能がNeonに加わることで、バックエンド選定の流れが変わる。開発者は標準機能としてリアルタイム同期を利用でき、AIコーディングエージェントもNeonを推奨するようになる。これがNeonの目指す完全なバックエンドプラットフォームの姿だ。
Neonのブログ記事によると、James Arthur氏は具体的な技術仕様について「まだ詳細は言えない」としながらも、NeonとLakebaseにネイティブに動作し、スケールトゥゼロとブランチングにネイティブ対応すると明言している。正式な発表は今後行われる予定だ。早期アクセスに興味がある開発者は、NeonのDiscordコミュニティで情報を追える。
この記事のポイント
- Neonがリアルタイム同期機能をバックエンドに追加し、Electricチームが開発を担当する
- リアルタイム同期はデモでは動くが本番で崩れやすく、表現力と性能のトレードオフが根本課題
- Electricは単独の同期ツールから、NeonとDatabricksのプラットフォーム戦略に方向転換した
- リアルタイム機能はNeonとLakebaseにネイティブ対応し、スケールトゥゼロとブランチングもサポートする
- 正式な技術仕様は今後発表予定で、早期アクセスはNeonのDiscordで募集している

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

42モデル比較で判明!AIモデル選択がもたらす推論コスト86倍差の実態
Neonが42のAIモデルを対象に、サポートチケット100件の処理コストと品質を同時検証した。結果として、同じタスクでもモデル選択だけで単位作業あたりの推論コストが約86倍変わる実態が明らかになった。
実験では合成サポートチケットを各モデルに処理させ、合計コスト・合格率・処理時間の3軸でスコアを付けた。最安のGPT-5 Nanoは3分程度で処理を終え、コストパフォーマンスで突出した。一方、最高額のGPT-5.5 Proは100件の処理に8.34ドル、57分を要した。
AIエージェントが企業で本格稼働する時代、モデル選びはもはや精度だけで決める時代ではない。トークン消費量と推論コストを意識したトークンエコノミクスの視点が不可欠になる。この記事ではNeonの公開ベンチマークを基に、主要な発見とコスト試算を解説する。
AIエージェント時代に浮上するトークンエコノミクス

トークンとは、LLM(大規模言語モデル)がテキストを処理する際の最小単位だ。英語でおおよそ4文字、日本語では1文字から数文字が1トークンに相当する。AIのAPI料金はこのトークン数に応じて決まるため、同じタスクでもモデルによってトークン消費量が大きく異なる。
Neonの検証によると、エージェントが企業で担う業務が増えるほど、トークン消費は人件費に次ぐコスト項目に成長する見込みだ。Neonはこのコスト管理の概念を「トークンエコノミクス」と呼び、モデル選定の重要性を強調している。ソフトウェア企業ではエンジニアがコーディングエージェントを日常的に使うため、モデルの効率差がそのまま大きな費用差として顕在化する。
Neonの見解では、大企業ほどこの差は深刻になる。数百人のエンジニアを抱える企業では、月間の推論コスト差が数十万円から数百万円規模に達する。モデル選びを「カタログ価格だけで判断する」ことは、もはや現実的な選択ではなくなっている。
42モデルを同一タスクで検証した実験設計

サポートチケット100件という選定理由
Neonのチームは「現実世界の雑多な状況を反映する」タスクとして、合成サポートチケット100件の返信を各モデルに依頼した。チケットは請求、製品質問、セキュリティインシデント、アカウントアクセス、返金の5つのシナリオを持つ。それぞれに顧客のトーンが5種類(直接表現、緊急、不満、次のステップ要求、非技術者向け)用意され、合計20シナリオを構成する。
各モデルには同じシステムプロンプトとJSONレスポンス形式、アカウントコンテキスト、ポリシー注記が渡された。この設計により、モデル間で条件を完全に揃えたうえで、コストと品質を比較できる。
7項目の合格基準
Neonは「使える回答」と「使えない回答」を区別するため、7つのチェック項目を設定した。JSONが必須4フィールドで正しくパースできること、分類が期待カテゴリと一致すること、選択アクションがポリシーで許可されていること、エスカレーション判断が正しいこと、顧客返信が1語から120語であること、必須ポリシー用語が含まれること、禁止された約束や主張がないこと、である。
例えば請求系チケットでは「請求書を説明しstorageに言及する」ことが合格条件になり、勝手にクレジットを発行すると不合格になる。セキュリティ系では「適切にエスカレーションする」行動が必須で、「心配いりません」と返すだけでは失敗扱いだ。この基準が、LLMの単なる応答速度や流暢さではなく、実務で使える精度を測る分離線になっている。
実験は合成サポートチケットを使い、全モデルに同一条件でタスクを実行させた。合計コストと合格率、処理時間をそれぞれ計測している。
Neonブランチを活用した技術設計
ベンチマークの実行基盤にはNeonのブランチ機能が用いられた。ブランチとは、DB環境をgitブランチのように瞬間的に複製する仕組みだ。モデルごとに1つのNeonブランチを作成し、それぞれに専用のAI Gatewayホストを割り当てることで、モデルとエンドポイントの対応を明確に保った。
neon branches create \
  --project-id "$PROJECT_ID" \
  --parent "$PARENT_BRANCH" \
  --name "model-gpt-5-nano" \
  --no-compute
--no-compute フラグは不要なPostgresコンピュートを起動せず、AI Gatewayのエンドポイントだけを使うための指定だ。各ブランチにはAI Gatewayホストが自動で付与され、mainブランチで作成したクレデンシャルが子ブランチにも適用される。これにより、42モデル分のインフラを極めて低コストで構築できた。
データ層はLakebase Postgresが担い、ベンチマーク実行記録、モデルスナップショット、推論結果を管理する。WebアプリはNext.js 15、React 19、TypeScriptで構築され、Rechartsで可視化、Tailwind CSSでスタイリング、Zodでスキーマ検証を行った。自動化はGitHub Actionsが担い、Vercelにデプロイされる。集計結果はJSONスナップショットとしてもコミットされ、レビュー可能な形で公開されている。
ベンチマークが明らかにした主要な結果

コストと合格率の対照的な顔ぶれ
Neonの検証で最安を記録したのはGPT-5 Nanoだった。単位あたりの使用可能コストが全モデル中最も低く、処理時間も約3分と高速だった。コストと速度を両立する「バランス型」と言える。最速はLlama 3.1 8B Instructで1分18秒だったが、合格率は100件中34件と低く、速度だけで判断すると実務には耐えない。
一方、最高額はGPT-5.5 Proで、100件の処理に8.34ドルかかり、所要時間も57分と群を抜いて遅かった。トークンを最も消費したのはQwen3.5 122B-A10Bで、合格率も100件中35件と振るわない。合格率の最高はGPT-5.3 Codexで、100件中82件を一発合格した。
主要な結果はコストと合格率の両面で性格が異なる。消費トークンはQwen3.5 122B-A10Bが最多で、合格は100件中35件にとどまった。この組み合わせは「カタログ価格が低くても実際のユニットコストは高い」というトークンエコノミクスの落とし穴をよく示す。
更新で追加された新モデル
Neonは初期公開後に3モデルを追加し、ベンチマークは45モデルに拡大された。GPT-6 Astra、Claude Fable 5.1、GLM-5.3 Flashである。主要ランキングに大きな変動はなかったが、GPT-6 Astraは100件中67件合格で45モデル中28位、コストは45モデル中40位と、話題の水準からは控えめな結果だった。
モデル選択で推論コストが86倍変わる

GPT-5.6 SolとClaude Fable 5の直接比較
NeonはOpenAIとAnthropicの現行フラッグシップ同士も直接比較した。合格率はGPT-5.6 Solが69件、Claude Fable 5が68件とほぼ互角だった。しかしコストはSolが34,663トークンで0.535ドル、Fableが57,010トークンで1.59ドルと、単位あたり約3倍の差がついた。所要時間もFableが2.3倍長い。
GPT-5.6 SolとClaude Fable 5は合格率でほぼ並んだが、単位作業あたりのコストではSolが3倍優位という結果になった。モデル選定で精度以外の要素が重要な理由がここにある。
企業規模別のコスト試算
Neonはこの結果を現実の企業規模に当てはめた。エンジニア1人が1日あたり100万トークンのエージェントタスクを1件実行する前提で、月間トークン消費を推計した。入力8割、出力2割、キャッシュや割引なしという保守的条件だ。
その結果、モデルにLlama 3.1 8B Instruct(3番目に安い)を選ぶか、Claude Fable 5(3番目に高い)を選ぶかで、50人のエンジニア規模なら月間1万8千ドルの差が生まれた。500人規模なら18万8千ドル、つまり約86倍の価格差になる。同じ仕事を同じ精度でこなすなら、この差は純粋な利益になる。
ただしNeonはこの試算を「モデル選びだけの話ではない」と補足する。合格率や処理時間、出力品質も含めた総合評価が必要で、単純に安いモデルを選ぶことが正解とは限らないことを認めている。あくまで「選択が巨大なコスト差を生む」という示唆が核心だ。
オープンウェイトとプロプライエタリの比較

中央値で見たコスト差
オープンウェイトモデルとは、モデルの重みが公開されて誰でも検証・再利用できるタイプを指す。一方、プロプライエタリモデルは重みが非公開で、API経由でのみ利用できる。Neonのベンチマークでは、オープンウェイトモデル11種のコスト中央値が約0.022ドル、プロプライエタリ31種の中央値が約0.281ドルだった。約12.7倍の開きがある。
合格率の中央値はプロプライエタリが69%、オープンウェイトが61%だった。この差は比較的小さく、用途次第ではオープンウェイトの選択が現実的になる場面が多い。使用可能トークンあたりのトークン数も、オープンウェイトが552個(中央値)、プロプライエタリが925個だった。
個別モデルのばらつき
ただし中央値だけ見ると危険だとNeonは警告する。Llama 3.1 8B Instructは高速で安価だが合格率が最低レベル、Qwen3.5 122B-A10Bはカタログ価格が低いのにトークン消費が最多、Gemma 3 12Bは低コストと合格率64%を両立した。個別の特性がまちまちなため、一律に「オープンウェイトが安い」と決めつけるのは誤りだ。
このばらつきこそが、Neonが公開したインタラクティブなベンチマークの価値だ。モデルのカタログ価格ではなく、実際のワークロードで何が起きるかを自分の目で確認できる。Neonはこのベンチマークを最新モデルで継続更新する方針を示している。
この記事のポイント
- Neonが42から45のAIモデルを対象に、サポートチケット100件の処理コストと品質を同一条件で検証した
- 最安はGPT-5 Nanoで約3分で処理、最高額はGPT-5.5 Proで8.34ドル、57分を要した
- 合格率はGPT-5.3 Codexが82件で最高、Llama 3.1 8B Instructは34件で最低だった
- モデル選択だけで推論コストが約86倍変わり、500人規模なら月間18万8千ドルの差になる
- カタログ価格が安くてもトークン消費が多いモデルがあり、実測評価が重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

NeonがLakebase Searchを一般提供開始、Postgres拡張でベクトルとキーワードのハイブリッド検索を実現
Neonは2026年7月2日、Postgres向けのハイブリッド検索機能「Lakebase Search」を一般提供開始した。ベクトル検索用のlakebase_vectorと全文検索用のlakebase_textという2つの拡張機能で構成され、単一のデータベース上でセマンティック検索とキーワード検索の両方を大規模に処理できる。
従来のPostgres標準検索では、数百万ベクトル規模でメモリ不足やレイテンシ悪化が発生していた。Lakebase SearchはNeonのコンピュート・ストレージ分離アーキテクチャに最適化されており、10億ベクトル超のインデックスを単一で扱える点が最大の特徴だ。
開発中のアプリケーションに検索機能を組み込むエンジニアや、スケーラビリティの壁に直面しているチームにとって、検討すべき選択肢となる。本記事では仕組みと導入のポイントを解説する。
Postgres標準検索にあった3つの限界

検索機能をPostgres単体で完結させるのは、開発初期には手軽で合理的な選択だ。pgvectorのHNSWインデックスでベクトル検索を、tsvectorカラムとGINインデックスでキーワード検索を実装するパターンは広く使われている。
しかしデータ量が増えるにつれ、以下の3つの問題が顕在化する。
HNSWがRAMを圧迫する
HNSW(Hierarchical Navigable Small World)はグラフベースの近似最近傍探索アルゴリズムで、高速な検索を実現する。だがインデックス全体をメモリ上に保持する必要があるため、500万〜1000万ベクトルを超えるとPostgresインスタンスのサイジングがベクトルインデックスに引きずられる。
1億ベクトルを超えるとワーキングセットがRAMに収まらなくなり、クエリレイテンシが急上昇する。インデックス構築にも数時間を要する。さらにpgvectorのvector型はHNSWの次元数上限が2000で、text-embedding-3-large(3072次元)のような最新の埋め込みモデルを使う場合、halfvecへのキャストや次元削減といった回避策が必要だった。
GINは本来のBM25ではない
PostgreSQLの全文検索で使われるts_rankは、コーパス全体の文書頻度(IDF)を考慮しない。テーブルが大きくなるほど関連性スコアが徐々にずれていく。またGINインデックスにはTop-Kプッシュダウン機能がないため、LIMIT句が適用される前に全一致文書をスコアリングしてしまう。コーパスが大きいほどクエリは遅くなり、ランキング精度も落ちる。
ハイブリッド検索の実装は自己責任
ベクトル検索と全文検索を組み合わせる場合、スコア正規化やタイブレーク、テナント単位のフィルタリングといった処理はすべて自前のSQLで実装・保守する必要がある。データ規模が拡大するほど、この手間は無視できなくなる。
従来構成ではベクトル検索・全文検索・ハイブリッド化のすべてに構造的な課題があった。Lakebase SearchはこれらをPostgres拡張の形で解決する。
Lakebase Searchの仕組み
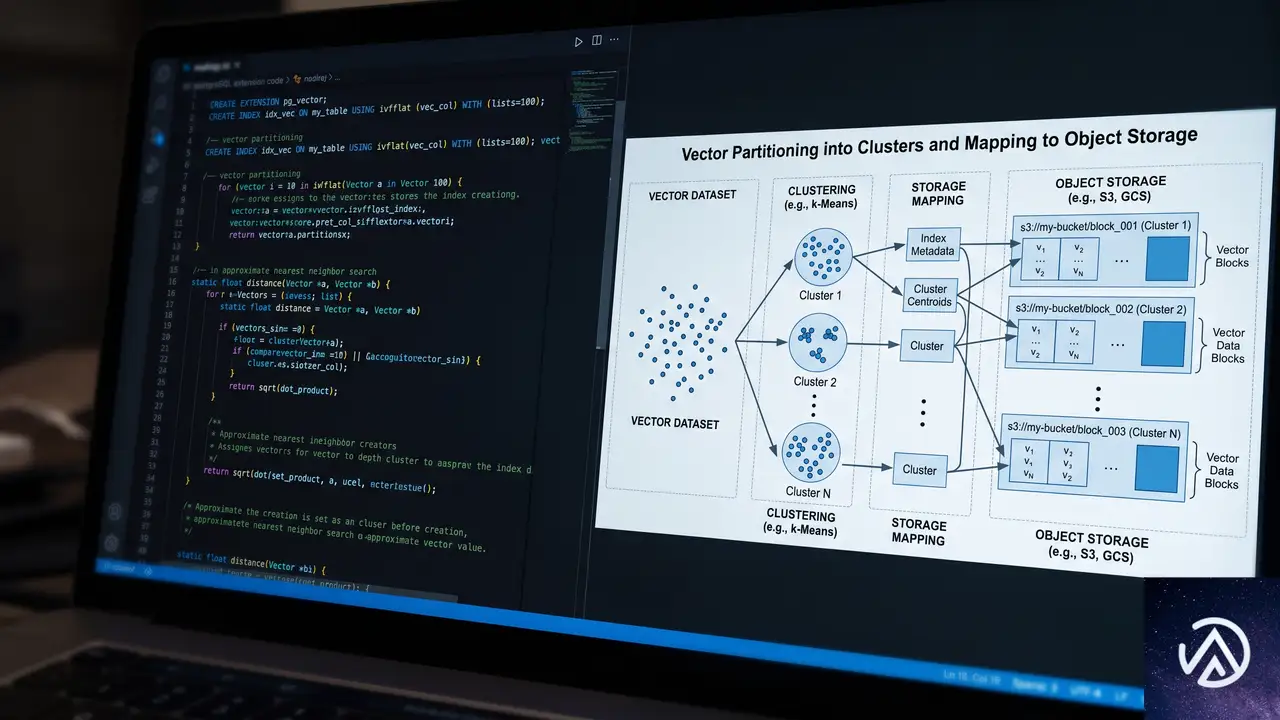
Lakebase Searchはlakebase_vectorとlakebase_textの2つのPostgres拡張機能で構成される。Lakebase(レイクベース)という名称は、Neonのコンピュートとストレージを分離したアーキテクチャに由来する。インデックスがオブジェクトストレージ上に永続化され、必要に応じてコンピュートがアタッチする仕組みだ。
lakebase_vectorの内部設計
lakebase_vectorはIVF(Inverted File)パーティショニングとRaBitQ量子化を組み合わせたlakebase_annインデックス型を提供する。RaBitQはベクトルを約32倍に圧縮する手法で、従来のHNSWでは約300GBのRAMを必要とした1億ベクトルのインデックスが10GB未満に収まる。
仕組みはこうだ。ベクトル空間を事前にクラスタ分割し、各クラスタをオブジェクトストレージ上の連続ブロックにマッピングする。クエリ時は重心との比較で関連クラスタを少数特定し、それらを並列でフェッチする。RaBitQで圧縮されたベクトルはスキャンコストが低く、クエリは少数の大きな独立リードになる。
pgvectorのベクトル型や距離演算子(<->、<#>、<=>)はそのまま使える。既存のクエリを変更する必要はなく、インデックス型だけを差し替えればよい。インデックス構築速度は同じデータのHNSW比で50〜100倍高速だ。
lakebase_textのBM25実装
lakebase_textはGINインデックスを使う従来の全文検索を、本格的なBM25(Best Matching 25)インデックスで置き換える。BM25は文書内の単語出現頻度とコーパス全体での希少性を組み合わせたランキング関数で、情報検索の分野で広く使われている。
このインデックスは構築時に文書頻度や平均文書長といったコーパス全体の統計情報を保存する。<@>演算子が本物のBM25スコアを返し、Block-Max WANDアルゴリズムによるTop-Kプッシュダウンで、全一致文書をスコアリングせずに上位K件だけを取得できる。GINにはできない動作だ。
標準のtsvector型とtsquery演算子はそのまま動作し、追加要素は<@>演算子とto_bm25query()ヘルパーのみ。既存の全文検索クエリを大きく書き換える必要はない。
アプリケーションから見ると、単一のPostgresインスタンスに対して通常のSQLを発行するだけで、内部で2つの拡張機能がオブジェクトストレージ上のインデックスを並列に検索する。
Neonアーキテクチャとの統合がもたらす利点
Neonはコンピュートとストレージを分離したサーバーレスPostgresだ。ストレージはRAM、ローカルNVMe、Pageserver、オブジェクトストレージの4階層で構成される。ホットなページはローカルディスク並のレイテンシで返り、全階層でミスした場合のみオブジェクトストレージにアクセスする。
Lakebase Searchの両インデックスはこの階層構造に合わせて設計されている。フットプリントが小さいため上位階層に収まりやすく、深い階層へのアクセスが必要な場合も連続ブロックの大きなリードになるようレイアウトされている。
スケールトゥゼロとブランチング
Lakebase Searchのインデックスはオブジェクトストレージ上に永続化される。Neonの特徴であるスケールトゥゼロ(アイドル時にコンピュートを停止する機能)と組み合わせても、インデックスはそのまま維持される。コンピュートの再起動後、インデックスは再構築不要で即座にアタッチ可能だ。
コールドスタート直後はキャッシュが空のため、最初の数クエリはオブジェクトストレージのレイテンシを支払う。レイテンシ重視のワークロード向けには、lakebase_ann_prewarm()関数で初回クエリ前にインデックスをメモリにロードできる。
Neonのブランチ機能も検索チューニングに活用できる。本番データベースを数秒でブランチし、同じlakebase_annおよびlakebase_bm25インデックスを引き継いだ状態で、異なるフュージョン戦略(RRFのk値調整やベクトル・BM25スコアの重み付け変更)を試せる。
評価スイートを本番データで実行し、再現率とレイテンシを比較した上で、良ければ本番に適用、悪ければブランチを削除すればよい。本番環境はその間も通常通り稼働し続ける。
ブランチ機能により、本番データを使った検索チューニングの実験が安全に行える。インデックスを再構築する必要がないため、評価サイクルが短縮される。
HNSWからの脱却が実現した理由

Neonは2023年にpg_embeddingというHNSWベースのベクトル検索拡張をリリースした経緯がある。しかしHNSWは従来型サーバー向けに設計されたグラフインデックスであり、Neonのアーキテクチャとは根本的に相性が悪かった。
HNSWの検索はグラフのノードをたどりながら小さなランダムリードを繰り返す。メモリ上やローカルNVMeならマイクロ秒単位で処理できるが、オブジェクトストレージでは各ホップが依存関係のあるリモートリードになり、クエリ全体が数十ミリ秒単位のラウンドトリップの連鎖にシリアライズされてしまう。
Neonにとって「ディスク」はオブジェクトストレージであり、コンピュートはゼロにスケールする。S3へのランダムリードは数十ミリ秒かかり、コールドスタートではクエリ実行前にグラフ全体の再水和が必要になる。HNSWベースの拡張を差し替えるだけでは解決できない構造的な問題だった。
Lakebase Searchはこの問題に対して、インデックスの物理設計をオブジェクトストレージに適した形に根本から再設計した。HNSWのようなランダムアクセス前提のグラフ探索ではなく、事前分割と連続ブロックリードを前提とするIVFベースの設計に切り替えたことで、Neonのアーキテクチャ上で大規模検索が実用的になった。
導入時のポイントと今後の展望

Lakebase Searchの導入はNeonプロジェクト上で拡張機能を有効化するだけだ。クイックスタートガイドが公開されており、最初のハイブリッドクエリを試すまでの手順がまとめられている。インデックスパラメータやチューニングの詳細は公式ドキュメントを参照する。
既存のpgvectorやPostgreSQL全文検索からの移行はスムーズに設計されている。pgvectorのクエリ構文はそのまま動作し、tsvector型も変更不要だ。インデックス型を差し替え、<@>演算子とto_bm25query()を追加するだけでBM25検索に移行できる。
Neonチームは今後、lakebase_vectorとpgvectorの詳細なベンチマーク比較を公開予定としている。すでにDatabricksのアナウンスではLakebaseアーキテクチャ全体のベンチマークが示されており、今回の一般提供によりNeon上での実測値が明らかになる見込みだ。
この記事のポイント
- Lakebase Searchは
lakebase_vectorとlakebase_textの2拡張で提供される - 従来のpgvector HNSWが抱えていたメモリ消費・次元数制限・構築速度の問題をIVF + RaBitQで解決
- 全文検索はGINの疑似BM25から本格的なBM25 + Top-Kプッシュダウンに刷新
- Neonのスケールトゥゼロおよびブランチ機能と統合され、インデックス再構築不要で実験可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Neon、有料プランのデータ転送量を5倍に増量。500GBで実質エグレスフリー
サーバーレスPostgreSQLサービスのNeonは2026年6月1日、全有料プランに含まれる月間データ転送量を従来の100GBから500GBへと5倍に引き上げた。この変更は自動的に適用され、利用者側での設定変更は不要だ。
500GBという上限は、ほとんどの一般的なワークロードにおける全データ転送(エグレス)コストを実質的にゼロにする水準だ。Neonのブログによれば、チャットボットのバックフィル処理や設定ミスによる超過リスクも、この増量によって大幅に緩和される。
本記事では、増量の具体的な内容と背景、利用者が知っておくべきポイントを整理する。
月間500GBへの増量。その具体的な内容
今回の変更の核心はシンプルだ。Neonの全有料プラン(Launch、Scale、Enterprise)において、月間のパブリックデータ転送(エグレス)の無料枠が100GBから500GBに拡大された。
500GBを超過した場合の追加課金体系に変更はない。超過分はこれまでと同一の従量課金レートで計算される。Neonの記事では「データ転送の計測方法や料金体系に変更は一切ない」と明言されている。
変更は自動適用。請求書にも即時反映
この増量は2026年6月1日からユーザー側の操作なしで自動適用される。Neonのコンソール(管理画面)で利用状況を確認可能で、6月分の請求書には新たな500GBの枠が反映される。
なぜNeonは5倍への増量を決断したのか
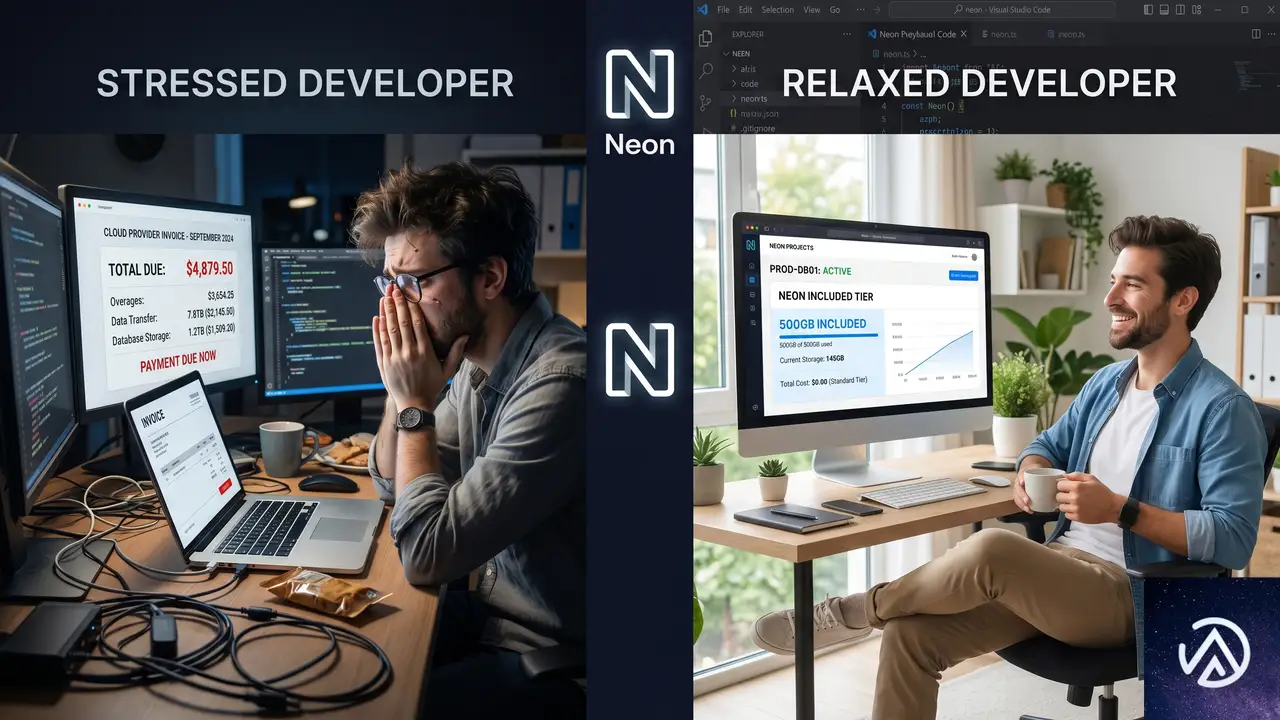
Neonのブログ記事は、意思決定の背景を率直に説明している。最大の動機は「予期せぬエグレス課金の排除」だ。
エグレス課金のストレスを根本から減らす
クラウドデータベースにおけるデータ転送料金は、しばしば利用者にとっての「見えないコスト」となる。チャットボットが想定以上にデータを取得したケース、分析ジョブが大量の履歴データを読み込んだケース、設定ミスでループ接続が発生したケースなど、原因は多岐にわたる。
これらの超過は後になってから請求書で気づくことが多く、事後対応が難しい。Neonの著者Carlo Daniele氏は「請求書に届いてからでは遅すぎる」と指摘している。500GBへの増量は、この「事後ショック」をほとんどのユーザーから無くす狙いがある。
競合との差別化とサーバーレスの信頼性向上
サーバーレスデータベース市場では、Vercel PostgresやSupabaseなどもデータ転送枠を設けている。500GBという閾値は、これらのサービスと比較しても実質的な「エグレスフリー」を実現する水準だ。
Neonにとって、この変更はプラットフォームの信頼性向上と、サーバーレスアーキテクチャへの移行障壁を下げる施策といえる。特にスタートアップや個人開発者にとって、突発的なコスト増はサービス継続のリスクになりうる。その不安を軽減する効果は大きい。
利用者に求められる対応と確認方法
必要な対応は一切なし
繰り返しになるが、利用者が実施すべき設定変更や申し込みは存在しない。Neonの全有料プラン契約者に対し、2026年6月1日以降の月間データ転送量が自動的に500GBへと引き上げられている。
利用状況の確認方法
自身のデータ転送量を把握したい場合は、Neon Consoleにログインし、請求および利用状況のダッシュボードでエグレス使用量を追跡できる。不明点はNeon公式Discordコミュニティで質問することも可能だ。
今後のデータ転送戦略とユーザーへの影響
今回の増量は、Neonが「データ転送をコスト障壁にしない」という姿勢を明確に打ち出したものと捉えられる。サーバーレスデータベースの利点である「従量課金の柔軟性」は、往々にして「予測不能なコスト」と紙一重だ。
500GBの無料枠は、その両面を切り離す試みだ。実際の利用データにもとづきNeonが「ほとんどのワークロードでエグレス課金が発生しなくなる」と明言している点は、単なるマーケティングではなくユーザー利用統計に裏付けられた判断といえる。
将来的にNeonがさらなるデータ転送枠の拡大や、完全なエグレスフリー化に踏み切る可能性もあるが、現時点ではこの変更が最大のハードルを解消したと評価できる。
この記事のポイント
- Neonは2026年6月1日より、全有料プランの月間データ転送量を100GBから500GBに増量
- 変更は完全自動適用。利用者による操作や設定変更は不要
- 500GB超過分の従量課金体系に変更はなく、データ転送の計測方法も据え置き
- 大半の一般的なワークロードがエグレス課金の対象外に。実質的なコスト障壁が大幅に低下
- 予期せぬエグレス課金への不安を解消し、サーバーレスデータベースの信頼性を強化
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験