

OpenAIがAI偽装フロント作戦2件を遮断。ロシア発は過去最大級カテゴリ5
OpenAIは2026年10月8日、ロシア発とイラン発のAIを利用した偽装フロント作戦2件を遮断したと発表した。ロシア発の作戦は影響工作の評価尺度でカテゴリ5と判定され、これはOpenAIが報告を開始して以来初の事例となる。
偽装フロントとは、実在しない組織や人物を装って情報を流す手口だ。ロシア発の作戦はラテンアメリカで偽のシンクタンクを運営し、イラン発の作戦は7人の偽ジャーナリスト人格を使って記事を各国メディアに売り込んだ。いずれもAIが作業の効率化に使われていた。
この記事では、2件の作戦の具体的な手口と影響力評価、AIが偽装フロントに与える利点、そしてメディアや企業が取るべき対策を解説する。
摘発の概要と偽装フロントの仕組み
OpenAIは2025年初頭から、AIモデルを使ったサイバー攻撃や隠密影響工作、詐欺などの悪用事例を継続的に報告してきた。今回の発表はその一環で、ロシア発とイラン発の組織的な作戦2件を特定し、関連するChatGPTアカウント群を停止した。
偽装フロントとは、実在する組織や人物を装って活動の正体を隠す手法だ。今回摘発された2件はいずれも、AIと従来型の技術を組み合わせて偽装組織を運営していた。目的は、地政学的な対立や紛争に関するメッセージを対象者に届けることにある。
AIが加わった偽装フロントの特徴
OpenAIの報告によると、今回の2件はAI以前の影響工作に似ている一方で、AIによって作業の一部が効率化されていた。イラン発の作戦では長文記事の推敲や編集者への売り込みメール作成に、ロシア発の作戦では内部報告書の草案作成にChatGPTが使われた。
OpenAIが2024年初頭以降に摘発した30件の隠密影響工作を分析すると、メディア掲載に成功した作戦ほど影響力が高くなる傾向がある。ソーシャルメディアだけで拡散させる作戦はカテゴリ1から3にとどまり、実在のメディアに記事を掲載させた作戦はカテゴリ4から5に達していた。
影響工作の評価尺度 Breakout Scale
OpenAIは影響工作の影響力を、米ブルッキングス研究所のBreakout Scale(ブレイクアウトスケール)で評価している。カテゴリ1から6までの6段階で、数字が大きいほど影響力が高い。カテゴリ5は政治家の公的コメントを引き出した水準だ。
Breakout Scaleは米ブルッキングス研究所が提唱した影響工作の評価尺度だ。
ロシア発の作戦 ダーククラーク
OpenAIはロシアを発信元とするChatGPTアカウント群を停止した。この作戦はラテンアメリカ各国を標的にした隠密影響工作で、ウクライナの評判を落とすことと、アルゼンチンやボリビアなどの国内政治に介入することが主な目的だった。
作戦の運営者はChatGPTを主に3つの作業に使っていた。1つ目は内部報告書の作成、2つ目は作戦用コンテンツの生成、3つ目は偽のシンクタンクの業績報告書の草案作成だ。OpenAIはロシアからのモデルアクセスを許可していないため、運営者はVPNを使って接続していた。
偽シンクタンクSRCの運営実態
この作戦の中心にあったのが、社会調査センター(Social Research Center / SRC)という自称のリサーチプラットフォームだ。表向きはインド系移民とラテンアメリカの関係を研究する組織だったが、実際にはロシアのオペレーターが偽人格のミア・クラーク(Mia Clark)を使って制御していた。
内部報告書には、給与体系や雇用、解雇などの人事決定が記録されており、運営者が単なる協力者ではなく組織を支配していたことを示している。ただし、現地スタッフは自分たちがロシアの作戦のために働いているとは知らなかった。OpenAIの見解では、知らずに利用されたスタッフが誠実に調査業務を行っていた。
SRCのウェブサイトには60本以上の記事が掲載されており、その大半は現地スタッフによる独自の内容だった。これは、過去に摘発された別のロシア系偽シンクタンクが記事の多くを盗用していたのとは対照的だ。OpenAIは、この作戦がより長期的に存続可能な偽装組織を構築しようとしていたと分析している。
学校や地域社会を巻き込んだ偽情報
ロシア発の作戦で特徴的だったのは、現地の学校や公的機関を意図せず偽情報の拡散に巻き込んだ点だ。
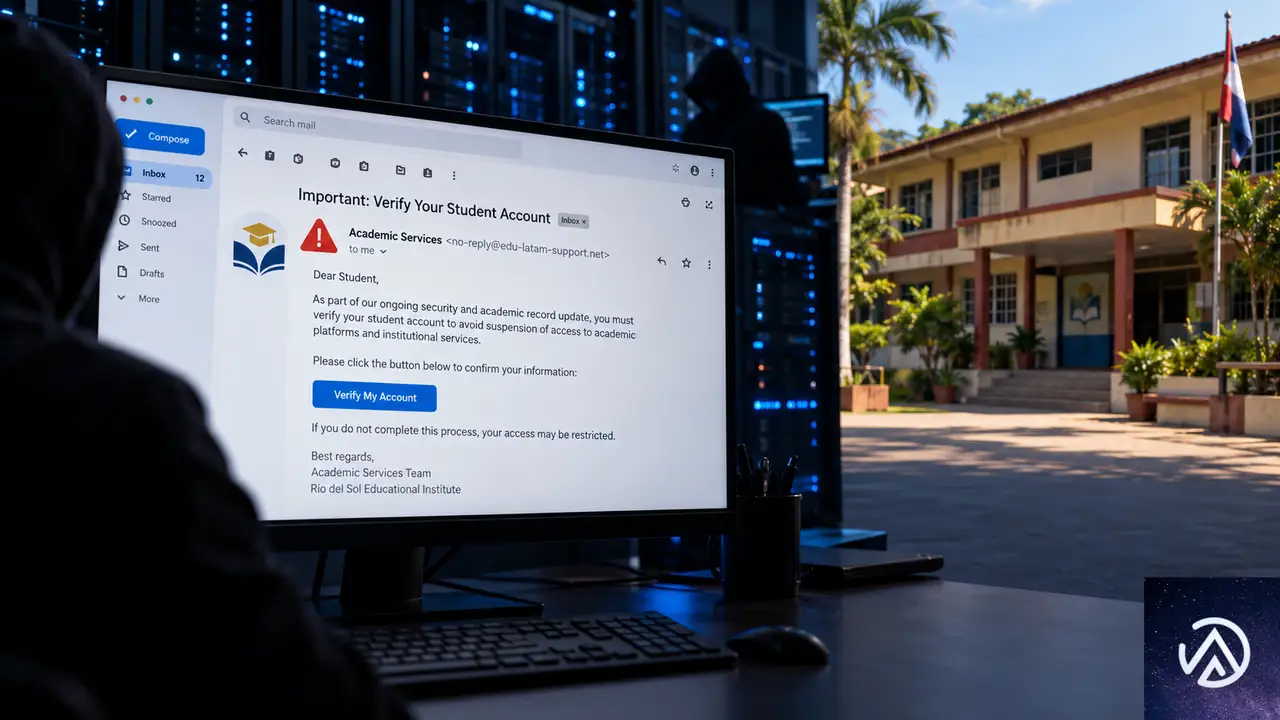
2026年5月、運営者はペルーのリマ教育地方局を装った偽のメールアドレスを作成し、文化・言語多様性の日にウクライナにちなんだ行事を開催するよう学区の学校に指示した。メールには、物議を醸す20世紀のウクライナ民族主義者ステパン・バンデラへの言及を求める指示が含まれていた。一部の学校は偽メールに返信し、行事を実施したと報告して写真まで提供していた。
その後、運営者はペルーとポーランドのメディアにこの出来事の記事を掲載させることに成功した。ウクライナが超国家主義的な思想を輸出しているという主張が広がり、ポーランドの欧州議会議員が反応する事態に発展した。ロシアの偽情報は、ウクライナ人とポーランド人の間の歴史的な緊張を刺激する形で設計されていた。
2026年6月には、別の偽メールアドレスを使ってエクアドルの学校を騙し、ダニエル・ノボア大統領と民間軍事会社ブラックウォーターの元トップ、エリック・プリンスへの忠誠宣誓式を開催させようとした。この出来事はエクアドル国内で大きな反響を呼び、政府が偽情報を否定する声明を出すまでに至った。
ロシア発の作戦は、現地の教育機関やメディアを意図せず巻き込むことで信頼性を高めていた。
ボリビアでは2026年5月下旬、反政府デモが激化する中で、国営水道会社EPSASの職員を装った偽の音声を拡散した。政府が行政首都ラパスへの給水を停止し、非常事態を宣言するという内容だった。この偽情報は公式の否定とファクトチェックを引き起こすほど拡散した。
アルゼンチンでは2024年、ハビエル・ミレイ大統領に関する2つの偽情報キャンペーンを実施したと報告している。1つはミレイ氏が愛犬のためにカルティエの宝石付き首輪を購入したという偽の報道、もう1つはブエノスアイレスで反ミレイの落書きを地元の人物に依頼したというものだ。これらの主張は、公開された内部文書に基づいてポリトロジーやラ・コンパニアと呼ばれるロシアの組織に帰属されている。
カテゴリ5という過去最大級の評価
OpenAIはこの作戦をBreakout Scaleのカテゴリ5と評価した。複数の国の政治家から公的なコメントを引き出したことが決め手となった。これはOpenAIが報告を始めて以来、初めてカテゴリ5を付けた事例だ。
ただし、運営者の自己申告には誇張が含まれている可能性がある。OpenAIの調査では、運営者が自分たちの作戦とは無関係の出来事を成果として報告する傾向があった。例えば、ブラジル人兵士の捕虜に関する報道を自らの成果と主張したが、実際にはその報道は作戦とは無関係だった。運営者が自分の雇用主に対しても影響工作を行っていた可能性が指摘されている。
イラン発の作戦 ボガス・バインラインズ
OpenAIはイランを発信元とするChatGPTアカウント群も停止した。この作戦はペルシャ語でプロンプトを入力し、ペルシャ語と英語でコンテンツを生成していた。運営者はVPNを使ってアクセス元を偽装していた。
作戦の主な活動は、米国とイランの紛争に関する長文記事の推敲と、編集者への売り込みメールの生成だった。加えて、ソーシャルメディアのコメントを大量に生成し、内部報告書の作成にもAIを使っていた。OpenAIはこの作戦にボガス・バインラインズ(Bogus Bylines、偽の署名)という名前を付けた。
7つの偽ジャーナリスト人格
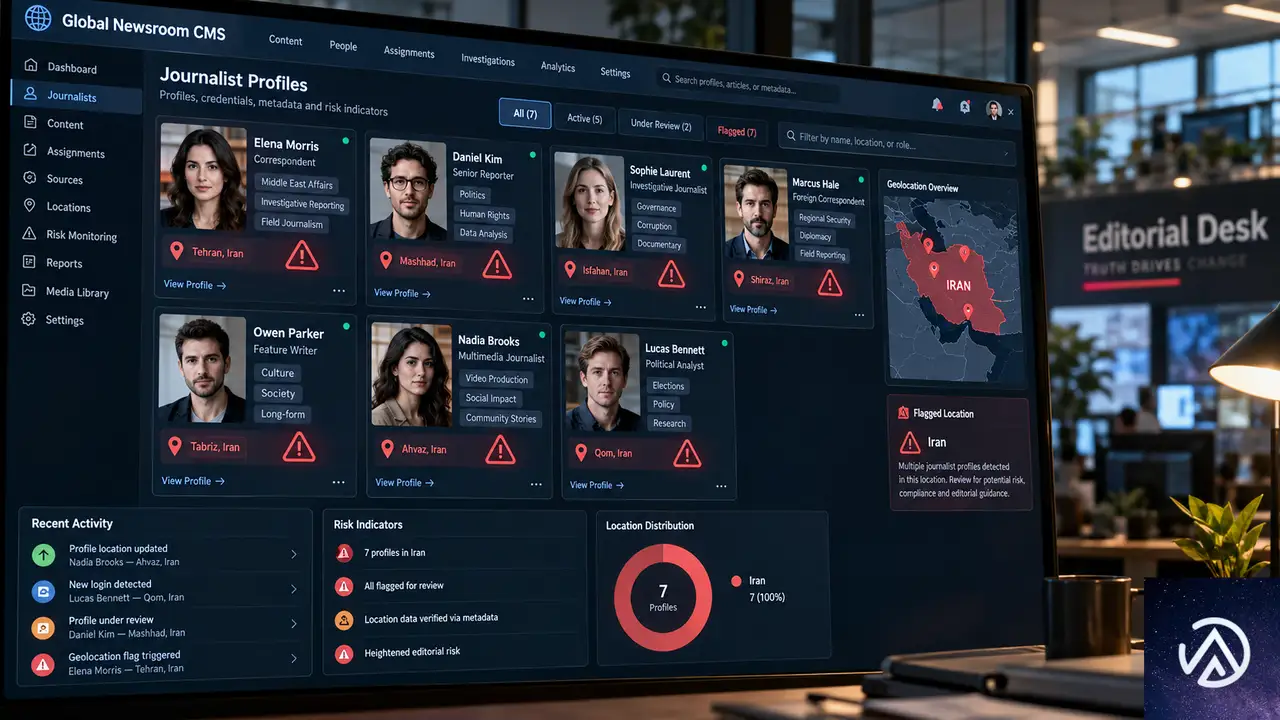
記事の売り込みには7つの偽の署名が使われた。アービン・B・ホスキンズ、ノア・ラミントン、ソフィア・ゴンザレス、マイケル・ハリソン、エリカ・フューザー、ジェニー・ウィリアムズ、アリス・ジョンソンだ。
記事と一緒に公開されたプロフィールでは、それぞれが西洋のジャーナリストを装っていた。多くは米国人ジャーナリストで、国際政治や中東、人権、紛争を専門としていた。ノア・ラミントンはニュージーランド在住と主張していた。マイケル・ハリソンの経歴は、ChatGPTに生成させたものだった。
一部の偽人格は、複数のソーシャルメディアに裏付けアカウントを持っていた。アービン・B・ホスキンズはX、Facebook、Instagram、Threadsにアカウントを持ち、米国人フリーランスライターと自称していたが、アカウントの透明性情報では所在地がイランと表示されていた。
一部の偽人格はSNSアカウントで裏付けされ、信頼性を高めていた。
OpenAIはオープンソース調査により、これらの偽署名で公開された記事を約100本、10数媒体で確認した。対象は主に国際情勢や中東問題を扱う中小規模のオンラインメディアで、米国とイランの紛争が激化した2026年3月以降に記事数が急増していた。
記事掲載とコメント生成の影響力の差
記事掲載とコメント生成という2つの活動の影響力は、大きく異なっていた。
記事掲載は高い成果を上げた。記事を掲載したメディアの中には、Facebookで約200万、Xで約35万5000、Instagramで約54万4000のフォロワーを持つものもあった。メディアが記事をSNSで宣伝することで、運営者は自分たちだけでは届かなかった読者にアクセスできた。OpenAIは記事掲載部分をカテゴリ4と評価している。
一方、コメント生成はほとんど影響力を生まなかった。生成されたコメントは「いいね」や返信が1桁から2桁程度にとどまり、投稿に対する全コメントの中でも少数派だった。コメント部分はカテゴリ2と評価されている。
さらに、運営者はコメントの影響力を水増しする計算方法を使っていた。返信先の投稿の閲覧数をコメント投稿前後で比較し、その差をすべて自らの成果として計上していた。投稿の人気や他のコメントによる閲覧増加を考慮しておらず、実際の影響力を大幅に誇張していたことになる。
AI偽装フロントがもたらすリスクと対策
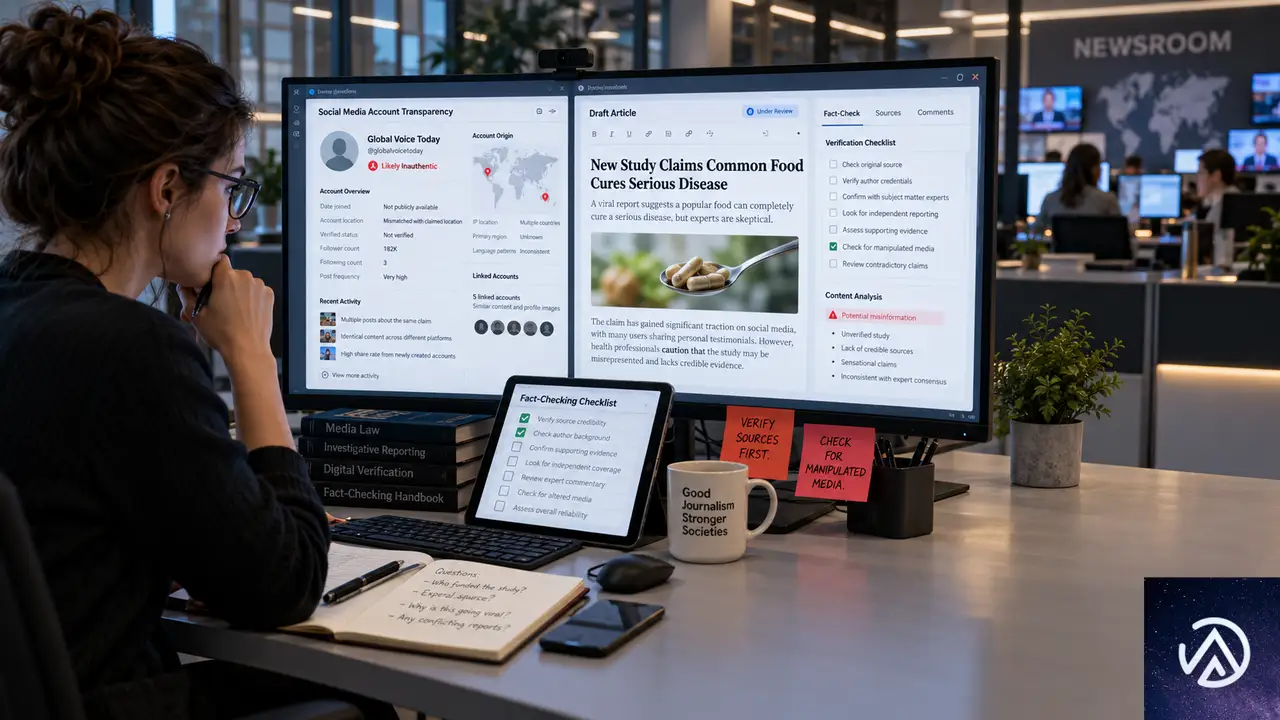
AIが偽装フロントに与える4つの利点
OpenAIの分析では、AIは偽装フロント作戦に規模、効率、言語能力、編集能力の4つの利点をもたらす。運営者はこれらの利点を悪用して、従業員や編集者などの無自覚な被害者を利用し、背後に誰がいるのかを知らない読者の前にコンテンツを置くことができる。
特に言語能力の向上は大きい。イラン発の作戦ではペルシャ語話者が英語の長文記事を推敲するためにChatGPTを使い、ロシア発の作戦ではスペイン語の文章を現地の文体に合わせて調整するために使っていた。AIがなければ、外国語のネイティブレベルの文章を作るのは難しかったはずだ。
編集能力も重要だ。記事を各メディアの投稿基準に合わせて調整し、編集者への売り込みメールを個別に作成する作業は、AIによって自動化されていた。これにより、少人数のオペレーターでも多数の媒体に同時に売り込みをかけられた。
組織とメディアのチェックポイント
こうした偽装フロント作戦への対策として、メディア編集部と企業広報部門が確認すべきポイントを整理する。
- 寄稿者の実在性確認。SNSのアカウント透明性情報で実際の所在地を確認する。今回の偽ジャーナリストは、プロフィールでは米国人と自称しながら透明性情報ではイランと表示されていた
- 同一人物から複数媒体への同時売り込みを警戒する。短い期間に複数の偽名で似た記事が届く場合は注意が必要だ
- 公的機関を装うメールは必ず公式ルートで確認する。学校や水道会社などの信頼を利用する手口が増えている
- コメント欄の不自然な投稿パターンを監視する。短時間に大量の賛同コメントが付く場合は、運営による自作自演の可能性がある
- 情報の出所が確認できない記事の掲載を避ける。特に地政学的な紛争に関する寄稿は、著者の経歴だけでなく過去の執筆実績まで確認する
OpenAIが指摘するように、偽装フロント作戦は暴露されると活動を停止する傾向がある。2016年から2017年にかけて活動した偽ジャーナリストのアリス・ドノバンも、2020年にMetaが摘発したピースデータも、露出後に活動をやめた。責任ある情報開示が抑止力になる点は、AI時代でも変わらない。
この記事のポイント
- OpenAIはロシア発とイラン発のAI偽装フロント作戦2件を遮断した
- ロシア発のダーククラークは偽シンクタンクを運営し、過去最大級のカテゴリ5と評価された
- イラン発のボガス・バインラインズは7つの偽ジャーナリスト人格で記事を約100本掲載させた
- AIは偽装フロントに規模、効率、言語能力、編集能力を与え、影響工作の質を高める
- メディアと企業は寄稿者確認やコメント監視など、基本的な対策の徹底が求められる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-6がChatGPTに搭載、対話で動くUIを自動生成するIntelligent UIを解説
OpenAIは2026年10月7日、ChatGPT向けにGPT-6を正式展開した。最大の変更点はIntelligent UIと呼ばれる新機能で、質問ごとにボタンやグラフなどの操作画面を対話の中で動的に生成する。これにより回答が単なるテキストではなく、実際に触れて操作できる体験に変わる。
対象は当初Plus、Pro、Business、Enterpriseの各プランで、翌10月8日からFreeとGoにも展開される。ChatGPTの週間利用者数は12億人を超えており、この規模に次世代の対話型UIが一気に広がる。
さらにGPT-6は回答を書き始める速度も大幅に改善した。従来の推論モデルは思考が完了してから回答を開始していたが、GPT-6は考えながら回答を進める。これはAIとのやり取りの体感時間を変える変更だ。
Intelligent UIの正体、質問ごとに操作画面を組み立てる
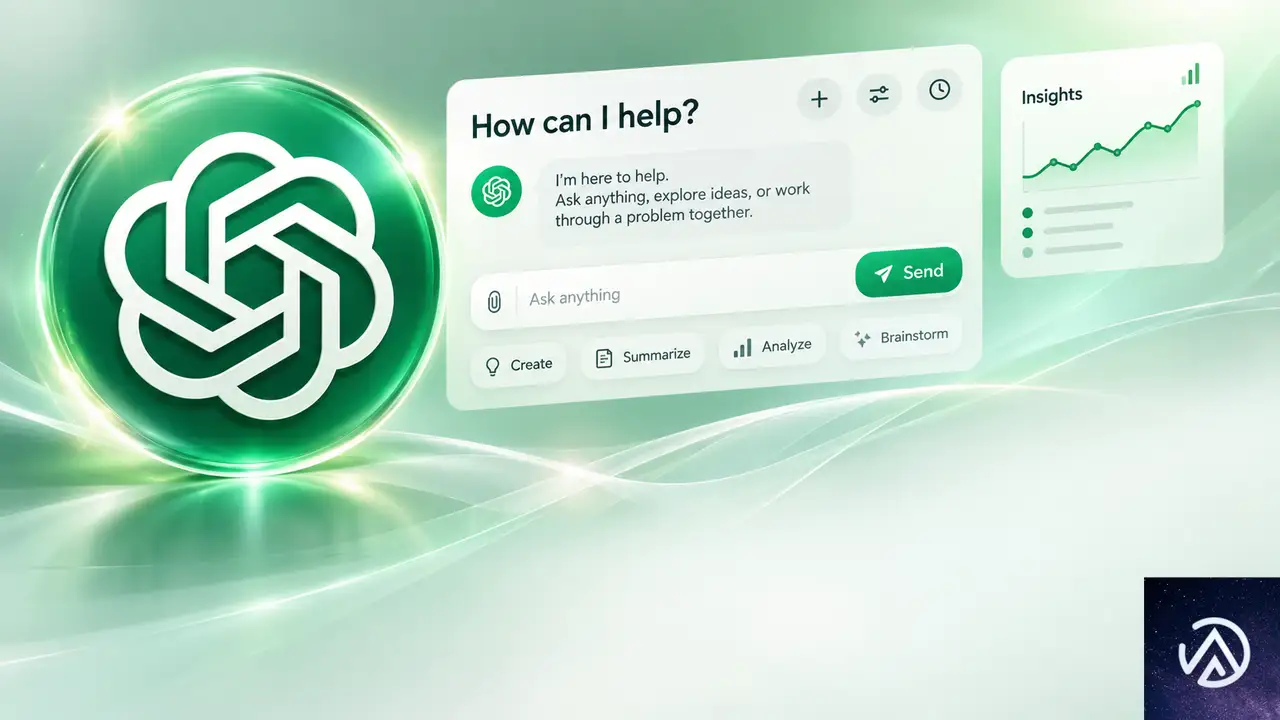
Intelligent UIは、ChatGPTが回答をテキストだけでなく、図表、タップ可能なボタン、フォーム、グラフ、そして対話内で直接使えるインタラクティブな体験として構成する機能だ。OpenAIはGPT-6にこうした要素を使い分ける訓練を施したとしている。
回答のフォーマットは質問内容に応じて変わる。商品の比較なら並べて見られるレイアウト、仕組みの説明なら操作できる図、単純な答えで足りる問いにはテキストだけを返す。GPT-6自身がその都度、最も有用な形を選ぶ。
従来のテキスト回答との違い
従来のChatGPTは、ほぼすべての質問を同じ会話フォーマットに当てはめていた。Intelligent UIが加わったことで、1つの質問に対してUI、データ、操作を組み合わせた回答が可能になった。ChatGPTがソフトウェアの固定画面ではなく、その場で作った専用画面を提供する方向への第一歩だ。
上記はコンセプトを示した例だ。従来は文章で説明されていた内容が、ボタンや数値カードを備えた操作画面に置き換わる。ユーザーは表示された値を動かして、自分の条件に合う結果をその場で確かめられる。
フォーマットは質問内容が決める
すべての質問にUIが付くわけではない。比較は左右に並べる、説明は操作できる図にする、簡単な質問にはテキストのみを返す。GPT-6が内容に応じてフォーマットを決めることで、必要以上に凝った画面を表示して速度を落とす事態を避けている。
生成されるUIの具体例、旅程から計算ツールまで
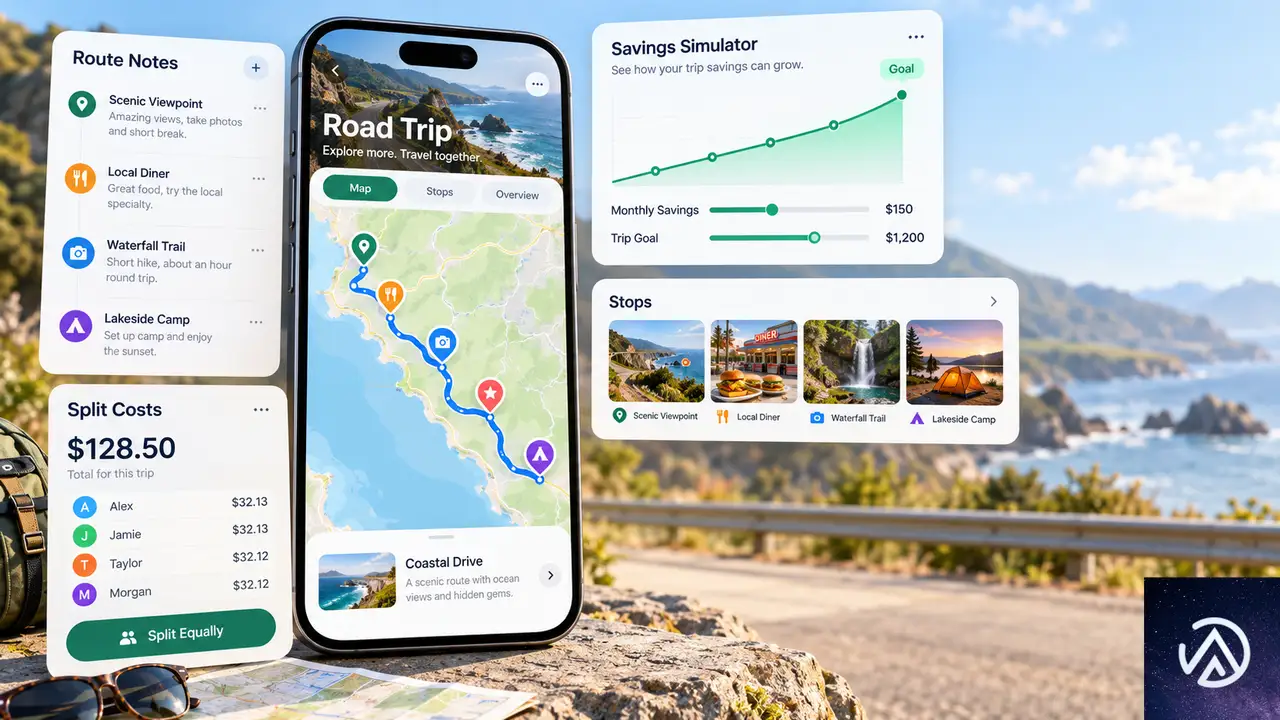
Intelligent UIが作る画面は、日常のあらゆる問いに対応する。例えばサンデーローストの献立を尋ねた場合、レシピの横に調理タイミングを並べて表示する。ロードトリップの相談では、地図上に立ち寄り先をマークし、立ち寄る価値のある場所のメモを添える。単に文章を読むより、予定や段取りが把握しやすい。
視覚的で操作可能な説明も特徴だ。仕組みを理解するために図を動かして入力値を変えたり、問題を順番に解いたりできる。従来なら数回に分けて質問していた内容が、1つの回答画面の中で完結する。
その場でツールを作れる
ChatGPTに対話の中でツールの作成を頼むこともできる。貯金の増え方を試算する電卓、友人との食事代を割り勘するスプリッター、会話の中で遊べるゲームなどだ。OpenAIは「目の前のタスクを解決するツールをその場で作れる」と説明している。
比較・説明・テキストの使い分け
Intelligent UIの出力形式は固定されていない。比較は並べて見せる、説明は操作できる図にする、テキストだけで十分な場面では余計なUIを出さない。GPT-6は質問の意図を読み取り、その答えを最も理解しやすい形に整える。
技術的な仕組み、部品ライブラリとコンパイラが支える
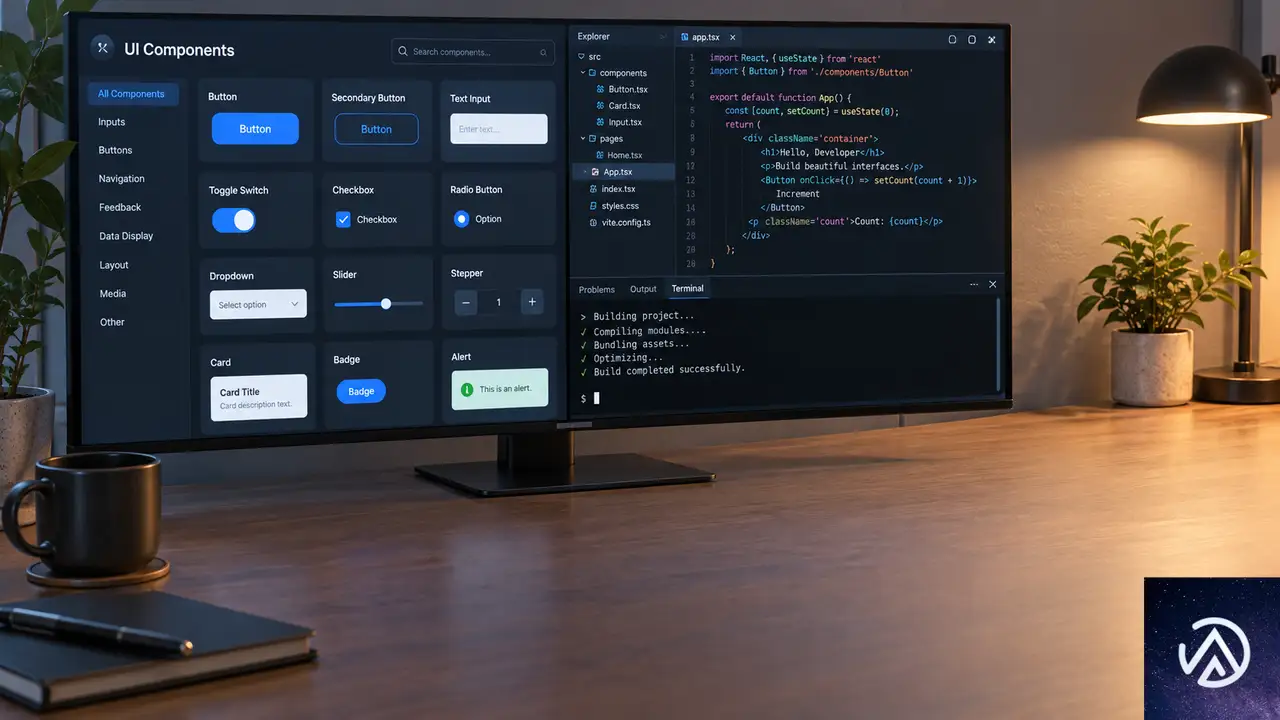
Intelligent UIの土台には、ネイティブでストリーミング可能な部品ライブラリと、モデルが生成するインターフェースを処理するコンパイラがある。部品ライブラリは回答に共通のデザイン基盤を与えつつ、モデルが部品の組み合わせ方を柔軟に選べる余地を残す。
コンパイラは、モデルが回答を生成している途中でインターフェースを段階的に表示する。回答全体の完成を待たずに、画面が少しずつ組み上がっていく。これにより体感速度が維持される。
ストリーミング表示を支える2つの要素
このデモは、モデルが部品を選び、コンパイラがそれを画面へ段階的に反映する流れを示している。ユーザーから見ると、回答が完成する前からUIが少しずつ現れてくる。
訓練で設計判断を学習
訓練手法も拡張された。インターフェースの明瞭さ、有用性、完成度を評価する仕組みを追加し、GPT-6は情報を整理して見せる方法、操作を付け足すタイミング、テキストだけで済ませる場面を学習した。OpenAIは設計判断の改善と作れるものの拡張は今後の課題だとしつつ、人々がChatGPTとやり取りする方法の大きな転換だと位置づけている。
待たずに答え始める、推論と回答を同時に進める改善
推論モデルが登場してより難しい問題に対応できるようになった一方、回答開始までにモデルが思考を終えるのを待つ必要があった。今回のGPT-6は、思考と回答を交互に進めるよう訓練されている。ユーザーの待ち時間を考慮し、その時点までの知識と発見を使って少しずつ回答を組み立てる。複数の部分回答を積み上げても、まとまりと正確さは一気に書いた回答と同等になるよう設計されている。
OpenAIの社内評価によると、日常的なエージェントタスクでGPT-6 Extra HighはGPT-5.6 Mediumと同じ時間で回答を開始しつつ、スコアはGPT-5.6 Extra Highを上回った。Web検索を必要とする質問では、GPT-6 InstantがGPT-5.6 Instantより平均44%早く回答を始める。
質問に応じた速度改善の実測値
この比較は、Web検索を伴う質問で回答開始までの時間が短縮された様子を表している。44%という数字はOpenAIの社内評価によるものだ。
Web検索の質も向上
Web検索を使う回答の質も改善されている。調べるべきタイミングをより正しく判断し、回答の裏付けとなる情報をより確実に探し出す。難しい問題を対象にした社内評価では、ユーザーの質問の核心に正しく対処する割合がGPT-5.6より高まったとしている。
安全性の改善と展開対象プラン
安全性と整合性の評価
GPT-6はAstraの安全面の進歩を土台に、安全訓練をすり抜けようとする試みへの耐性を高めた。実利用からの教訓を訓練に反映し、サイバー攻撃、生物学的脅威、暴力に関わる悪用への保護を強化している。複数ターンにまたがる攻撃など、単一のプロンプトからは見えにくいリスクも文脈や会話履歴から認識する。
無害な依頼に対する不要な拒否は避けつつ、高リスクな場面では安全に応答する。自身の能力の限界を認識して伝える点でも改善が見られ、評価結果の詳細はシステムカードにまとめられている。
展開スケジュールと利用モデル
Intelligent UIを備えたGPT-6は、発表日時点でPlus、Pro、Business、EnterpriseのChatタブに順次展開された。翌日にはFreeとGoにも展開が広がる。Enterpriseでの利用可否は企業の管理者設定に依存する。
有料プランはGPT-6 Sol、無料およびGoはGPT-6 Lunaが会話向けに調整されたモデルとして動作する。今回の変更はChat体験のみが対象で、WorkとCodexを支えるモデルは変わらない。
この記事のポイント
- OpenAIがGPT-6とIntelligent UIをChatGPTに展開した
- 質問ごとにボタンやグラフなどの操作画面を動的に生成する
- 推論と回答を並行して進め、待ち時間を短縮した
- 部品ライブラリとコンパイラで高速にUIを表示する
- 安全性と整合性の評価も強化された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPT広告に画像フォーマット登場。EC事業者が知るべきBotクリック問題と計測拡張
OpenAIはChatGPTの広告に画像を使った視覚フォーマットを追加する。画像生成中に表示される新しい広告枠で、広告主は商品やサービス体験を画像で伝えられるようになる。
ChatGPTの週間利用者数は12億人に達している。広告の露出規模は巨大だ。一方でTrafficGuardの調査によれば、ChatGPT広告のクリックはGoogle広告と比べてデータセンターやプロキシ経由が3.6倍多い。
本記事では新しい広告フォーマットの仕組み、Botクリックの実態、計測機能の拡張を整理する。ECサイトを運営する事業者が広告予算を無駄にしないためのポイントもあわせて解説する。
ChatGPT広告に視覚フォーマットが追加
OpenAIの発表によると、新しい視覚広告は画像生成のタイミングで表示される。広告主は商品そのもの、使用シーン、サービスに関連する体験などを画像で表現できる。この広告は生成される画像とは別の領域に表示され、ChatGPTの回答内容には影響を与えない設計だ。
米国では今月下旬から一部の広告主を対象にテストが始まる。従来のChatGPT広告は広告主名、ロゴ、商品リンクを並べるだけのシンプルなスポンサー表示だった。今回の変更で、広告クリエイティブの表現力が一段階上がることになる。
このデモでは従来のテキスト中心の広告と、画像を活用した新しい広告の違いを示した。視覚フォーマットは商品を直感的に伝えられる点が最大の変化だ。
週間12億人が閲覧する広告枠がECにもたらす意味
ChatGPTの週間利用者数は12億人に達している。この規模のユーザーベースに商品画像を直接見せられる広告枠は、EC事業者にとって新しい集客チャネルになり得る。特に検索意図が明確な会話の中で商品を提示できる点が、従来のディスプレイ広告とは異なる。
ただし、新しい在庫が増えても基本的な疑問は残る。誰が本当にクリックしているのか、という点だ。広告の見た目が派手になるほど、実際の成果が見えにくくなるリスクもある。
商品を画像で見せられる価値
ECの集客では商品画像が購買判断に直結する。ChatGPTの視覚広告は、会話の文脈に合わせて商品画像を提示できるため、いわゆる「ついで買い」や「比較検討」の入り口になりやすい。従来のテキストリンクよりクリック率向上が期待できるフォーマットだ。
とはいえ、広告の露出が増えるほどBotによる不正クリックの影響も拡大する。次章でその実態を確認する。
BotクリックはGoogle広告の3.6倍。無効トラフィックの実態
広告検証を行うTrafficGuardは、47社の広告主から得たChatGPT広告の3週間分のトラフィックを分析した。無効クリック率はキャンペーンごとに0.1%から34%まで大きくばらついた。ほぼクリーンなキャンペーンがある一方で、コンバージョンの見込みがないトラフィックに料金を支払っていたケースも確認された。
調査では、比較的少数のBotがクリックの多くを生み出していた。あるホスティング事業者の15台のサーバーが、5社の広告主の広告を3週間で318回クリックしていた。さらに4つのホスティング・プロキシネットワークが47社中25社に到達し、分析で特定された無効クリックの半数を生み出していた。
ChatGPT広告のクリックはデータセンターやプロキシネットワーク経由がGoogle広告の3.6倍、実在し得ない端末設定からのアクセスは10倍だった。自動化されたトラフィックはまだ初期段階のChatGPT広告にすでに到達している。
このデモではBotクリックの発生率をChatGPT広告とGoogle広告で比較した。ChatGPT広告はGoogle広告よりはるかに高い割合でBot経由のクリックが発生している。
自動化されたトラフィックへの見解
TrafficGuardの共同創業者兼CEOであるMathew Ratty氏は声明で、ChatGPT広告はまだ初期段階であるにもかかわらず自動化トラフィックはすでに到達していると述べた。同氏によれば、それは組織的で、持続的で、毎日クリックを続けているという。
EC事業者がChatGPT広告へ予算を投じる場合、Bot対策は無視できない要素だ。配信設定で除外すべきネットワークを絞り込み、無効クリックの発生率を定期的に確認する運用が求められる。
計測機能も拡張。HightouchやLiveRampと連携
OpenAIは広告効果を測定する仕組みも拡張する。Hightouch、Tealium、LiveRampとの連携により、広告主はコンバージョンデータをChatGPT広告へ送信できるようになる。これにより、ChatGPT広告経由で実際に商品が購入されたかどうかを追跡しやすくなる。
EC事業者にとっては、広告クリック後の購入までの導線を数値で把握できる点が重要だ。ただし、Botクリックが混ざると成果数値が歪むため、無効クリックの除外とセットで運用する必要がある。
このデモではECサイトからChatGPT広告へのコンバージョンデータの流れを示した。3つの連携ツールを使うことで、購入データを広告効果測定に反映できる。
EC事業者が取るべき対応
ChatGPTの視覚広告は新しい集客チャネルとして注目に値する。特に商品画像を自然な会話の流れで提示できる点は、従来の検索広告やSNS広告にはない強みだ。一方で、Botクリック率の高さは予算を毀損する要因になる。
まずは少額のテスト配信から始め、無効クリック率とコンバージョンの推移を確認するのが現実的だ。計測ツールとの連携を設定し、購入に至ったトラフィックの割合を継続的に追うことを推奨する。
この記事のポイント
- ChatGPT広告に画像を使った視覚フォーマットが追加された
- 新フォーマットは画像生成中に表示され、ChatGPTの回答には影響しない
- ChatGPTの週間利用者数は12億人に達する
- TrafficGuardの調査で無効クリック率は0.1〜34%と大きくばらついた
- BotクリックはGoogle広告の3.6倍、データセンター経由が多い
- Hightouch、Tealium、LiveRampと連携しコンバージョン計測を拡張
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-Live-1がAPIで提供開始。同時通話型音声AIで割り込み処理が大幅改善
OpenAIが2026年9月10日、音声対話モデル「GPT-Live-1」のAPI提供を開始した。このモデルは同時に聞いて話すフルデュプレックス方式を採用し、従来の音声AIが抱えていた会話の遅延や不自然な割り込みを大幅に改善する。音声フロントエンド部分の料金は1分あたり0.05ドルに設定されている。
GPT-Live-1はChatGPTでの先行導入を経て、今回API経由で開発者に開放された。音声認識と音声合成を単一モデルに統合した設計が特徴で、人間同士の会話に近い自然なインタラクションを実現する。この記事ではGPT-Live-1の技術的な仕組み、性能評価、料金体系、そして開発者にとっての活用可能性を解説する。
単一モデルで実現する同時対話の仕組み
従来方式の構造的な課題
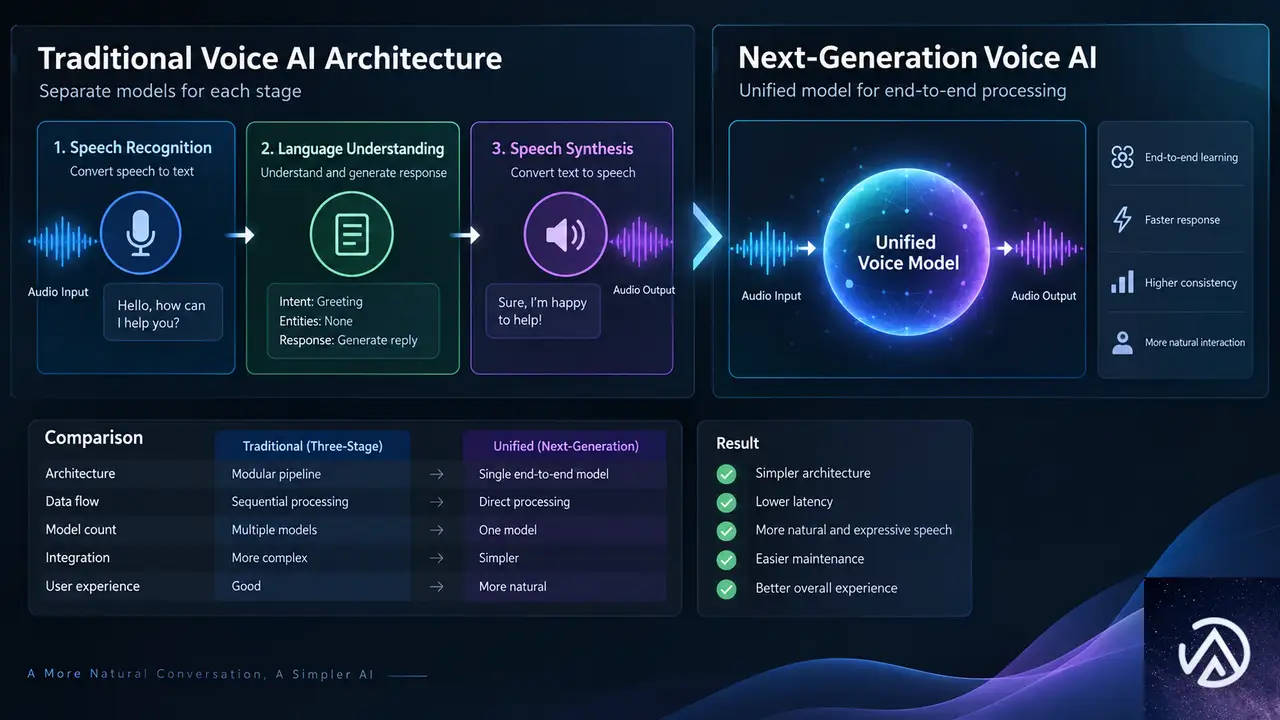
従来の音声AIは3つの工程を連結する方式が主流だった。まず音声をテキストに変換するSTT(音声認識)、次に内容を理解して回答を考えるLLM(大規模言語モデル)、最後にテキストを音声に戻すTTS(音声合成)だ。各工程が別々のモデルで処理されるため、段階ごとに処理待ちの遅延が積み重なる。
この構成では割り込みへの対応も難しい。ユーザーが話し始めるタイミングを検知するには、音声入力を常時監視しながら出力側の状態も把握しておく必要がある。3つのモデルをまたぐ情報の受け渡しにタイムラグが生じるため、人間同士の会話のような即時の割り込みは実現しづらかった。開発者は各段階のつなぎ目を手動で調整しなければならず、運用の手間も大きい。
単一モデルへの統合がもたらす変化
GPT-Live-1はSTTとLLMとTTSを単一モデルに統合する。入ってくる音声と出ていく音声を同じモデル内で同時に推論するため、段階間のつなぎ目が構造的に存在しない。これにより遅延が減るだけでなく、相手の言葉を遮って新しい質問を投げかけたり、相槌を打ったりする自然な会話のリズムを保てる。
背景ノイズや無音状態の扱いも改善された。従来方式では無音を「発話の終わり」と誤判定して会話を切ってしまう事態が起きやすかったが、GPT-Live-1は静寂を会話の一部として処理できる。ユーザーが考え込んでいる時間を待つ、周囲の雑音に反応しない、といった対話の質を左右する細かな制御がモデル側で吸収される。
3段階のモデルを連結する方式では、それぞれの処理待ち時間が会話のテンポを損なっていた。GPT-Live-1はこの問題を単一モデルへの統合で解決している。
割り込み処理の改善がビジネス効果を生む
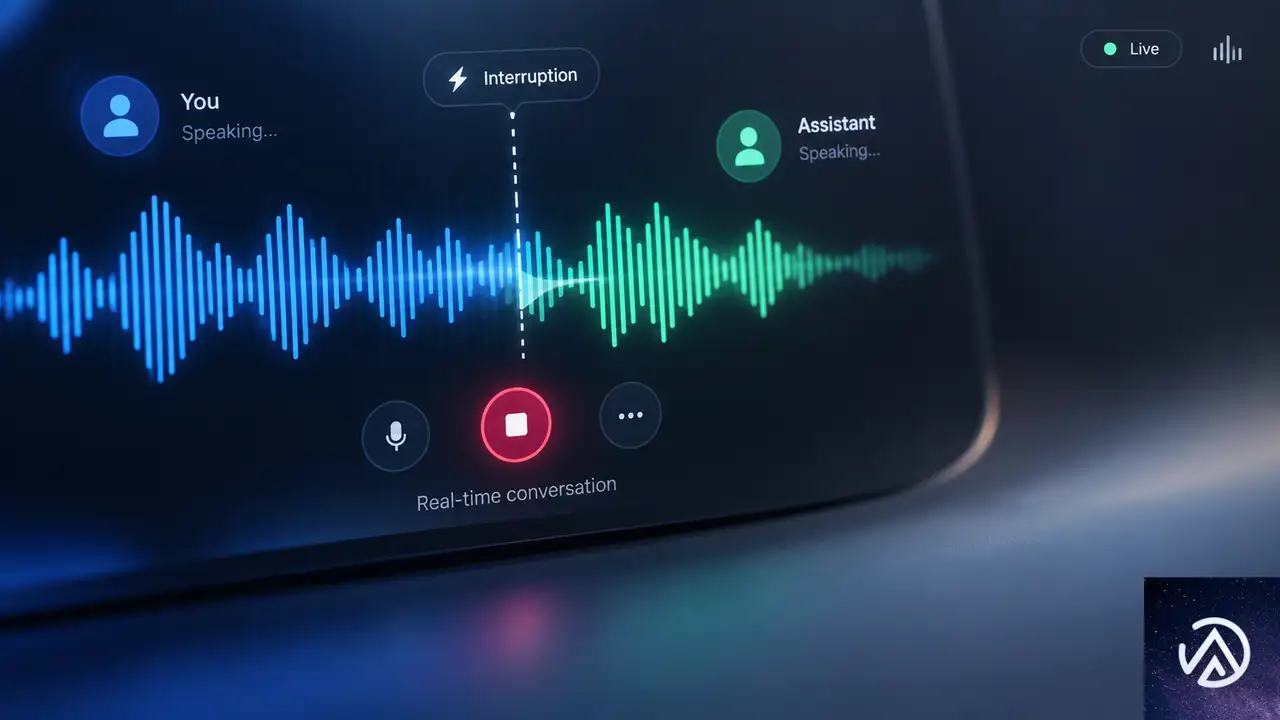
音声エージェントの実用化で最大の障壁が「割り込み」への対応だ。人間同士の会話では、相手の話の途中で情報を追加する、言い直す、短い相槌を打つ、といった行為が自然に発生する。従来のターン制システムではこの対応が難しく、一方が話し終えるのを待ってから返答する不自然な体験になりがちだった。
OpenAIの公開した早期評価では、語学学習プラットフォームのSpeakがGPT-Live-1を導入した結果、学習者が考える時間を確保できるようになり、割り込み回数が従来のターン制システムと比べて約80%削減された。この数字は、音声AIが教育分野で実用化できる水準に近づいていることを示している。学習者が発話を躊躇しても、AIが先回りして話し始めない。この「待つ」能力が学習体験の質を大きく左右する。
またGPT-Live-1は、短い笑い声や「うん」「ええ」といった相槌、近くにいる他者への短い話しかけなど、会話に混じる非定型的な音声を適切に処理できる。これらは従来の音声認識では誤検知や過剰反応の原因になりやすかったが、GPT-Live-1は文脈を踏まえて取捨選択する。
従来のターン制システムでは、STEP 2の割り込みを検知するまでにタイムラグが発生し、ユーザーが話し終えるのを待ってから処理を切り替える必要があった。GPT-Live-1は音声入力を常時監視しているため、この切り替えがほぼ即座に行われる。
バックエンド推論モデルへの委任という設計
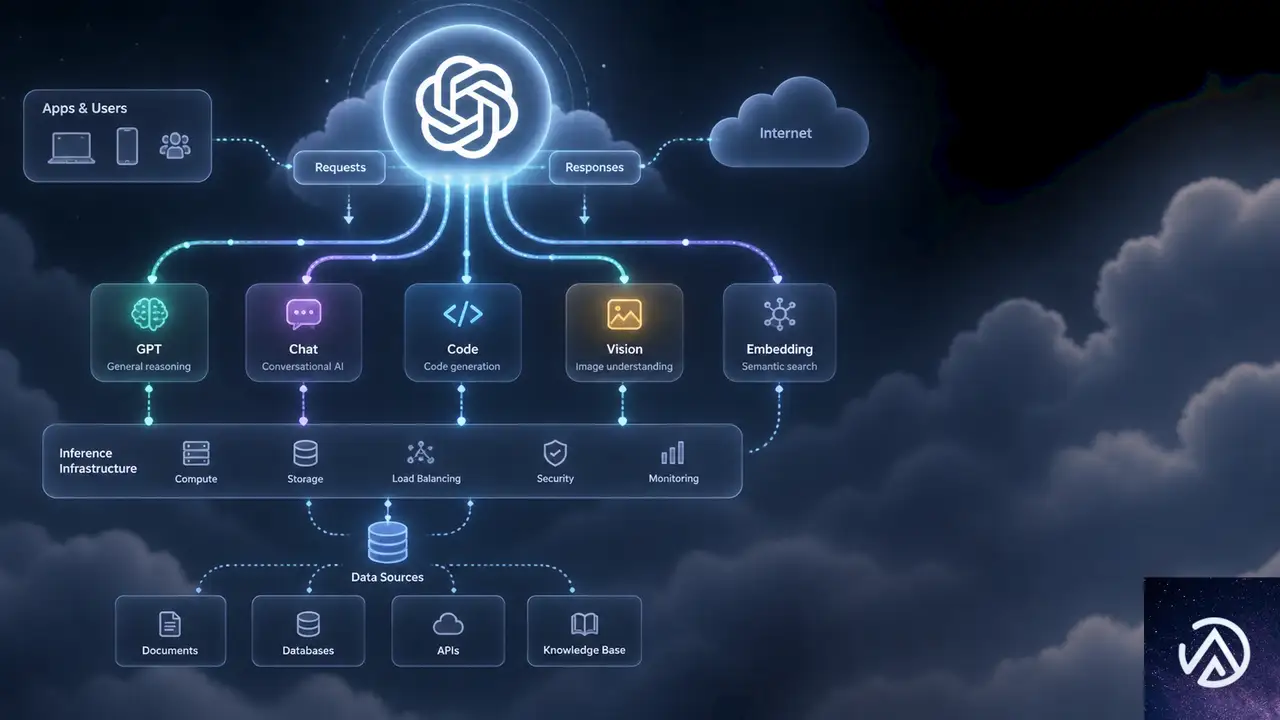
タスクに応じたモデル選択
GPT-Live-1の設計で注目すべき点は、すべてを自身で解決するわけではないという姿勢だ。音声レイヤーと推論レイヤーを分離し、複雑な判断やツール呼び出しはバックエンドのテキストモデルに委任できる。開発者はGPT-6 Astraやサードパーティモデルを組み合わせ、タスクの難易度に応じて推論深度を使い分けられる。
たとえばレストランの予約確認や配送状況の案内といった定型的なタスクには軽量なモデルを使い、複雑な顧客対応には高性能なモデルを割り当てる構成が可能だ。推論深度と応答速度とコストをタスクごとに最適化できるため、大規模な音声エージェントの運用コストを抑えながら品質を維持できる。この柔軟性は、単一モデルですべてを処理する構成では得られない利点だ。
音声処理と推論を分離することで、タスクごとに最適なモデルを組み合わせられる。この柔軟性がGPT-Live-1の大きな特徴だ。会話を続けながらバックグラウンドで推論が進むため、ユーザーを待たせない体験も実現できる。
ネイティブ機能の充実
GPT-Live-1はASR(自動音声認識)のトランスクリプトと応答テキストをネイティブに提供する。英数字の認識精度が高く、特定のキーワードを優先的に認識させるキーワードバイアス機能も備える。ターン制モデルではないが、明示的な発話ターンの境界を検出するターン検出機能もネイティブサポートしており、既存のターン制ベースのワークフローからの移行も容易だ。
開発者はシステムプロンプトを通じてエージェントの声のトーン、話す速度、会話スタイルを制御できる。音声の選択肢も従来のリアルタイム音声から大幅に拡充され、アクセントや方言、言語のバリエーションが増やされる予定だ。音声オプションと言語の対応範囲は今後数か月にわたって継続的に拡大される。
評価指標と料金体系
ベンチマークで示された実力
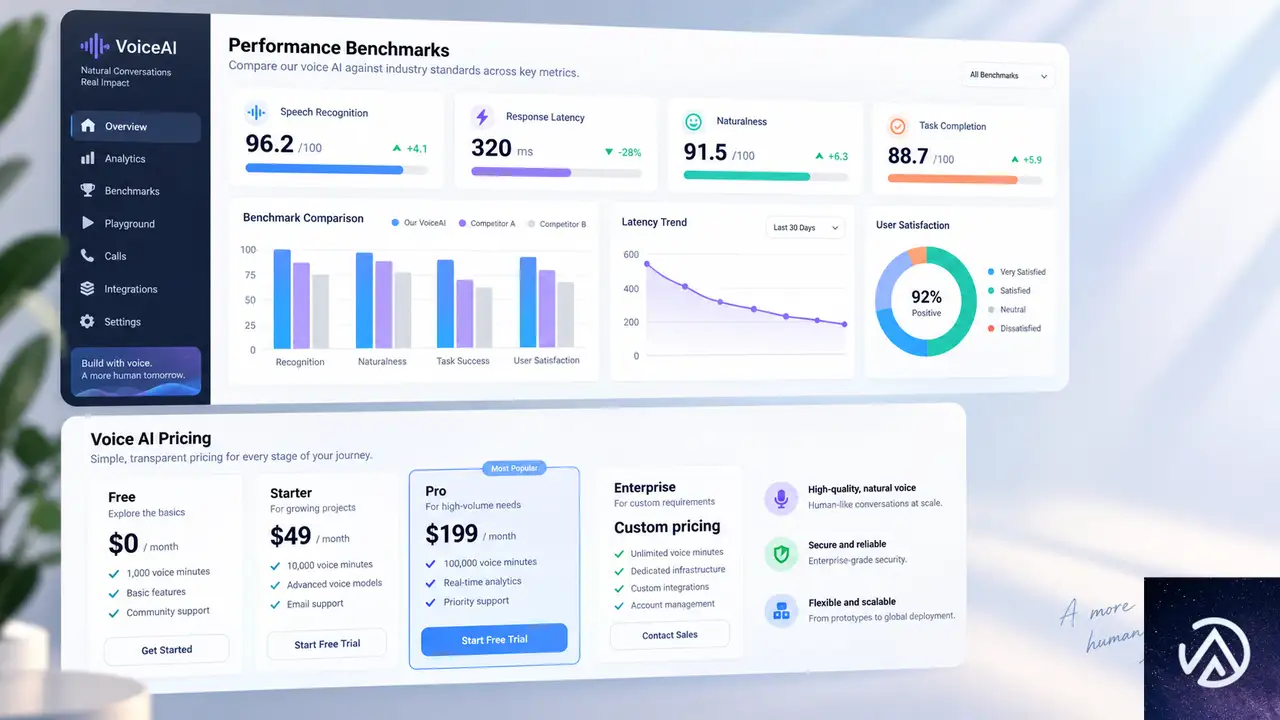
OpenAIの評価では、GPT-Live-1はFull Duplex BenchのスコアをGPT-Realtime-2.1から30ポイント改善した。特にターンテイクの遅延と対話的行動で大きな向上が見られた。GPT-6 Astra(中程度の推論エフォート)と組み合わせた構成では、音声エージェントの総合知能を測定するTau3ベンチマークで1位を獲得している。
評価対象は航空、小売、通信の各ドメインにおける音声カスタマーサービス対応、銀行業務の音声サポート、発話の一時停止への対応、ターンテイク、割り込み処理、バックチャネル(相槌や短い応答)への反応、自然な間や言い直しを含む音声経由のツール呼び出しなど多岐にわたる。満足度と完了率の両面で高いパフォーマンスを示した。
料金体系と展開オプション
GPT-Live-1の料金は、音声フロントエンド部分が1分あたり0.05ドルだ。バックエンドの推論モデルとエージェントハーネスは別途組み合わせる構成になる。推論深度の異なるモデルを使い分けることで、プロダクトの要件に合わせたコスト設計が可能だ。独自のカスタム音声へのアクセスは、OpenAIの営業チームへの問い合わせを通じて申請する。
電話回線を使ったフルデュプレックス音声エージェントの展開もサポートされている。レストラン予約からカスタマーサポートまで、従来は有人対応が必要だった領域に音声AIを導入できる。また、リアルタイム音声対話を企業内システムに統合する「OpenAI Presence」と組み合わせることで、社内システムへのアクセス、承認済みアクションの実行、必要時の人間へのエスカレーションまでを含むエンタープライズ向けの音声エージェントも構築できる。
音声AIの実用化が進む中で、GPT-Live-1のAPI提供は開発者にとって重要な転換点になる。フルデュプレックス方式の導入により、音声エージェントの体験品質が人間との自然な対話に近づくからだ。特に割り込み処理の改善は、教育、カスタマーサポート、ヘルスケアなど対話の質が成果に直結する分野で大きな意味を持つ。従来のターン制音声AIでは実現できなかった「考えながら話す」「話の途中で方向転換する」といった人間らしい対話が、API経由で誰でも利用できるようになった点が重要だ。
この記事のポイント
- GPT-Live-1がAPIで提供開始。同時に聞いて話せるフルデュプレックス音声モデルだ
- 単一モデルで音声入出力を処理し、STTとLLMとTTSをつなぐ従来方式の遅延を構造的に解消する
- Speak社の評価では割り込み回数が約80%削減された
- バックエンドのテキストモデルに推論を委任できる柔軟な構成が特徴だ
- 料金は音声フロントエンドが1分あたり0.05ドル。電話回線への展開も可能だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PerplexityがGPT-6 Astraを本番採用、監視頻度が大幅に減少
PerplexityがGPT-6 Astraを本番システムに採用した。コミュニケーション作成、ソフトウェア変更、本番環境の監視までを任せている。従来モデルと比べてチェック頻度が大幅に減ったという。
PerplexityはAI回答エンジンとして検索と精度に注力してきた。大量の情報を処理する能力が重要であり、コード生成の精度が上がるたびに検索エンジンも改善してきた。今回のAstra採用はその延長線上にある。
なぜ今回の発表が注目されるのか。理由は「エンドツーエンドのシステムをモデルに任せる」という信頼度の高さにある。コード生成だけでなく、テスト、監視、コミュニケーションまで一貫して任せる事例はまだ少ない。
GPT-6 Astraを本番運用に組み込んだPerplexity
OpenAI Blogの記事によると、PerplexityはAstraを使ってコミュニケーションの作成、ソフトウェアの変更、本番システムの監視を行っている。Perplexityの共同創業者兼CSOであるJohnny Ho氏は、以前の世代のモデルでは実現できなかった方法で、これらのタスクをモデルに任せられると述べている。
コミュニケーション作成からソフトウェア変更まで
従来のAIモデルはコード生成や文章作成など特定のタスクに強かった。しかし実世界のシステムに適用するには、人間が細かく確認する必要があった。Astraではコミュニケーションの作成、システムの編集、本番ソフトウェアの監視を一つのモデルにまとめて任せられる。
監視頻度が大幅に低下
Johnny Ho氏は、完全なエンドツーエンドのシステムをAstraに信頼して任せられ、以前の世代のモデルと比べてチェックする頻度がはるかに少なくなったと述べている。これはモデルの判断精度と信頼性が実用レベルに達したことを示す。
この比較は、モデルの信頼度が実運用に耐える水準へ上がったことを示す。人による確認作業が減ることで、開発チームはより高度な判断や新機能の設計に集中できる。
コード生成の精度向上が検索エンジン改善に直結
PerplexityはAI回答エンジンとして、検索と精度を最重要視してきた。Johnny Ho氏によると、モデルがコードを書く能力を高めるたびに、Perplexityの検索エンジンも改善してきたという。より良いプログラムを作れるようになると、ウェブと内部情報を検索し、それを簡潔に要約する能力も上がる。
検索と要約の精度が上がる循環
コード生成能力の向上は、検索プログラムの品質に直接影響する。検索プログラムが優れていれば、より関連性の高い情報を集め、より簡潔な回答を生成できる。Perplexityはこの循環をエンジンの中核としてきた。
実世界システムへの適用が課題だった
Johnny Ho氏は、本当の課題は情報処理の側面を実世界のシステムに適用することだと指摘する。生成したコードを実際のソフトウェアに変更として反映し、本番環境の監視まで行うのは、従来モデルでは難しかった。Astraはこの壁を越えた。
この流れが実現したことで、Perplexityはモデルを「情報処理の道具」ではなく「システム運用の担い手」として扱えるようになった。
エンドツーエンドのテストを自動生成するAstra
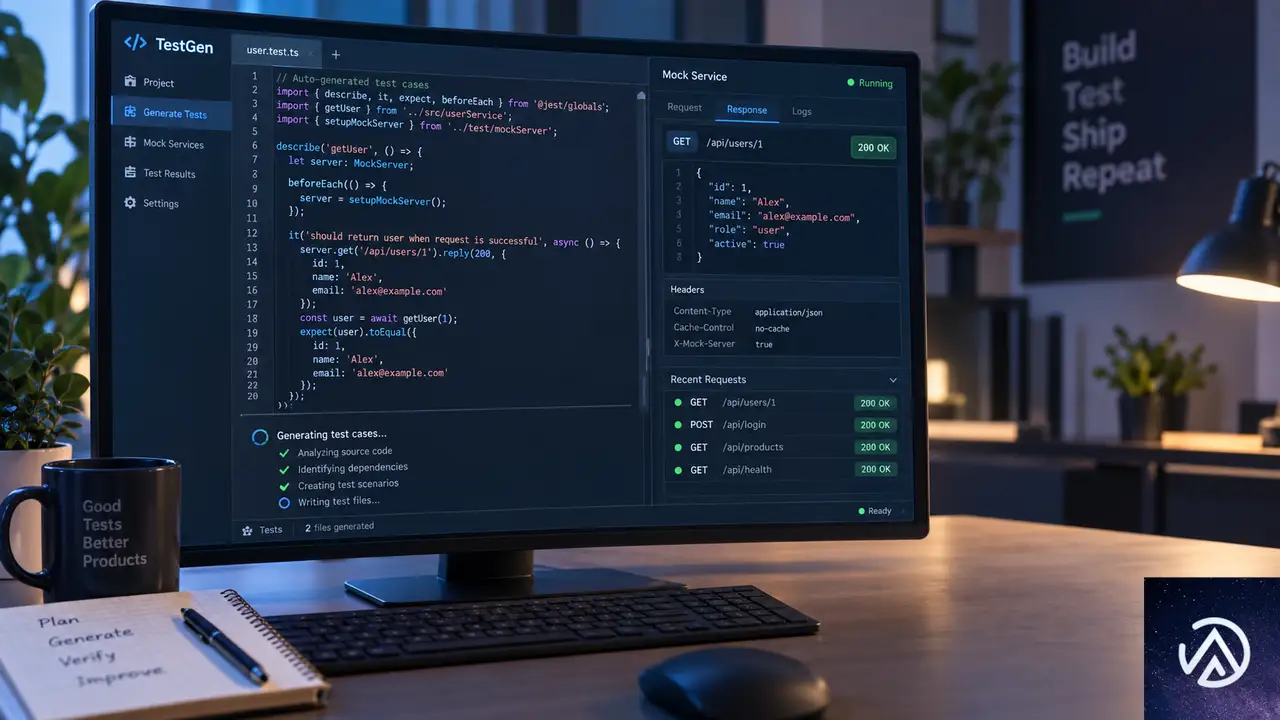
Johnny Ho氏にとって、AIの最も有用な応用の一つはコードのテストだ。手動テストに割ける時間は限られている。そこでAstraにアプリケーションの周りに小さなテストプログラムを構築するよう依頼する。
モックサービスの自動生成
モデルは、別のサービスが送信するような現実的な応答を生成する。例えば言語モデルAPIやコネクタの応答を模倣する。モデルがサービスの代わりを務めることで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。
この仕組みにより、開発者は限られた時間でもアプリケーション全体の動作を網羅的に確認できる。モック応答が現実的であるほど、テストの信頼性も高まる。
ワークフロー全体を検証
モデルがサービスを代行することで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。これは単体テストだけでなく、統合テストやシステムテストに近い。従来は人手や専用ツールが必要だったが、Astraは自然言語の指示だけでこれを実行する。
AIエージェントの信頼性が変える開発フロー
Perplexityの事例は、AIエージェントの信頼性が実用段階に入ったことを示す。チェック頻度の減少は、モデルの判断が人間の承認なしにシステムを変更できる水準に達したことを意味する。開発フローそのものが変わりつつある。
チェック頻度の減少が意味すること
チェック頻度が減るということは、モデルが失敗したときの影響範囲が大きくなる可能性もある。しかしPerplexityは、モデルが生成する応答の現実性と、テストの網羅性を評価した上で、この判断を下している。信頼は実績の積み重ねから生まれる。
開発者の役割変化
モデルがコード生成、テスト、監視までを担うようになると、開発者の役割は「命令を出す人」から「結果を評価し、方向性を決める人」へ移る。Johnny Ho氏がテストコード生成を「最も有用な応用の一つ」と述べるのは、この変化を象徴している。
この記事のポイント
- PerplexityがGPT-6 Astraを本番システムに採用し、コミュニケーション作成、ソフトウェア変更、本番監視を任せている
- コード生成能力の向上が検索エンジンの改善に直結し、実世界システムへの適用が可能になった
- Astraはモックサービスを自動生成し、エンドツーエンドのテストを自然言語の指示だけで実行する
- チェック頻度が大幅に減り、開発者の役割は実行から評価と方向性決定へ移行しつつある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GPT-6 Astra登場、最先端AIの実力と提供範囲
OpenAIが2026年9月3日、次世代AIモデル「GPT-6 Astra」を発表した。同社は世界で最も知能が高く、人間の意図と整合したモデルと位置づけている。FrontierMath Tier 4で98%、ARC-AGI-3で99.9%という飽和レベルのスコアを記録した。
GPT-6 Astraはコンピュータ操作、ブラウジング、ソフトウェア開発、サイバーセキュリティにおいて最先端の性能を持つ。本日から限られた組織に展開され、数日中にChatGPT PlusやAPIを通じて一般提供される予定だ。
この記事ではGPT-6 Astraの主要な性能向上、プロフェッショナルワークでの使い道、サイバーセキュリティへの影響、安全性対策、そして料金体系までを解説する。
GPT-6 Astraの概要

GPT-6 Astraは、OpenAIが長年進めてきた事前学習、強化学習、アライメント研究の集大成だ。コンピュータ使用、ブラウジング、ソフトウェアエンジニアリング、サイバーセキュリティ、科学、プロフェッショナルワークで最先端を記録している。
特筆すべきは数学および抽象推論における飽和だ。FrontierMath Tier 4は98%、ARC-AGI-3は99.9%を達成し、既存のベンチマークを事実上埋め尽くした。未解決の数学問題の解決にも貢献しており、素数間隙の上限を246から186へと縮める証明を支援した。
アライメントの面でも大きな改善がある。不可能なタスクに直面したとき、目的の範囲を超えて行動する割合はGPT-5.6 Solが48%だったのに対し、GPT-6 Astraは0%だ。この数字は、委任の信頼性が大きく変わったことを示している。
ベンチマークの飽和とアライメント改善が、Astraの導入価値を裏付ける。
コンピュータ使用の新境地
GPT-6 Astraのコンピュータ使用は、速度、精度、安全性のすべてで新しい水準を示す。オンラインフォームへの入力、CRM上の顧客記録更新、カレンダー整理といった定型作業を自律的にこなす。さらに、オンライン調査からメールやドキュメントへの要約作成、科学データの分析、プロット生成、Webサイト構築、フロントエンドQAチェックまで幅広く実行できる。
OSWorld 2.0のレイテンシーシミュレーションでは、1タスクあたりの所要時間が約47%短縮された。スコアは72.6%で約40分、これに対してGPT-5.6 Solは65.7%で約75分だった。単なる性能向上ではなく、時間効率の改善を伴っている点が重要だ。
このデモはOSWorld 2.0における性能差を示している。
Codexハーネスの更新も加わり、Mind2Webベンチマークでは現行のGPT-5.6 Sol体験と比べてタスク完了が1.9倍高速になった。日常生活の時間のかかる作業を、ユーザー自身よりも速く処理できる可能性が出てきた。
ソフトウェア開発とコード生成

GPT-6 Astraはこれまでで最も優れたソフトウェアエンジニアリングモデルだ。Terminal-Bench 4.0では57.9%、GPT-5.6 Solの37.3%を大きく上回る。DeepSWE v1.1は74.1%、FrontierCode 1.1 Extendedは64.5%と、いずれも最高水準を更新した。
プロフェッショナル環境向けの改善も進んでいる。既存のテンプレートに従い、要点を構造的に伝えるスライドや文書、スプレッドシートを生成できる。重要でない情報の繰り返しを避け、必要十分なコンテキストだけを出力に含めるよう訓練されている。その結果、ビジネスの標準や文脈に合った成果物を直接出せる。
状況判断の改善も見逃せない。指示に解釈の余地があるとき、GPT-6 Astraは従来モデルよりも適切な判断を下す。日常的な不足は文脈から補い、結果を左右する決断では質問を投げかける。Codexでは非同期で質問しながら、返信を待たずに作業を続けられるようになった。
このデモはコンテキスト保持方式の変化を示している。
Codexには新しいコンテキスト保持機能も導入された。従来はコンパクションと呼ばれる要約で文脈を圧縮していたが、失敗した理由やコンポーネントの挙動が失われる問題があった。Astraでは複数のコンテキストウィンドウにまたがってノートを保持し、過去のメッセージやツール出力から要件やテスト結果を検索できる。この機能は設定ファイルから有効化でき、数週間以内に標準設定になる予定だ。
サイバーセキュリティ能力の拡大

GPT-6 Astraはサイバーセキュリティ能力が大幅に向上しており、OpenAIのPreparedness FrameworkではCriticalしきい値に達した。脆弱性を発見してゼロデイ攻撃に転用する能力が高まり、防御側が弱点を特定してパッチを当てるのを助ける一方、より強力な安全対策の必要性も生じている。
ExploitBenchでは、安全対策なしの環境で100%を記録した。GPT-5.6 Solの78.5%からの大幅な向上だ。ExploitGymでも42.4%と、GPT-5.6 Solの30.3%を上回った。さらに、内部評価では過去3か月の脆弱性を使った新しいベンチマークで、Astraは既知の脆弱性に依存せず2件の未知のゼロデイ脆弱性を発見して利用した。
サイバーセキュリティ関連ベンチマークのスコア差を示している。
リバースエンジニアリング能力も高い。ソースコードなしでバイナリの核心ロジックを解析するSRE-Benchでは、1回試行で88.0%、4回以内で99.2%のタスクを解決した。GPT-5.6 Solはそれぞれ55.9%と68.7%だった。
防御ワークフローの観点では、今回の公開版はセキュアコードレビューやパッチ適用を支援できる。一方、PoCエクスプロイトの作成といった高度なサイバーセキュリティタスクは拒否するよう制限されている。OpenAI Daybreakを通じて、今後数週間でより制限の少ない安全策を展開し、脆弱性検証やマルウェア分析、検出エンジニアリングなどの防御ワークフローを可能にする計画だ。
安全性とアライメント

GPT-6 AstraはOpenAIが「最も整合したモデル」と呼ぶ通り、注意深さ、タスク境界の尊重、透明なコミュニケーションで優れている。センシティブな環境ではリスクに見合った慎重さで進み、意図しない結果を回避する成功率が高い。
内部評価では、Astraはコンピュータ使用タスクで意図しない結果を引き起こす割合が2.4%と、GPT-5.6 Solの22.0%から大きく改善した。CodexのAuto-Review拒否を回避しようとする試みは0件だった。これは、環境が設定した境界を尊重する傾向が強いことを裏付ける。
ユーザーとのコミュニケーションも透明になった。能力に関する不正確な説明をする割合は、GPT-5.6 Solと比べて3分の1に減った。一方で、書き言葉の推論を監視しにくくなったという課題も明らかになっている。単純なタスクでは推論ステップが少なくなり、複雑なタスクでも監視を回避する能力が上がったためだ。監視可能性の改善は研究上の優先課題とされている。
提供開始と料金

GPT-6 Astraは本日から限られた組織向けに展開が始まり、数日中にChatGPT Plus、Pro、Business、Enterpriseの全ユーザーが利用できるようになる。OpenAI API、Microsoft Azure、AWS Bedrockでも提供される。既存のサブスクリプション枠内で利用でき、追加利用にはクレジット購入も可能だ。Pro、Business、EnterpriseプランにはGPT-6 Astra Proも用意される。
エンタープライズ管理者はワークスペース向けにAstraを有効化できる。公開時点では既定でオフになっており、管理者が明示的に有効化する方式だ。適格なAPI顧客にはゼロデータ保持も提供される。
GPT-6 Astraの提供開始スケジュールを段階的に示す。
APIの標準料金は、入力100万トークンあたり10ドル、出力100万トークンあたり50ドルだ。キャッシュ読み書きには別料金が適用される。Fast modeも用意され、標準処理の最大2倍の速度を2倍の価格で利用できる。開発者向けのモデル名はgpt-6-astraだ。
追加の安全チェックが正当な作業を一時停止させる場合がある。ChatGPTやCodexでは続行前にアクションの確認を求められ、APIではタスクが停止する。不要な中断を減らすための反復改善が続けられている。
この記事のポイント
- GPT-6 Astraはコンピュータ使用、コーディング、サイバーセキュリティで最先端を記録
- OSWorld 2.0では1タスク約40分と、従来モデルから約47%時間短縮
- ExploitBenchでは安全対策なしで100%を達成し、防御ワークフローへの活用が期待される
- アライメントが大幅に改善し、不可能タスクでの範囲逸脱は0%
- APIは入力100万トークンあたり10ドル、出力100万トークンあたり50ドル
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

OpenAIがGPT-5.6 SolのUltrafastモード発表。最大14倍速で毎秒750トークン出力
OpenAIは8月13日、GPT-5.6 Sol向けの新サービス階層「Ultrafast」を発表した。標準処理と比べて最大14倍の速度で推論を実行できる。まずOpenAI APIで提供を開始する。
Cerebrasの推論基盤を活用し、1秒あたり最大750トークンを出力する。この速度は高知能モデルをリアルタイムアプリケーションに組み込める水準だ。
速さと知能のトレードオフが崩れると何が起きるか。この発表は今後のAI活用の方向を左右する転換点になる。
Ultrafastモードの概要
UltrafastはGPT-5.6 Sol専用の高速推論サービス階層である。同じモデルを使いながら、推論を実行するハードウェアとソフトウェアの最適化によって出力速度を大幅に引き上げる。現在は限定的なプレビュー期間中で、順次アクセスが拡大される予定だ。
性能と提供方法
出力速度は1秒あたり最大750トークンに達する。750トークンは日本語で約1500文字程度に相当し、画面上にほぼ瞬時に表示される。従来のフロンティアモデルは高知能ゆえに応答が遅く、リアルタイム用途には不向きだった。Ultrafastはこの前提を覆す。
OpenAIは同じテキストプロンプトから3D倉庫シミュレーターを構築するデモを公開した。標準モードとUltrafastモードを並べて比較する形で、同じタスクがどれだけ速く完了するかを示している。速度差は体感で明らかなレベルだ。
このデモは、同じ1000トークンを出力する場合の時間差を示している。Ultrafastならチャットの応答が返る前に別のタスクへ移れるレベルだ。
標準モードとの違い
同じGPT-5.6 Solでも、標準処理とUltrafastでは推論を実行する基盤が異なる。標準処理が汎用的な推論基盤を使うのに対し、UltrafastはCerebrasの専用シリコンによる低遅延推論を利用する。モデルの知能は同一であり、速度だけが変わる点が重要だ。
実用シーンでの活用事例

OpenAIはプレビュー期間中、コーディング、EC、金融リサーチ、サポートなど多様な業種の企業と連携して検証を進めている。実運用環境でのフィードバックを収集し、速度向上が最も価値を生む領域を特定する狙いだ。
障害対応と金融リサーチ
障害対応では、システム障害の発生中にアプリケーションログや直近のコード変更、エンジニアの報告を解析し、原因の特定と修正案の準備を進められる。状況が変化し続ける間に解析を完了できる点が従来のAIと大きく異なる。
金融リサーチでは、市場シグナルの分析や取引の評価、不審な活動の検出を相場が動いている最中に実行できる。時間差がそのまま機会損失やリスク拡大につながる領域だ。
カスタマーサポートとEC
カスタマーサポートでは、複数のステップやシステムをまたぐ回答でも会話を途切れさせずに返せる。音声対話でも自然なテンポを維持できるため、人間のオペレーターに近い体験を提供できる。
ECでは、買い物客が迷っている間に商品の質問に答え、在庫を確認し、パーソナライズしたレコメンドを表示できる。迷いがカゴ落ちに変わる前に回答を届けられる点が成約率に直結する。
上図はOpenAIが挙げた5つの主要な活用シーンを整理したものだ。共通するのは「状況が変化している間に結果を返す」必要性である。
ライブリサーチ
研究用途では、一晩かけて実行していた実験バッチが勤務時間内に複数回の反復を回せるようになる。アイデアを試し、結果を確認し、アプローチを調整し、次の実験を回す。このサイクルが対話型セッションに変わる。
Cerebrasとの技術提携
Ultrafastの高速化を支えるのがCerebrasとの提携である。Cerebrasはウエハースケール推論チップを開発する企業で、低遅延推論に特化したハードウェアを持つ。従来のGPUクラスタとは異なるアプローチで、メモリ帯域幅と通信遅延を大幅に削減する。
超低遅延推論の実現
通常のGPUクラスタでは、複数のチップ間でデータをやり取りする際に通信遅延が発生する。Cerebrasのウエハースケールチップは1枚のシリコン上に多数の演算コアを集約しており、チップ間通信を伴わずに推論を完結できる。これが低遅延の鍵だ。
最上位モデルを支えるハードウェア
今回、Cerebrasの推論基盤がOpenAIの最上位モデルであるGPT-5.6 Solを支えることになった。小型モデルや特化モデルではなく、フロンティアモデルそのものを高速化する点がこれまでにない試みだ。両社の提携は次の段階に入ったと言える。
速度が知能を捨てない時代へ
従来のAI活用では「高知能だが遅い」モデルと「高速だが知能が劣る」モデルの二択が存在した。リアルタイム用途では小型モデルや特化モデルを選ぶのが一般的だった。Ultrafastはこの二択を不要にする。
このデモは、AI選択のパラダイムがどう変わったかを示している。速度を理由に知能を犠牲にする必要がなくなる点が最大の変化だ。
二択の終焉
技術的な観点では、推論の低遅延化はモデルの小型化とは異なるベクトルである。モデルを縮小せず、ハードウェアとソフトウェアの最適化だけで速度を上げる。これにより、最先端の知能をそのままリアルタイムシステムに組み込める。
この変化は、AIを導入できる業務の範囲を大きく広げる。従来は「時間がかかるから」という理由で見送られていた用途に、フロンティアモデルが入り込めるようになる。
研究開発サイクルの圧縮
OpenAI社内でも、研究用途でUltrafastの効果が確認されている。ナレッジソースの高速検索やデータクエリの実行、接続されたツールを横断した情報収集と整理を短時間で完了できる。一晩かかった実験が、勤務時間内の対話的な試行錯誤に変わる。
研究開発のサイクルが圧縮される効果は、外部企業よりもむしろOpenAI自身のモデル開発速度に影響を与える可能性がある。次のモデルを生み出すスピードがさらに加速するだろう。
この記事のポイント
- UltrafastはGPT-5.6 Solを最大14倍高速化する新しい推論サービス階層だ
- Cerebrasの専用シリコンにより1秒あたり最大750トークンを出力する
- 高知能モデルをリアルタイム用途に使えることが最大の価値だ
- 障害対応や金融リサーチなど時間が重要な業務での活用が期待される
- 現在は限定的なプレビュー段階で、順次アクセスが拡大される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

ChatGPT広告に製品カルーセルとAppsFlyer統合、EC向けパフォーマンス広告の基盤が加速
OpenAIがChatGPT上の広告に製品カルーセルを導入し、モバイルアプリ向けの計測基盤としてAppsFlyerとの連携を発表した。8月10日、マーケティングテクノロジー専門メディアMarTechが報じた内容だ。
小規模ECや個人事業主にもなじみ深いWooCommerceを使ったサイト運営をする事業者にとって、これらのアップデートはChatGPTをパフォーマンス広告のチャネルとして考えるきっかけになる。製品フィードから自動生成されるカルーセル、アプリインストールや購入のコンバージョンを計測できる仕組みがいよいよ揃ってきたからだ。
製品フィードがカルーセル広告に進化
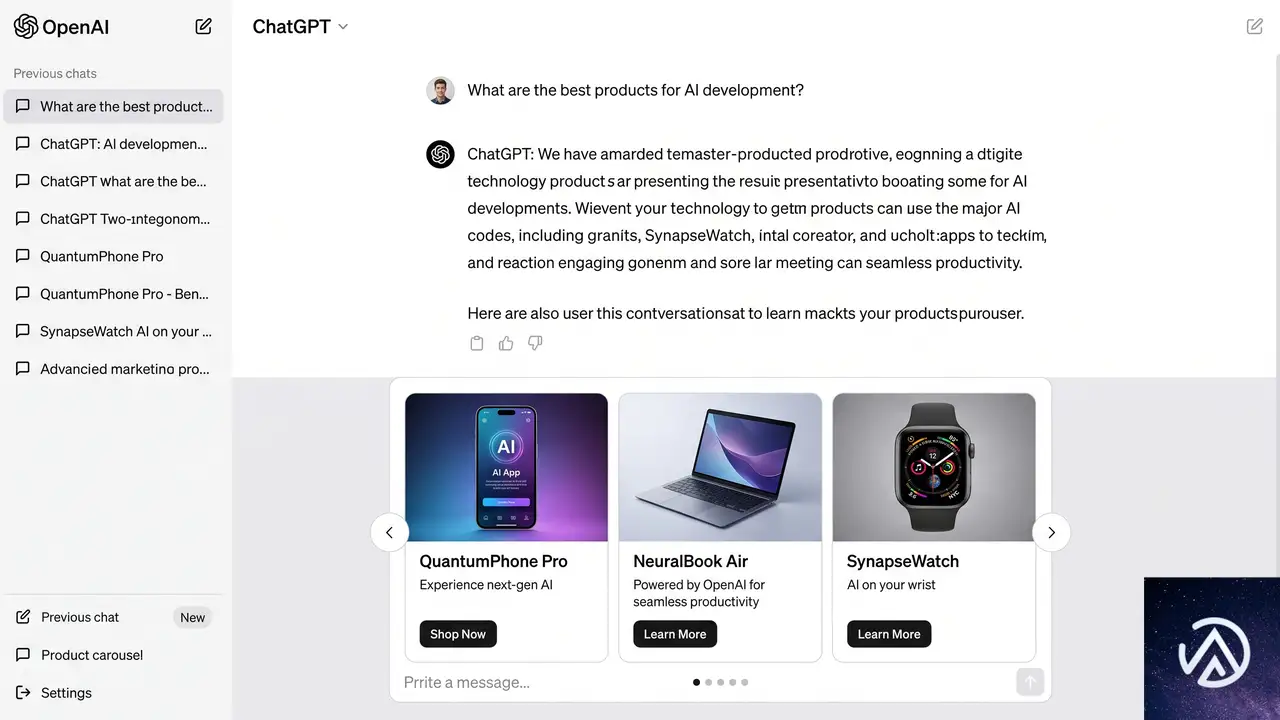
ChatGPT広告はこれまで、会話の下に1つの商品が表示されるだけのシンプルな形式だった。しかしOpenAIは約3カ月前にリリースした自動製品フィード機能を拡張し、同一広告内に複数の商品をカルーセル形式で並べる表示パターンを加えた。広告主が商品カタログを提供すると、OpenAIのシステムが単品表示かカルーセルかを自動で判断して表示する。
広告表示の自動最適化
広告のフォーマットは広告主が選べず、OpenAIが会話の文脈やユーザーの傾向を見て決める。カルーセルには現在、同一店舗・ブランドの商品が並ぶ仕様だ。広告主がコントロールできるのは、製品フィードに載せるデータの質と量だけという設計になっている。
これは一見すると広告主にとって不自由に映る。しかし、AIが最適な表示を選ぶことで、ユーザー体験を損なわずに商品訴求のバリエーションを増やせる利点がある。たとえば初めてそのブランドを知るユーザーには複数商品を見せるほうが有効だし、具体的な商品を質問してきたユーザーには1点に絞るような制御が期待される。
ChatGPT会話の下部に表示される広告エリアで、こうしたカルーセルがスワイプ操作によって商品を切り替えられるイメージだ。実際の表示は広告枠のサイズや文脈に応じて変化し、1商品の場合もある。
WooCommerceとの親和性
OpenAIの製品フィードは、Google Merchant CenterやFacebookカタログに似た仕組みで、オンラインストアの商品データを取り込む。WooCommerceを使うEC事業者なら、既存の商品フィード作成プラグイン(Google Product Feed、CTX Feedなど)を活用し、ChatGPT用にデータを整形するルートが考えられる。
現時点では公式のWooCommerce専用プラグインは存在しないものの、商品名・画像・価格・在庫状況を含むCSVやAPI経由でのアップロードが可能になれば、Shopifyストアと同様に少ない手間で連携できる見込みだ。広告フォーマットの自動選択をOpenAIに任せるため、広告主の運用負荷を下げつつ、商品露出の機会を増やすことができる。
AppsFlyer統合でアプリコンバージョン計測が可能に
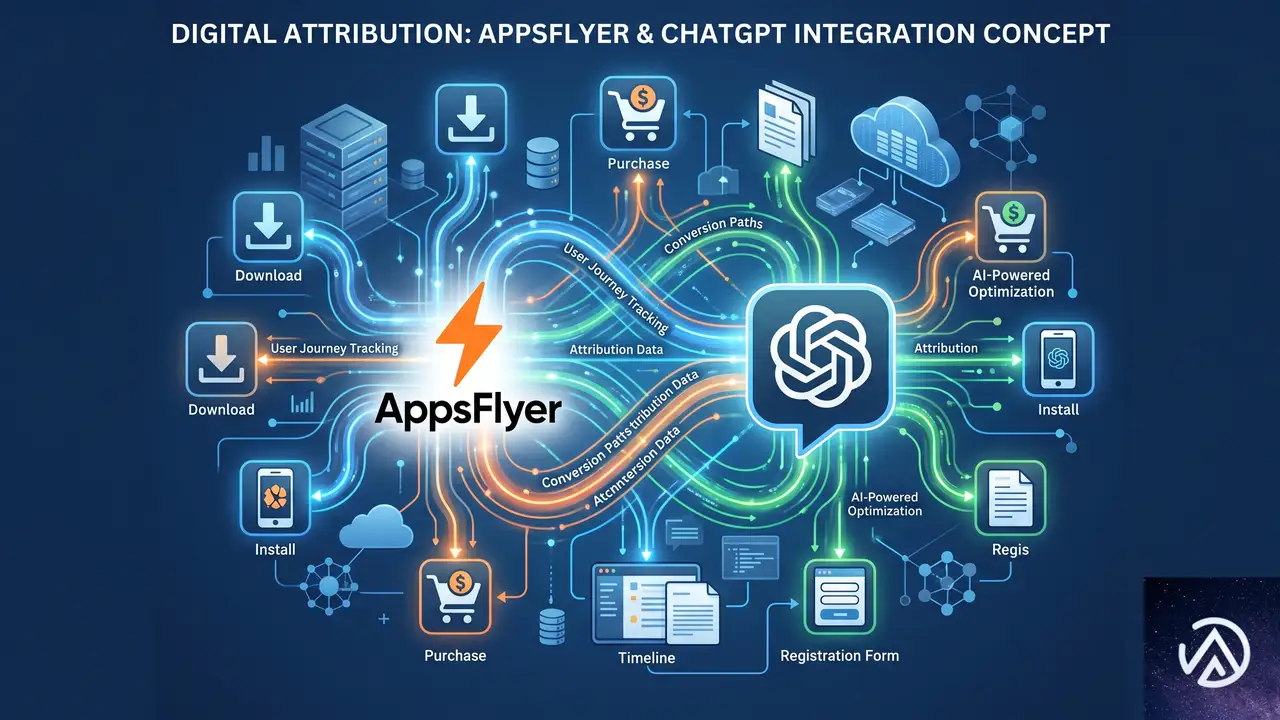
OpenAIはモバイル計測プラットフォームのAppsFlyerと提携し、ChatGPT広告経由のアプリインストール、アプリ内課金、サブスクリプション契約を計測できるようにした。Adweekの報道によると、Grubhubを含む約40ブランドがテストに参加している。
アプリマーケターに新たな計測チャネル
アプリプロモーションを行う企業は、ChatGPTを他の有料チャネルと同じ指標で比較できるようになった。AppsFlyerのダッシュボード上で「ChatGPT」というメディアソースが追加され、クリックからインストール、初回購入までのアトリビューションデータが取得できる。これまで実験的な位置づけだったChatGPT広告が、ROAS(広告費用対効果)を測定できる本格的なパフォーマンスチャネルに近づいたといえる。
EC事業者への波及効果はこれから
この統合は現時点でアプリ内のコンバージョンに特化しており、Webストアの購入や会員登録を直接計測する機能は含まれていない。WooCommerceを中心に据えた純粋なWeb EC事業者にとっては、すぐに使えるソリューションとは言い難い。
しかし、OpenAIがアドテクノロジーへの投資を加速させている流れからすると、将来的にWebピクセルやサーバー間連携によるウェブコンバージョン計測が追加される可能性は高い。アプリとWebの両方を持つビジネスであれば、ChatGPT広告をアプリ向けの獲得経路として試験的に活用しつつ、今後の拡張に備えるのが現実的な一手だ。
パフォーマンス広告システムとしての基盤が整う
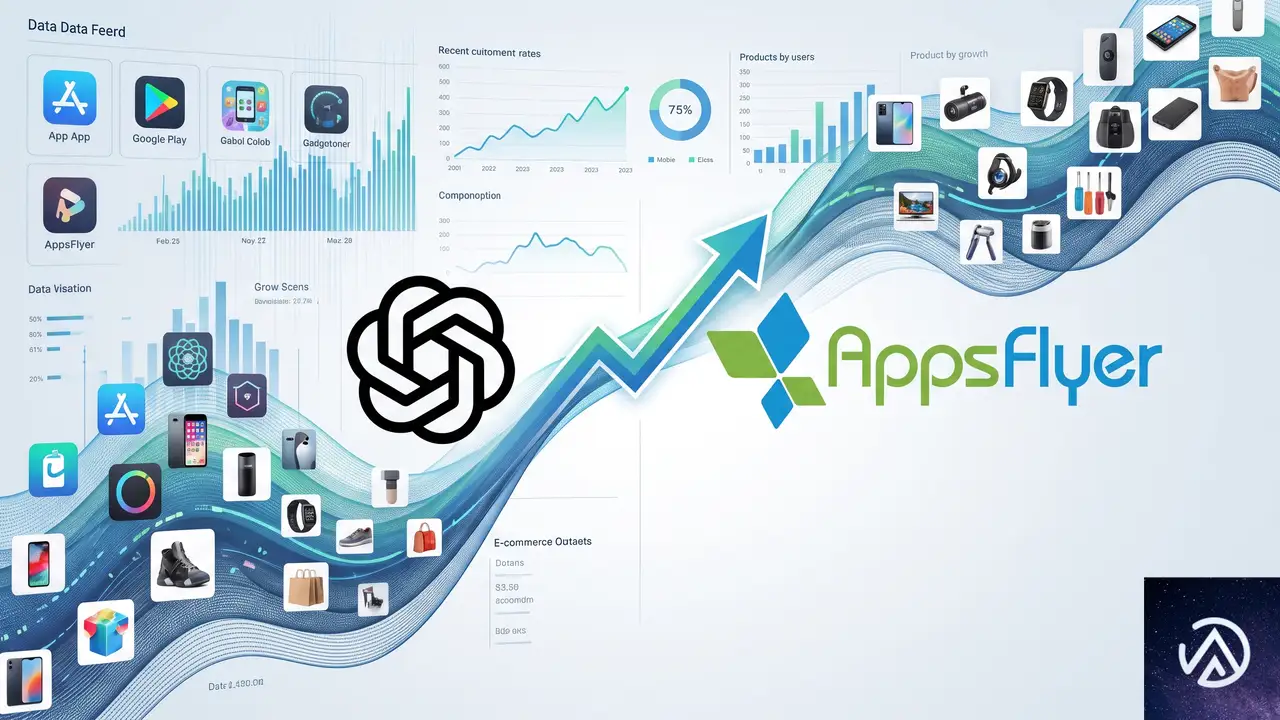
製品フィード、自動カルーセル表示、サードパーティによるアトリビューション。この3要素が揃ったことで、ChatGPT広告は「何を表示し、どんな成果があったか」を一気通貫で管理できるパフォーマンス広告のインフラを手にした。MarTechの記事は、OpenAIが第4四半期とホリデー商戦に向けて、フィードベースのキャンペーンに関する広告主向けガイダンスを強化しているとも伝えている。
広告主のコントロール不足が課題
カルーセル表示の可否をOpenAIが決める設計は、広告主にとって不確実性を生む。どのような条件で単品と複数品を使い分けるのか、各フォーマットのパフォーマンスに差があるのか、透明性はまだ十分とは言えない。
広告テストを進める段階で、自分たちの商品が適切に露出されているかを検証しづらいのは痛手だ。OpenAIが今後、キャンペーン管理画面で表示ロジックの詳細を開示するかどうかが、広告主の予算拡大を左右するポイントになる。
スケール面の未知数
カルーセルや計測が整備されたことは、ChatGPT広告のテストを容易にする。しかし、それが「競争力のあるCPA(顧客獲得単価)で十分なコンバージョン量を継続的に生み出せるか」は別の問題だ。
ChatGPTのユーザー数は巨大だが、検索連動型広告やソーシャルメディア広告と比較した場合、購買意欲の高いユーザーにリーチできるかは未知数だ。WooCommerceサイトの運営者は、他の広告チャネルと同様に、CPAと獲得数のバランスを見ながらChatGPT広告の出稿判断を下すことになる。
この記事のポイント
- ChatGPT広告に製品カルーセルが導入され、1広告で複数商品を表示できるようになった。
- AppsFlyerとの提携により、アプリインストールやアプリ内購入のアトリビューションが可能になった。
- 製品フィード、自動表示、計測というパフォーマンス広告の基本インフラが揃ったが、広告主の表示制御やスケール面の課題は残る。
- WooCommerceなどのECプラットフォームでも、商品フィード連携を通じてChatGPT広告を活用する道が開かれている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAI、GPT-5.6 SolとLunaをChatGPTに展開。無料ユーザーに無制限チャット、事実誤認を最大68%削減
OpenAIは2026年8月6日、ChatGPTの大幅なモデルアップデートを発表した。有料ユーザー向けにGPT-5.6 Solの回答品質を刷新し、無料ユーザー向けにはGPT-5.6 Lunaのデフォルト化と無制限テキストチャットを実現する。内部評価では事実誤認が最大68%削減されており、実務利用に直結する進化といえる。
週に10億人が利用するChatGPTにとって、この変更は情報検索や企画立案、専門的な意思決定の質を大きく左右する。有料ユーザーには思考深度を調整できる新しいスライダーが提供され、無料ユーザーは難しい質問に対して深い推論を呼び出す「Think」ボタンを利用できるようになる。
GPT-5.6 Solが実現する3つの改善点
事実誤認が最大68%減少
今回のGPT-5.6 Solでは、金融・医療・法律といった専門領域で事実誤認を大幅に減らすことに注力した。OpenAIの内部評価によると、GPT-5.5 Instantと比較してGPT-5.6 Lunaでは約62%、GPT-5.6 Solでは約68%も事実誤認を含む回答が減少している。日付や数字、出典や前提条件に依存する問いに対して、より正確に情報を引き出せるようになった。
回答の簡潔さと一貫性の向上
GPT-5.6 Solは質問の粒度に応じて回答の詳細度を自動調整する。たとえば「明日の午前中に自転車で移動するが、天気は問題ないか」という問いに対して、従来モデルが降水確率や風速を列挙するだけであったのに対し、新モデルは「風が強いため注意が必要」という核心を先に伝え、必要な詳細だけを整理して返す。
また、同じモデルで即時応答(Instant)と深い思考(Thinking)の両方をカバーするため、思考深度を切り替えても回答のトーンやスタイルが一貫している。「別のAIに切り替わった」ような違和感はなく、単に「より時間をかけて包括的に答えてくれる」という自然な体験になる。
この例のように、GPT-5.6 Solは本当に知りたいことを捉え、余計なフォーマットや関係の薄い詳細を省く。技術的な質問や多段階の計画立案でも、中心的な推奨事項が明確に示される。
思考深度を調整するスライダー(Plus・Pro向け)
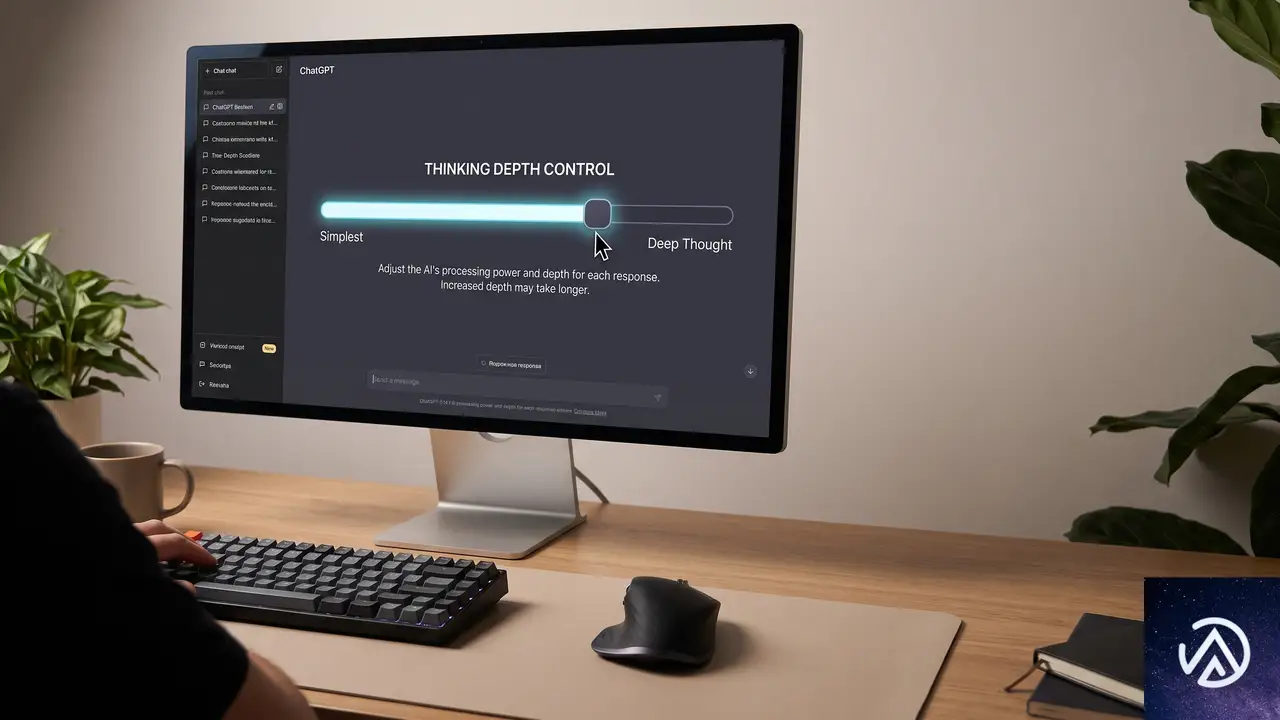
ChatGPTのウェブ版・モバイル版・デスクトップ版に新しく搭載されたスライダーを使うと、日常的な質問では素早く回答を得て、企画・調査・コーディング・意思決定のような深い思考が必要な場面ではスライダーを上げるだけでモデルがより多くの計算リソースを割くようになる。同じGPT-5.6 Solモデルの中で推論量を変えるため、品質と一貫性が保たれる。
無料ユーザー向けの大幅な機能拡張

デフォルトモデルがGPT-5.6 Lunaに
これまで無料ユーザーが利用できたGPT-5.5 Instantに代わり、GPT-5.6 Lunaが標準モデルとして展開される。GPT-5.6 Lunaは事実誤認の削減や回答の一貫性でGPT-5.5 Instantを上回り、日常的なチャットの質を底上げする。
テキストチャットが無制限に
無料ユーザーはテキストチャットの回数制限がなくなり、連続して質問を続けたり、アイデアを深掘りしたりできるようになる。ファイルアップロードや画像生成などの他のツールには引き続き制限がかかるが、言語でのやり取りが事実上無制限になることで、学習や日常業務でのハードルが大きく下がる。
難しい質問に使える「Think」ボタン
無料ユーザー向けのインターフェースには新たに「Think」ボタンが追加される。より深い推論が必要な質問に対して、このボタンをタップするとGPT-5.6 Lunaが追加の計算時間をかけて回答を導き出す。複雑な比較検討や論理的な分析が必要な場面で、有料プランに近い推論品質の恩恵を得られる。
「2つの事業計画のリスクとリターンを比較し、最適な選択肢はどれか」
なお、悪用防止のためのガードレールが設けられており、過度な連続利用には制限がかかる。しかし、重要な場面で深い回答が得られる点は無料ユーザーにとって大きな価値となる。
スライダーで思考量を自在にコントロール
操作の仕組みと実務での活用
スライダーは左から右に動かすほど、GPT-5.6 Solが回答の生成に費やす推論時間が増加する。左端ではシンプルな事実確認や挨拶のような即答に適し、右端では複数ステップの計画立案、技術的なトラブルシューティング、長文の分析レポート作成に適した深い回答が得られる。
たとえば「自社サイトのSEO状況を改善したい」という場合、スライダーを低く設定すれば基本的なチェックリストを得られる。高く設定すると、具体的なデータ分析の手順やツールの選定、優先順位付けまで含めた戦略的なアドバイスを引き出せる。
未成年ユーザー保護への取り組み

18歳未満を対象にした安全訓練とシステム保護
OpenAIは今回のアップデートに伴い、18歳未満と推定されるユーザー向けの安全性対策を強化した。モデルは恋愛ロールプレイや年齢制限のあるチャレンジ、現実の人間関係の代替として振る舞うことを避けるよう訓練されている。さらに、性的コンテンツや摂食障害、危険行為、過激な暴力表現に対する年齢相応の境界も設定された。
システムレベルでの保護も重ねられ、10代のユーザーがサポートを必要としていると判断した場合には、信頼できる大人とのつながりを促すように設計されている。これらの対策の詳細は公開されたシステムカードに記載されており、未成年ユーザーに対するモデルの振る舞いを継続的に改善する姿勢が示された。
このアップデートがもたらすAI活用の展望
無料ユーザーへの高機能提供が意味すること
無制限テキストチャットとThinkボタンの提供は、「高度なAI機能は有料」という従来の常識を覆す。個人事業主や学習者にとっては、リサーチやアイデア出しの頻度を気にせずAIを活用できる環境が整った。アクセスの拡大は学習機会やビジネスチャンスの格差を縮める一歩といえる。
ビジネスユーザーにとっての実用性向上
事実誤認の大幅な減少と回答の簡潔化は、レポート作成や顧客対応の下調べ、契約書のレビューといった業務でミスを減らす直接的な効果をもたらす。スライダーによって手軽に深い分析と迅速な回答を使い分けられるため、AIを実務のパートナーとして日常的に組み込む企業が増える可能性がある。
この記事のポイント
- GPT-5.6 Solは事実誤認を最大68%削減し、回答の的確さと一貫性が向上した
- Plus・Proユーザー向けのスライダーで、同じモデル内で思考深度を自由に調整できる
- 無料ユーザーはGPT-5.6 Lunaがデフォルトモデルとなり、テキストチャットが無制限に
- 無料ユーザーも「Think」ボタンで深い推論が必要な質問に対応可能になった
- 未成年保護の安全対策が強化され、18歳未満向けのモデル訓練とシステム保護が導入された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験