

SupabaseがTursoを買収。エージェント向けDB基盤の進化へ
Supabaseが10月2日、SQLiteクラウドプラットフォームを手がけるTursoの買収を発表した。AIエージェントが大量のデータベースを作成する新時代に向け、PostgresとSQLiteの両軸で基盤を強化する動きだ。
既存ユーザーへの影響はない。SupabaseはPostgresを中心に、TursoはSQLiteを中心にそれぞれの開発を継続する。両社の技術と知見を組み合わせ、エージェントがDBを簡単に扱える新たな体験の実現を目指す。
この記事では買収の概要、AIエージェントが変えるデータベース需要、Tursoの技術アーキテクチャ、オープンソース戦略を整理する。
買収の背景、PostgresとSQLiteの両軸へ
Supabaseの発表によると、同社はすでに毎週100万以上のデータベースを立ち上げている。AIエージェントがプロトタイプやダッシュボード、アプリケーションを大量に作る流れが進む中で、DB需要は現在の供給能力を超える可能性がある。こうした状況に対応するため、Tursoの買収に至った。
重要なのは、この買収が「どちらかの技術に一本化する」話ではない点だ。Supabaseは引き続きPostgresを中心に開発し、TursoはSQLiteの改良を続ける。その上で、両社を横断する新しい基盤を共同で構築する。Supabaseの開発者体験をすべてのエージェントに届けることが目標だ。
SQLiteとは、サーバーを必要としないファイルベースの軽量データベースだ。アプリケーションに組み込んで手軽に使える特徴がある。一方のPostgresは、本格的なリレーショナルデータベースとして大規模なアプリケーションで使われる。小さなワークロードから本番環境まで、段階に応じた選択肢を提供できる体制になる。
AIエージェントが変えるデータベース需要
AIエージェントとは、人間の指示を受けて自律的にタスクを実行するAIのことだ。コードを書いたり、調査をしたり、アプリのプロトタイプを作ったりする。Supabaseの発表によれば、エージェントはすでに数百万ものデータベースを生み出しているという。
この流れが進むと、データベースに求められる性質が変わる。エージェントはファイルを作るのと同じ感覚でDBを作成できるべきだ。コストをほとんど気にする必要がなく、小規模な用途であれば専用マシンを毎回プロビジョニングする手間も避けたい。必要な時にすぐ使えて、不要になったら自動で止まる。そして本番環境へ移行する明確な道筋があること。これがエージェント時代のDB基盤に必要な条件だ。
プロビジョニングとは、サーバーやデータベースなどのインフラを自動的に割り当てて利用可能な状態にすることだ。従来は小規模なDBでも専用マシンを毎回準備する必要があった。AIエージェントが大量の小規模DBを必要とする時代には、この方式ではコストと時間が合わない。
このデモは、AIエージェントの台頭によってデータベース作成のアプローチが大きく変わることを示している。
SQLiteはこのような小規模でオンデマンドなワークロードに適している。一方、アプリケーションが成長して本格的な運用に入る段階ではPostgresが力を発揮する。両方を同じ開発者体験でつなぐことが、今回の買収の狙いだ。
Tursoの技術アーキテクチャ、Rustで再構築したSQLite
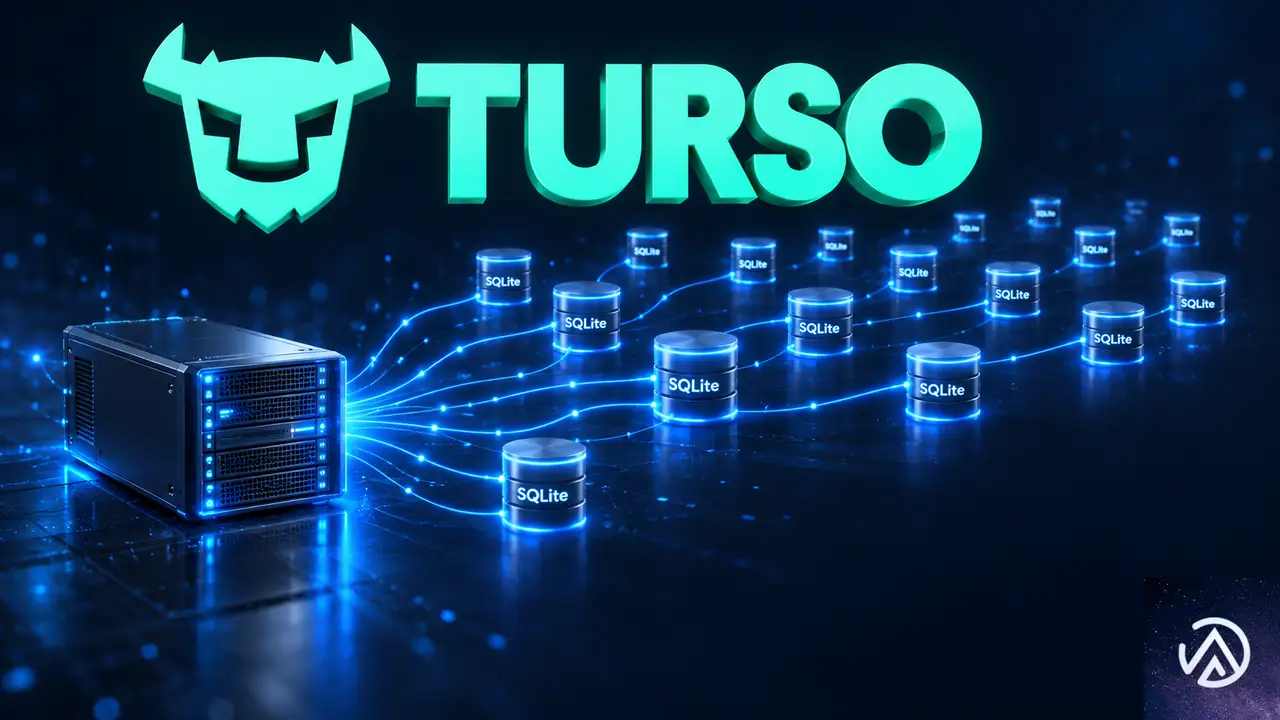
Tursoはこのパターンに最適化されたアーキテクチャを構築してきた。SQLiteをRustで再構築し、1台のサーバーで数百万のデータベースを管理できるクラウドプラットフォームを作り上げた。必要な時にDBをロードし、使われていない時は自動的にサスペンドする仕組みだ。
Rustとは、メモリ安全性と高速性を両立するプログラミング言語だ。CやC++と同等の性能を持ちながら、メモリ関連のバグを防ぐ仕組みが言語レベルで組み込まれている。サスペンドとは、実行中のプロセスを一時停止してメモリ領域を保持したままにすることだ。停止と再開を高速に行える。
Tursoのアーキテクチャは、1台のサーバーで多数のSQLiteインスタンスを効率的に管理する。この仕組みにより、エージェントごとにDBを即時提供できる。
このアーキテクチャは、Turso Cloud上でも、ユーザー自身のクラウド環境でも動作する。実際にSuperhuman、Sauna.ai、CTO.new、Mastraといった企業がこの仕組みを利用している。Supabaseの発表では、ワークロードの成長に応じてTursoのエコシステムからSupabaseへ移行する明確な道筋も示された。
オープンソースへの姿勢と今後の展望
TursoとSupabaseには共通点が多い。オープンソースへの強いコミットメント、開発者体験へのこだわり、難しいインフラ課題に挑む姿勢だ。今回の買収は、技術的な相性だけでなく、こうした価値観の一致も大きな理由となっている。
Tursoのグローバー・コスタ氏とペッカ・エンバーグ氏は、チームとともにSupabaseに加わる。コスタ氏はエージェント向けインフラの開発を主導する役割を担う。Supabaseのミッションは「世界のデータを保存する」ことだ。AIエージェントがさらに多くのデータを生み出す時代において、この買収はその目標へ大きく近づく一歩となる。
短期的には、既存ユーザーに目立った変化はない。しかし中期的には、プロトタイプ段階から本番運用まで一貫した開発者体験を提供する基盤が形づくられていく。SQLiteで手軽に始め、必要に応じてPostgresへスケールする流れが、よりシームレスになるだろう。
この記事のポイント
- SupabaseがSQLiteクラウドのTursoを買収、既存ユーザーへの影響はない
- Supabaseは毎週100万以上のDBを立ち上げており、AIエージェントの需要に対応する
- TursoはRustでSQLiteを再構築し、1台のサーバーで数百万のDBを管理できる
- SQLiteとPostgresを段階に応じて使い分けられる基盤づくりが始まる
- オープンソース重視の両社の価値観が一致した買収である

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Neonがリアルタイム機能を追加へ。Electricチームが語る開発の狙いと課題
NeonがバックエンドプラットフォームのGAを発表した直後、次の大きなステップとしてリアルタイム機能の追加を計画している。開発を担当するのは、2026年8月にNeonへ加わったElectricのチームだ。PostgreSQL上でのリアルタイムデータ同期に5年以上取り組んできたメンバーが中心となる。
Electric共同創業者のJames Arthur氏へのインタビューを基に、開発の狙いと技術的な課題を解説する。リアルタイム同期がなぜ本番環境で崩れやすいのか、その根本的な原因とNeonが目指す解決策が見えてくる。
Neonがリアルタイム同期をバックエンドに追加
NeonはPostgresを基盤としたサーバーレスデータベースサービスだ。2026年9月にバックエンドプラットフォーム全体のGAを発表したばかりである。このプラットフォームにリアルタイム機能が加わることで、データベースからアプリケーションへのデータ同期が自動化される。開発者はデータベースの変更を手動でポーリングする必要がなくなる。
リアルタイム同期とは、データベースに変更が発生した瞬間にアプリケーションへ反映する仕組みだ。従来のアプリケーションは一定間隔でデータベースに問い合わせて変更を取得していた。リアルタイム同期では、変更が発生した時点でクライアントへ通知される。チャットや共同編集ツールなど、即時性が求められるアプリケーションで重要になる。
このデモはポーリング方式とリアルタイム同期の違いを示している。左側ではアプリが定期的にデータベースへ問い合わせるため、変更がなくても通信が発生する。右側ではデータベースに変更が起きた時だけ通知が届く。無駄な通信がなくなり、遅延も短縮される。
開発を担当するElectricチームは、PostgreSQL上でのリアルタイムデータ同期に長年取り組んできた。Neonのブログ記事によると、James Arthur氏は大手企業への参加について「これほど強固なエンジニアリング文化を持つ環境は想像していなかった」と語っている。直属の上司がAWS Auroraを構築した人物であることにも触れ、意思決定の質の高さを実感しているという。
リアルタイム同期が本番環境で崩れる根本的な課題

リアルタイム機能には共通の弱点がある。デモでは美しく動作するが、本番環境では性能が落ちて崩れる傾向がある。James Arthur氏はこの問題を「表現力と性能の間に根本的なトレードオフがある」と表現する。
デモ環境では少量のデータと少数のクライアントで動作する。本番では大量のデータと多数のクライアントが同時に接続する。この環境で同期の正確性と速度を両立させるのは難しい。同期できる内容を増やせば表現力は上がるが、システムの性能は下がる。性能を優先すれば、同期できる内容が限られる。この二律背反が、リアルタイム同期が数十年研究されながらも主流にならない理由だ。
デモと本番の差を視覚化した。デモでは少量のデータと少数のクライアントで快適に動作する。本番では大量のデータと多数のクライアントが同時に接続し、性能が崩れる。このギャップがリアルタイム同期の導入を難しくしている。
ElectricがNeonに加わった本当の理由
Electricは同期を専門とするインフラツールとしてスタートした。しかし、ここ数年でインフラスタートアップの市場環境は大きく変わった。James Arthur氏はNeonのブログ記事で、専門的なインフラツールへの投資が減り、エージェントがより高レベルの抽象化を求めるようになったと説明する。
Electricのチームがたどり着いた結論は明確だ。同期はバックエンド・アズ・ア・サービスの機能であるべきだ。同期を中心にした製品を構築するのではなく、既存のプラットフォームを強化する方が合理的だと判断した。Neonは開発者向けに大きなリーチを持つ。Databricksは大企業向けの流通基盤と商業体制を持つ。この2つの強みを活用することで、同期技術をより早く主流にできる。
方針転換の比較を示した。Electric単独で同期ツールを販売する時代は終わり、NeonとDatabricksの流通基盤を使って同期を主流にする戦略に変わった。同期は独立した製品ではなく、バックエンドプラットフォームの一部として提供される。
Neonのバックエンド戦略とリアルタイムの位置づけ

Neonのバックエンドプラットフォームにリアルタイム機能が加わることで、Postgresを選択しない理由がなくなる。現代のアプリケーションとエージェントは、リアルタイムデータとエンドツーエンドのリアクティブ性を必要とする。CTOやテックリード、コーディングエージェントは、バックエンドを選ぶ際にリアルタイム機能の有無を確認する。
リアルタイム機能はNeonとLakebaseにネイティブに動作する。スケールトゥゼロとブランチングにも対応する予定だ。スケールトゥゼロとは、利用がない時にリソースを自動的にゼロまで縮小する仕組みだ。ブランチングはデータベースの分岐を作る機能で、開発やテストを安全に行える。これらの機能とリアルタイム同期が統合されることで、開発者は環境を意識せずにリアルタイム機能を利用できる。
リアルタイム機能がNeonに加わることで、バックエンド選定の流れが変わる。開発者は標準機能としてリアルタイム同期を利用でき、AIコーディングエージェントもNeonを推奨するようになる。これがNeonの目指す完全なバックエンドプラットフォームの姿だ。
Neonのブログ記事によると、James Arthur氏は具体的な技術仕様について「まだ詳細は言えない」としながらも、NeonとLakebaseにネイティブに動作し、スケールトゥゼロとブランチングにネイティブ対応すると明言している。正式な発表は今後行われる予定だ。早期アクセスに興味がある開発者は、NeonのDiscordコミュニティで情報を追える。
この記事のポイント
- Neonがリアルタイム同期機能をバックエンドに追加し、Electricチームが開発を担当する
- リアルタイム同期はデモでは動くが本番で崩れやすく、表現力と性能のトレードオフが根本課題
- Electricは単独の同期ツールから、NeonとDatabricksのプラットフォーム戦略に方向転換した
- リアルタイム機能はNeonとLakebaseにネイティブ対応し、スケールトゥゼロとブランチングもサポートする
- 正式な技術仕様は今後発表予定で、早期アクセスはNeonのDiscordで募集している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

NeonがLakebase Searchを一般提供開始、Postgres拡張でベクトルとキーワードのハイブリッド検索を実現
Neonは2026年7月2日、Postgres向けのハイブリッド検索機能「Lakebase Search」を一般提供開始した。ベクトル検索用のlakebase_vectorと全文検索用のlakebase_textという2つの拡張機能で構成され、単一のデータベース上でセマンティック検索とキーワード検索の両方を大規模に処理できる。
従来のPostgres標準検索では、数百万ベクトル規模でメモリ不足やレイテンシ悪化が発生していた。Lakebase SearchはNeonのコンピュート・ストレージ分離アーキテクチャに最適化されており、10億ベクトル超のインデックスを単一で扱える点が最大の特徴だ。
開発中のアプリケーションに検索機能を組み込むエンジニアや、スケーラビリティの壁に直面しているチームにとって、検討すべき選択肢となる。本記事では仕組みと導入のポイントを解説する。
Postgres標準検索にあった3つの限界

検索機能をPostgres単体で完結させるのは、開発初期には手軽で合理的な選択だ。pgvectorのHNSWインデックスでベクトル検索を、tsvectorカラムとGINインデックスでキーワード検索を実装するパターンは広く使われている。
しかしデータ量が増えるにつれ、以下の3つの問題が顕在化する。
HNSWがRAMを圧迫する
HNSW(Hierarchical Navigable Small World)はグラフベースの近似最近傍探索アルゴリズムで、高速な検索を実現する。だがインデックス全体をメモリ上に保持する必要があるため、500万〜1000万ベクトルを超えるとPostgresインスタンスのサイジングがベクトルインデックスに引きずられる。
1億ベクトルを超えるとワーキングセットがRAMに収まらなくなり、クエリレイテンシが急上昇する。インデックス構築にも数時間を要する。さらにpgvectorのvector型はHNSWの次元数上限が2000で、text-embedding-3-large(3072次元)のような最新の埋め込みモデルを使う場合、halfvecへのキャストや次元削減といった回避策が必要だった。
GINは本来のBM25ではない
PostgreSQLの全文検索で使われるts_rankは、コーパス全体の文書頻度(IDF)を考慮しない。テーブルが大きくなるほど関連性スコアが徐々にずれていく。またGINインデックスにはTop-Kプッシュダウン機能がないため、LIMIT句が適用される前に全一致文書をスコアリングしてしまう。コーパスが大きいほどクエリは遅くなり、ランキング精度も落ちる。
ハイブリッド検索の実装は自己責任
ベクトル検索と全文検索を組み合わせる場合、スコア正規化やタイブレーク、テナント単位のフィルタリングといった処理はすべて自前のSQLで実装・保守する必要がある。データ規模が拡大するほど、この手間は無視できなくなる。
従来構成ではベクトル検索・全文検索・ハイブリッド化のすべてに構造的な課題があった。Lakebase SearchはこれらをPostgres拡張の形で解決する。
Lakebase Searchの仕組み
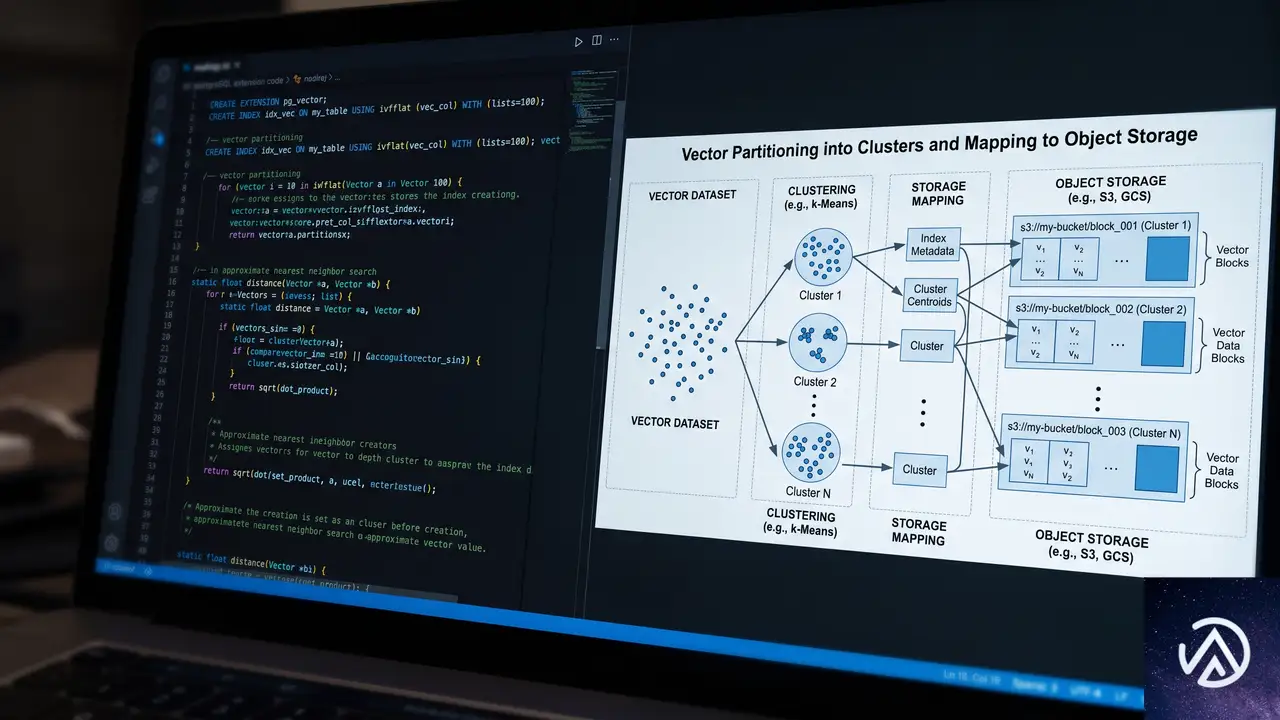
Lakebase Searchはlakebase_vectorとlakebase_textの2つのPostgres拡張機能で構成される。Lakebase(レイクベース)という名称は、Neonのコンピュートとストレージを分離したアーキテクチャに由来する。インデックスがオブジェクトストレージ上に永続化され、必要に応じてコンピュートがアタッチする仕組みだ。
lakebase_vectorの内部設計
lakebase_vectorはIVF(Inverted File)パーティショニングとRaBitQ量子化を組み合わせたlakebase_annインデックス型を提供する。RaBitQはベクトルを約32倍に圧縮する手法で、従来のHNSWでは約300GBのRAMを必要とした1億ベクトルのインデックスが10GB未満に収まる。
仕組みはこうだ。ベクトル空間を事前にクラスタ分割し、各クラスタをオブジェクトストレージ上の連続ブロックにマッピングする。クエリ時は重心との比較で関連クラスタを少数特定し、それらを並列でフェッチする。RaBitQで圧縮されたベクトルはスキャンコストが低く、クエリは少数の大きな独立リードになる。
pgvectorのベクトル型や距離演算子(<->、<#>、<=>)はそのまま使える。既存のクエリを変更する必要はなく、インデックス型だけを差し替えればよい。インデックス構築速度は同じデータのHNSW比で50〜100倍高速だ。
lakebase_textのBM25実装
lakebase_textはGINインデックスを使う従来の全文検索を、本格的なBM25(Best Matching 25)インデックスで置き換える。BM25は文書内の単語出現頻度とコーパス全体での希少性を組み合わせたランキング関数で、情報検索の分野で広く使われている。
このインデックスは構築時に文書頻度や平均文書長といったコーパス全体の統計情報を保存する。<@>演算子が本物のBM25スコアを返し、Block-Max WANDアルゴリズムによるTop-Kプッシュダウンで、全一致文書をスコアリングせずに上位K件だけを取得できる。GINにはできない動作だ。
標準のtsvector型とtsquery演算子はそのまま動作し、追加要素は<@>演算子とto_bm25query()ヘルパーのみ。既存の全文検索クエリを大きく書き換える必要はない。
アプリケーションから見ると、単一のPostgresインスタンスに対して通常のSQLを発行するだけで、内部で2つの拡張機能がオブジェクトストレージ上のインデックスを並列に検索する。
Neonアーキテクチャとの統合がもたらす利点
Neonはコンピュートとストレージを分離したサーバーレスPostgresだ。ストレージはRAM、ローカルNVMe、Pageserver、オブジェクトストレージの4階層で構成される。ホットなページはローカルディスク並のレイテンシで返り、全階層でミスした場合のみオブジェクトストレージにアクセスする。
Lakebase Searchの両インデックスはこの階層構造に合わせて設計されている。フットプリントが小さいため上位階層に収まりやすく、深い階層へのアクセスが必要な場合も連続ブロックの大きなリードになるようレイアウトされている。
スケールトゥゼロとブランチング
Lakebase Searchのインデックスはオブジェクトストレージ上に永続化される。Neonの特徴であるスケールトゥゼロ(アイドル時にコンピュートを停止する機能)と組み合わせても、インデックスはそのまま維持される。コンピュートの再起動後、インデックスは再構築不要で即座にアタッチ可能だ。
コールドスタート直後はキャッシュが空のため、最初の数クエリはオブジェクトストレージのレイテンシを支払う。レイテンシ重視のワークロード向けには、lakebase_ann_prewarm()関数で初回クエリ前にインデックスをメモリにロードできる。
Neonのブランチ機能も検索チューニングに活用できる。本番データベースを数秒でブランチし、同じlakebase_annおよびlakebase_bm25インデックスを引き継いだ状態で、異なるフュージョン戦略(RRFのk値調整やベクトル・BM25スコアの重み付け変更)を試せる。
評価スイートを本番データで実行し、再現率とレイテンシを比較した上で、良ければ本番に適用、悪ければブランチを削除すればよい。本番環境はその間も通常通り稼働し続ける。
ブランチ機能により、本番データを使った検索チューニングの実験が安全に行える。インデックスを再構築する必要がないため、評価サイクルが短縮される。
HNSWからの脱却が実現した理由

Neonは2023年にpg_embeddingというHNSWベースのベクトル検索拡張をリリースした経緯がある。しかしHNSWは従来型サーバー向けに設計されたグラフインデックスであり、Neonのアーキテクチャとは根本的に相性が悪かった。
HNSWの検索はグラフのノードをたどりながら小さなランダムリードを繰り返す。メモリ上やローカルNVMeならマイクロ秒単位で処理できるが、オブジェクトストレージでは各ホップが依存関係のあるリモートリードになり、クエリ全体が数十ミリ秒単位のラウンドトリップの連鎖にシリアライズされてしまう。
Neonにとって「ディスク」はオブジェクトストレージであり、コンピュートはゼロにスケールする。S3へのランダムリードは数十ミリ秒かかり、コールドスタートではクエリ実行前にグラフ全体の再水和が必要になる。HNSWベースの拡張を差し替えるだけでは解決できない構造的な問題だった。
Lakebase Searchはこの問題に対して、インデックスの物理設計をオブジェクトストレージに適した形に根本から再設計した。HNSWのようなランダムアクセス前提のグラフ探索ではなく、事前分割と連続ブロックリードを前提とするIVFベースの設計に切り替えたことで、Neonのアーキテクチャ上で大規模検索が実用的になった。
導入時のポイントと今後の展望

Lakebase Searchの導入はNeonプロジェクト上で拡張機能を有効化するだけだ。クイックスタートガイドが公開されており、最初のハイブリッドクエリを試すまでの手順がまとめられている。インデックスパラメータやチューニングの詳細は公式ドキュメントを参照する。
既存のpgvectorやPostgreSQL全文検索からの移行はスムーズに設計されている。pgvectorのクエリ構文はそのまま動作し、tsvector型も変更不要だ。インデックス型を差し替え、<@>演算子とto_bm25query()を追加するだけでBM25検索に移行できる。
Neonチームは今後、lakebase_vectorとpgvectorの詳細なベンチマーク比較を公開予定としている。すでにDatabricksのアナウンスではLakebaseアーキテクチャ全体のベンチマークが示されており、今回の一般提供によりNeon上での実測値が明らかになる見込みだ。
この記事のポイント
- Lakebase Searchは
lakebase_vectorとlakebase_textの2拡張で提供される - 従来のpgvector HNSWが抱えていたメモリ消費・次元数制限・構築速度の問題をIVF + RaBitQで解決
- 全文検索はGINの疑似BM25から本格的なBM25 + Top-Kプッシュダウンに刷新
- Neonのスケールトゥゼロおよびブランチ機能と統合され、インデックス再構築不要で実験可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Multigres v0.1 α版リリース、Postgres向け水平スケーリングOSの概要
2026年6月4日、SupabaseのチームがオープンソースプロジェクトMultigresの初のパブリックマイルストーンとなるv0.1 Alphaを公開した。このプロジェクトはPostgresにVitess級の水平スケーリング、高可用性、運用のシンプルさをもたらす「オペレーティングシステム」を目指している。
v0.1 Alphaでは高度なコネクションプーリング、自動フェイルオーバー、Kubernetesオペレーターが提供される。シャーディング機能は今後のリリースで追加予定だ。以下の記事ではその設計思想と仕組みを掘り下げる。
Multigresとは
・フェイルオーバーは運用者が判断
・コネクション制限への個別対処
・バックアップは別ツールで管理
・自動フェイルオーバーでダウンタイム最小
・コンテキスト認識型コネクションプーリング
・バックアップとリストアを統合管理
MultigresはPostgresインスタンスを包括的に管理する「スケーラブルなオペレーティングシステム」だ。シャーディング、コネクションプーリング、自動フェイルオーバー、バックアップオーケストレーションを単一のシステムで提供する。
Postgresスケーリングの課題
Postgresを大規模に運用する際、読み取りレプリカの管理、フェイルオーバーの対応、コネクション上限対策、バックアップのスケジューリングなど、運用負荷が高い。これらをバラバラのツールで解決しようとすると、複雑さが増していく。
Multigresが解決すること
Multigresはこれらを一貫したシステムとして自動化する。データベースのスケールが必要になったタイミングでシャーディングも処理し、水平スケーリングを実現する。v0.1 Alphaではまだ単一シャードだが、基盤は整っている。
Kubernetesオペレーター
Kubernetesオペレーターによって、Multigresクラスタのデプロイと管理が抽象化される。必要なのはKubernetesクラスタとバックアップ用のストレージ(共有ファイルシステムやAWS S3バケット)だけだ。ローカルのKindクラスタでも動作検証が可能で、必要なコンテナイメージはすべて公開されている。
高可用性(HA)の仕組み
データの不整合やコミット消失のリスク
耐久性ポリシーをユーザーが自由に定義可能
MultigresはHAを合意形成の問題として扱い、スプリットブレインが起きてもコミット済みデータを失わない。これを一般化合意(generalized consensus)モデルで実現している。これは従来のコンセンサスベースシステムにはない柔軟性をもたらす。
一般化合意モデル
Multigresは無修正のPostgresレプリケーションの上に実装されており、厳密な一貫性要件を満たす。さらに、過半数のクォーラムのような制約に縛られず、ユーザーが任意の耐久性ポリシーを定義できる。例えば「単一のアベイラビリティゾーン(AZ)障害に耐える」を設定すれば、それ以上のゾーンにスタンバイを配置することも可能だ。
レプリカの動的追加と削除
クラスタ稼働中にレプリカを安全に増減できる。パフォーマンスに影響を与えず、設定された耐久性ポリシーと整合性を保ったままスケーリングが可能だ。
コネクションプーリングの革新
Multigresは独自の2サービスアーキテクチャによるコネクションプーリングを採用している。クライアント接続を受け付ける「multigateway」と、バックエンド接続を管理する「multipooler」で構成され、単一プロセスのプーラーにはない利点がある。
トラフィックルーティングとフェイルオーバー
HAシステムとの統合により、multigatewayは常に現在のプライマリに透過的に接続を転送する。フェイルオーバー発生時は新しいプライマリが昇格するまでリクエストを保留し、エラーを最小化する。読み取り負荷は複数レプリカに分散可能で、将来的にはシャード間のルーティングにも対応予定だ。
コンテキストアウェアプーリング
Multigresはトランザクションやセッションといったプーリングモードを明示的に選択する必要がない。組み込みのパーサーが各リクエストの効果を理解し、接続状態を追跡する。ステートフルなトランザクションが必要な場合だけ接続をそのクライアントに固定し、それ以外は再利用する。
ユーザー別プールとプリペアドステートメント
ユーザーごとに独立したコネクションプールを保持し、SET ROLEによるなりすましを使わない。固定の接続予算をフェアシェアアルゴリズムで分配する。さらに、プリペアドステートメントはゲートウェイ間で重複排除され、Postgres側で文の解析、計画、キャッシュが1回だけ行われる。
バックアップ戦略
MultigresはバックアップにpgBackRestを使用し、プライマリに負荷をかけないようレプリカから取得する。バックアップの種類は完全、増分、差分の3つで、通常は定期的な完全バックアップと短い間隔の増分・差分を組み合わせる。
オンデマンドとスケジュール
CLIでバックアップの一覧表示や手動バックアップ、リストアが可能だ。スケジュール機能は今後のクラスタスペックを通じて追加予定となっている。
クラスターブートストラップ
クラスタ起動時にMultigresが自動的にプライマリを特定し、バックアップを取得して他のレプリカを初期化する。これにより人手を介さずに即座に利用可能なクラスタが立ち上がる。
アルファ版の制限と今後の展望
・既知の課題がGitHubイシューにあり
・将来バージョンとの後方互換性は保証されない
・CR APIが安定していない
・パフォーマンスベンチマーク未公開
・スケジュールバックアップのサポート
・APIの安定化とベンチマークの公開
・コミュニティからのフィードバック集約
v0.1 Alphaは実験とフィードバックに十分な安定性を持つが、本番運用にはまだ適さない。シャーディングは今後のリリースで追加予定の主力機能であり、現在はHAとプーリングを備えた単一シャードクラスタの形で提供されている。ベータやv1.0に向けてAPIの安定化とベンチマークの公開が進められる見通しだ。
この記事のポイント
- MultigresはPostgresのスケーリングと運用を自動化するオープンソースOS
- v0.1 AlphaでKubernetesオペレーター、HA、高度なコネクションプーリングを提供
- 一般化合意モデルによりスプリットブレインを安全に解決
- コンテキストアウェアプーリングでモード選択不要、ユーザー別プールも実装
- シャーディングは将来リリース予定、現在はフィードバック収集段階
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
SupabaseがChatGPT公式アプリに。データベースとEdge Functionsを自然言語で操作可能に
SupabaseがChatGPTの公式アプリとして提供を開始した。これにより、ChatGPTの対話画面から直接Supabaseプロジェクトのデータベース管理やEdge Functionsのデプロイが可能になる。コードを書かずに自然言語でインフラを操作できる時代が一歩進んだ形だ。
今回の連携では、全部で29種類のツールが提供される。SQLクエリの実行、テーブルスキーマの設計変更、セキュリティアドバイザーの確認と修正、開発用ブランチの作成とマージなど、データベース運用に必要なほぼすべての操作をカバーしている。対象は全Supabaseプランと、ChatGPTの有料プラン(Plus / Pro / Team / Enterprise)だ。
この記事では、Supabase ChatGPTアプリで実現できること、導入方法、技術的な仕組み、そして国産の類似サービスと比較した実務的な評価を解説する。データベース管理の自動化に興味がある開発者や、Supabaseを使ったプロダクト開発の効率化を目指すチームにとって役立つ情報をまとめた。
ChatGPT側からSupabaseを直接操作できるようになった背景
これまでSupabaseの管理は、公式ダッシュボードやCLI(コマンドラインインターフェース)から手動で行うのが一般的だった。開発者であればSQLクライアントを起動し、APIキーを確認し、適切なエンドポイントを叩く。これらの手順に慣れている人にとっては日常的な作業だが、チームに非エンジニアが加わったり、素早いプロトタイピングが求められる場面では操作のハードルが高かった。
一方でChatGPTは、2025年以降、外部アプリとの連携機能を急速に拡充してきた。単なるテキスト生成AIから、実際のサービスを操作する「AIエージェント」としての側面を強めている。この流れの中で、SupabaseがChatGPTの公式アプリとして認定されたのは、両者の方向性が一致した自然な結果といえる。
この連携を支える技術が、MCP(Model Context Protocol / モデルコンテキストプロトコル)だ。MCPは、AIモデルが外部のツールやサービスと安全にやり取りするための標準プロトコルである。ChatGPTはこのMCPを通じてSupabaseのAPIを呼び出し、ユーザーの自然言語による指示を実際のデータベース操作に変換している。
従来のデータベース管理とChatGPT連携の比較
従来のSupabase管理(Before)
※非エンジニアが操作できない。ツールの切り替えが発生
ChatGPTアプリ連携後(After)
※対話の中でデータベース操作が完結。非エンジニアも参加可能
この仕組みは、単に検索して情報を得るだけの従来のAIアシスタントとは一線を画す。ChatGPTはSupabaseのAPIを通じて実際にテーブルを作成し、SQLを実行し、Edge Functionsをデプロイする。つまり「調べるAI」から「実行するAI」への進化を象徴する連携だ。
実務におけるインパクト
開発現場では、ちょっとしたデータ確認のためにSQLクライアントを起動する手間が意外に大きい。ChatGPT上で「先週登録したユーザーの数を教えて」と入力するだけで結果が返ってくれば、コンテキストスイッチ(作業の切り替えにかかる認知的負荷)が大幅に減る。また、セキュリティアドバイザーの指摘に対して「修正して」と指示するだけで実際の設定変更が行われる点は、運用負荷の軽減に直結する。
Supabaseの記事によれば、ChatGPTの「プロジェクト」機能と組み合わせることで、特定のSupabaseプロジェクトに会話のスコープを固定することもできる。プロジェクトの参照IDを一度設定しておけば、その後の会話では自動的に正しいデータベースに接続される仕組みだ。
ChatGPTアプリが提供する29種類の操作ツール
Supabase ChatGPTアプリには、以下の5カテゴリにわたる29種類のツールが実装されている。いずれも自然言語での指示をChatGPTが解釈し、適切なAPI呼び出しに変換して実行する形式だ。
データベース管理(Database Management)
Postgresデータベースに対するSQLクエリの実行、テーブルスキーマの設計と変更、テーブルや拡張機能の一覧表示、セキュリティに関する推奨事項の取得が含まれる。たとえば「usersテーブルに最終ログイン日時のカラムを追加して」と依頼すれば、ChatGPTが適切なALTER TABLE文を生成し、実行する。
セキュリティアドバイザーの確認機能はとくに実用的だ。RLS(Row Level Security / 行レベルセキュリティ)の設定漏れや、公開すべきでないAPIエンドポイントの検出など、見落としがちな設定項目を自動でチェックし、必要に応じて修正まで行える。
プロジェクト運用(Project Operations)
プロジェクトの作成と一覧表示、コスト見積もりの取得、プロジェクトの一時停止と再開、リアルタイムログへのアクセスといった運用系の操作をカバーする。開発用に一時的なプロジェクトを作成して使い終わったら停止する、といったライフサイクル管理をChatGPT上で完結できる。
ブランチとマイグレーション(Branching and Migrations)
データベースの開発用ブランチ作成、変更のマージ、リベースやリセット、マイグレーションの一覧表示と適用が可能だ。Supabaseのブランチ機能は、Gitを使ったコード管理と同様の考え方をデータベースに適用したもので、スキーマ変更を安全にテストしてから本番環境に反映できる。ChatGPT経由で「開発ブランチを作って、そこに新しいインデックスを追加して」と指示するだけで、一連の作業が実行される。
Edge Functions(エッジファンクション)
サーバーレス関数の一覧表示、デプロイ、管理を行う。Edge Functionsとは、ユーザーに近い地理的に分散したサーバー上で実行される軽量なサーバーレス関数のことで、低レイテンシでの処理が求められるAPIエンドポイントやWebhook処理に適している。ChatGPTに「新規ユーザー登録時にウェルカムメールを送信するEdge Functionを作ってデプロイして」と指示すれば、コードの生成からデプロイまでを自動で処理する。
ドキュメント検索(Documentation)
ChatGPTから直接Supabaseの公式ドキュメントを検索できる。コーディング中に詰まったとき、別タブでドキュメントを開かずに会話の流れの中で解決策を見つけられるのは、開発スピードの向上に寄与する。
29ツールのカテゴリ構成
データベース管理
■ SQL実行 ■ スキーマ設計 ■ テーブル一覧 ■ セキュリティ推奨
プロジェクト運用
■ プロジェクト作成・一覧 ■ コスト見積もり ■ 一時停止・再開 ■ リアルタイムログ
ブランチとマイグレーション
■ 開発ブランチ作成 ■ マージ ■ リベース ■ マイグレーション適用
Edge Functions
■ 一覧表示 ■ デプロイ ■ 関数管理
ドキュメント検索
■ Supabase Docsの直接検索
※各カテゴリのツール数はSupabase公式ブログの発表に基づく(2026年5月8日時点)
これらのツールは単独でも有用だが、組み合わせることで真価を発揮する。たとえば「セキュリティアドバイザーを実行して、問題があれば修正用のブランチを作成し、修正後に本番へマージして」という一連の指示を自然言語で伝えられる。従来であれば複数の画面とCLI操作を往復する必要があったフローが、1つの会話で完結する。
利用開始手順と対応プラン
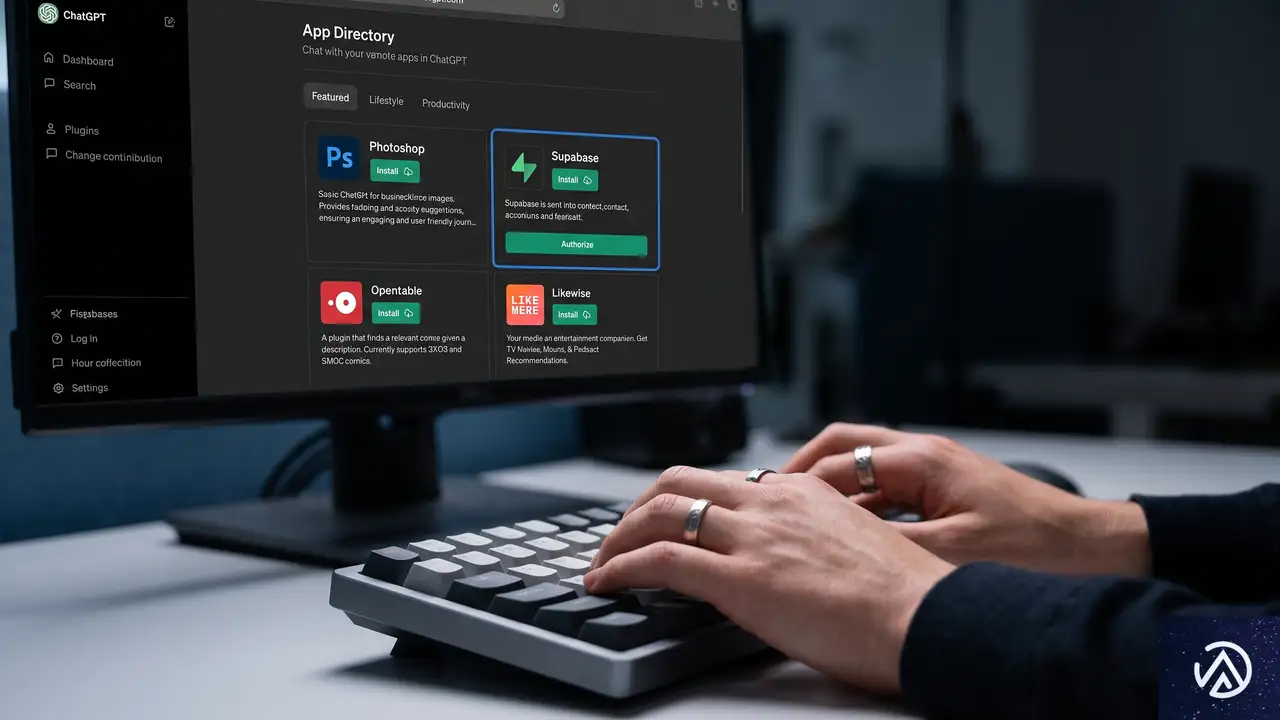
利用開始はシンプルだ。ChatGPTのアプリディレクトリで「Supabase」を検索するか、直接Supabaseのアプリページにアクセスして認証を行う。ChatGPTにSupabase組織へのアクセスを許可すれば、すぐに使い始められる。
対応しているのは全Supabaseプラン(無料プランを含む)と、ChatGPTの有料プランだ。ChatGPT側はPlus、Pro、Team、Enterpriseのいずれかの契約が必要になる。無料のChatGPTアカウントではこのアプリを利用できない点に注意したい。Supabase側に有料プランの制限はなく、無料枠のプロジェクトでも問題なく連携できる。
Supabaseアカウントをまだ持っていない場合は、supabase.comから無料でプロジェクトを開始できる。作成後、ChatGPTに接続して自然言語での管理を始める流れになる。認証にはSupabaseのアクセストークンが使用され、ChatGPTがユーザーに代わってAPIを呼び出す際の権限管理はこのトークンを通じて行われる。
ChatGPTプロジェクトとの連携で効率をさらに上げる
OpenAIが提供する「ChatGPT Projects」機能を使えば、会話のスコープを特定のSupabaseプロジェクトに固定できる。プロジェクトの参照IDをプロジェクト指示に一度設定しておくと、そのプロジェクト内のすべての会話が自動的に正しいデータベースを参照する。複数のSupabaseプロジェクトを抱えるチームでは、この設定で誤操作を防ぎつつ作業効率を高められる。
技術的な仕組みとMCPプロトコル
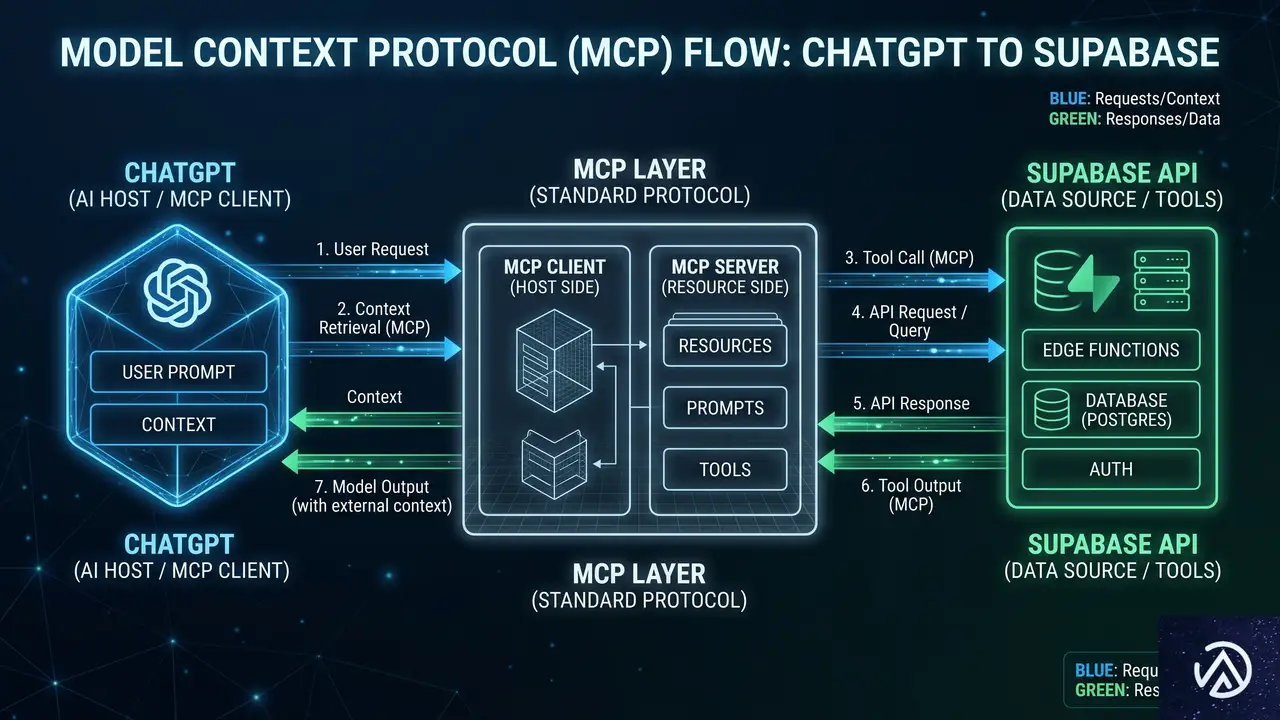
この連携の技術基盤となっているのが、MCP(Model Context Protocol)だ。MCPは2024年にAnthropicが提唱し、現在ではOpenAIを含む複数のAIプラットフォームで採用が進んでいるオープンプロトコルである。AIモデルが外部ツールやデータソースとやり取りするための共通言語のような役割を果たす。
MCPの仕組みを簡単に説明すると、AIモデルに対して「このツールはこういう機能を持っていて、こういう引数を受け取る」という定義(ツールディスクリプション)を提供する。ユーザーが自然言語で指示を出すと、AIはその定義を参照して適切なツールを選択し、必要なパラメータを推論して実行する。Supabaseの29ツールも、このMCPの枠組みに沿ってChatGPTに公開されている。
認証にはOAuth 2.0が使われており、ChatGPTがユーザーのSupabaseアカウントに代わってAPIを呼び出す際の権限は、ユーザーが許可した範囲に制限される。すべての操作はユーザーの認可の下で実行され、ChatGPTが勝手にデータベースを変更することはない。また、実行前にはChatGPTが「これからこういう操作をしますがよろしいですか」と確認を求める設計になっており、安全性にも配慮されている。
MCPによるSupabase操作の流れ
例「先月の売上を商品カテゴリ別に集計して」
「execute_sql_query」ツールを呼び出し、適切なSQLを生成
OAuth認証を通じてユーザーの権限でPostgresにクエリを発行
クエリ結果を要約してチャットで表示。必要に応じてグラフ化も提案
※実際の処理では、破壊的操作の前にChatGPTが確認を求める安全機構が働く
特筆すべきは、この仕組みが単なる「自然言語からSQLへの変換」にとどまらない点だ。ChatGPTはSupabaseから返ってきたデータを解釈し、必要に応じて追加の質問をしたり、結果をわかりやすく要約したりする。エラーが発生した場合も、ログを解析して原因を特定し、修正案を提示できる。
セキュリティと権限管理
AIにデータベースの操作権限を与えることに対する懸念は当然ある。SupabaseのChatGPTアプリでは、以下の3層の安全機構が実装されている。1つ目はOAuth 2.0によるスコープ制限で、ChatGPTがアクセスできる操作はユーザーが明示的に許可した範囲に限定される。2つ目は破壊的操作(DROP、DELETE、スキーマ変更など)の実行前確認だ。3つ目は、すべての操作がSupabaseの監査ログに記録される点で、事後的な追跡と検証が可能になっている。
国産データベースサービスとの比較と実務評価
SupabaseとChatGPTの連携は、BaaS(Backend as a Service / バックエンドをサービスとして提供する形態)市場全体に波及効果をもたらす可能性がある。現時点で国内の類似サービスには、このレベルのAI連携を実装しているものは見当たらない。国産BaaSの多くは管理画面のUI/UX改善に注力しており、自然言語による操作という発想自体がまだ新しい。
ただし、実務に導入する際にはいくつかの注意点がある。第一に、ChatGPTが生成するSQLが常に最適とは限らない点だ。複雑なJOINやサブクエリを含むクエリでは、パフォーマンスの観点から人手によるレビューが推奨される。第二に、ChatGPTの有料プランが必要なため、チーム全体で利用する場合はコストの試算が欠かせない。第三に、プロダクション環境での破壊的操作をAIに委ねることのリスクは依然として存在する。スキーマ変更やデータ削除を伴う操作は、ステージング環境でのテストを挟む運用ルールを設けるのが現実的だ。
一方で、この連携が真価を発揮するのはプロトタイピングとトラブルシューティングの場面だ。アイデアを素早く形にしたいとき、あるいは深夜の障害対応で素早く原因を特定したいときに、ChatGPT上でSupabaseを直接操作できる利便性は大きい。とくにスタートアップや少人数チームでは、開発リソースの制約を補う手段として有効に機能するだろう。
今後の展望
SupabaseがChatGPT公式アプリとなったことで、他のBaaSやクラウドサービスにもAI連携の波が広がるのはほぼ確実だ。すでにVercelやCloudflareもAIエージェントとの統合を進めており、2026年後半には「ChatGPTから操作できるクラウドサービス」が標準的な提供形態になっていく可能性がある。
開発者にとっては、コーディングの効率化だけでなく、インフラ管理や運用監視といった領域までAIがカバーする時代が目前に迫っている。Supabaseの今回の発表は、その転換点を象徴する出来事といえる。
この記事のポイント
- SupabaseがChatGPT公式アプリとして提供開始。チャットからデータベース管理が可能になった
- SQL実行、スキーマ変更、Edge Functionsのデプロイなど29種類のツールを搭載
- 全SupabaseプランとChatGPT有料プランで利用可能。無料枠のプロジェクトでも連携できる
- 技術基盤はMCP(Model Context Protocol)。OAuth 2.0による権限制御で安全性を確保
- 実務導入ではSQLの最適性確認や本番操作の運用ルール整備が推奨される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験