

Cloudflareがrobots.txtを自動生成するBot Preference Syncの仕組みと検証
Cloudflareが2026年8月21日、サイトのrobots.txtを自動生成する新機能「Bot Preference Sync」を発表した。Search、Agent、Trainingの3つのカテゴリ設定から、Cloudflareがrobots.txtの該当部分を自動的に書き換える仕組みだ。robots.txtとエッジ強制設定の矛盾を解消すると期待される。
この機能は無料プランから利用でき、新規顧客にはデフォルトでオンになる予定だ。一方でカテゴリ単位の設定には粗さがあり、個別クローラー単位のビジネス判断を表現できないという課題もある。本記事では機能の仕組みと限界、サイト運営者が取るべき対応を検証する。
robots.txtとエッジ強制の矛盾が生んだ新機能
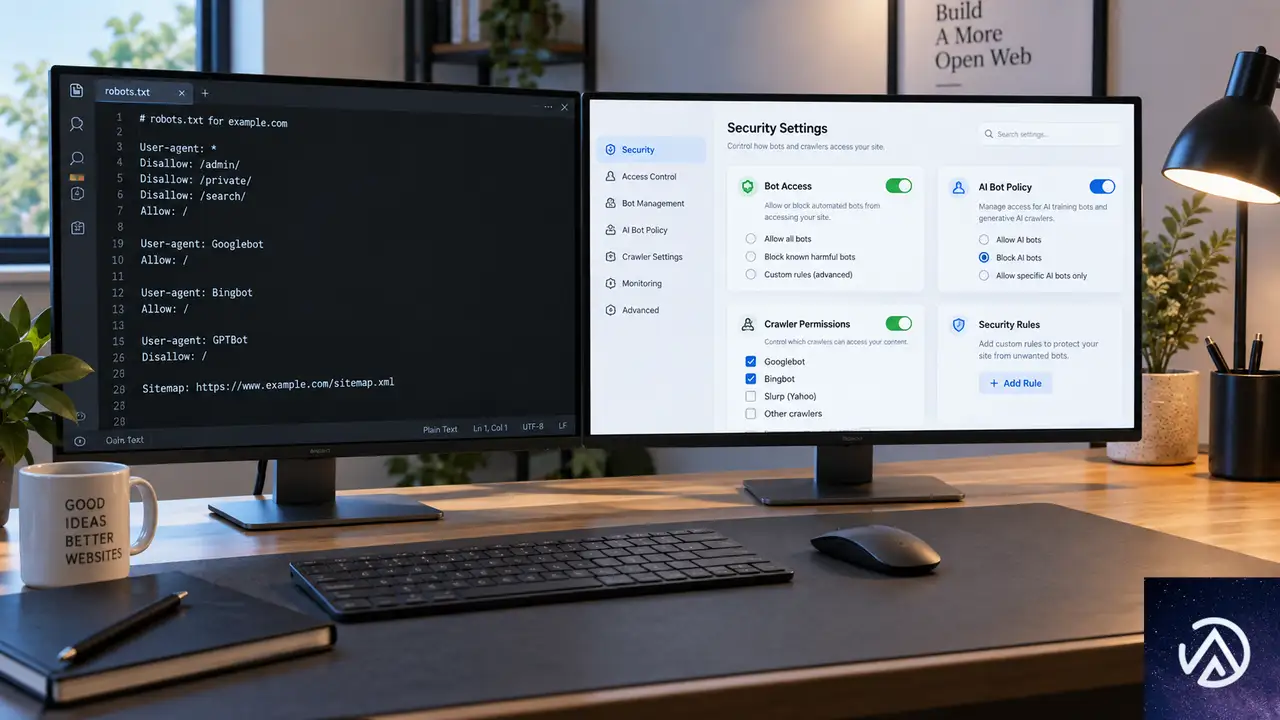
Webサイトのクローラーポリシーは2つの場所で管理される。1つはrobots.txtファイル、もう1つはWAFやCDNのエッジ側で動作するブロック設定だ。robots.txtはテキストファイルであり、クローラーへのリクエスト(お願い)を記述する。エッジ強制設定はダッシュボードで操作し、実際にHTTPリクエストを拒否する。
この2つは別々の場所で管理されるため、時間とともに矛盾が生じやすい。robots.txtは一度作成すると放置されがちで、エッジ設定は後から変更されることが多い。No Hacksの記事は、運営者自身のサイトでこの問題が発生していた例を報告している。robots.txtではBytespiderを許可する記述が数ヶ月間残っており、意図しないクローラーを歓迎する状態だったという。
CloudflareのBot Preference Syncは、この矛盾を自動的に解消する。ダッシュボードで設定したAIボットポリシーをrobots.txtに反映し、エッジ強制設定との乖離を防ぐ。Cloudflareがrobots.txtを書くという行為は、サイト運営者の代わりにポリシーを文書化することでもある。
Bot Preference Syncの仕組みと3つのカテゴリ設定
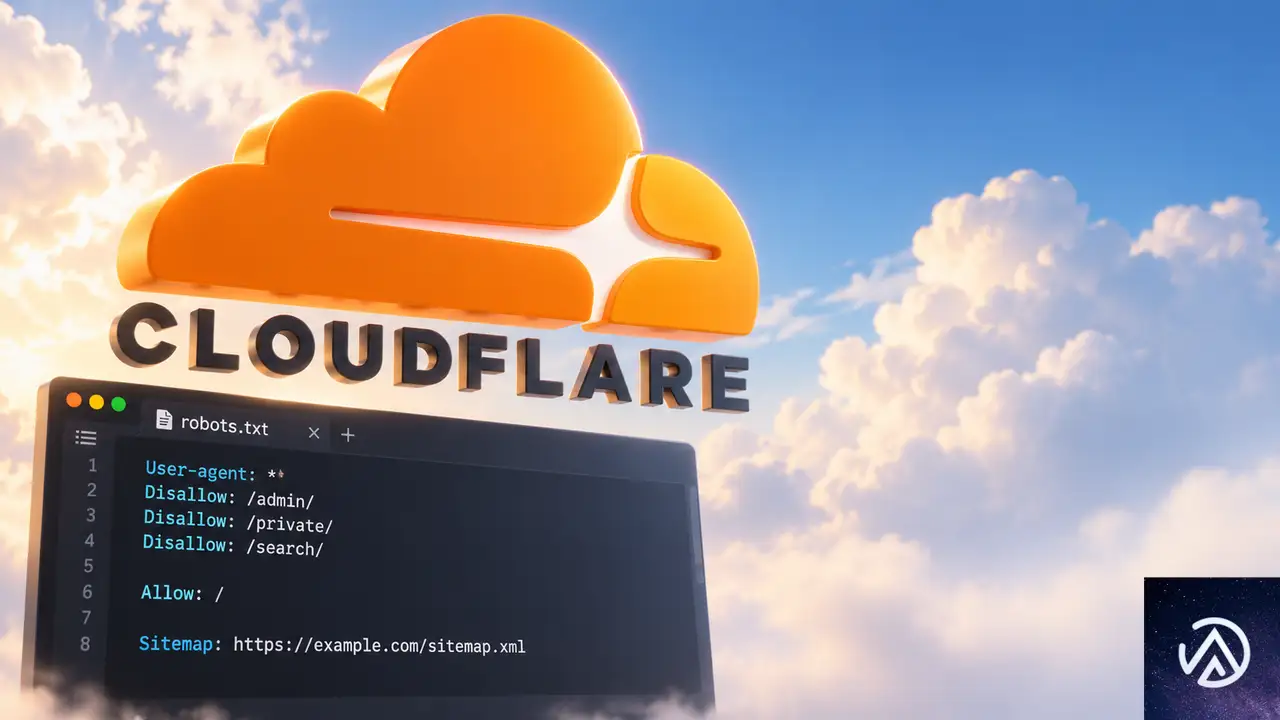
Bot Preference Syncは、セキュリティ設定の「AIボットポリシー」で設定した内容をrobots.txtに変換する。設定項目はSearch(検索)、Agent(エージェント)、Training(トレーニング)の3カテゴリだ。各カテゴリには「全ページでブロック」「広告表示ページのみブロック」「許可」の選択肢がある。
生成されたrobots.txtには、Cloudflare Bot Preference Syncの開始マーカーと終了マーカーが付与される。既存のrobots.txtコンテンツはその下に保持される。つまりCloudflareが書き込むのはマーカーの間の部分だけで、サイト運営者が手動で書いた部分は残る仕組みだ。
Bot Preference Syncは設定をrobots.txtへ反映する一連の流れを自動化する。
Cloudflareの発表によると、この機能は無料プランから利用可能で、新規顧客にはデフォルトでオンになる。ただし2026年9月13日時点では、Bot Preference Syncの公式Changelogへの記載がなく、Cloudflareのボットドキュメントにも言及がない。また一部のサイトではrobots.txtに生成ブロックがまだ現れていない。本記事は発表内容に基づく検証となる。
カテゴリ単位の設定では表現できない個別ポリシー
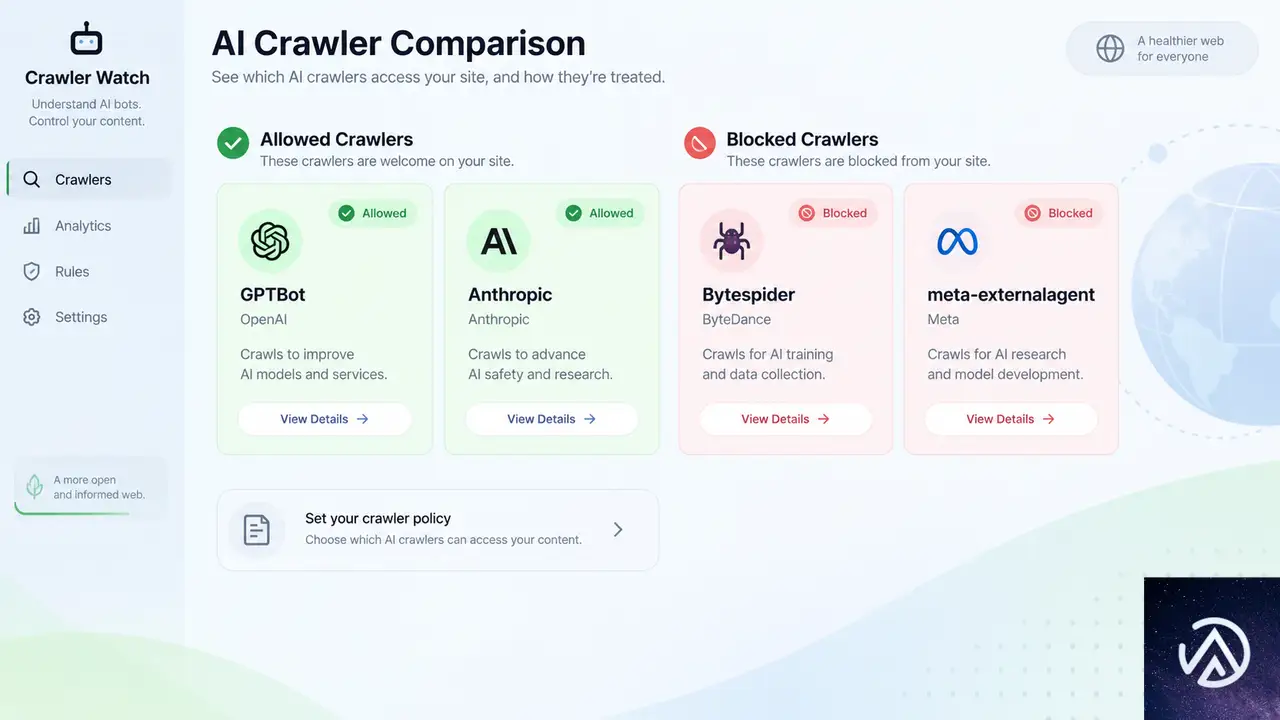
Bot Preference Syncの3カテゴリ設定は、サイト運営者のビジネス判断を必ずしも表現できない。No Hacksの記事の運営者は、OpenAIのGPTBot、Anthropicのクローラー、PerplexityBotを許可し、Bytespiderとmeta-externalagentをブロックしている。この判断は企業ごとの見返りに基づく。前者は自社ページをアシスタントの回答に表示してくれるが、後者は何も返さない、という理由だ。
このポリシーを3カテゴリ設定で表現しようとすると、矛盾が生じる。Trainingをブロックに設定すれば、許可したいGPTBotまでブロックされる。Trainingを許可に設定すれば、ブロックしたいBytespiderまで許可される。個別クローラー単位のビジネス上の決定は、カテゴリ単位の設定では表現できない。
個別クローラー単位のポリシーは3カテゴリ設定では表現できない。許可したいクローラーの扱いが、設定次第で逆転してしまう。
Cloudflareは、より細かい制御が必要な場合の対応策として、同期機能をオフにして手動でrobots.txtを管理することを挙げている。これはBot Preference Syncが万人向けではなく、カテゴリ単位の粗さを受け入れられるサイトに向けた機能だということを示している。
独自の見解として、日本のサイト運営者にもこの課題は当てはまる。コンテンツをAIトレーニングに提供する見返りを個別に評価している企業は、3カテゴリの設定では対応できない。Bot Preference Syncはあくまで「全許可」か「全拒否」に近いポリシーを持つサイト向けの省力化ツールと捉えるべきだ。
Cloudflareが公開した4つの開示条件とブロッキング
TrainingをDisallowに設定すると、robots.txtにno-training行が書き込まれる。同時に、Cloudflareが「不透明」と判断したAIクローラーがブロックされる。Cloudflareはこのブロックを回避するために、クローラーが満たすべき4つの条件を公開している。
4つの条件を満たさないクローラーは不透明とみなされ、TrainingをDisallowに設定したサイトではブロック対象となる。
条件2と条件4はGoogleを記述している。条件4についてGoogleはすでに満たしている。Googleのクローラードキュメントは、Google-ExtendedがGeminiモデルのトレーニングを制御し、検索結果への掲載やランキングシグナルには影響しないと明記している。これは条件4が求める公開声明に該当する。
一方で条件2はGoogleが答えを持っていない。条件2はAIサマリーからオプトアウトする方法を求めている。GoogleのAI機能のドキュメントによると、AI概要から除外するにはnosnippet、data-nosnippet、max-snippet、noindexのいずれかを使うことになる。しかし、これらはすべて通常の検索表示にも影響する。AI概要だけから外れて通常の検索スニペットは残す、という設定は存在しない。
Microsoftは2023年9月に条件2への回答を示している。NOARCHIVEタグを付けたコンテンツはBing Chatの回答に含まれないが、検索結果には引き続き表示される。検索インデックスから除外せず、チャットの回答からだけ除外できる仕組みだ。Cloudflareは2026年7月の記事で、BingBotとGooglebotを混合用途クローラーとしてこの条件の対象に挙げている。
CloudflareがAI企業への開示要求を明文化した点は評価できる。ただし、その条件を書いたのも執行するのもCloudflareという単一ベンダーだ。条件を読まずにダッシュボードのトグルをクリックしたサイト運営者も多い。パブリッシャーがAI企業に求めてきた説明責任は、いまやCloudflareにも向けられている。
新規顧客にデフォルト適用される意味とリスク
2026年9月15日から、Cloudflareは新規ドメインのデフォルト設定を変更する。広告を表示するページではTrainingとAgentがブロックされ、Searchは許可される。オンボーディング時に「広告付きページで収益化している」を選択すると、TrainingがDisallowに自動設定される。
これはビジネスモデルに関する質問であり、その回答がrobots.txt上のAIトレーニングに関する公開ポジションになる。広告収益に依存するサイトは、AIトレーニングを拒否する立場を自動的に表明することになる。サイト運営者がこの設定を認識していなければ、意図しないポジションが公開され続ける。
リスクが大きいのは、robots.txtを二度と開かず、自分の代わりに書かれたポジションを読まないサイトだ。Cloudflareはすでにアナリティクススクリプトを無料プランのサイトにデフォルトで書き込んでいる。同じオンデフォルトのパターンがrobots.txtにも及ぶ。サイト運営者が設定を確認しなければ、AIトレーニングに関する自社の立場を外部ベンダーに委ねることになる。
SEO担当者の観点では、このデフォルト変更を黙認してはいけない。自社サイトがAIトレーニングを拒否しているのか許可しているのかは、AI時代の検索戦略を左右する。デフォルト設定のまま放置するのではなく、自社のビジネスモデルに合わせて意図的に選択することが重要だ。
robots.txtが守れる範囲と守れない範囲
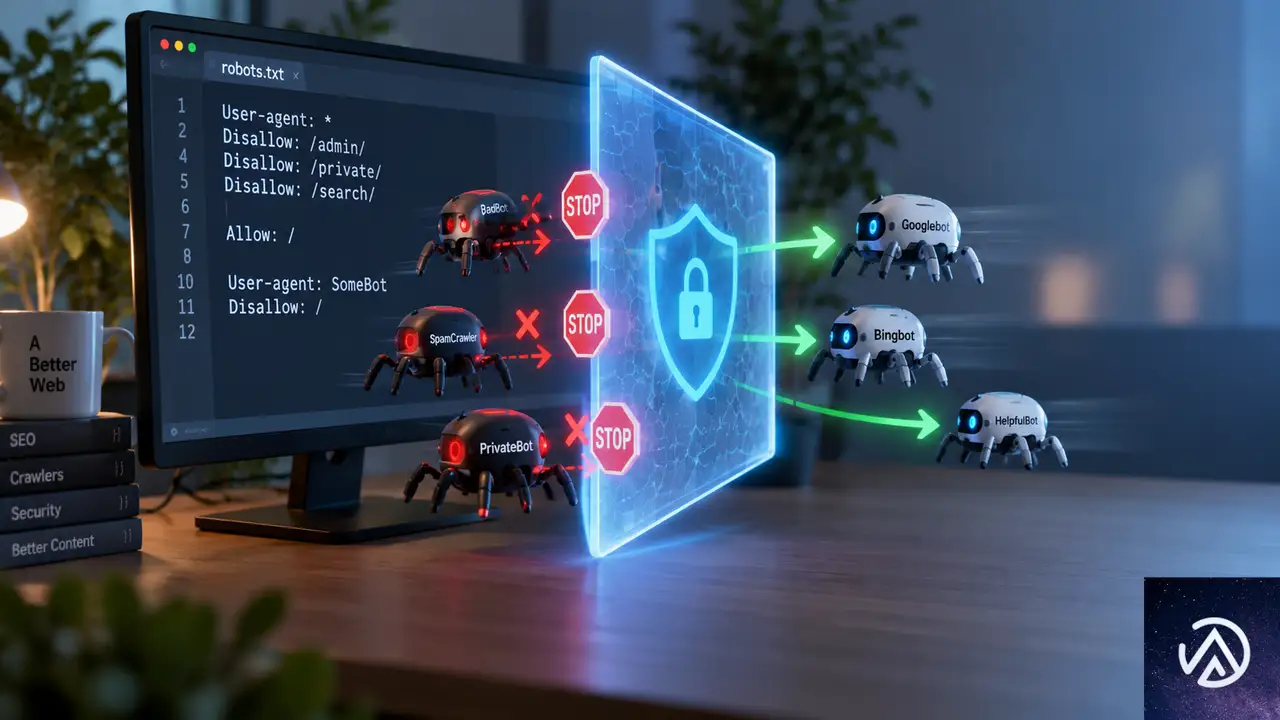
robots.txtのルールは、停止することを選ぶクローラーを停止させるだけだ。ルールを無視するクローラーには何も影響しない。No Hacksの記事は、同サイトのログで最大のAIクローラーが認証情報を探していたと報告している。非営利研究アーカイブの名前を使い、/.envやSSHキーを要求するクローラーがいたという。テキストファイルのルールはそのようなクローラーを不便にさせることすらできない。
それでもBot Preference Syncは有用だ。インターネットの誠実な側、つまりルールを守るクローラーに対しては機能する。エッジでの強制が実際の防御であり、robots.txtは意図の文書化として、後から紛争になった時に意味を持つ。リクエストが到着した瞬間の防御にはならないが、自社のポリシーを明確に残しておく価値はある。
最終的には、robots.txtとCloudflareのAIボットポリシーを突き合わせて確認する作業が欠かせない。Bot Preference Syncが自サイトに到達したら、書かれた内容を必ず確認すること。読んでいないポリシーファイルは、他人が自分の代わりに表明した立場になる。
この記事のポイント
- CloudflareのBot Preference Syncはrobots.txtとエッジ強制設定の矛盾を解消する自動化機能である
- Search、Agent、Trainingの3カテゴリ設定では個別クローラー単位のビジネス判断を表現できない
- Cloudflareは4つの開示条件を公開し、不透明なクローラーをブロック対象にした
- 新規顧客にはデフォルトでオンになり、広告収益化サイトではTrainingがブロックされる
- robots.txtは誠実なクローラーにしか効かないため、エッジ強制が依然として重要である

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
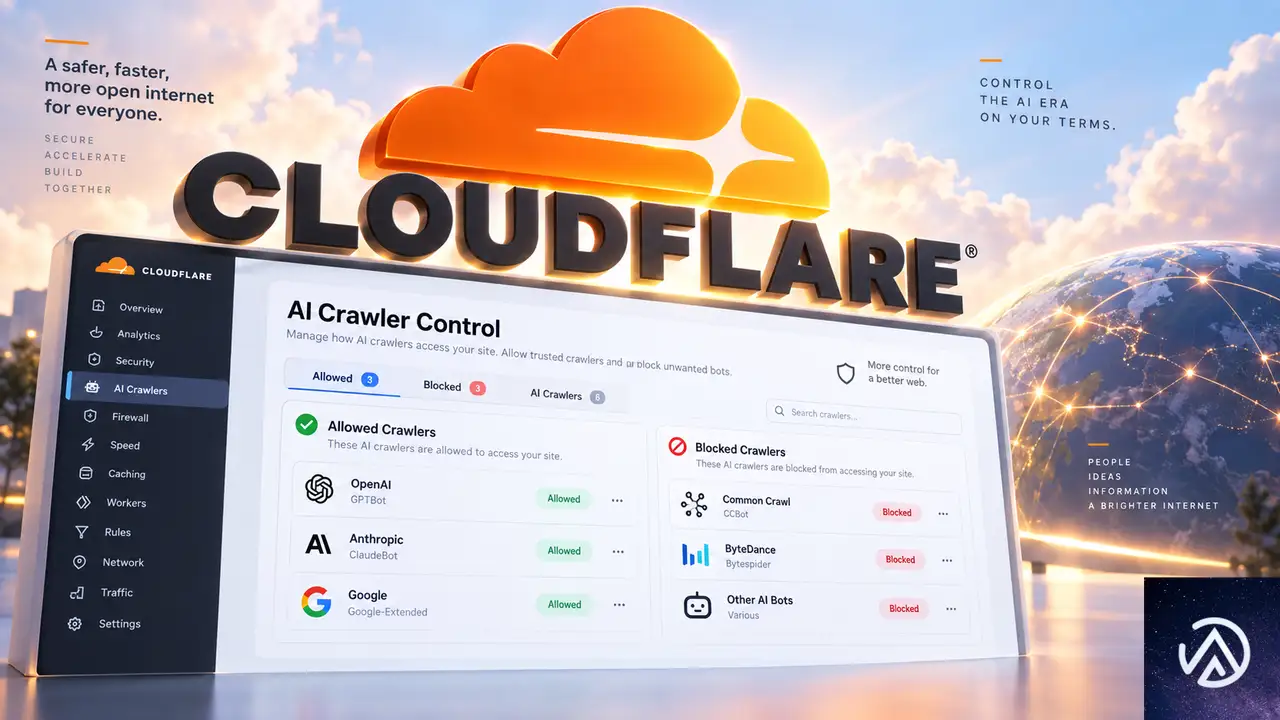
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
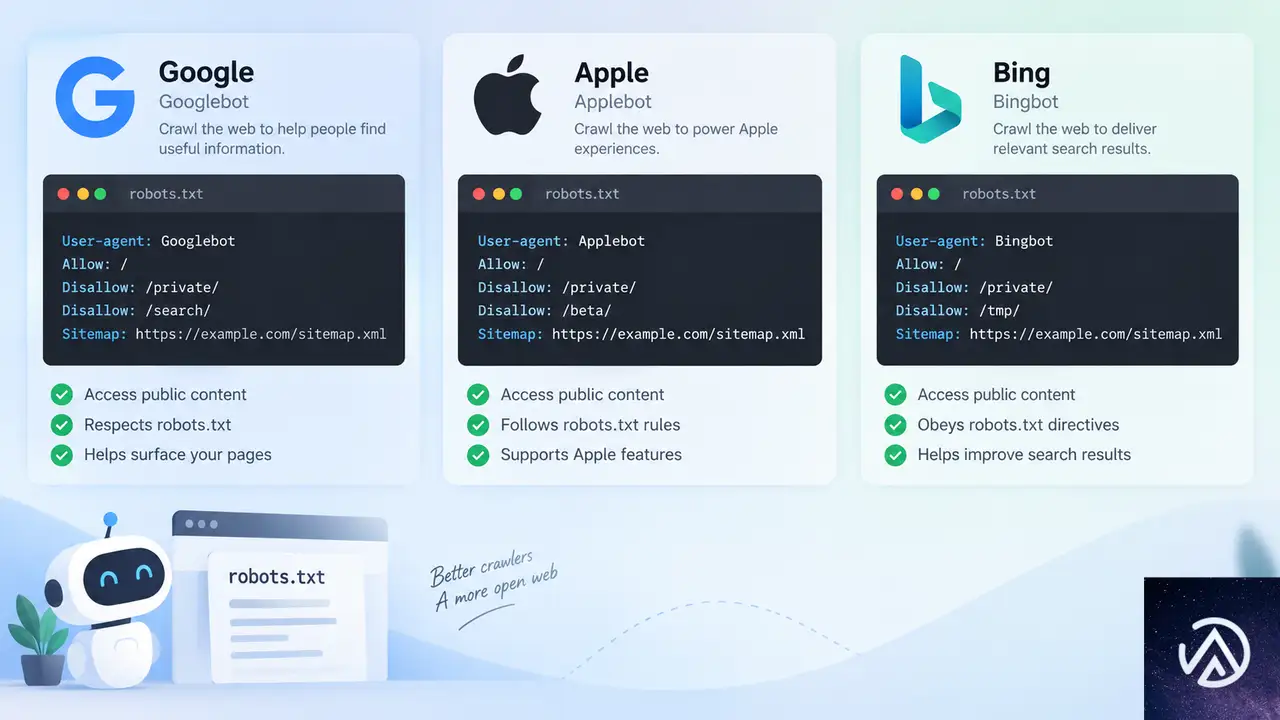
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleがrobots.txtを無視する理由とSEOへの悪影響を解説
GoogleのJohn Mueller氏が、robots.txtに関する見落としがちな設定ミスについて回答した。このミスは、SEOやサイトのインデックス目標に悪影響を及ぼす可能性があり、特に検索ボックススパムへの対策を複雑化させる。なぜrobots.txtが正しく機能しないのか、その根本原因と具体的な解決策を解説する。
「無視されるrobots.txt」が生まれる仕組み
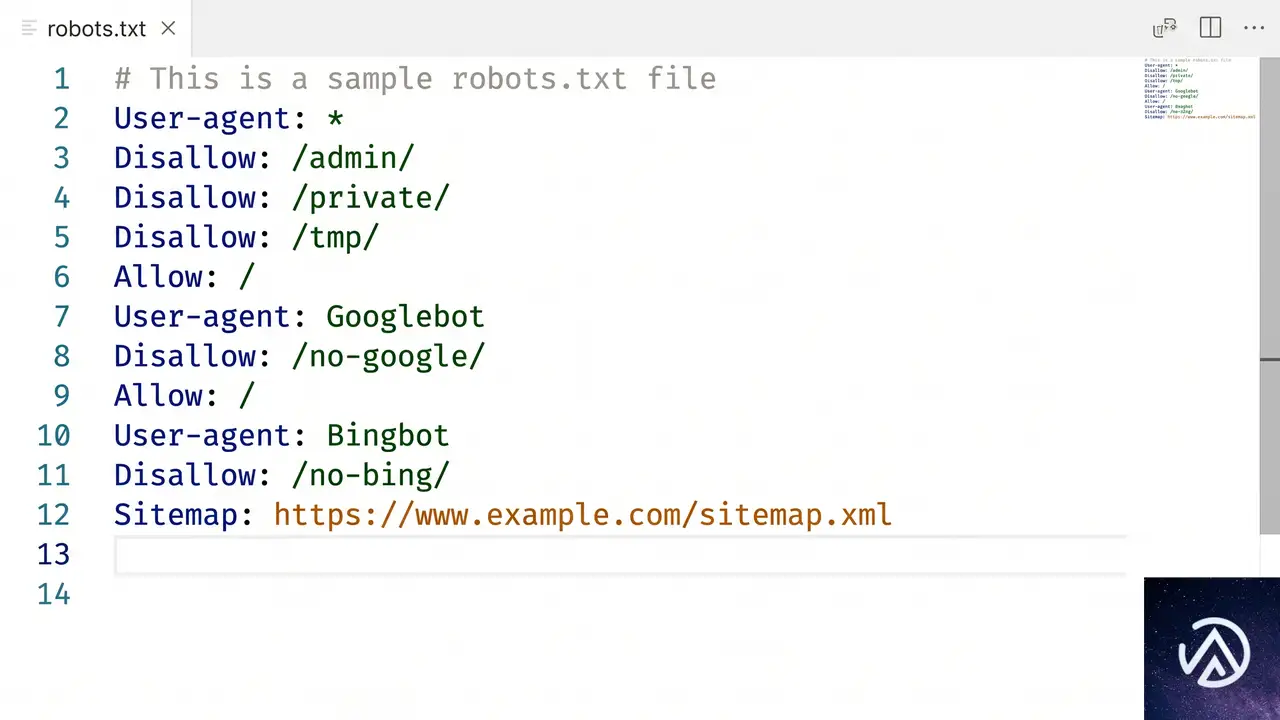
robots.txtは、検索エンジンのクローラーに対して「どのページをクロールしてよいか」を指示するためのファイルだ。しかし、設定の書き方を誤ると、その指示が完全に無視され、意図しないページがGoogleにインデックスされる事態を引き起こす。
Disallow: /search
Disallow: /private
Disallow: /admin
Disallow: /search
Disallow: /private
Disallow: /admin
Disallow: /
User-agent別ルールと優先順位の落とし穴
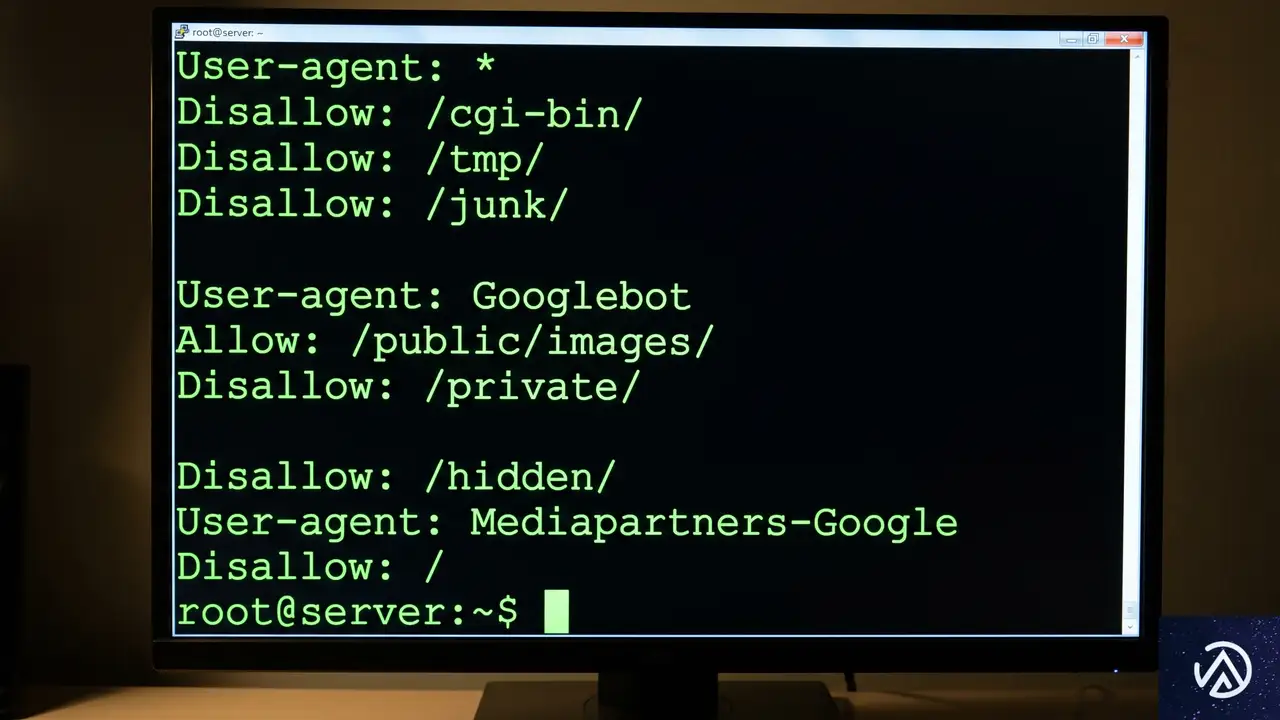
問題の核心は、robots.txtの「より具体的なルールが優先される」という仕様にある。一般的なクローラー向けの User-agent: * セクションと、Googlebot専用の User-agent: googlebot セクションが同じファイル内に存在する場合、Googlebotは自身に直接関係するセクションのみを参照する。
Search Engine Journalの記事によると、あるShopifyサイトでは検索ボックススパム対策として Disallow: /search を User-agent: * 内に記述していたが、別途 User-agent: Googlebot セクションが存在したため、この禁止指示がGooglebotに無視されていた。結果として、スパムによって生成されたURLがGoogleのインデックスに残り続けることになった。
これはrobots.txtの設計に起因する合理的な動作だ。特定のクローラーにだけピンポイントで指示を出し、それ以外のクローラーには別のルールを適用できる柔軟性を持たせるための仕組みである。しかし、この「柔軟性」が、設定の分断と見落としを生み出す。
■ クローラーの動作
■ 発生した問題
robots.txtが制御するのは「クロール」であって「インデックス」ではない
もう一つの重要な前提として、robots.txtはページのクロールを制御するものであり、インデックスを直接制御するものではない。robots.txtでブロックしたページでも、何らかの理由でGoogleがそのURLを知り得た場合、コンテンツをクロールせずにインデックスすることがある。この仕様は、robots.txtだけに依存したインデックス制御が根本的に不完全であることを示している。
robots.txtとnoindexの正しい使い分け

インデックスそのものを確実に防ぎたい場合、robots.txtよりも meta robots タグによる noindex 指定の方がはるかに効果的だ。robots.txtはドアの前に立つ警備員のようなもので、部屋の中のものを「知らない」ままでいられるが、部屋の存在自体を消し去ることはできない。noindex は、その部屋に「公開禁止」の札を貼るようなもので、検索エンジンに直接「これを検索結果に表示しないでほしい」と伝える。
Disallow: /search
noindexを確実に適用するための注意点
noindex を適用する際、robots.txtでそのページをクロール禁止にしてしまうと、Googlebotはそもそもそのページを読みに行けず、noindex タグを発見できない。結果として、いつまでもインデックスから削除されないという、本末転倒な事態を招く。クロールを許可した上で、noindex を指示することではじめて、意図したインデックス制御が機能する。
ShopifyとWordPressにおける具体的な対策
検索ボックススパムは、どのようなCMSでも発生しうる問題だが、幸いShopifyとWordPressの両方には、比較的簡単に実装できる緩和策が用意されている。
Shopifyでの検索ページnoindex設定
Shopifyでは、テーマの theme.liquid ファイルを編集することで、すべての検索結果ページに自動で noindex タグを追加できる。これにより、スパムクエリによって生成された無意味なページが検索結果に表示されることを防ぐ。
{% if template contains 'search' %}
  <meta name="robots" content="noindex">
{% endif %}
このコードをテーマの <head> セクションに追記するだけで、すべての検索ページへのnoindex適用が完了する。robots.txtによる制御と異なり、検索結果ページのURLを確実にインデックスから除外できるため、より根本的なスパム対策となる。
WordPressでの検索スパム対策
WordPress環境では、主要なSEOプラグインを導入するだけで検索結果ページへの noindex がデフォルトで有効になる。Yoast SEO、Rank Math、All In One SEO Packといったプラグインは、インストールしたその日から検索スパムに対する基本的な防御壁として機能する。
さらに、Diviをはじめとする一部のテーマやページビルダーは、スパムワードを含む検索クエリに対して、結果を表示する代わりに「該当する結果がありませんでした」というメッセージを返す仕組みを備えている。これにより、スパムURLそのものが生成されにくくなるという副次的な効果も期待できる。
robots.txtの正しい知識がサイトを守る
robots.txtは強力なツールだが、その仕様を正しく理解していないと、かえってサイトの健全性を損なう原因になりうる。特に、User-agent別のルールの優先順位や、クロール制御とインデックス制御の違いといった基礎知識は、サイト運営者にとって必須のリテラシーと言える。
この記事のポイント
- robots.txtでUser-agent: Googlebotの専用セクションがあると、一般的なUser-agent: *のルールはGooglebotに無視される。
- robots.txtはクロールの制御であり、確実なインデックス除外にはmeta robotsタグのnoindex指定が必要。
- 検索ボックススパム対策には、robots.txtよりnoindexの方が根本的な解決策となる。
- ShopifyやWordPress(SEOプラグイン利用)では、テンプレートや設定を少し修正するだけで検索スパムを効果的に緩和できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google-Agent登場、AIがユーザー代理でWebを閲覧する時代へ
Webサイトを訪れるのは人間だけではなくなった。2026年3月20日、Googleは公式のフェッチャーリストに「Google-Agent」という新たな項目を追加した。これはクローラーでもなければ、学習用のボットでもない。ユーザーの指示で動くAIエージェントだ。
AIアシスタントに「この商品をリサーチして」「最安値のサイトを比較して」と頼む場面を想像してほしい。そのとき実際にサイトを訪問し、情報を読み取り、フォームを操作するのがGoogle-Agentである。Googleの実験的ブラウジングツール「Project Mariner」が最初の採用例となる。
これまでのSEOは「クローラーにどう読まれるか」が主眼だった。しかし今回の発表で、Web運営者は「ユーザーの代わりに行動するAI」という第三の訪問者像を明確に意識せざるを得なくなった。
Google-Agentが従来のクローラーと根本的に異なる点

GooglebotはWeb全体を巡回し、検索インデックスを構築する自動プログラムだ。一方、Google-Agentが発動する条件はただ一つ、人間がAIに「調べて」と依頼したときである。この「ユーザートリガー」という性質が、あらゆるルールを塗り替える。
robots.txtは通用しない
GoogleはGoogle-Agentを「ユーザートリガーフェッチャー」に分類している。Google Read Aloud(テキスト読み上げ)やNotebookLM(文書分析)、Feedfetcher(RSS)と同じカテゴリだ。いずれも「人間がリクエストを起こした」という共通点がある。Googleの公式見解は明快で、ユーザートリガーフェッチャーは「原則としてrobots.txtを無視する」としている。
考え方はシンプルだ。ChromeのアドレスバーにURLを入力して開くとき、ブラウザはrobots.txtの内容に関係なくページを取得する。Google-Agentはユーザーの代理であり、自律型クローラーではない。したがって同じ理屈が適用される。
この判断はOpenAIやAnthropicのアプローチと明確に異なる。ChatGPT-UserやClaude-Userはいずれもユーザートリガーフェッチャーでありながら、robots.txtの指示に従う仕様だ。robots.txtでブロックすれば、ユーザーに頼まれてもページを取得しない。Googleはそこに別の線を引いた形になる。
robots.txtを万能のアクセス制御手段と考えていたサイト運営者にとって、これは大きな認識転換になる。Google-Agentを拒否したい場合は、サーバーサイドの認証やIP制限など、人間の訪問者をブロックするのと同じ手段を採る必要がある。
暗号認証「Web Bot Auth」がもたらす信頼性

Google-Agentの発表でより重要なのは、付随する技術的布石だ。公式ドキュメントの一行に、Google-Agentが「web-bot-auth」プロトコルの実験に参加していることが記されている。識別子は「https://agent.bot.goog」である。
デジタルパスポートの仕組み
Web Bot AuthはIETF(インターネット技術標準化委員会)で策定が進む標準規格である。簡単に言えば、ボットのためのデジタルパスポートだ。各エージェントは秘密鍵を持ち、公開鍵をディレクトリに登録する。そして全てのHTTPリクエストに暗号署名を付与する。
Webサイト側はその署名を検証することで、訪問者が名乗る通りの存在であることを暗号学的に確認できる。ユーザーエージェント文字列は誰でも偽装できるが、Web Bot Authの署名は偽装できない。この差は決定的だ。
すでにAkamai、Cloudflare、AmazonのAgentCore Browserがこのプロトコルをサポートしている。Googleの参入は、標準化に向けたクリティカルマス(臨界量)の獲得を意味する。
なぜこの仕組みが今必要なのか
Webは深刻なアイデンティティ問題に直面しつつある。AIエージェントのトラフィックが増えるほど、正規のエージェントと、エージェントを装うスクレイパーを区別する必要が高まる。IPアドレスによる検証は有効だが、暗号署名のほうが大規模にスケールしやすく、なりすましも極めて難しい。
Google-AgentへのWeb Bot Auth導入は実験段階だが、エージェント認証の方向性を強く示す一手とみられている。Search Engine Journalの記事でも、この暗号認証こそがGoogle-Agent発表の最も重要な要素だと指摘されている。
Webサイト運営者が今すべき具体的対応

Google-Agentの登場で、Webの訪問者モデルは3層構造として明確化された。人間が直接ブラウジングする層、GooglebotやGPTBotのようにコンテンツをインデックスするクローラー層、そして特定の人間の指示でリアルタイムにタスクを実行するエージェント層である。それぞれに異なるアクセスルールと目的がある。
この3層構造を前提に、運営者が取るべき現実的な対策は以下の通りだ。
サーバーログの監視を始める
Google-Agentはユーザーエージェント文字列に「compatible; Google-Agent」を含む。Googleは検証用のIPレンジも公開している。まずは自社サイトにどの程度の頻度でエージェントが訪れているか、どのページを標的にしているか、何を試みているかを把握することが出発点になる。
CDNとファイアウォールの設定を確認する
非ブラウザトラフィックを積極的にブロックするセキュリティ設定を導入している場合、Google-Agentがサーバーに到達する前に拒否されている可能性がある。公開されているIPレンジが許可リストに含まれているか、確認しておくべきだ。
フォームや予約フローの検証
Google-Agentはフォームの送信や複数ステップのフロー操作も行う。チェックアウト、予約、問い合わせといった機能がJavaScriptに過度に依存していると、エージェントが正常に処理できず、裏側で静かに失敗しているケースが生じる。セマンティックなHTMLと明確なラベル設計が、これまで以上に重要になる。
robots.txtは完全なアクセス制御手段ではないと認識する
robots.txtはクローラー向けに設計された仕組みであり、エージェントの時代には通用しない場面が増える。どうしてもアクセスを制限すべきコンテンツには、認証を導入する必要がある。境界線の引き直しが求められている。
ハイブリッドWebはすでに始まっている

1年前まで、AIエージェントが人間と並んでWebサイトを閲覧する未来はカンファレンスの予測トークに過ぎなかった。しかし今、その存在にはユーザーエージェント文字列があり、公開されたIPレンジがあり、暗号認証プロトコルがあり、Googleの公式ドキュメントへの記載がある。
Webは人間用と機械用に分岐しなかった。融合したのだ。公開する全てのページは、人間とエージェントの両方に同時にサービスを提供している。Googleが可視化したのは、その非人間のオーディエンスがいつ現れたかを正確に把握できる手段である。
Search Engine Journalの記事は、この動きを「SEO史上最大の意識改革」と位置づけている。誇張ではない。検索エンジンにどう読まれるかだけでなく、「ユーザーの代理としてやってくるAI」にどう対応するかが、これからのWeb運営の新たな基軸になる。
この記事のポイント
- Googleがユーザー代理でWebを閲覧する新フェッチャー「Google-Agent」を公開、Project Marinerが最初の採用例
- ユーザートリガーフェッチャーに分類されるためrobots.txtは原則無効、アクセス制御にはサーバー認証が必要
- 「Web Bot Auth」暗号認証プロトコルを実験導入中、エージェントのなりすまし防止を狙う
- Web訪問者は「人間」「クローラー」「エージェント」の3層構造へ移行、各層で対応が異なる
- サーバーログ監視、CDN設定確認、フォームのセマンティックHTML対応が即時の実務対策となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google検索結果の「続きを読む」リンク表示を増やす3つの法則!robots.txtドキュメント拡充と最新SEO動向
Googleが検索結果の表示をより詳細にする「続きを読む(Read more)」ディープリンクのベストプラクティスを公開した。これは検索結果のスニペット内に、ページ内の特定セクションへ直接ジャンプできるリンクを表示させるための指針だ。これまで経験則で語られてきた部分が、公式ドキュメントによって明確化された形となる。
あわせて、robots.txtのドキュメント拡充や、EUでのAIチャットボットに対するデータ共有規制、さらには検索画面上でタスクを完結させる新機能についても動きがある。2026年4月の最新情報を踏まえ、Webサイト運営者が今取り組むべき構造改革について解説する。
これらのアップデートは単なる表示の変化ではなく、Googleが「AIエージェントにとって読みやすい構造」をWebサイトに求めていることの表れだ。サイトの構造が古いままでは、検索結果での露出機会を大きく損なう可能性がある。技術的な背景とともに、具体的な対策を確認していこう。
Google検索のディープリンク表示を増やす3つの鉄則
Googleは検索結果のスニペット(説明文)の下に表示される「続きを読む」リンクについて、その出現率を高めるための具体的な方法を明らかにした。ディープリンクとは、ページ全体ではなくページ内の特定の章や節に直接ユーザーを誘導するリンクのことだ。これが表示されると、検索結果の占有面積が増え、クリック率の向上が期待できる。
コンテンツはページ読み込み時に即座に表示させる
最も重要なポイントは、ユーザーがページを開いた瞬間にコンテンツが人間にとって可視化されていることだ。クリックしないと中身が見えない「折りたたみ式(アコーディオン)」や「タブ切り替え」の中に重要な情報を隠している場合、ディープリンクとして採用される確率は下がる。Googleは、ユーザーの操作なしにレンダリングされる情報を優先して評価している。
これは「隠れたテキスト」がインデックスされないという意味ではないが、検索結果の拡張機能(リッチスニペットやディープリンク)においては、露出の優先度が低くなることを示唆している。特にモバイルユーザー向けに情報をコンパクトにまとめようとして、重要な見出しや本文をアコーディオン内に閉じ込める設計には注意が必要だ。
H2やH3の見出しタグを適切に活用する
ディープリンクのリンク先となるセクションには、必ず <h2> や <h3> といった見出しタグを使用する必要がある。Googleのシステムは、これらの見出しをページの構造的な区切りとして認識し、リンクのアンカー(目的地)として利用するからだ。
また、検索結果に表示されるスニペットのテキストと、実際のページ内の見出しや本文の内容が一致していることも条件となる。見出しが画像だけで構成されていたり、装飾目的で <div> タグにスタイルを当てただけの「見出し風」のデザインになっていたりすると、Googleはそこをセクションの開始点として正しく認識できない。
UIデザインのBeforeとAfter比較
ディープリンクが表示されにくい構造(タブ・アコーディオン)と、表示されやすい構造(フラットな見出し構成)を比較してみよう。以下のデモは、コンテンツの露出度による構造の違いを視覚化したものだ。
このデモのように、すべての主要コンテンツがページロード時に露出している構成の方が、Googleは各セクションをディープリンクとして採用しやすくなる。ユーザーの利便性を損なわない範囲で、情報の「隠しすぎ」を避けることが重要だ。
robots.txtの公式ドキュメント拡充とスペルミスへの寛容さ
GoogleのGary Illyes(ゲイリー・イリェーシュ)氏とMartin Splitt(マーティン・スプリット)氏は、ポッドキャスト「Search Off the Record」にて、robots.txtに関する新たなプロジェクトについて語った。Googleは現在、HTTP Archiveのデータを分析し、実際に世界中のサイトで使用されているrobots.txtの記述パターンを調査している。
非サポートルールの明文化
robots.txtには、Googleが公式にサポートしていない独自の命令(ディレクティブ)が記述されているケースが多々ある。例えば、クロールの頻度を指定する Crawl-delay や、特定の条件下でのみ適用されるカスタムルールなどだ。Googleは今回の分析に基づき、よく使われているが実際にはGoogleが無視している「非サポートルール」のトップ10から15をドキュメントに追加する予定だ。
これにより、Webサイト運営者は「自分が設定しているルールがGoogleに効いているのか」を正確に判断できるようになる。もしGoogleがサポートしていないルールに頼ってクロール制御を行っている場合、それは期待通りに機能していない可能性が高い。公式ドキュメントが更新された際には、自サイトのrobots.txtを改めて監査する必要があるだろう。
記述ミスの自動補完が進む可能性
さらに興味深い点として、Googleのrobots.txtパーサー(解析機)が、記述のスペルミスをより柔軟に受け入れるようになる可能性が示唆された。例えば disallow を dissallow と書き間違えた場合でも、Googleがそれを意図通りの命令として解釈してくれるようになるかもしれない。
ただし、これはあくまで「Googleが親切に解釈してくれる」という話であり、ミスを放置してよいという意味ではない。他の検索エンジン(Bingなど)が同様の寛容さを持っているとは限らないからだ。robots.txtはサイトの立ち入り禁止区域を指定する「地図」のようなものだ。記述ミスがあれば、検索エンジンにインデックスさせたくないページが公開されてしまうリスクがある。基本的には、標準的なスペルを厳守すべきだ。
EUのデータ共有規制がAIチャットボットに波及
欧州委員会(EC)は、デジタル市場法(DMA)に基づき、Googleに対して検索データを競合他社と共有するよう求める予備的な見解を示した。この規制の対象には、従来の検索エンジンだけでなく、特定の条件を満たす「AIチャットボット」も含まれる見通しだ。
AIチャットボットが「検索エンジン」として定義される日
これまでSEO業界では、Googleのような検索エンジンと、ChatGPTやPerplexityのようなAIチャットボットを別物として扱ってきた。しかし、EUの規制当局は「オンライン検索エンジン」の定義を広げ、AIチャットボットもその範疇に含める動きを見せている。これが確定すれば、Googleが持つ膨大なランキングデータやクリックデータが、競合するAIサービスに提供されることになる。
この変化は、EU圏内での検索市場の流動性を高める可能性がある。Googleのデータを活用して精度を高めたAIチャットボットが普及すれば、ユーザーの検索行動はさらに分散するだろう。Webサイト運営者にとっては、Googleだけでなく「AIチャットボットからどう参照されるか」という視点が、法規制の面からも裏付けられた重要な課題となる。
匿名化された検索シグナルの行方
共有されるデータは匿名化されるものの、ランキング、クエリ、クリック、閲覧データといった核心的な情報が含まれる。これにより、新興のAI検索サービスが「どのコンテンツがユーザーに支持されているか」をより正確に把握できるようになる。日本国内のサイトであっても、EUからのアクセスがある場合は、これらのデータ共有の影響を間接的に受けることになるだろう。
検索結果でタスクを完結させる新機能の追加
Googleは検索結果画面(SERP)上で直接ユーザーの目的を達成させる「タスクベース」の機能を強化している。その一環として、特定のホテルの価格下落を追跡できるトグルスイッチが導入された。これは、ユーザーがホテル予約サイトへ移動することなく、Google内で価格監視を開始できる機能だ。
Webサイトへの流入機会が「Google内」に吸収される
これまで、価格下落通知は旅行予約サイトや比較サイトが提供する主要なサービスの一つだった。Googleがこの機能を検索結果に直接組み込むことで、ユーザーが各サイトを再訪する動機が減少する可能性がある。GoogleのSundar Pichai(サンダー・ピチャイ)CEOが語っていた「エージェントとしての検索」が、着実に具現化していると言える。
この変化への対策として、ホテルなどのサービス事業者はGoogleビジネスプロフィールの情報を最新に保ち、Googleのフィードに対して正確なデータを提供し続ける必要がある。検索結果が単なる「リンク集」から「実行プラットフォーム」へと進化する中で、プラットフォームとのデータ連携の重要性はかつてないほど高まっている。
AIエージェントの起動ボタン
また、Googleの「AIモード」から直接AIエージェントを起動し、複雑なタスクを委任できる機能もテストされている。例えば「旅行の計画を立てて予約まで進める」といった一連の動作を、AIが代行する仕組みだ。この際、AIがどのWebサイトの情報をソース(情報源)として採用するかは、前述した「ディープリンクのベストプラクティス」のような構造化された情報の有無に左右される。
AIエージェントは、人間と同じようにWebページを「読み」に行く。その際、Javascriptの実行や複雑なクリック操作を必要とするページよりも、シンプルで見出し構造が明確なページを好む。検索がタスク完結型になればなるほど、Webサイトは「人間が見る場所」であると同時に「AIがデータを取得するAPI」のような役割を求められるようになるのだ。
この記事のポイント
- 「続きを読む」リンクを表示させるには、コンテンツをアコーディオンやタブに隠さず、ページロード時に露出させることが重要だ。
- 適切な見出しタグ(H2、H3)を使用し、検索スニペットとページ内容の整合性を保つことで、ディープリンクの採用率が高まる。
- robots.txtの公式ドキュメントが拡充され、Googleがサポートしていないルールの実態が明確になるため、定期的な記述の監査が推奨される。
- EUの規制によりAIチャットボットが「検索エンジン」として扱われ始め、Googleの検索データが競合AIに共有される道が開かれつつある。
- Google検索は「情報を探す場所」から「タスクを完結させる場所」へ進化しており、WebサイトにはAIエージェントが読み取りやすい構造が求められている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験