

Shopifyが全AIショッピングチャネルに自動登録。デフォルト設定の全容
Shopifyが2026年1月から、対象ストアを新しいAIショッピングチャネルへ自動登録する仕組みを本格稼働させている。2026年9月8日のMeta「Muse」ローンチ当日には、対象ストアの商品情報が即座にMetaへ共有された。
現在、ChatGPT・Google・Microsoft Copilot・Metaの主要4チャネルでAIエージェント経由の販売が可能だ。チャット内で決済まで完了する「ダイレクトチェックアウト」もデフォルトで有効になっている。
この記事では自動登録の仕組み、ダイレクトチェックアウトの影響、アナリティクス計測で発生する盲点、停止手順までを解説する。
ShopifyのAIショッピングチャネル自動登録の仕組み
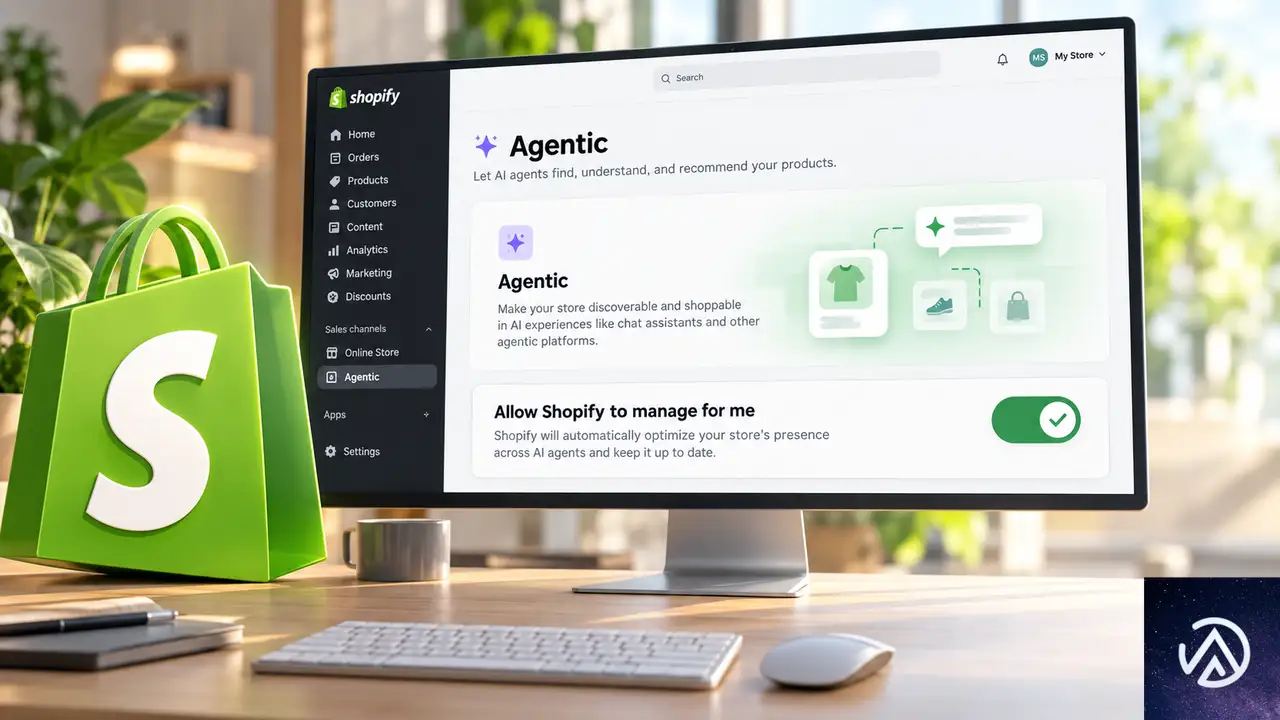
このデモは「Shopifyに管理を任せる」設定のオン・オフで表示がどう変わるかを示している。オフにすると3つの独立したスイッチが現れ、細かな制御が可能になる。
Shopify管理画面の「販売チャネル → Agentic」ページには「Allow Shopify to manage for me(Shopifyに管理を任せる)」という設定がある。この設定がオンの場合、Shopifyは対象ストアを新しいAIショッピングチャネルへ自動で登録する。デフォルトで有効だ。
Shopifyの公式ドキュメントによると、この設定では次の3つが自動的に行われる。Shopify Catalogを通じた商品アクセスの提供、関連チャネルでのダイレクトチェックアウトの有効化、新しいエージェンティックストアフロントチャネルへの自動登録だ。
Shopify Catalogは、多くのAIアプリが商品リストを取得する仕組みだ。Googleは例外で、Google Merchant Centerから商品情報を読み取る。
自動登録の最初の大規模適用は2026年1月12日に実施された。その後2026年9月8日のMeta「Muse」ローンチ時に、対象ストアの商品が即座にMetaへ共有された。MuseはMetaのAIエージェントで、ブラウザの操作やフォーム入力、価格交渉まで行える。2026年9月20日には、AmazonがMuseを自社ストアからブロックしている。Shopifyの自動共有からわずか12日後のことだ。
自動登録の対象となる主要チャネル
管理画面には「その他のチャネル」という行もあり、PerplexityのようなAIプラットフォームや、実験的なショッピングエージェントを開発するスタートアップが含まれる。この行もデフォルトでオンになっている。
ダイレクトチェックアウトで店舗訪問不要の購入が可能に
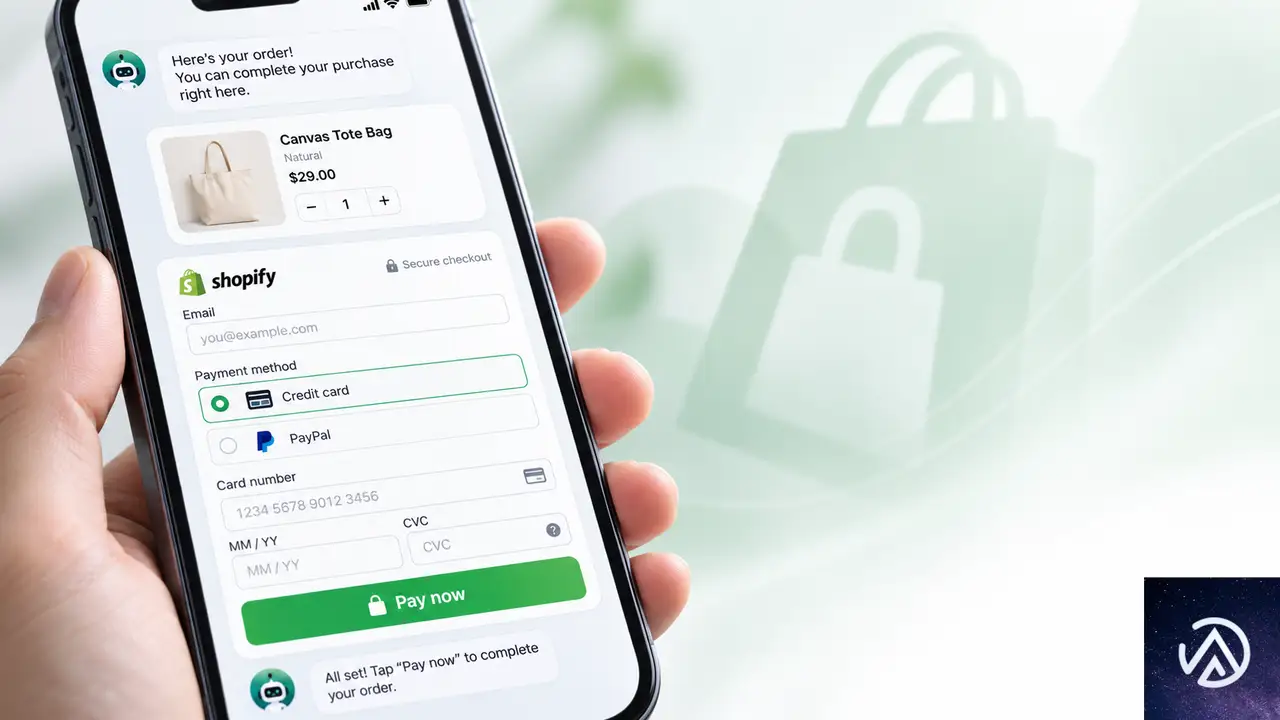
従来フローではサイト訪問が必須だったが、ダイレクトチェックアウトではチャットアプリ内で決済まで完了する。この違いがアナリティクス計測に影響を与える。
ダイレクトチェックアウトとは、顧客がAIチャットアプリ内のShopifyチェックアウトで決済を完了し、自社サイトを一切開かない購入方法だ。条件を満たすストアではデフォルトで有効になっている。
- Meta、米国・カナダ・メキシコ向けに販売するストア
- Google AI ModeとGemini、米国のストアが米国顧客向けに販売し、Google Merchant Centerアカウントを持つこと
- Microsoft Copilot、米国内で販売するストア
ChatGPTは仕組みが少し異なり、顧客を自社ストアのチェックアウトへ誘導する。ChatGPTアプリ内ブラウザで表示されるか、Web版なら新しいタブでチェックアウトが開く。
アナリティクス計測に生じる盲点
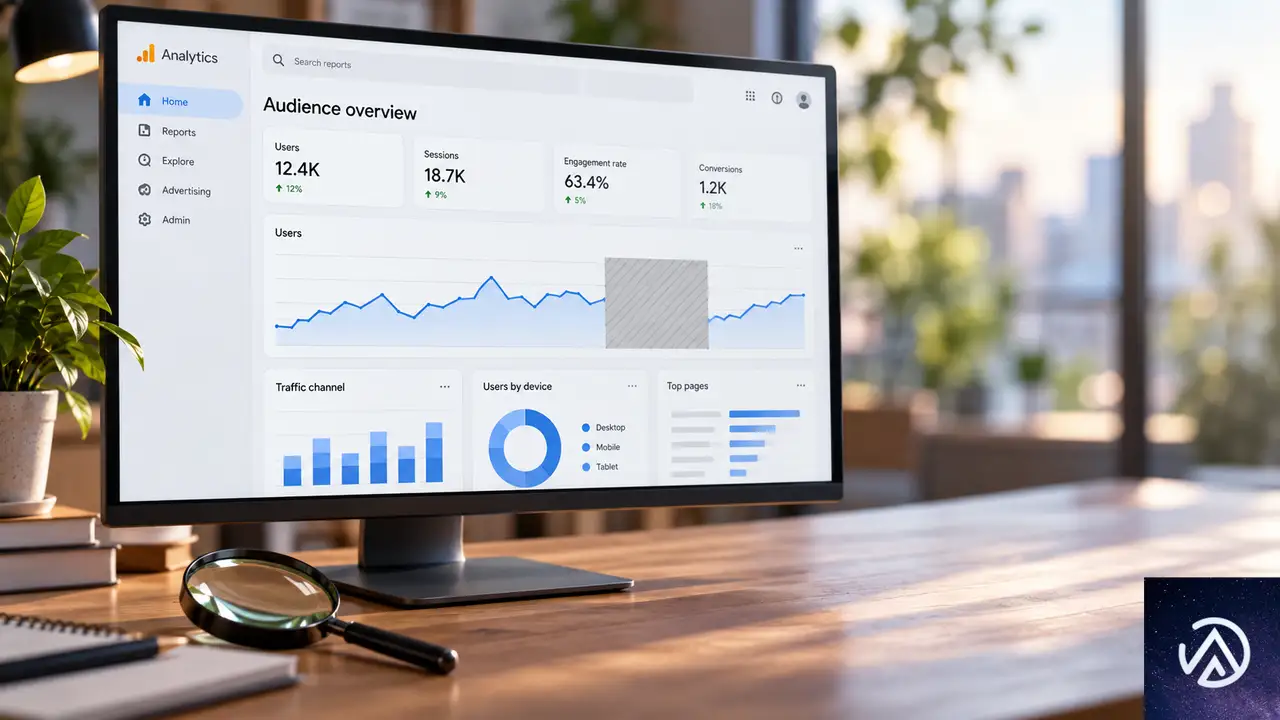
カスタムピクセル あり
サーバーサイド計測 あり
カスタムピクセル なし
サーバーサイド計測 あり
Shopify管理画面の注文記録 あり
ダイレクトチェックアウトではクライアントサイドの計測が止まる一方、Shopify管理画面には注文が記録される。売上分析の際は計測経路の違いを理解しておく必要がある。
ダイレクトチェックアウトでの購入では、自社サイトのトラッキングコードが実行されない。Shopifyによると、Google AnalyticsとカスタムピクセルはGoogle・Copilotのチェックアウトで発火せず、サーバーサイドトラッキングのみが機能する。Metaのチェックアウトではサードパーティ製アナリティクスピクセルが発火しない。
ただしShopify管理画面には注文が記録される。Meta経由の注文も「他の販売チャネルと同じ方法で」表示されるため、Shopifyの管理画面を見ていれば売上自体は把握できる。
このため、Google Analyticsや広告ダッシュボードで売上を確認しているストア運営者は、AI経由の売上を見落とす可能性がある。月に1回程度、注文リストをチャネル別にフィルタして確認する運用が推奨される。
自動登録を停止する手順と注意点
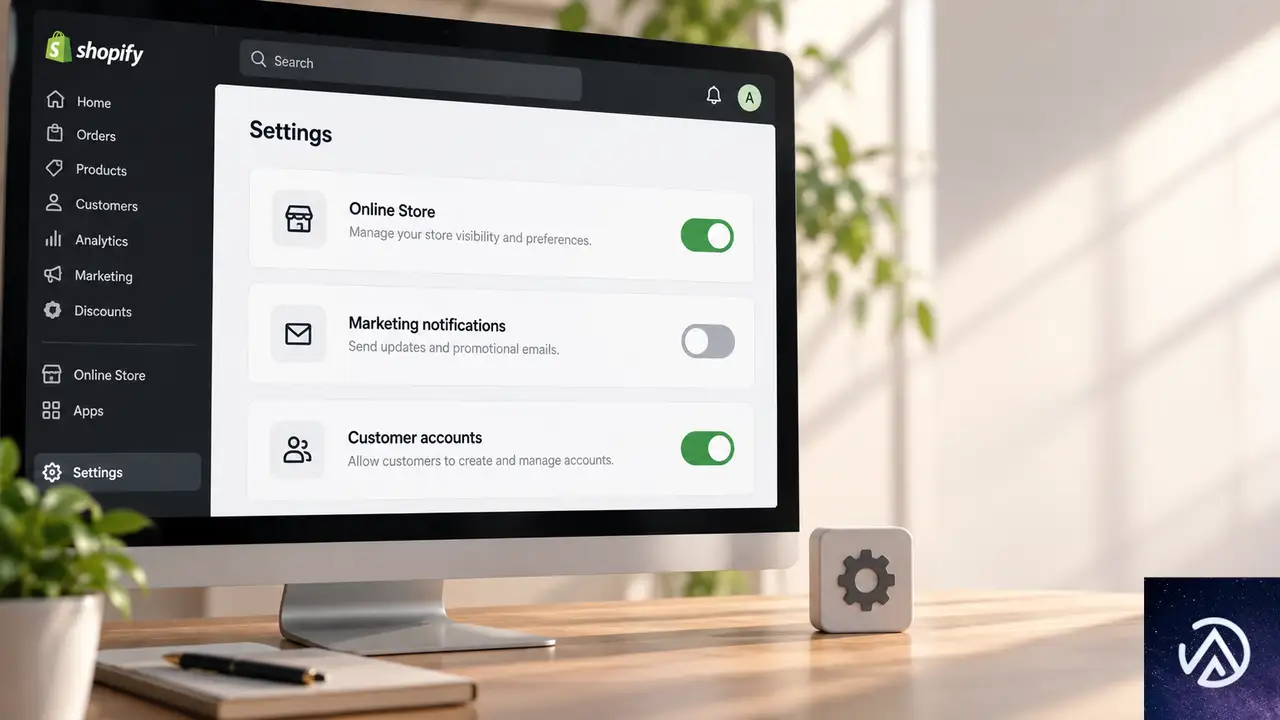
「Shopifyに管理を任せる」設定をオフにすると、次の3つのスイッチが表示される。
- Shopify Catalogアクセス
- 新しいストアフロントの自動登録
- ダイレクトチェックアウト
「新しいストアフロントの自動登録」をオフにすれば、既存チャネルは維持しつつ新規チャネルへの自動登録だけを停止できる。
チャネル別にも設定がある。MetaとCopilotはカタログアクセスとダイレクトチェックアウトのそれぞれにスイッチを備える。ChatGPTはカタログアクセスのみ、Googleはダイレクトチェックアウトのみだ。
カタログアクセスをオフにした場合、Shopifyは商品データの共有が停止するまで最大7日かかるとしている。即時に共有が止まるわけではない点に注意が必要だ。
特定商品だけをAIアプリから隠すには「unlisted(非公開)」に設定する。ただし非公開にするとサイトマップやGoogle検索、自社サイト内検索からも除外される。AIチャネル限定の除外はできない。
手数料は当面無料、Metaは将来の手数料徴収を示唆
2026年9月時点で、ChatGPT・Google・Microsoft Copilot・Metaはいずれも手数料を請求していない。ストア運営者が支払うのは通常の決済処理手数料のみだ。販売者としての立場も変わらず、発送・返品・カスタマーサービスは引き続きストア側が担当する。
ただしMetaは将来の手数料徴収を明確に示唆している。Mark Zuckerberg氏は2026年9月8日公開のポッドキャストで、Museについて「時間の経過とともに、取引額のごくわずかなカットを徴収するビジネスモデルを期待している」と発言した。手数料はMuseが取引を仲介する事業者から徴収する形になる見通しだ。
GoogleとMicrosoftからは同様の手数料計画は明らかにされていない。No HacksのポッドキャストEpisode 233では、MetaがMuseについて述べた内容と手数料の見通しを詳しく検証している。
AI参照トラフィックは急増中
Agenticページ上部に表示される「ショッパー数」は、AIアプリから自社ストアへの訪問数を表す。Shopifyのドキュメントでは「指定期間内にAIチャネルからオンラインストアへの総訪問数」と定義されている。
ただしダイレクトチェックアウトでの購入はWebサイトを開かないため、この数には含まれない。つまりこの数値は「AIエージェントが購入した数」ではなく「AIチャットアプリの回答からリンクをクリックして訪問した人数」だ。
Search Engine Journalの記事では、このショッパー数を「エージェンティックショッピングではなくLLM参照トラフィック」と整理している。AIチャットアプリの回答経由でストアに送られてきた訪問者という位置づけだ。
Shopifyは2026年8月、2026年第2四半期に「AI参照セッションが前年同期比197%増、注文数も3倍に増加した」と発表している。一方、AIエージェントがチャットアプリ内で完了した購入の具体的な件数は、Shopifyからも他社からも公表されていない。
Search Engine Journalの記事は、当面はすべての設定をオンにしたまま、Shopifyがチャネルリストに追加する項目を注視することを推奨している。ダイレクトチェックアウトの売上は、チャネル別にフィルタした注文リストでしか把握できないためだ。
この記事のポイント
- Shopifyの自動登録設定はデフォルトで有効、対象ストアは新AIチャネルに自動参加する
- ダイレクトチェックアウトではGAやピクセルが発火せず、計測の盲点が生じる
- 自動登録は「Shopifyに管理を任せる」設定をオフにすれば停止できる
- 現在は手数料無料だが、Metaは将来の手数料徴収を示唆している
- AI参照トラフィックは前年比197%増と急成長している

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CloudflareがAI決済2製品をベータ公開、サイト運営者が知るべき課金モデルとは
CloudflareがAI決済分野で動きを加速させている。9月30日に2つの製品をベータへ移行した。Monetization GatewayとPay Per Useだ。いずれもサイト運営者がAIエージェントやAI企業から収益を得るための仕組みである。
Monetization GatewayはAIエージェントからのリクエスト単位で課金する。Pay Per UseはAI企業がコンテンツを使用した際にパブリッシャーへ支払う。どちらも現在は米国拠点の利用者に限定したクローズドベータだ。
AI検索の普及でコンテンツの無断利用が問題視される中、この発表はサイト運営者にとって新たな収益化の選択肢となる。本記事では仕組みと実務への影響を解説する。
CloudflareがAI決済製品をベータ公開、収益化の選択肢が拡大
この比較図は3つの支払いモデルの課金タイミングを示している。縦に並んだ各モデルは、それぞれ異なる課金ポイントを持つ。
Cloudflareは7月1日にMonetization Gatewayを発表し、順番待ちリストを開設していた。今回のベータ移行で実際の利用が始まった形だ。Pay Per Useも同じくベータ段階に入っている。
3つの支払いモデルが揃った
Cloudflareが提供するAI関連の支払いモデルはこれで3つになった。既存のPay Per Crawlに加え、今回の2製品が加わった。それぞれ課金のタイミングと主体が異なる。
- Pay Per Crawlはクローラーがアクセスした時点でサイト所有者が設定した料金を支払う
- Monetization GatewayはAIエージェントからのリクエストごとに売り手が設定した料金を請求する
- Pay Per UseはAI企業がコンテンツを使用したと報告した時点でAI企業が設定した料金をパブリッシャーに支払う
この3モデルを理解すると、AI時代のコンテンツ課金の全体像が見えてくる。
Monetization Gatewayの仕組み
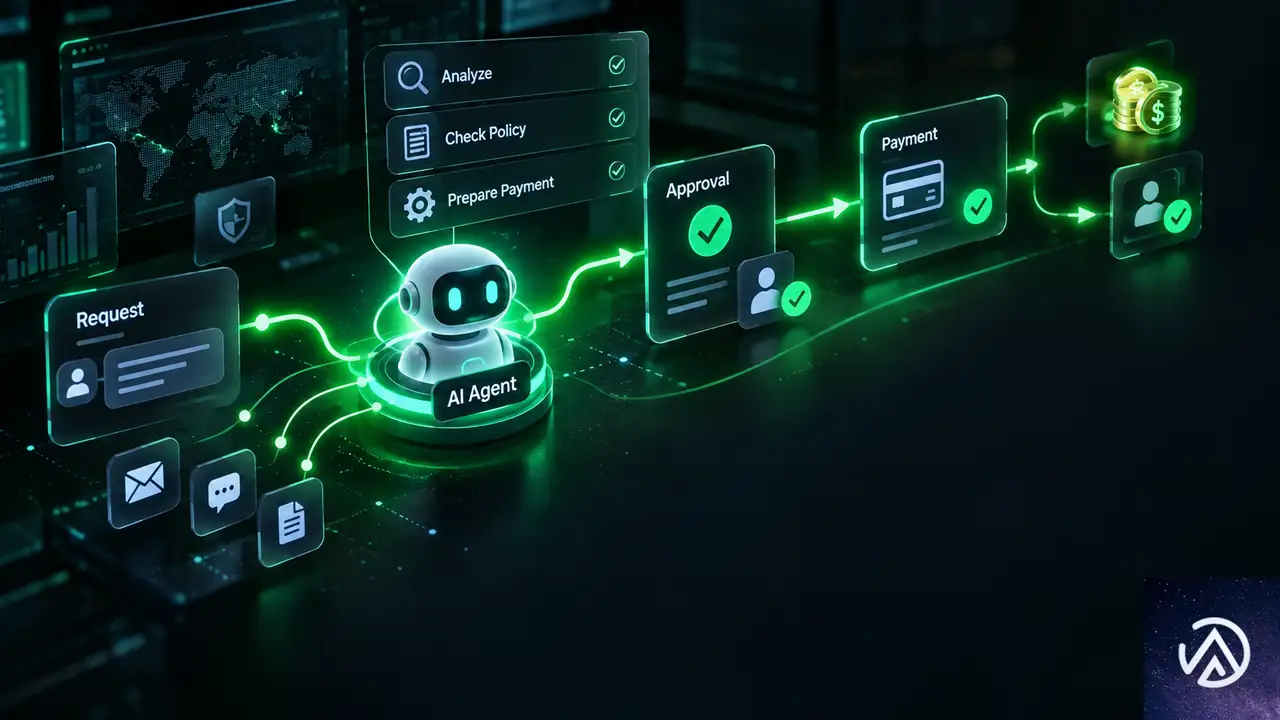
このフロー図はMonetization Gatewayの処理手順を示している。支払いが完了するまでコンテンツは提供されない。
Monetization GatewayはAIエージェントに対してリクエスト単位で課金する仕組みだ。API、MCPツール、データセット、サイトなど、リクエストがあるたびに使用が発生するリソース向けに設計されている。MCPツールとは、AIアシスタントが外部の機能を呼び出すための標準規格Model Context Protocolに対応したツールを指す。
リクエスト単位の課金フロー
このゲートウェイはx402プロトコルとHTTP 402 Payment Requiredステータスコードを使用する。x402プロトコルは、HTTP 402を利用した機械支払いのための規約だ。人間の介入なしにAIエージェント同士が支払いを処理できるよう設計されている。
HTTP 402は「支払いが必要」という意味のレスポンスコードだ。AIエージェントが保護されたリソースへアクセスすると、まず支払い条件を受け取り、支払い承認に署名してから再試行する。支払いはこのリクエスト内で処理され、売り手のサーバーが応答する前に検証される。つまり、支払いが確認できなければコンテンツは提供されない仕組みだ。
料金設定は固定と変動の2種類から選べる。固定価格は入力が同じなら常に同じ料金になる。変動価格は上限額を設定し、実際の使用量に応じて売り手側が請求額を報告する。決済は1回0.001ドルから100ドルまで対応する。
支払い処理にはUSDCステーブルコインを採用した。Baseブロックチェーン上でCoinbaseのx402 Facilitatorを経由する。将来的には他の支払い方法も追加する予定だ。
導入に必要な条件
現在はクローズドベータのため、利用するには条件がある。売り手と買い手の双方が米国に拠点を置く必要がある。売り手側はクレジットカードの登録、確認済みメールアドレス、開設から60日以上経過したアカウントが求められる。
さらにサイトがCloudflare経由でプロキシされており、作成から30日以上経過していること、ゾーンのセキュリティチェックを通過することが条件だ。アクセス申請はダッシュボードから行う。
4つのライブ実装も公表されている。Ceramic.aiはエージェント向けのWeb検索APIを固定価格で提供する。AI Gatewayは4つのオープンモデルで推論リクエストごとの支払いを受け付ける。Stocktwitsは市場シグナルをリクエスト単位で課金する。API2PDFはリクエストの計算量と帯域幅に基づく変動価格でPDF生成APIを提供する。
API2PDFの事例は示唆的だ。初月無料の後にクレジットカードを要求すると変換率が50%以上低下したという。AIエージェント向けの決済はスムーズさが重要だと示している。
Pay Per Useの仕組み
このフロー図はPay Per Useの役割分担を示している。AI企業が使用を報告し、Cloudflareが照合してパブリッシャーへ支払う流れだ。
Pay Per Useは別のアプローチを取る。パブリッシャーがコンテンツを提供し、AI企業がそのコンテンツを使用したと報告した場合に、AI企業からパブリッシャーへ支払いが発生する。
使用報告の流れ
役割分担は明確だ。AI企業が支払う用途と価格を定義する。パブリッシャーは提示されたオファーを承認するか拒否するかを決める。承認後は自分のコンテンツがどれだけ使われ、いくら稼いだかを確認できる。Cloudflareは登録、使用記録、請求、支払いを担当する。
使用の記録はAI企業側が自己申告する。タイムスタンプ、ソースURL、イベントIDを報告し、Cloudflareが各使用報告が登録済みパブリッシャーのものか照合する。そこから買い手に請求し、毎月パブリッシャーへ支払う流れだ。
ベータ期間中、Cloudflareは個々の買い手および参加を選択したパブリッシャーと直接連携している。買い手の企業名はまだ公表されていない。
パブリッシャーが注意すべき点
Pay Per UseではAI企業が使用用途と価格を設定する。パブリッシャーはオファーを承認するか否かの判断のみで、価格交渉はできない。また、使用データは買い手の報告に依存するため、実際の使用頻度との乖離があり得る。
各プログラムの規約には、AI企業がコンテンツをどう扱えるか、学習用途の制限なども含まれる。参加前に規約を確認する必要がある。
サイト運営者への実務的な影響
これら2製品は、AIエージェントの台頭でコンテンツ収益が脅かされているサイト運営者に新たな選択肢をもたらす。特にMonetization GatewayはAPIやデータセットを提供する事業者との相性が良い。Pay Per Useはコンテンツメディア向けだ。
SEO観点での評価
SEO対策の観点では、AI検索エンジンがコンテンツを読み取る動きが加速する中、その利用に対して対価を求める仕組みが整ってきた点が重要だ。これまで無断でクロールされ、引用される一方だったパブリッシャーに交渉の余地が生まれる。
ただし現段階では取引件数や支払い実績は公表されていない。収益化の効果を実証するデータはまだない。ベータ期間中の成果報告が待たれる。
導入を検討する際のチェックポイント
現時点で導入できるのは米国拠点の事業者に限られる。日本からはまだ利用できない。地理的な拡大は予告されているが、時期は明らかではない。まずは動向を追い、仕組みを理解しておくことが現実的だ。
- 自社コンテンツがAIエージェントに利用される頻度を把握する
- Pay Per Crawl、Gateway、Pay Per Useの違いを理解する
- Cloudflareを利用しているか、利用予定があるか確認する
- ベータが日本に開放された際にすぐ試せるよう準備する
今後の展開と注目ポイント
CloudflareはPay Per Useのベータで、パブリッシャーが買い手の提示価格に対抗してカウンターオファーを出したり、用途別に異なる料金を設定したりする方法を模索している。
また、Pay Per Useで購入するAI企業の社名が公表されるかも注目点だ。Gatewayについては新たな地域への対応が予告されている。日本からの利用開始時期も気になるところだ。
AIエージェント経済のインフラが整いつつある。サイト運営者はこの変化を収益化のチャンスと捉え、早期に情報をキャッチアップしておくべきだ。
この記事のポイント
- Cloudflareが2つのAI決済製品をベータ公開した
- Monetization Gatewayはリクエスト単位でAIエージェントに課金する
- Pay Per UseはAI企業の使用報告に基づきパブリッシャーへ支払う
- どちらも現段階では米国拠点の限定ベータである
- AI時代のコンテンツ収益化に新たな選択肢が加わった
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIが検索意図を再定義。68%がクリックされない検索の新常識
Google検索の68%がクリックなしで終わる時代に入った。2019年には49%だった「ゼロクリック」の割合が、わずか7年で20ポイント近く上昇したことになる。検索結果から外部サイトへ移動しないユーザーが、すでに3分の2を超えている。
この変化の中心にあるのが、AI ModeとAI Overviewsの急速な普及だ。月間アクティブユーザー10億人を超えたAI Modeの利用データは、検索意図の構造が根本から変わったことを如実に示す。もはやキーワードを入力して青いリンクを探す時代ではない。
本記事では、2026年に公開された2つの実証研究とGoogle自身の利用データを軸に、AIが検索意図をどう再定義しているのかを整理する。旧来のSEO指標では捉えきれない変化の実態と、これからの戦略立案に必要な視点を提示する。
ゼロクリック検索の実態。68%という衝撃の数字

SparkToroが発表した2026年のクリックストリームデータによると、米国におけるGoogle検索の68%がクリックを生まない。この数値は2019年の49%から一貫して上昇を続けており、単なる一時的な現象ではない。検索行動の地殻変動が10年単位で蓄積してきた結果だ。
ゼロクリックの広がりは、生成AIの登場によって突然始まったものではない。ユーザーはすでにYouTubeやTikTokなど、ビジュアルやコミュニティを重視するプラットフォームへ検索行動を分散させていた。Googleはこの流出を食い止めるため、検索結果画面の中で即時に答えを返す仕組みを強化してきた経緯がある。
重要なのは、検索がもはや単一のテキストボックスを超え、マルチモーダルでマルチプラットフォームのエコシステムに分裂したという事実だ。従来のSERP(検索結果ページ)での可視性だけを追いかけても、オーディエンスの意図が生まれる場所を捉えきれなくなっている。
検索結果画面の中で情報取得が完結するほど、外部サイトへの送客は減っていく。この構造変化こそがゼロクリック検索の核心であり、SEO戦略の前提を揺るがす要因だ。
Google AI Modeのデータが示す会話型検索の台頭

クエリは3倍長く、40%が追加質問
Googleが2026年のI/Oで公開したAI Modeの利用データは、検索行動の変化を具体的に裏付ける。AI Modeは月間アクティブユーザーが10億人を突破し、平均クエリの長さは従来型検索の3倍に達している。「説明する」「要約する」といった行動指向のコマンドが目立ち、一人称「私」の使用頻度が高い点も特徴だ。
これは単なるキーワード検索ではなく、会話型の対話に近い。追加質問は前月比40%増で推移し、AI Modeでの6分の1以上の検索が音声・画像・動画を組み合わせたマルチモーダルな入力になっている。ユーザーは青いリンクの一覧を求めておらず、即座に統合された価値を対話の中で求めている。
この変化は検索意図の捉え方そのものを変える。従来の「情報を探す」という受動的な行動から、「決める」「学ぶ」「創る」という能動的な行動へと、検索の役割が拡張しているのだ。
4語クエリがAI回答を起動する確率は48.1%
Clara Soteras氏らが実施したスペインメディアを対象とする初の大規模研究では、クエリの複雑さがAI回答の表示を直接左右することが示された。4語を含む検索では48.1%の確率でAIO(AI Overviews)が表示され、3語と4語のクエリだけで全AI生成結果の約70%を占める。
長いクエリの背後にある意図は、根本的に問いかけ型だ。常緑コンテンツ(長期間にわたって価値が変わらない情報)が75.2%を占め、ジャーナリズムの基本である「6W」を含むキーワードは高い確率でAI要約を誘発する。「why」は92.3%、「what」は85.7%、「who」は68.4%という数値が出ている。
ここから導かれる結論は明確だ。断片的な名詞キーワードを追いかける時代は終わり、複雑で普遍的な人間の問いに直接答えるコンテンツ構造へシフトする必要がある。
クエリの語数が増えるほど、また「なぜ」という問いかけが含まれるほど、AI回答は高い確率で表示される。コンテンツ設計では、複雑な問いに直接答える構成が求められる。
速報とAI回答は別世界。ブランド可視性の逆説も
同じ研究で注目すべきなのが、生成AIと速報ニュースが完全に別の生態系で動いている事実だ。AIOは常緑コンテンツの検索で34.6%表示されるのに対し、現在進行形のニュースでは1.1%まで急減する。速報を扱うTop Storiesモジュールとの同時表示率も1.4%に留まる。
さらに重要な発見として、分析対象となったSERPの43.6%はAIOもTop Storiesも表示されない「ブルーオーシャン」だった。この領域では従来のオーガニック順位が依然として高い効果を発揮する。
ブランド可視性の逆説も見逃せない。20 Minutosはブランド関連クエリで38.9%のAIO表示率を獲得した一方、トラフィック全体のリーダーであるEl Españolは11.1%に留まった。大量の訪問数が生成AI時代のシェア・オブ・ボイスを保証しないという端的な証明だ。
検索意図の5つの柱。探索から実行へ

Googleが発表した米国におけるAI Mode利用調査は、検索意図の境界を公式に再定義した。ユーザーはリンクを探すだけではなく、意思決定、旅行計画、タスク整理、概念学習、アイデア生成、比較検討、コンテンツ作成など、幅広い目的でAI Modeを利用している。
Googleはこの変化を5つの行動指向の柱として整理する。「探求する」「決める」「学ぶ」「創る」「実行する」の5つだ。検索が受動的な情報レイヤーから能動的なユーティリティレイヤーへ進化したことを、この分類は明確に示している。
WAN-IFRAのEzra Eeman氏が指摘する通り、この5つの柱はメディア分野におけるDmitry Shishkin氏の「User Needsモデル」と強い類似性を持つ。事実を報じるだけでなく、教育し、インスピレーションを与え、視点を提供する。そうした深いユーザー・ニーズを生成検索エンジンがインターフェース内で直接満たそうとしているのだ。
5つの柱はすべて動詞で構成されている点が重要だ。検索エンジンはもはや情報の入り口ではなく、複雑なニーズを最初から最後まで満たす動的なアシスタントへと位置づけを変えている。
視線追跡が暴く「見られるがクリックされない」領域

Laika Teamが実施した視線追跡調査は、SERP上でのユーザー行動をさらに深く解明した。Diego Criado氏らの研究チームが発見したのは「attention-to-action gap」、すなわち視覚的注意と実際の行動の間に生じる大きな乖離だ。
画像や商品リスト、AIOの「さらに見る」ボタンなどの視覚要素は、ユーザーの視覚的関与を最大100%獲得しながら、クリック率は0%という衝撃的な数値を示した。ユーザーはこれらの要素をわずか数ミリ秒で走り読みするだけで、実際の意思決定には利用しない。
一方で真の「コンバーター」は、AI Overviewの核心テキスト部分と従来のオーガニックリンクだった。AIO本体は86.4%、上位オーガニックリンクは95.5%という高いクリック率を記録している。生成AI機能が基本的な探索を完結させるため、周辺要素は視覚的ノイズと化し、クリックを獲得できる領域は限られていく。
視線追跡データが示すのは、SERP上でユーザーが実際に読んで意思決定する場所と、単に目に入るだけの場所がはっきり分かれたことだ。意図の高いトラフィックを獲得するには、この2つの領域の違いを理解する必要がある。
注目から互酬へ。新しい評価指標の必要性

検索行動の変化がここまで明確になると、KPI(主要業績評価指標)の見直しは避けられない。クリック数やクエリ量などの既存指標を捨てる必要はないが、量だけでなく深さを測る定性指標の補完が必須になる。
Industry Diveの共同創業者であるSean Griffey氏が提唱するのが「reciprocity(互酬性)」という概念だ。「注目は取引であり、互酬は持続可能である。それは堀になる」という同氏の言葉が示す通り、既存のダッシュボードは読者が消費する時点までしか測れていない。読者が購読する瞬間まで追跡できても、その先にある真のファン度を測る指標は存在しない。
互酬性が問うのは、より難しい質問だ。助けを求めたとき、オーディエンスは本能的な応答欲求を感じるか。見返りがなくても支えたいと思うほどのつながりがあるか。クリエイターエコシステムがこのつながりを常に検証してきたのに対し、メディアブランドも同様の実践を学ぶ必要がある。
tchop.ioのHeiko Scherer氏が指摘する「到達から所属へ」という視点も同じ方向を向く。単なるリーチでは測れない帰属意識こそが、ゼロクリック時代の最も価値ある資産になる。編集プロダクトの質を磨く、学びを目的としたコンテンツを設計する、活発なコミュニティを育てる、創作の場を提供する。これらの取り組みが、互酬性を育む具体的な道筋だ。
数値化しにくい指標を追いかけるのは実務的に難しい。しかしゼロクリックが進むほど、取引型の指標だけではブランドの持続可能性を測れなくなる。感覚的でも手応えのある定性指標を補完することが、これからのメディア運営に不可欠だ。
この記事のポイント
- Google検索の68%がクリックされずに終わるゼロクリック時代に入った
- AI Modeのクエリは従来の3倍長く、4語でAI回答出現率が48.1%に達する
- 検索意図は「探求する・決める・学ぶ・創る・実行する」の5つの柱に再定義された
- 視線追跡では画像やボタンが100%見られてもクリック率0%という乖離が判明した
- 新しい評価指標として、取引型の注目ではなく互酬性と所属の概念が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
2026年8月スパムアップデート開始!Google検索への影響と対策を解説
Googleが2026年8月18日、8月のスパムアップデートの展開を開始した。全言語・全地域が対象で、完了までに数日かかる見込みだ。Search Status Dashboardにランキングへ影響を与えるインシデントとして記録されている。
これは2026年に入って3回目のスパムアップデートとなる。3月の更新は過去最速の19時間30分で完了し、6月の更新は生成AI検索への操作対策もスパムポリシーの対象に含める方針が示された直後に行われた。
検索順位に動きが出た場合、スパムポリシー違反がないか確認することが重要になる。復旧には数ヶ月かかることもあるため、早期の対応が求められる。
8月スパムアップデートの概要
今回のアップデートは太平洋時間8月18日午前9時27分に開始された。日本時間では8月19日午前1時27分となる。Search Status Dashboardには開始時刻の約1分後、午前9時28分にリリースノートが掲載された。
適用範囲は全世界・全言語だ。Googleは完了までに数日かかる可能性があると案内している。この種のアップデートは、展開中に順位の変動が大きくなることがある。短期間のデータだけで判断せず、数日単位で傾向を見る必要がある。
公開時点では、Search Status Dashboardの注記に加えて公式ブログ記事は投稿されていない。スパムアップデートの概要ページも2025年12月から変更されていない。今回は新しいスパムポリシーの種類は追加されていない。既存のポリシーがそのまま判断基準になる。
このデモは8月スパムアップデートの展開フローを示している。各ステップの色分けは進行段階を表しており、青が開始、緑が適用範囲、橙が展開期間、紫が完了通知を意味する。
2026年のスパムアップデート史
2026年はスパムアップデートが立て続けに実施されている。8月の更新は3回目だ。過去2回の傾向を把握しておくと、今回の展開期間や影響範囲を推測しやすくなる。
3月の更新は過去最速で完了
3月のスパムアップデートは19時間30分で完了した。これはSearch Status Dashboardの記録上、確認済みの展開としては最速だった。展開期間が短いほど、順位変動も短期間に集中しやすい。
6月の更新は生成AI検索の操作対策も対象に
6月のスパムアップデートは2日と1時間かけて完了した。その前月の5月15日には、GoogleのスパムポリシーがAI OverviewsやAI Modeなど、生成AI検索の結果を操作しようとする試みにも適用されるという方針が明確化されている。6月の更新がこの種の操作を具体的に狙ったものかどうかは、Googleから公式な説明はない。
8月の更新についても、生成AI検索の操作を特に標的にしているかどうかは明らかにされていない。ただし、スパムポリシーは検索結果全般に適用されるため、生成AI検索への操作も対象範囲に含まれると考えるのが自然だ。
このデモは2026年に実施された3回のスパムアップデートを比較したものだ。青が3月、緑が6月、橙が8月を表す。完了までの時間が回を追うごとに長くなる傾向が見える。
サイト運営者が取るべき行動
スパムアップデートの展開中は、検索順位が一時的に変動することがある。1日だけのデータで判断せず、Search Consoleのデータを数日分確認するのが基本だ。特に8月18日以降の動きに注目する必要がある。
Search Consoleで順位変動を確認する
順位の変動を確認するには、Search Consoleのパフォーマンスレポートが最も信頼できる。表示回数・クリック数・平均掲載順位を日別で確認し、8月18日以降に急激な変化が出ていないかを見る。
もし変動が見つかったら、それがスパムアップデートの影響なのか、他の要因によるものなのかを切り分ける必要がある。季節要因や自サイトの変更、競合サイトの動きなども同時に確認することだ。
このデモはSearch Consoleを使った確認手順を示している。青から紫への色分けは、各ステップの進行順を表す。
スパムポリシーの見直しが復旧の最短経路
順位が大きく下がった場合、Googleのスパムポリシーに違反していないかを見直す必要がある。主なポリシーには、クローキング、隠しテキスト、リンクスパム、キーワードの乱用、ユーザー生成スパムなどがある。自サイトが該当する可能性がないか、コンテンツとリンクの両面から確認する。
Googleの公式ドキュメントによると、スパムポリシー違反からの復旧には数ヶ月かかることがある。自動化されたシステムが、サイトがルールに従うようになったことを認識するまでに時間が必要なためだ。違反を修正しても、すぐに順位が戻るわけではないことを理解しておく必要がある。
このデモはGoogleのスパムポリシーで代表的な違反の種類を示している。赤い左線が注意を促す配色だ。
今後の展開と監視ポイント
Googleはアップデートの展開が完了すると、Search Status Dashboardに完了記録を掲載する。3月は19時間30分、6月は2日と1時間で完了しており、今回も同様に記録される見込みだ。
サイト運営者としては、完了通知が出るまでの間、Search Consoleのデータを注視するのが現実的な対応になる。特に8月18日以降の表示回数と平均掲載順位の推移を数日分まとめて確認し、変動の傾向を掴むことだ。
Search Engine JournalはGoogleが完了を確認次第、続報を伝えるとしている。今回のアップデートで新たなスパムポリシーが追加されたり、特定のスパム手法が集中的に取り締まられたりした場合は、その情報も出てくるだろう。
この記事のポイント
- 8月スパムアップデートは2026年8月18日に開始、全言語・全地域が対象
- 今年3回目のスパムアップデートで、新ポリシーの追加はなし
- 完了までに数日かかる見込みで、完了後にSearch Status Dashboardで通知される
- 順位変動があればSearch Consoleで8月18日以降のデータを確認する
- スパムポリシー違反からの復旧には数ヶ月かかることがある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索で無名の新ブランドは勝てるのか?1カ月実験で見えた可視化ルール
実在しない架空のブランドでも、AI検索結果に表示され、あたかも業界の有力企業であるかのように引用される。そんな実験結果が、SEOツールを提供するSE Ranking社の研究チームによって2026年4月に公開された。実験開始からわずか1カ月で、作りたてのブランドがAIに「学習」され、検索結果で確固たるポジションを築いたのだ。
この実験が示すのは、AI検索(ChatGPTやGoogleのAI Overviewsなど)の可視性には、明確で再現可能なパターンが存在するということだ。AIはデタラメに結果を表示しているわけではない。特定のシグナルに反応し、そのシグナルは戦略的に操作できる可能性がある。
データに基づいた、AI時代の新しい情報発信のルールを見ていこう。
実験の設計と5つのAIエンジン
この実験を主導したのは、Search Engine Landに寄稿したSE Ranking社の研究チームだ。彼らは実在する市場の中に、完全に架空の新ブランドを作り出した。そのブランドに関する情報を、専用に取得した新しいWebサイトと、過去の運用履歴がある11の追加ドメインに分散して公開。複数のサイト間で情報をどう拾い上げるかも検証した。
作成したコンテンツは以下の7形式に及ぶ。
- 詳細ガイド(5000~6000語の網羅的ページ)
- 「代替品」リスト
- 「ベスト」リスト
- レビュー記事
- 比較(vs)ページ
- ハウツー・チュートリアル記事
- クリックベイト風の記事
2026年3月にコンテンツの公開を開始し、以下の5つのAIシステムがどのように反応するかを1カ月間追跡した。
- ChatGPT
- GoogleのAI Overviews(検索結果の上部に表示される生成AI要約)
- GoogleのAI Mode(AI Overviewsより対話型の検索体験)
- Perplexity(リアルタイムWeb検索に特化したAI)
- Gemini
追跡したプロンプト数は全カテゴリで825件。これに対してAIが生成した回答は合計15,835件にのぼった。各回答において、架空ブランドが「登場したか」「情報源として引用されたか」「1番目の主要な情報源として扱われたか」をチェックしている。
新興ブランドがAI検索を制する3つの発見
実験から浮かび上がった最も重要な事実は、AI検索での可視性の96%が「ブランド名を含む検索(Branded Search)」から生まれている点だ。「最高のプロジェクト管理ツール」のような一般キーワードでは、まったく新しいドメインが既存の権威あるサイトに勝つのは極めて難しい。
しかし、見方を変えれば、これは新規ブランドにとって大きなチャンスでもある。具体的な3つのパターンを見ていこう。
自社の物語は自社で定義できる
架空ブランドのメインサイトでは、ブランド名を含むクエリで10,253件のAI回答が生成されたのに対し、非ブランドクエリではわずか6件だった。その差は約1,700倍だ。AIは、答えが一意に定まる「ブランド固有の質問」に対して、驚くほどの信頼を寄せる。
「御社の製品は元々社内ツールとして開発されたのですか?」といった質問には、そのブランド自身しか答えられない。AIは複数の情報源を比較する必要がなく、結果としてドメインの権威がなくとも、そのサイトの記述をそのまま正解として採用する。実験では、この種のクエリで、権威スコアが40を超える既存の競合を最大32倍も上回る結果を残した。
実際に最も引用されたページは、ブランドの核となる情報をまとめた「完全ガイド」で、1,799件のAI回答に登場した。「会社概要(About Us)」ページも1,500件で続く。LLM(大規模言語モデル)は、これらの基本ページを他のどの追加ドメインよりも3~5倍の頻度で情報源として利用した。
AIはあなたのブランドをすぐに学び始める。しかし、何を学ぶかは、あなたがサイトに何を書くかで決まる。権威がなくとも、「自分たちは何者か」「何を提供しているか」「何が違うのか」を明確に説明することで、AI内でのブランドの語られ方を形成できるのである。
AIエンジンごとの振る舞いはまったく異なる
5つのAIは、それぞれが異なる「性格」を持っていた。この違いを理解することは、AI検索対策において極めて実践的な意味を持つ。
Google AI Mode: 最も安定した支持者
ブランド関連のクエリにおいて、約90%のケースで架空ブランドのドメインを情報源の1位に据えた。変動が少なく、特定の補助ドメインに依存する様子も見られなかった。ブランドの直接的な可視性を最も予測しやすいエンジンと言える。
Google AI Overviews: 高揚感と不安定さの同居
ブランドを認識し、検索結果の上位に表示する能力は高い。しかし、その可視性は安定しない。実験中、2週間連続で1位を維持した後、月中に急に姿を消し、回復しなかったプロンプトもある。AI Overviewsがブランドを「知らない」と回答したり、公開情報がないと主張するケースも散見された。リンクが表示される時は正確な説明を伴うが、その状態を維持するのが難しい。
Perplexity: 俊足の曲者
新しく公開されたページを、インデックスされてからわずか1~3日で拾い上げる圧倒的なスピードを持つ。実験初期の可視性はほぼPerplexityが牽引した。だが、そのスピードにはトレードオフがある。Perplexityは、ブランドのメインサイトよりも、実験用の補助ドメインを情報源として好む傾向を示した。月の後半には、メインのブランドサイトではなく、6つの異なる外部ドメインが引用されるようになった。可視性の総量は増えるが、それが必ずしもブランド本体への直接的な評価向上につながるとは限らない。
ChatGPT: 遅効性で深く浸透
実験開始当初はブランドをまったく認識しなかった。それが月の後半にかけて徐々に可視性を増していく。特に、ブランド固有の主張や製品レビュー、競合との比較ページで強さを発揮した。比較ページでは、月末までに31日中29日間という高い一貫性で引用を続けた。一度認識すると、繰り返し情報源として取り上げる傾向が見て取れる。
Gemini: 最も不安定な存在
実験で最もパフォーマンスが低かった。最初はブランドの事業領域すら誤認するほどだった。プロンプトを「X vs Y」のような比較形式に変えると精度が上がったが、それでもブランド固有のクエリに対して、約60%の回答でブランドへの言及や引用を一切行わなかった。
コンテンツの量と質の意外な関係
AIに引用されやすいコンテンツ形式は明らかだった。1ページあたりのAI回答数で見ると、詳細ガイドが約900件と圧倒的で、レビュー記事(約257件)、比較記事(約145件)がそれに続く。一方、ハウツー記事(22件)やクリックベイト記事(19件)、リスト記事(4~11件)はほとんど引用されなかった。
しかし、ここには明確な逆説がある。実験チームは、1つのテストドメインに、1ページ500~750語程度の薄い内容のページを30ページだけ公開するという、いわば「質より量」のテストも実施した。この30ページは、1ページあたりの平均AI回答数が63件と、詳細ガイドには遠く及ばない。
ところが、ドメイン全体の合計で見ると、総AI回答数は1,897件となり、これが全テストドメインの中で最も高い数値となった。個々のページの質では勝てなくとも、量で総露出を稼ぐ戦略が通用することを示している。これは、Perplexityのように新鮮さを重視するエンジンが存在するAI検索ならではの現象と言える。
トピッククラスターの神話が崩れた瞬間
この実験で最も注目すべき「失敗」のデータがある。それは、従来のSEOで効果的とされてきた「トピッククラスター」が、AI検索ではまったく機能しなかった点だ。
実験チームは、1つのテストドメイン内に、ハブとなる1ページと、それを支える10の関連記事を作成した。これらはすべて適切にインデックスされ、内部リンクで構造化され、検索エンジンにとって意味的なまとまりを形成していた。古典的なSEO理論で言えば、これは「専門性の塊」であり、検索エンジンからの高い評価を得られるはずの構成だ。
結果は、AI回答からの引用ゼロ。1件も引用されなかった。これは、従来の「内部リンクとセマンティックな広がりが権威性を高め、検索されやすくなる」という前提に対する痛烈な反証である。AIが必要としているのは、「構造化された知識のネットワーク」だけではない。AIがその情報を「なぜ、その回答のために引用しなければならないのか」という明確な理由なのだ。そこが欠けていれば、完璧に見えるコンテンツ群もAIの目には留まらない。
AIは「一貫性」に弱い。これはチャンスでありリスクだ
1カ月の実験が突きつけた結論は明快だ。AI検索は、情報の真偽を厳密に検証するよりも、「その情報がどれだけ一貫して、繰り返し、事実のように語られているか」に強く反応する。決して「AIは何でも信じ込む」と言うつもりはない。しかし、ある主張が明確に構造化され、関連する複数のページで何度も繰り返され、それが検索可能な形で存在すれば、AIはそれを驚くほど簡単に「事実」として表面化させる可能性がある。
これは正規のブランドにとっては、自社の強みを定義し、AIに正しく理解させるための能動的な戦略が必要だという警鐘である。AIは黙っていても正確な企業情報を語ってくれるわけではない。こちらから情報環境を整え、学習させにいかなければならない。
同時に、これは大きなリスクでもある。実験では「そのブランドに価値はあるか?」という問いに対し、AIが、まったく無名の架空ブランドを肯定的に推薦するケースも確認された。AIには、まだ情報の空白を批判的に捉えるのではなく、利用可能な限られたシグナルから「中立的」あるいは「好意的」な回答を生成することで埋めようとする傾向があるからだ。
これはAI検索の世界において、ブランド認知がこれまで以上に「柔軟」で、戦略的な影響を受けやすいものであることを意味する。あなたが事業を定義しなければ、他者(あるいは何者でもない情報)が、あなたのブランドの物語を上書きしてしまうかもしれないのだ。
この記事のポイント
- AI検索での可視性の96%は「ブランド名を含む検索」から生まれる。最初に集中すべきは、自社の核となる情報(「私たちは誰か」「何が違うのか」)を明確に定義し公開することである。
- 5つの主要AI(ChatGPT、Google AI Overviews / AI Mode、Perplexity、Gemini)は、情報の拾い上げ速度や引用の安定性がまったく異なる。戦略はこれを前提に設計する必要がある。
- AIに最も引用されるのは網羅的な詳細ガイドや比較記事だ。ただし、質の高い少数の記事が勝つとは限らず、大量のコンテンツが総露出で勝利するケースもある。
- 従来の内部リンクを中心としたトピッククラスター戦略だけでは、AIからの引用を獲得できない。AIに「なぜこれを引用すべきか」という理由を与えることの方が重要である。
- AIの判断は「一貫性」と「反復」に影響を受けやすい。自社のブランド情報を放置すれば、AIは情報の空白を推測で埋め、実態とかけ離れたブランドイメージが形成されるリスクがある。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google 2026年3月コアアップデート分析!上位サイトの80%が変動した理由
2026年3月に実施されたGoogleのコアアップデートは、近年のなかでも極めて大きな衝撃を検索結果にもたらした。前回の2025年12月のアップデートを遥かに凌ぐ変動率を記録し、多くのWebサイト運営者が順位の激変に直面している。
調査データによれば、検索結果のトップ3に入っていたURLの約80%が入れ替わるという異例の事態となった。これは、Googleが検索の質を根本から再定義しようとしている強い意志の表れだ。今回の変動は単なる順位の入れ替えではなく、評価されるサイトの「種類」そのものが変化した点に注目する必要がある。
コアアップデートとは、Googleが検索アルゴリズムの基幹部分を大規模に見直す更新を指す。年に数回行われるこの施策により、ユーザーにとってより価値の高い情報が上位に表示されるよう調整される。本記事では、最新データに基づき、どのようなサイトが勝ち残り、どのようなサイトが順位を落としたのかを詳しく分析していく。
2026年3月コアアップデートの衝撃と変動データ

今回のアップデートで最も驚くべき点は、その変動の激しさだ。SE Rankingが公開したデータによると、検索結果の最上部に位置するサイトの顔ぶれが劇的に変化したことが明らかになった。
上位3位の約8割が入れ替わる異例の事態
具体的な数字を見ると、その規模がよくわかる。検索結果のトップ3(1位から3位)において、順位が変動したURLの割合は79.5%に達した。2025年12月のアップデート時の66.8%と比較しても、その差は歴然だ。さらにトップ10まで範囲を広げると、実に90.7%のサイトが何らかの順位変動を経験している。
特筆すべきは、検索結果からの「脱落」の多さだ。トップ10にランクインしていたページのうち、約24.1%が100位圏外へと一気に順位を下げた。これは4ページに1ページが検索結果からほぼ姿を消したことを意味する。安定していたはずの主要サイトであっても、今回のアルゴリズム変更の影響を免れなかったことが伺える。
スパムアップデートとの重複による複雑な影響
今回の混乱に拍車をかけたのが、実施のタイミングだ。2026年3月のコアアップデートは、同月のスパムアップデートが完了したわずか翌日に開始された。スパムアップデートとは、低品質なコンテンツや不正な手法を用いるサイトを排除するための更新だ。
二つの大きな更新が連続、あるいは重複して行われたことで、順位下落の原因が「コンテンツの質」にあるのか「スパム判定」にあるのかを切り分けることが難しくなっている。しかし、変動の規模と過去のパターンを照らし合わせると、広範囲な順位の入れ替えは主にコアアップデートによるものだとの見方が強い。スパムアップデートがその混乱をさらに増幅させた形だ。
このデモは、アップデート前後で検索結果の構成がどれほど劇的に変化したかを視覚化したイメージだ。
「仲介サイト」から「目的地サイト」への評価シフト

今回のアップデートで最も顕著に見られた傾向は、ユーザーが最終的に必要とする情報を持っている「目的地(デスティネーション)サイト」の優遇だ。一方で、情報を集約して紹介するだけの「仲介(インターミディアリ)サイト」は苦戦を強いられている。
公式サイトや公的機関が検索結果を独占
SEOアナリストのAleyda Solis氏による分析では、検索の可視性が特定のサイトタイプに集中していることが指摘されている。順位を上げたのは、政府機関、教育機関、専門性の高いニッチなサイト、そして確立されたブランドサイトだ。
たとえば、事実に基づくクエリ(検索ワード)に対して、アメリカの国勢調査局(Census.gov)や労働統計局(BLS.gov)といった公的機関のドメインが大きく順位を伸ばした。これは、Googleが「情報の正確性」と「信頼できる情報源」をこれまで以上に重視している証拠だ。ユーザーが情報を探す際、二次解説サイトを経由せずに、直接一次ソースにたどり着けるよう調整されている。
比較サイトやアグリゲーターが直面する苦境
一方で、大きな損失を被ったのがアグリゲーター(情報の集約サイト)やディレクトリサイト、比較を主目的としたサイトだ。これらは自ら情報を生成するのではなく、他者の情報を整理して提示する役割を担ってきた。
これまでのSEOでは、網羅性の高い比較サイトが上位を占めることが一般的だった。しかし、今回のアップデートにより、特定のサービスを提供する企業の公式サイトが、それらをまとめた比較サイトを追い抜く現象が各所で見られている。Googleは「まとめページ」よりも「実行者・提供者のページ」を高く評価する方針へと舵を切ったようだ。
カテゴリ別に見る勝者と敗者の明確な差

アップデートの影響は業界ごとに異なる形で現れている。特定のカテゴリでは、検索結果の勢力図が完全に書き換えられたケースもある。
求人・不動産・旅行でのドメインパワーの変化
求人業界では、ZipRecruiterやGlassdoorといった大手求人アグリゲーターが順位を落とした。代わって上昇したのは、USAJobsのような公的求人サイトや、Amazon.jobsといった企業独自の採用ページだ。ユーザーは「求人を探すためのツール」よりも「具体的な仕事の提供元」を求めているとGoogleが判断した結果だと言える。
不動産や旅行のカテゴリでも同様の動きがある。広範な物件やプランを網羅するディスカバリープラットフォームから、より強力なブランド力を持つ一次提供者や、特定の地域に特化した専門サイトへと可視性が移っている。大規模なドメインであれば安泰という時代は終わり、そのドメインが「何を提供している当事者か」が問われている。
健康・医療情報における専門性の再定義
健康情報の分野では、より厳格な再編が行われた。一般的な情報を幅広く扱う消費者向けの健康情報サイトが軒並み順位を下げた一方で、臨床データや研究に基づいた専門的な情報源、あるいは特定の疾患に特化した専門医療機関のサイトが順位を上げている。
これはGoogleの掲げるE-E-A-T(経験、専門性、権威性、信頼性)の基準が、より高度なレベルで適用された結果だ。単に「わかりやすくまとめた記事」よりも、「専門家による深い知見や一次データ」が含まれていることが上位表示の必須条件となりつつある。
なぜYouTubeの可視性が低下したのか

今回のアップデートにおける最大の驚きの一つは、Google傘下であるYouTubeの可視性が大幅に低下したことだ。多くのキーワードにおいて、検索結果に表示されるYouTube動画の枠が減少、あるいは順位を下げている。
一見すると不可解な動きだが、これには「ユーザーの検索意図(インテント)」の純化が関係しているとの分析がある。これまでは、テキストベースの情報を探しているユーザーに対しても、関連する動画が表示されるケースが多かった。しかし、今回の更新では「文字で読みたい人には文字の情報を、動画で見たい人には動画の情報を」という切り分けが厳格になった可能性がある。
また、前述の「目的地サイトの優遇」というルールがYouTubeにも適用された結果、動画よりも詳細なデータや公式な文書が優先されたケースも少なくない。YouTubeは依然として強力なプラットフォームだが、Google検索内での「万能な解決策」としての地位は、今回のアップデートで少し変化したようだ。
今後のSEO戦略で重視すべき「一次データ」の価値

2026年3月のコアアップデートから学べる最も重要な教訓は、自社にしかない「一次データ」や「独自の見解」を持つことの重要性だ。他サイトの情報をリサーチしてまとめただけのコンテンツは、今後さらに厳しい状況に置かれるだろう。
今後の対策として、以下の3つのポイントを意識することが推奨される。第一に、自社が提供するサービスや製品の「公式サイト」としての情報を充実させることだ。第三者の比較サイトに頼るのではなく、自社サイト内でユーザーの疑問を完結させる構造を目指すべきだ。
第二に、独自の調査データや事例紹介など、他者が模倣できないコンテンツを増やすことだ。公的機関のサイトが評価された理由は、彼らが情報の「源泉」だからである。小規模なサイトであっても、独自の実験結果や専門家としての深い考察を提示できれば、ニッチな分野で「目的地」として認められる可能性は十分にある。
第三に、ブランド認知度の向上だ。Googleは「有名なブランドだから上位にする」のではなく「多くのユーザーがそのブランドの情報を直接求めているから上位にする」というロジックを強化している。検索窓で社名やサイト名が直接入力されるような、指名検索の獲得がSEOにおいても強力な武器となる。
この記事のポイント
- 2026年3月のコアアップデートは過去最大級の変動で上位3位の約80%が入れ替わった
- 公式サイトや専門サイトなどの「目的地サイト」が評価され、比較・集約を行う「仲介サイト」が下落した
- 公的機関やブランド力の強いドメインが事実ベースの検索クエリで強みを発揮している
- YouTubeの可視性が低下し、検索意図に応じたコンテンツ形式の出し分けが厳格化された
- 今後のSEOでは他サイトのまとめではない「一次データ」と「独自の専門性」が生き残りの鍵となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleが「戻るボタンの乗っ取り」をスパムと定義。6月15日からペナルティ対象に
Googleは検索セントラルのスパムポリシーを更新し、ブラウザの「戻る」操作を妨害する行為を「悪意のある行為」として明確に禁止した。この新ルールは2026年6月15日から適用が開始される予定だ。
ポリシーの追加により、ユーザーの意図に反して履歴を操作するサイトは検索順位の低下や手動ペナルティの対象となる。サイト運営者には2ヶ月の猶予期間が与えられており、その間に自社サイトの挙動を確認する必要がある。
今回の変更は、長年ユーザーから報告されていた「ページを戻ろうとしても同じサイト内に留め置かれる」という不快な体験を根絶するための強力な措置といえる。
戻るボタンの乗っ取り(Back Button Hijacking)とは何か
戻るボタンの乗っ取りとは、ウェブサイトのスクリプトを使用してブラウザのナビゲーション機能を操作し、ユーザーが前のページに戻るのを阻止する手法を指す。本来、ブラウザの「戻る」ボタンを押せば直前に閲覧していたページに戻るはずだが、この手法が使われていると正常に機能しない。
Googleの公式ブログによれば、この乗っ取りにはいくつかのパターンが存在する。代表的なものは、ユーザーが一度も訪問していないページをブラウザ履歴に強制的に挿入する手法だ。これにより、戻るボタンを押しても同じサイト内の別の広告ページや推奨記事ページが表示される仕組みになっている。
また、戻るボタンを完全に無効化したり、クリックした瞬間に別のURLへ強制リダイレクトをかけたりする悪質なケースも確認されている。これらはすべて、ユーザーの「前の画面に戻りたい」という基本的な期待を裏切る行為であり、Googleはこれをスパムと定義した。
上記の図のように、ユーザーの意図しない遷移を強制することがポリシー違反の核心だ。
技術的な仕組みと履歴の操作
この乗っ取りの多くは、JavaScriptの history.pushState() という関数を悪用して実現されている。この関数は、ページをリロードせずにブラウザの履歴スタックに新しいエントリを追加できる便利な機能だが、これを悪用すると「戻る」ボタンの行き先を勝手に書き換えることが可能になる。
例えば、ページが読み込まれた瞬間に、現在のページの履歴を2回分挿入するスクリプトが動くとする。ユーザーが「戻る」を1回押しても、履歴スタックにはまだ同じサイトのエントリが残っているため、画面が切り替わらない。このような挙動は、ユーザーに「ブラウザが故障した」あるいは「このサイトから逃げられない」という恐怖感や不快感を与える。
Googleがポリシー改訂に踏み切った背景
Googleが今回の決定を下した背景には、ウェブ全体でこの「戻るボタンの操作」を伴う悪質なサイトが増加しているという事実がある。Googleの報告によれば、多くのユーザーがこうした操作によって「操作されている」と感じ、見知らぬサイトへの訪問をためらうようになっているという。
実は、Googleは2013年の時点ですでに、ブラウザの履歴に欺瞞的なページを挿入することに対して警告を発していた。しかし、当時は「推奨されない行為」という扱いに近く、明確なスパムポリシーとしての定義はされていなかった。今回の更新により、この行為は「マルウェアの配布」や「不要なソフトウェアのインストール」と同等の「悪意のある行為」として格上げされた形だ。
検索エンジンとしての信頼性を維持するためには、検索結果から訪れたサイトがユーザーを「閉じ込める」ような挙動を許してはならない。Googleは、ユーザー体験(UX)を著しく損なう要素を排除することで、検索エコシステム全体の健全性を高めようとしている。
6月15日からの取り締まりプロセス
今回のポリシー適用には、約2ヶ月の猶予期間が設けられている。2026年6月15日以降、Googleは自動化されたシステム(SpamBrainなど)および手動レビューの両面で違反サイトの特定を開始する。違反が確認されたサイトには、検索順位の極端な低下や、検索結果からの完全な削除といった厳しいペナルティが科される可能性がある。
このスケジュール感は、2024年3月に行われた大規模なスパムアップデート(サイト評判の不正利用など)の際と同様だ。十分な準備期間を与えることで、意図せず違反状態にあるサイト運営者が修正を行う機会を提供している。
サードパーティ製スクリプトによる意図しない違反のリスク
サイト運営者にとって最も注意すべき点は、自らが意図的に乗っ取りを行っていなくても、ポリシー違反と判定される可能性があることだ。Googleのブログでは、一部の「戻るボタンの乗っ取り」は、サイトに組み込まれた外部ライブラリや広告プラットフォームが原因である可能性を指摘している。
例えば、無料で利用できるアクセス解析ツールや、コンテンツ推奨ウィジェット(レコメンドエンジン)、あるいは収益性の高さを謳う特定の広告ネットワークなどが、勝手に履歴を操作しているケースがある。運営者が「便利なツールを導入しただけ」のつもりでも、そのコードがユーザーのナビゲーションを妨害していれば、サイト全体の責任としてペナルティを受けることになる。
このため、自社のエンジニアが書いたコードだけでなく、外部から読み込んでいるすべてのスクリプトがどのような挙動をしているかを把握することが不可欠だ。特に、ページ遷移を伴わないSPA(シングルページアプリケーション)構成のサイトでは、履歴管理のロジックが複雑になりやすいため、意図しないバグが乗っ取りと見なされないよう注意が必要である。
外部ツールを導入する際は、そのツールがブラウザ履歴(History API)に干渉していないか、ドキュメントを確認したり実際にテスト環境で挙動を検証したりすることが求められる。
サイト運営者が今すぐ実施すべき対策と監査方法
猶予期間である6月15日までに、サイト運営者は自社サイトの「戻るボタン」の挙動を徹底的にチェックすべきだ。最も確実な方法は、シークレットモード(プライベートブラウジング)を使用して、一般的なユーザーと同じ条件でサイトを回遊してみることである。
チェックの際は、検索エンジンからサイトへ流入し、数ページ閲覧した後に「戻る」ボタンを連打してみる。もし、前のページに戻るために2回以上のクリックが必要だったり、見たこともない広告ページに飛ばされたりする場合は、即座に原因を特定しなければならない。開発者ツールの「Network」タブや「Console」タブを確認し、履歴を操作している不審なスクリプトが動いていないかを調査する。
もし万が一、6月15日以降に手動ペナルティ(手動による対策)を受けてしまった場合は、Google Search Consoleを通じて通知が届く。その際は問題を修正した上で、再審査リクエストを送信する必要がある。自動アルゴリズムによる順位下落の場合は通知が来ないため、定期的な順位計測とUX指標の監視が重要となる。
チェックリスト:ポリシー違反を避けるために
以下の項目に当てはまる挙動がないか、サイトの全ページを確認することを推奨する。
- 戻るボタンを1回押しただけで、直前のページ(検索結果など)に戻れるか
- 履歴スタックに、ユーザーが訪問していないURLが勝手に追加されていないか
- 戻る操作をした際に、ポップアップ広告や全画面広告が表示されないか
- 特定のサードパーティ製スクリプトを停止した状態で、戻るボタンの挙動が変わらないか
特に、収益化を優先するあまり過度な広告設定を行っているサイトや、古いJavaScriptライブラリを更新せずに使い続けているサイトは、意図せずスパムと判定されるリスクが高い。技術的な負債を解消し、ユーザーが自由にサイトを出入りできる環境を整えることが、長期的なSEOの成功につながる。
独自の分析:UXの健全化がSEOの「最低条件」になる時代
今回のポリシー更新は、Googleが「コンテンツの質」だけでなく「ブラウザ操作の安全性」を極めて重視していることの表れだ。かつては検索順位を上げるためのテクニックが注目されていたが、現在は「ユーザーに不快な思いをさせないこと」がSEOのスタートラインとなっている。
戻るボタンの乗っ取りは、短期的な滞在時間やページビュー(PV)を稼ぐためには有効だったかもしれない。しかし、そうした小細工はブランドの信頼を損なうだけでなく、今や検索エンジンによって明確に排除される対象となった。サイト運営者は、数字上の指標を追う前に、ユーザーがブラウザの標準機能をストレスなく使えるかどうかを最優先すべきだ。
また、この動きは今後、他のブラウザ操作(右クリックの禁止やテキストコピーの妨害など)にも波及する可能性がある。ウェブのオープンな性質を損なう実装は、長期的には検索トラフィックの損失を招くリスクであることを、すべてのマーケターやエンジニアは再認識すべきだろう。
この記事のポイント
- Googleが「戻るボタンの乗っ取り」をスパムポリシーの違反項目に追加した
- ユーザーの意図に反して履歴を操作し、前のページに戻らせない行為が禁止される
- 新ルールは2026年6月15日から適用され、順位下落やペナルティの対象となる
- 自社コードだけでなく、広告や外部ウィジェットなどのサードパーティ製スクリプトも監査が必要だ
- 猶予期間中に「戻る」ボタンの挙動を実機でテストし、不審な挙動を修正すべきだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験