
WooCommerce 11.0が商品オブジェクトキャッシュを標準化!新規ストアは自動有効
WooCommerce 11.0がリリースされ、商品オブジェクトキャッシュが新規ストア向けにデフォルトで有効化された。この機能は、商品ページやチェックアウト処理で同じ商品データを何度もデータベースから取得する無駄を省き、ECサイトの表示速度を底上げする。
可変商品がある製品ページでは約9〜12%、バンドル商品を含むチェックアウト処理では6〜12%の処理速度改善が報告されている。今回の変更は、WooCommerce 10.5で実験的導入が始まったキャッシュ機構が安定動作の段階に達したことを示している。
新規にWooCommerce 11.0以上をインストールしたストアには自動で適用されるが、アップグレードした既存ストアの設定は一切変更されない。必要に応じて管理画面から手動でオンにできる仕組みだ。
商品オブジェクトキャッシュの仕組みとパフォーマンス改善の数字
リクエスト内で商品データを使い回すメモリ内キャッシュ
このキャッシュは、一度のHTTPリクエストの間だけ生きている、揮発性のメモリ内キャッシュだ。wc_get_product(123)が呼ばれると、キャッシュに保存されていればデータベースに問い合わせず、すぐに商品オブジェクトの複製を返す。リクエストが終わればキャッシュは完全に消去されるため、次のリクエストで古い情報が残る心配はない。
特に、wc_get_product()を同じIDで何度もコールするパターンが多いテーマやプラグインで効果が大きい。各呼び出しが独立したオブジェクトのクローンを返すため、意図せず商品データの状態を共有してしまうバグも防げるようになった。
このデモは、同じ商品IDに対する繰り返し呼び出しがキャッシュによってどれだけ無駄を省けるかを示している。実際のECサイトでは、商品ループやセール情報の取得、決済フローの中で wc_get_product() が頻繁に呼ばれるため、体感速度の改善が期待できる。
実測値として9〜12%の高速化
WooCommerce 10.5の実験的導入時に公表されたパフォーマンス測定値は、今回の正式適用後も同じだ。可変商品(サイズや色のバリエーションがある商品)の製品ページでは、読み込み時間が9〜12%短縮された。バンドル商品を含むチェックアウト処理では6〜12%高速化されている。
この改善幅は、商品データを繰り返し取得する重いクエリがページ表示のボトルネックになっている状況で顕著だ。小規模なサイトでは効果が体感しにくいケースもあるが、商品数が多いストアや複雑な製品構成のサイトでは、目に見える速度向上が得られる。
WooCommerce 10.5から11.0への段階的な導入プロセス

10.5で実験的機能として登場、10.6で互換性の宣言が「互換」に
商品オブジェクトキャッシュは、WooCommerce 10.5で「実験的機能」として初めて公開された。当時はデフォルトで無効であり、ストア運営者が手動でオンにする必要があった。機能自体は、wc_get_product()の呼び出しをインターセプトし、リクエスト単位のメモリ内キャッシュからデータを返す仕組みだ。
WooCommerce 10.6では、この機能のプラグイン互換性宣言が「非互換」から「互換」に変更された。実験期間中に拡張機能エコシステム全体で互換性の問題が一切報告されなかったため、明示的に互換性を宣言していない拡張機能も、デフォルトで互換とみなされるようになった。
もし拡張機能が明示的に「この機能とは非互換」と宣言している場合は、WooCommerceの機能画面に従来通り非互換の通知が表示される。しかし、そのような宣言が必要になった拡張機能は見つかっていない。
11.0で新規ストアへの自動有効化を実装
WooCommerce 11.0のクリーンインストール時には、インストールプロセスの一環として商品オブジェクトキャッシュが自動で有効になる。機能登録自体は enabled_by_default => false のまま変更されていないが、新規インストール時に明示的に有効化が書き込まれる仕組みをとっている。
これは、HPOS(High-Performance Order Storage)など、他の機能がオプトインから新規インストール時デフォルトへ移行した際と同じパターンだ。バージョンアップだけでは既存ストアの設定を変更しない、慎重な設計が貫かれている。
既存ストアの挙動と手動有効化の手順

アップグレードしても設定は一切変わらない
WooCommerce 11.0より前に構築されたストアは、11.0へアップグレードしても既存のキャッシュ設定がそのまま維持される。もし以前に無効だった(それが11.0以前のストアのデフォルト設定だ)なら、アップグレード後も無効のままだ。すでに手動で有効にしていたストアは、そのまま有効が継続される。
つまり、次の3パターンに整理できる。
- WooCommerce 11.0以降を新規インストール → 自動的に有効(操作不要)
- 既存ストアで機能が無効だった → アップグレード後も無効のまま(手動で有効にできる)
- 既存ストアで機能が有効だった → アップグレード後も有効のまま(操作不要)
手動で有効化する方法
既存ストアでこの機能を試したい場合、管理画面の WooCommerce → 設定 → 詳細設定 → 機能 にアクセスし、「商品オブジェクトをキャッシュする(Cache Product Objects)」のトグルをオンにすればよい。ただし、設定変更後にサイト全体の動作を一通りチェックしておくことが推奨される。
トグルをオンにすると、その瞬間からリクエスト単位の商品キャッシュが働き始める。とくに、複数の拡張機能が同じ商品データにアクセスする大規模ストアでは、即効性のある改善が期待できるだろう。
拡張機能開発者への影響と注意点

標準APIを使っていればコード変更は不要
wc_get_product() やその他 WooCommerce 標準 API を通じて商品を取得している拡張機能は、このキャッシュの影響をまったく受けない。キャッシュは内部で透過的に動作し、呼び出し元には変わらず正しい商品オブジェクトが返る。
キャッシュから返されるのは、あくまで独立したクローンなので、取得した商品オブジェクトを編集しても他の処理に副作用が及ぶことはない。したがって、従来のコーディング規約に従っている拡張機能は、そのまま動作し続ける。
直接SQLを実行する拡張機能が注意すべきポイント
注意が必要なのは、WooCommerceのメタフックを経由せずに、商品データに対して直接SQLクエリを発行している拡張機能だ。これらのクエリはキャッシュの無効化フックを迂回するため、更新後のデータがキャッシュに反映されず、古い情報が返ってしまう可能性がある。
この問題は、商品オブジェクトキャッシュに限った話ではなく、WooCommerceのデータ整合性全般に関わる設計課題だ。該当する拡張機能を開発している場合は、標準の wc_get_product() やメタデータ更新用のAPIを使うことで、キャッシュの恩恵を受けつつ、データ不整合も回避できる。
今後のロードマップと全ストアへの有効化計画

データ蓄積後に全ストアで有効化へ
今回のリリースは通過点であり、最終的にはすべてのストア(既存ストアも含む)で商品オブジェクトキャッシュを有効化する計画が示されている。現時点で具体的な実施時期は明言されていないが、十分なストアでの稼働データが蓄積された段階で判断される。
すでに実験期間で問題が報告されていないこと、新規インストールのデフォルト有効化でさらなる実績が積み上がることを踏まえると、早ければ数バージョン後には全ユーザー対象の強制有効化に踏み切る可能性が高い。
問題が発生した場合の報告先
もし商品オブジェクトキャッシュに関連して予期せぬ挙動が見つかった場合、WooCommerceのGitHubリポジトリでIssueを報告してほしいと開発チームは呼びかけている。拡張機能開発者やストア運営者からのフィードバックが、今後の安定化に直結する。
この記事のポイント
- WooCommerce 11.0 で商品オブジェクトキャッシュが新規ストア向けに自動有効化された
- 可変商品の製品ページ読み込みは 9〜12% 高速化、バンドル商品のチェックアウトは 6〜12% 改善
- 既存ストアはアップグレードしても設定変更なし、管理画面から手動でオンにできる
- 標準の WooCommerce API を使う拡張機能はコード変更不要で動作する
- 最終的には全ストアで有効化される予定で、Issue 報告を募っている

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Action Scheduler 4.0.0の変更点、WooCommerceのテーブル肥大化を抑制
WooCommerceの裏側で動くAction Schedulerは、多くのデータベースの中でも特に負荷の高いテーブルを持つ。高トラフィックのストアでは、完了した処理を削除する仕組みが追いつかず、失敗したアクションは一切消えないまま蓄積し続けることが問題になっていた。4.0.0はその根本に手を入れたメジャーアップデートだ。失敗アクションの保持期間をデフォルトで3か月に制限し、クリーンアップを専用のデイリージョブとして分離した。これにより、アクションとログのテーブルサイズが際限なく肥大化する状態を防げる。
本バージョンは7月28日リリース予定のWooCommerce 11.0にバンドルされ、すでにWordPress.orgで単独でも入手可能だ。互換性を壊す変更が複数含まれているため、拡張機能を開発している人や大規模ストアを運用している人は、4.0.0での動作検証を早めに始める必要がある。
4.0.0が狙う根本的なテーブル肥大化の抑制
Action SchedulerはWordPress管理画面での注文処理やメール送信など、WooCommerceの非同期ジョブを支えるコアライブラリだ。これまでは小さなバグフィックスが中心で、3.9.x台を刻んでいた。しかし今回、互換性を壊す複数の変更をまとめて投入するため、バージョン番号が4.0.0にジャンプした。WordPress形式のバージョン付けでは3.9.3の次は3.10ではなく4.0だから、意図的な動きといえる。
失敗アクション 無期限で保持
クリーンアップ キュー処理のついでに小分け
専用ジョブ 毎日3時に一括処理
バッチサイズ 最低250件、最大まで連続
このデモが示すように、クリーンアップの仕組みが根本から見直された。特に失敗アクションが自動削除の対象になった点と、削除処理が専用ジョブとして分離された点が、テーブル肥大化を抑える大きな柱だ。
互換性の壁を越えるメジャーバージョンアップ
4.0.0ではWordPress 6.8以上の動作要件が課せられ、WordPress 7.0との互換性も明示された。これは今後のWooCommerceエコシステムにとって、基盤環境を一段上げる布石でもある。また、後述するユニークアクションの判定変更は、同じフックでも引数が異なれば別物として生成されるようになり、既存コードの重複防止ロジックに影響を与える可能性がある。
失敗アクションの保持期間を3か月に制限
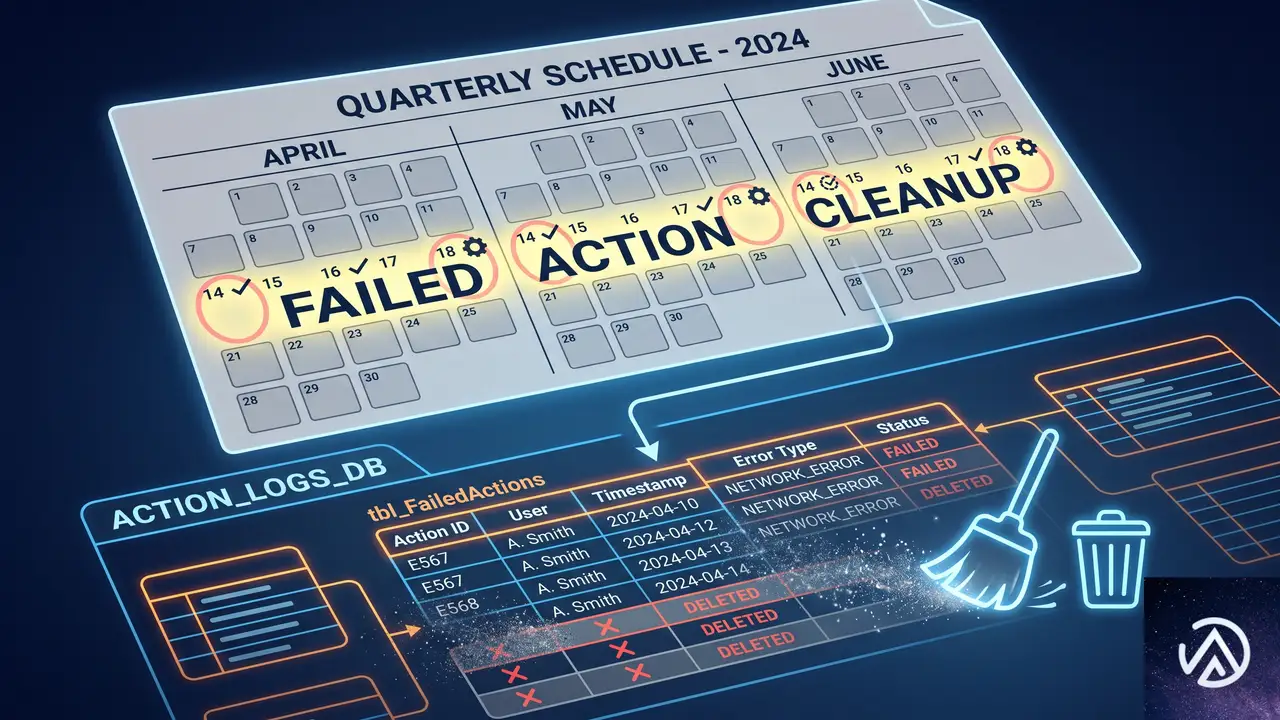
これまでAction Schedulerは、完了とキャンセルのアクションだけを削除していた。失敗ステータスのアクションは、自らフィルターで追加しない限り永久に残り続けた。多忙なストアではこれが原因でアクションテーブルとログテーブルが無制限に成長し、自力で回復できない状況に陥っていた。4.0.0では、失敗アクションが発生から3か月を超えると自動的に削除される専用のクリーンアップパスがデフォルトで有効化された。
3か月という期間は、典型的な四半期会計サイクルに合わせつつ、障害調査のための十分な猶予を残す設計だ。より厳格なデータ保持ポリシーを持つストアでは、action_scheduler_retention_period_for_failedフィルターで秒単位の期間を変更できる。あるいはaction_scheduler_enable_failed_action_cleanupに__return_falseを渡せば、4.0.0以前と同じく無期限保持に戻せる。
注目すべき点は、既にaction_scheduler_default_cleaner_statusesフィルターで失敗ステータスを追加していた場合、そちらの設定が優先されることだ。その場合は、4.0.0の新しい失敗専用パスではなく、既存のクリーンアップサイクルに統合されるため、動作が変わることはない。
クリーンアップを専用のデイリージョブに分離
旧バージョンでは、古いアクションの削除はキューの各バッチ処理にインラインで埋め込まれ、一度に少量しか処理されなかった。そのため、処理量の多いストアではクリーンアップが追いつかず、テーブルが大きくなる一方だった。4.0.0では、クリーンアップを独立したタスクとし、サイト時刻で毎日午前3時に一度だけ実行する方式に変更された。
この方式により、削除処理が通常のキュー処理のパフォーマンスに影響を与えなくなり、大規模テーブルでも遅延なく追いつけるようになった。バッチサイズはaction_scheduler_cleanup_batch_sizeフィルターで変更可能で、デフォルトの250件より少なくも多くもできる。もし従来のインライン方式に戻したい場合は、カスタムキュークリーナーを実装すれば自動的にそちらが使われるが、ほとんどのサイトではその必要はないだろう。
ユニークアクションの判定に引数が加わった
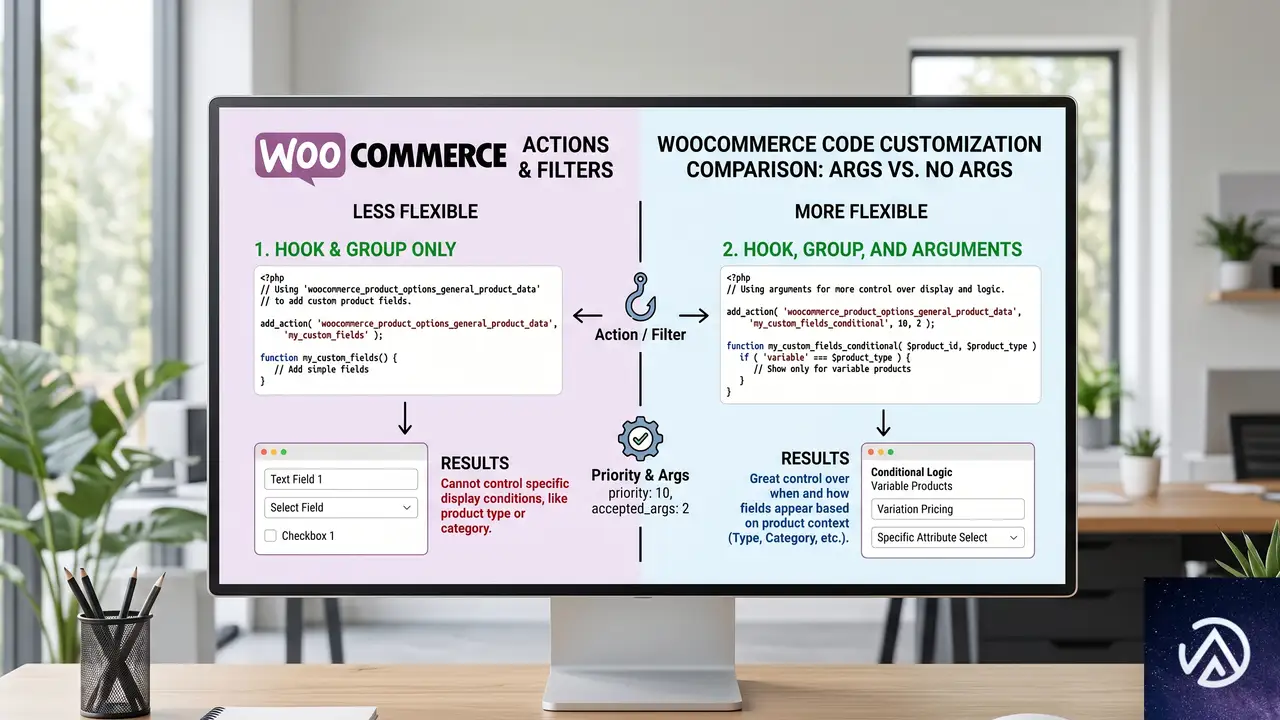
as_enqueue_async_action()やスケジュール系関数の$uniqueパラメータは、同じアクションが重複して生成されるのを防ぐためのものだ。従来はフック名とグループだけを比較していたため、引数が異なる2つのアクションでも同一とみなされ、後のほうが黙って破棄される挙動だった。これが4.0.0では、引数の内容まで含めて同一性を判定するように変更された。
この変更は互換性を壊すため、特に注意が必要だ。旧来のフックとグループだけの重複防止に依存していたコードでは、これまでよりも多くのアクションが生成されるようになる。意図しない大量のジョブがキューに積まれないよう、$uniqueを使っている箇所は必ず見直してほしい。
WooCommerceサイトへの実務的な影響と移行のポイント
4.0.0はWooCommerce 11.0のバンドルに先立って単独テストが可能だ。大規模ストアや独自の拡張機能でAction Schedulerを利用している開発者は、以下の3点を中心にステージング環境で動作検証を行うことを推奨する。
- 失敗アクションの保持ポリシー
3か月のデフォルトが自社のデータ保持要件に合致するか確認し、必要ならフィルターで調整する。 - ユニークアクションの重複防止ロジック
$unique=trueを使用している全箇所を洗い出し、引数が異なるアクションが正しく生成されるかテストする。 - クリーンアップの実行タイミング
デイリージョブへの移行により、削除がバッチ処理から外れたことで、期待していたリアルタイム性が失われていないか確認する。必要に応じてカスタムクリーナーを実装する。
開発元のWooCommerceチームはGitHubでフィードバックを募集しており、予期しない動作があれば早期に報告するよう呼びかけている。WooCommerce 11.0の正式リリースまで1か月あまり。致命的なトラブルを回避するために、今のうちに4.0.0との互換性テストを済ませておくことが賢明だ。
この記事のポイント
- Action Scheduler 4.0.0はテーブル肥大化を防ぐため、クリーンアップの仕組みを根本から見直したメジャーアップデート
- 失敗アクションがデフォルトで3か月後に自動削除されるようになり、保持期間のカスタマイズも可能
- クリーンアップが専用のデイリージョブとして実行され、キュー処理のパフォーマンスに影響しなくなった
- ユニークアクションの重複チェックに引数が含まれるようになり、既存の重複防止ロジックへの影響に注意が必要
- WooCommerce 11.0へのバンドル前に単体テストを行い、互換性の問題を早期に発見することが重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PostgreSQLで大規模削除をスケールさせるならDROP TABLE一択
PostgreSQLでテーブルから大量の行を削除する必要に迫られたとき、DELETE文をそのまま使うのは最悪の選択肢のひとつだ。一見直感的ではないが、大規模なDELETEはデータベースに余計な仕事を追加するだけに終わる。
一方で、DROP TABLEやTRUNCATEはテーブルごと削除することで、デッドタプルやバキュームといった負債を生まず、即座にディスク領域を開放する。この記事では、なぜDELETEがスケールしないのか、そしてDROP TABLEがなぜ高速なのかをMVCCや物理ストレージの観点から解説する。
さらに、大量の不要データが混入したテーブルを安全にクリーンアップする実践的な手法や、日常的な削除処理をパーティショニングでDROPに変える設計術も紹介する。
なぜDELETEはスケールしないのか
このデモはDELETEとDROP TABLEのデータ処理フローの違いを示している。DELETEはデッドタプルとバキュームという負債を生み、領域をOSに返さない。DROP TABLEはファイル削除だけで完了する。
MVCCとデッドタプルの正体
PostgreSQLは行が更新されるたびに、元の行を「古いバージョン」として内部に保持する。これはMVCC(Multi-Version Concurrency Control / マルチバージョン同時実行制御)と呼ばれ、異なるトランザクションがそれぞれの時点のデータを正しく読み取れるようにする仕組みだ。
この設計では、DELETE文を実行しても行が物理的に即座に消えるわけではない。削除された行は「デッドタプル」としてテーブルやインデックスに残り続ける。後にバキューム処理がそれらを回収して領域を再利用可能にするが、その間も読み取りクエリはデッドタプルをスキップするためのオーバーヘッドを負う。
さらに、通常のバキュームや自動バキューム(autovacuum)は、デッドタプルが占めていたページを「書き込み可能」とマークするだけで、OSにディスク領域を返還しない。PostgreSQLはINSERTとDELETEが混在するワークロードで領域を再利用しやすいようにこの挙動を選んでいる。OSへの領域返還にはVACUUM FULLが必要だが、長時間の強力なロックを伴う。
レプリケーションとバキュームの重み
DELETEは書き込み操作としてWAL(Write Ahead Log)に記録され、レプリカにも転送される。同期レプリケーション環境では、大量のDELETEがコミットされるまで他の書き込みトランザクションが待たされる可能性がある。つまり、DELETEは「それ自体が負荷を増やす」のであり、後片付けもバキュームに丸投げする形になる。
インデックスに関しても、DELETE実行時にインデックスのエントリは即座に消されない。読み取り時に「このタプルは無効か」を逐一判定する必要があり、インデックススキャンがデッドタプルを見つけた場合、ベストエフォートでそのエントリを無効化する最適化はあるものの、根本的なオーバーヘッドは残る。
DROP TABLE/TRUNCATEが高速な理由
DROP TABLEとTRUNCATEはテーブルに対してAccessExclusiveLock(アクセス排他ロック)を取得するため、他のトランザクションがそのテーブルを読み書きできなくなる。しかし、処理そのものはデータ量にほぼ依存しない。内部的にはテーブルに関連する物理ファイルをOSから直接削除し、共有バッファキャッシュからも該当ページのメタデータを一掃する。
PostgreSQLの共有バッファは8KBのページ単位で管理され、各ページに64バイトの固定サイズのヘッダが付与される。テーブル削除時にスキャンするのはページ本体ではなく、このヘッダ情報のみだ。例えば128GBの共有バッファがあっても、スキャンするメタデータは全体の1/128の約1GBに過ぎず、シーケンシャルアクセスで高速に処理できる。これがデータサイズに依存しない真の理由である。
一時的な大量削除への実践アプローチ
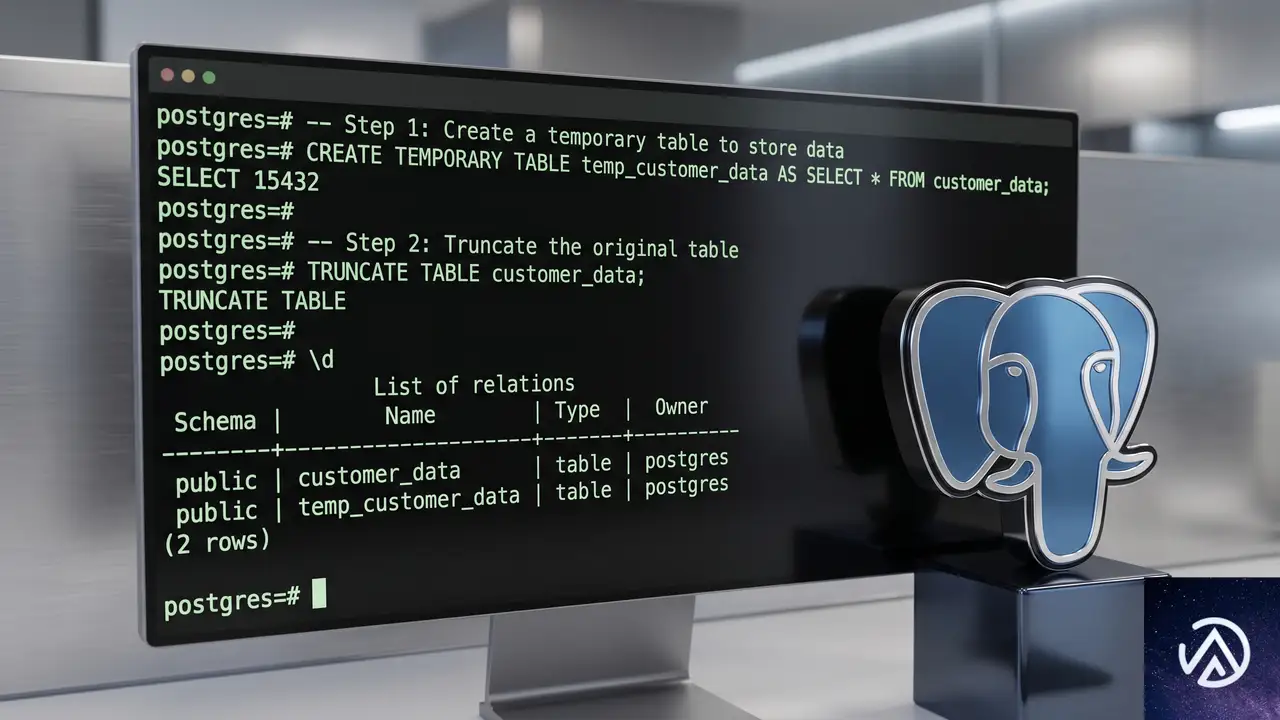
テンポラリテーブルを使った外科手術
バグによってテーブルに大量の不要データが混入したケースを考えよう。保持すべきデータは数十万行程度で、残りはすべて削除対象だ。ダウンタイムが数分許容できるなら、以下の手順で一気にクリーンアップできる。
-- 1. 対象テーブルを排他ロック
LOCK TABLE big_table IN ACCESS EXCLUSIVE MODE;

-- 2. テンポラリテーブルに保持したいデータだけコピー
CREATE TEMP TABLE temp_keep_big_table AS
  SELECT * FROM big_table
  WHERE updated_at >= '2026-04-01';

-- 3. 元テーブルをTRUNCATE
TRUNCATE big_table;

-- 4. テンポラリテーブルからデータを再挿入
INSERT INTO big_table SELECT * FROM temp_keep_big_table;
この手順ではテーブルを完全にロックするため、オンラインサービスではダウンタイムが発生する。しかし、ロック時間が分単位で許容できるメンテナンスウィンドウがあるなら、数十万行のテーブルでも数分で処理できる。実際にPlanetScale社内のオブザーバビリティツールで同様のケースが発生し、この手法で問題を解決している。WALに書き込まれるのは、4の再挿入で戻された行だけであり、DELETEによる膨大なログは一切発生しない。
トリガーを使ったゼロダウンタイムの切り替え
より高度な手法として、テーブルへの書き込みを新しいテーブルにミラーリングし、タイミングを見計らってアトミックなリネームで切り替える方法がある。具体的には、元のテーブルにトリガーを設定して、INSERTやUPDATE、DELETEを新テーブルにも反映させる。十分にデータが同期された段階で、短時間の排他ロックを取得し、テーブルをリネームして差し替える。
このアプローチはPostgreSQLの拡張であるpg_squeeze(pg_repackの後継)が行っていることと本質的に同じだ。ただし、pg_squeezeは既に肥大化したテーブルを最適化するためのツールであり、この記事で伝えたいのは「設計段階で大規模DELETEを避けておく」ことである。初めからスキーマをコントロールできれば、こうした事後対応は不要になる。
パーティショニングで日常的な削除をDROPに置き換える
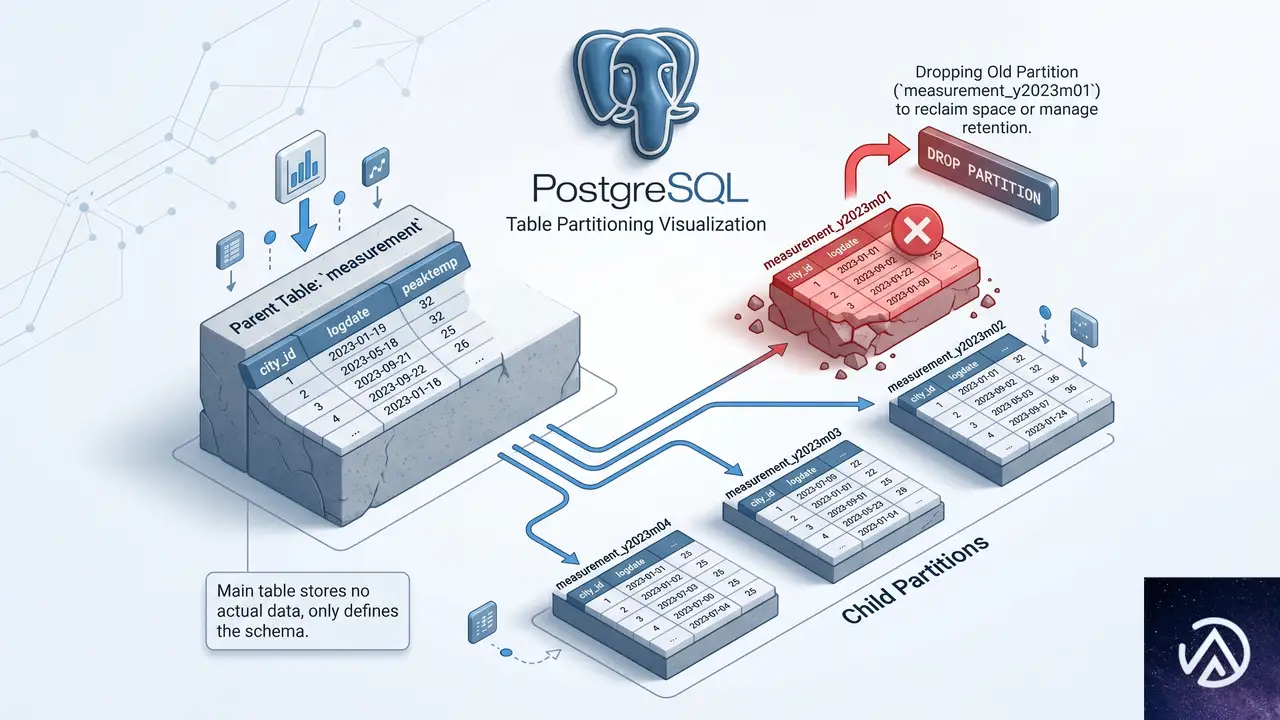
このデモは日付パーティションを使ったエージングアウトと、DROP TABLEによる高速な領域解放の流れを示している。
PostgreSQL 10以降、パーティショニング機能が大幅に強化された。親テーブルの背後に子テーブルを複数持ち、クエリは自動的に該当の子テーブルに振り分けられる。日付ベースのRANGEパーティションを使えば、過去のデータを保持する子テーブルを定期的にDROP TABLEするだけで、古いデータを一瞬で削除できる。これは、数百万行単位のDELETEを定常的に実行していたワークロードを、数秒のDROP TABLEに置き換える強力なテクニックだ。
pg_partman拡張を利用すれば、子テーブルの自動作成や古いパーティションの削除をスケジュール実行できる。また、パーティショニングは再帰的に構成できるため、より高度な設計も可能だ。たとえば、最上位をLISTパーティションで「可視行」と「不可視行」に分け、「不可視行」の子テーブルをさらにRANGEパーティションで日付ごとにエージアウトさせる、といった多次元の構成が組める。
スキーマ設計でDELETEをDROPに置き換える視点
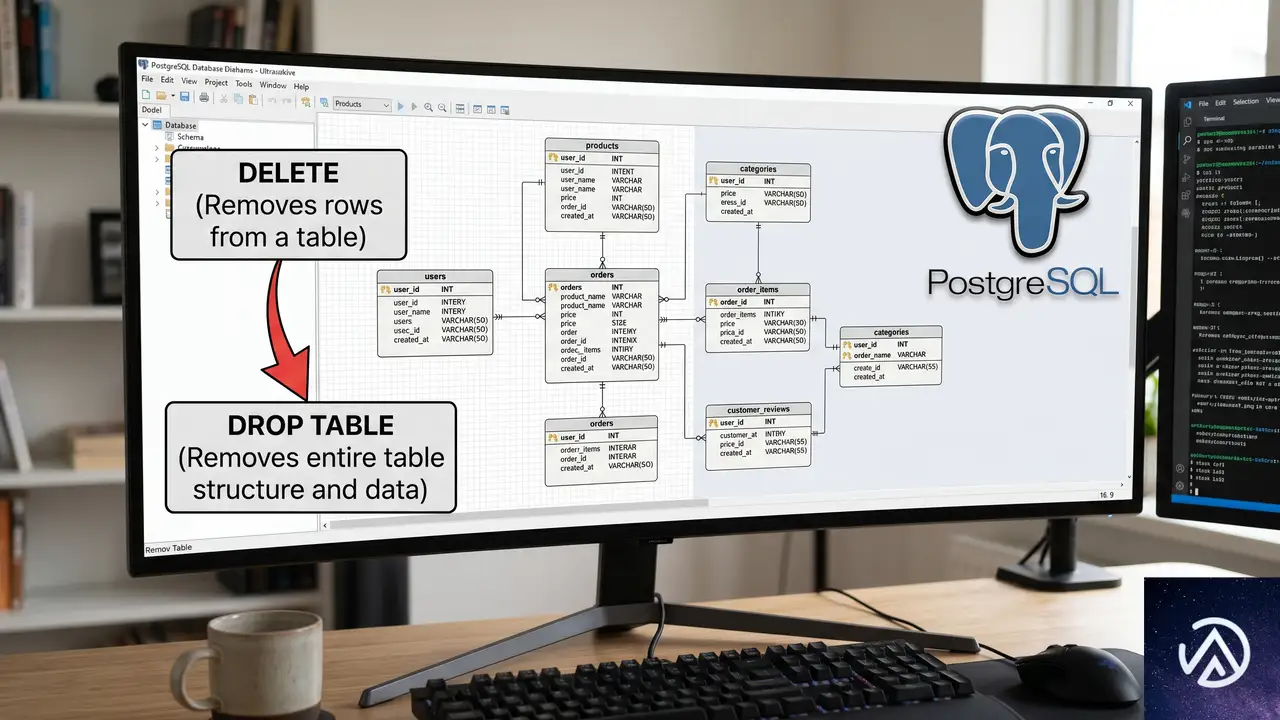
大量データを削除する必要が生じるアプリケーションでは、テーブル設計の段階からDELETEをDROPやTRUNCATEで代替できるか検討することが重要だ。DELETEを多用しない設計にすることで、読み取りクエリのレイテンシ低減、レプリケーションラグの抑制、バキューム負荷の軽減といった効果が期待できる。
パーティショニングしかり、トリガーベースのテーブル差し替えしかり、選択肢は多様だ。PostgreSQLのMVCCが持つ根本的な制約を理解し、大規模な行削除は「テーブルごと破棄して必要なデータだけを再構築する」という発想でスキーマを組み立てる。その結果、データベースの健全性は飛躍的に向上する。
この記事のポイント
- DELETEはデッドタプルを生成し、バキュームやレプリケーションに余計な負荷をかける。大規模削除には向かない
- DROP TABLEやTRUNCATEはデータ量に依存せず、物理ファイルの削除とバッファキャッシュのメタデータスイープで瞬時に領域を解放する
- 一度きりの大量削除はテンポラリテーブルとTRUNCATEの組み合わせが有効。ダウンタイムを許容できるなら強力な手法
- 定常的な古いデータの削除には、パーティショニングでDROP TABLEに置き換える設計が有効。日付パーティションとpg_partman拡張で自動化できる
- アプリケーション設計時に「大量削除が必要なテーブル」をDROPできるようスキーマを工夫することで、データベースの健全性を大幅に向上できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Graviton5搭載EC2 M9g/M9gdがGA。汎用インスタンス性能限界突破の全容
AWSが2026年6月10日、Graviton5プロセッサを搭載したEC2 M9gおよびM9gdインスタンスの一般提供を開始した。Armアーキテクチャベースの第5世代カスタムシリコンであり、前世代比で最大25%の計算性能向上を実現したとされている。
2025年末のプレビュー公開から半年、ClickHouseやHoneycombといった企業が実運用環境で検証を重ね、コード変更ゼロで36%の性能向上を確認している。HubSpotではMySQLデータベースのクエリ処理時間が最大60%短縮されたとの報告もある。
Arm系インスタンスはこれまでも存在したが、192コア、5倍のL3キャッシュ、DDR5-8800対応メモリを搭載したGraviton5は次元が異なる。本記事ではM9g/M9gdの技術的進化と、それがビジネスにどう影響するかを具体的に解説する。
Graviton5とは何か。5世代の進化がもたらしたもの
AWSのGravitonプロセッサは、Armアーキテクチャを採用したAWS独自設計のカスタムシリコンだ。第1世代が登場したのは2018年。以来8年にわたり継続的に投資が続けられ、現在では350以上のインスタンスタイプがGravitonで稼働している。
Arm系クラウドインスタンスの現在地
Armアーキテクチャとは、スマートフォンやタブレットで広く使われている省電力設計のCPU命令セットだ。これに対し、従来のサーバCPUの多くはx86アーキテクチャ(IntelやAMDが採用)で動作していた。Armは消費電力あたりの処理効率に優れており、クラウドの大規模データセンターで電気代を抑えつつ高性能を発揮できる点が評価されている。
AWS広報情報によれば、現在12万以上の顧客がGravitonを採用。スタートアップから大企業まで幅広く、Webアプリケーション、マイクロサービス、データベース、機械学習推論、ゲームサーバ、動画エンコーディングなど多様な用途で使われている。x86依存の強い従来のクラウド常識を、Armが着実に塗り替えつつある。
クラウドインスタンスの選択肢は、この5年で一変した。Armはもはや「実験的な選択肢」ではなく、x86と並ぶ本流の一つとして位置づけられる。特にGraviton5では、その傾向がさらに加速するだろう。
Graviton5が前世代から飛躍した3つの要素
Graviton5の改良点を、AWS公式発表から整理する。最も注目すべきは次の3つだ。
- 計算性能の大幅向上:Graviton4比で最大25%の計算性能向上。Webアプリケーションで最大35%、機械学習推論で最大35%、データベースで最大30%の高速化が実測されている
- 5倍のL3キャッシュ:CPUが頻繁にアクセスするデータを一時保存する高速メモリ領域が前世代比5倍に拡大。コア間のデータ待ち時間が最大33%削減された
- DDR5-8800メモリとPCIe Gen6対応:クラウド上のプロセッサインスタンスとして最速水準のメモリ帯域幅を実現。PCIe Gen6はGen5比でデータ転送速度が2倍となり、NVMeストレージや高速ネットワークとの連携性能が飛躍的に伸びる
L3キャッシュの増量は、単なる数値スペックの向上ではない。CPUは計算のたびにメインメモリまでデータを取りに行くと時間がかかる。L3キャッシュが大きければ近くにデータを置けるため、処理待ちが減り、結果として体感性能が大きく向上する仕組みだ。
実際にAWSの広報記事で紹介された顧客事例では、ClickHouseがコード変更なしでM8g比36%の性能向上を達成。Honeycombは6カ月にわたるA/Bテストで、コアあたりのスループットが36%向上したと報告している。これらの数字は、CPUそのものの改良がアプリケーションレベルで直接的な効果を生むことを示している。
M9g/M9gdのラインアップと性能スペック
インスタンスサイズと性能の詳細
M9gは汎用用途向けで、1vCPUあたり4GiBのメモリ比率を採用している。M9gdはこれに加え、高速ローカルNVMe SSDストレージを搭載したバリエーションだ。ラインアップは1vCPUの小規模構成から、192vCPU・768GiBメモリの大規模構成まで幅広く用意されている。
最大サイズの48xlarge(192vCPU)では、ネットワーク帯域が100Gbpsに達する。前世代比で最大2倍の帯域幅になっており、大量のデータを扱うデータベースやログ処理基盤での効果が特に大きい。
IBC(Instance Bandwidth Configuration)の実用性
M9g/M9gdでは、IBC(インスタンス帯域幅設定)と呼ばれる新機能が利用可能になった。これはEBS(永続ストレージ)とVPCネットワーク間で、帯域幅の配分を最大25%調整できる仕組みだ。
たとえばデータベースサーバではEBSへの書き込み性能がボトルネックになりやすい。IBCを使えばEBS側に帯域を多めに割り当て、クエリ処理やログ書き込みを高速化できる。ネットワーク通信が少ないバッチ処理やキャッシュサーバでも有効だ。
Nitro Isolation Engineが実現する「数学的に証明されたセキュリティ」
Graviton5と同時に発表された技術の中で、最も静かでありながら最も革新的なものがNitro Isolation Engineだ。聞き慣れない用語だが、クラウドセキュリティの考え方を根本から変える可能性がある。
形式検証(Formal Verification)とは何か
通常、ソフトウェアのセキュリティは「テスト」で検証する。攻撃パターンを想定し、実際に動かして問題がないかを確認する手法だ。しかしこの方法では、想定外の攻撃や未知の脆弱性を見逃すリスクが常に残る。
形式検証(Formal Verification)はこれとは根本的に異なる。数学の定理証明と同じアプローチで、「このシステムは絶対に想定外の動作をしない」ことを数理的に証明する技術だ。特定のテストケースだけでなく、あらゆる入力パターンで期待通りに動作することを保証する。
AWSによれば、Nitro Isolation Engineはこの形式検証を適用したクラウドハイパーバイザーとして業界初の事例となる。ハイパーバイザーとは、1台の物理サーバ上で複数の仮想マシンを安全に隔離する基盤ソフトウェアだ。この隔離機能が破られると、他の顧客のデータにアクセスされる重大なセキュリティ事故につながる。Nitro Isolation Engineは、その隔離が破られる可能性を数学的にゼロにする設計となっている。
この技術は金融機関や医療機関など、厳格なデータ保護が求められる業界にとって特に重要な意味を持つ。セキュリティ監査のレベルが一段引き上げられることになるからだ。なおNitro Isolation EngineはM9g/M9gd専用の機能であり、既存のインスタンスタイプには搭載されない。
エージェントAI時代のCPU需要とGraviton5の位置づけ
AIが「考える」から「行動する」へのシフト
ここ数年、AIの進化は大規模言語モデル(LLM)のテキスト生成能力に注目が集まってきた。しかし現在、AIの主戦場は「質問に答える」から「行動を実行する」へと急速に移行している。いわゆるエージェントAIと呼ばれる分野だ。
エージェントAIとは、ユーザーの指示に対して、コードを実行し、ツールを使い、結果を評価し、複数ステップのタスクを自律的に組み立てるAIシステムを指す。たとえば「今月の売上データを分析してグラフ化し、経営陣向けのサマリをSlackに投稿して」という指示に対し、AIがデータベースに接続し、集計処理を実行し、グラフを生成し、メッセージを送信する一連の流れを自律的に処理する。
このような処理は、GPUなどのアクセラレータだけで完結しない。指示の解釈、コードのコンパイル、データベースクエリの実行、APIの呼び出しなど、CPUに依存する処理が大量に発生する。AWSの広報記事で、MetaがエージェントAI基盤として数千万コア規模のGravitonを導入していると報告されているのは、このトレンドを象徴している。
エージェントAIが実用段階に入るにつれ、クラウド上のCPU需要はむしろ増大する。Graviton5が192コアという高密度設計を採用したのは、こうした並列処理ニーズを先取りしたものといえる。
Web開発者にとっての実務的意味
中小企業のWeb担当者や個人事業主にとって、「エージェントAI」や「192コア」という言葉は遠い世界に感じられるかもしれない。しかし実際には、以下のような形でM9gの恩恵は身近な領域に及ぶ。
- MySQL/PostgreSQLの応答速度向上:HubSpotの事例ではクエリ時間が最大60%短縮。WordPressサイトやECサイトのデータベース応答が高速化する可能性がある
- コスト効率の改善:Graviton5はGraviton4比でエネルギー効率も向上。同じ処理をより少ない電力で実行できるため、ランニングコストの削減につながる
- セキュリティの底上げ:Nitro Isolation Engineによる隔離保証は、顧客データを扱うあらゆるサービスに恩恵がある
重要なのは、これらの恩恵がコード変更ゼロで得られるケースが多い点だ。ClickHouseやHoneycombの報告にあるように、Armネイティブ対応が済んでいるアプリケーションであれば、インスタンスタイプをM8gからM9gに変更するだけで性能向上が見込める。
M9g/M9gdへの移行を検討する際の実践ステップ
Graviton5インスタンスの利用を始めるには、いくつかの準備と確認が必要だ。AWS公式が提供する移行ガイドやツールを活用すれば、想定よりスムーズに移行できる。
Arm対応状況の確認と移行パス
最初に行うべきは、現在稼働中のアプリケーションがArmアーキテクチャに対応しているかの確認だ。Java、Python、Node.js、Go、PHPなど主要な言語ランタイムはすでにArm対応が完了している。ただし、x86固有のアセンブリコードを含むC/C++プログラムや、特定のx86向けバイナリに依存しているアプリケーションでは注意が必要になる。
Javaアプリケーションの場合、AWSが提供する「AWS Transform」というAI支援サービスが利用できる。x86用にコンパイルされたJavaアプリケーションをArm向けに自動変換し、互換性分析や依存関係の更新まで処理するツールだ。コードの書き換えが必要なケースでも、変換作業の多くを自動化できる。
コスト面の評価ポイント
M9g/M9gdは、Savings Plans、オンデマンド、スポットインスタンス、Dedicated Hostsのいずれでも購入可能だ。一般にGraviton系インスタンスはx86系より低価格に設定されており、さらにSavings Plansを組み合わせることで長期利用時のコストを大幅に抑えられる。
AWS公式が提供する「Graviton Savings Dashboard」を使えば、Graviton移行によるコスト削減効果を可視化できる。費用対効果を数字で把握しながら、段階的に移行を進めるのが実務的なアプローチだ。
この記事のポイント
- AWS Graviton5搭載M9g/M9gdが一般提供開始。前世代Graviton4比で最大25%の計算性能向上
- ClickHouseで36%、HubSpotのMySQLクエリで最大60%の高速化を実測。コード変更不要のケースが多い
- Nitro Isolation Engineにより、形式検証を用いた数学的に証明されたVM隔離をクラウドで初めて実現
- エージェントAIの普及でCPU需要が急増する中、192コアの高密度設計が新たな計算基盤として台頭
- 移行にはArm対応状況の確認から段階的に進めるのが安全。AWS TransformやSavings Dashboardが支援ツールとして利用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerceモノレポのビルドが大幅高速化、コールドビルド60%減。メモリ使用量84%削減
WooCommerceのモノレポ(単一リポジトリ)を使った開発において、ビルドにかかる時間とメモリ消費が大幅に改善された。2026年6月5日、Developer WooCommerce Blogで公開された記事によると、コールドビルド時間が60%削減、ウォッチ(ファイル監視)の準備完了時間が75%短縮、開発時ウォッチプロセスのメモリ使用量が84%削減されたという。
計測環境はM4 Maxプロセッサ(48GB RAM、macOS 26)で、ベースラインから顕著な低下を確認している。一連のプルリクエストによってビルドプロセスを再設計し、開発者体験を飛躍的に向上させた内容を解説しよう。
本記事では、実際に実施されたビルド最適化の技術的詳細と、今後のCIスループット向上計画を紹介する。
WooCommerceモノレポのビルドが抱えていた課題
WooCommerceのコードベースは多数のパッケージと連携しており、開発時のwatch:buildコマンドは最大128個のプロセスを起動していた。それぞれがESM(ECMAScript Modules)やCJS(CommonJS)、webpackによる監視を分担し、さらにwireitモニターとPNPMのランチャープロセスが重なり、24.4GBものメモリを消費する状態だった。
このままでは開発マシンのリソースを圧迫し、CI(継続的インテグレーション)実行時にもジョブの待機時間が増大する。ビルド速度の遅延はフィードバックサイクルを長びかせ、生産性に悪影響を及ぼしていた。その根本原因を取り除くため、重複作業の排除とツールチェーンの刷新に着手した。
上記の数値が示す通り、ビルド時間とメモリ消費の両面で大幅な改善が実現された。この結果をもたらした主要な施策は以下の3段階に分けられる。
重複ビルドの排除とTypeScriptコンパイラからの脱却
最初に取り組まれたのは、不必要なモジュール形式のビルド重複の解消だ。WooCommerceはESMとCJSの両方を配布しているが、内部のバンドラ(webpack)ではESMのみが消費されていた。にもかかわらず、開発フローでは常に両方を生成していたため、無駄なビルドコストがかかっていた。
PR #64876では、パブリッシング専用のプリパックビルドコマンドを新設し、普段の開発時にはESMのみを生成するよう分離した。これによりビルドプロセスがスリム化され、コールドビルドの短縮に寄与している。
続いて、TypeScriptのコンパイル基盤をtscからesbuildへ移行するための準備が行われた。型チェックは独立したLintステップに分離し、型定義ファイルの生成はパブリッシュ時のみ実行する方式に切り替えた。こうしてビルド本体からTypeScriptコンパイラを外し、高速なバンドラに置き換える土台が整った。
esbuildへの移行とビルド設定の一元化
型チェックとビルドの分離が完了したあと、全パッケージのビルドをesbuildへ切り替えた。esbuildはGo言語で実装されており、TypeScriptのトランスパイルにおいてtscやBabelよりもはるかに高速だ。この移行だけでウォームビルドの速度は顕著に向上した。
しかし、急いで移行した結果、各パッケージに似たようなbuild.mjsファイルが散在するという新たな課題が生まれた。これに対処するため、PR #65422ではビルド用の内部パッケージ@woocommerce/internal-buildを新設し、従来の設定パッケージ(internal-ts-configやinternal-style-build)を統合した。開発マシン上のスクリプトが整理され、今後の保守性も高まった。
Admin/Blocksによるパッケージビルド統合、メモリ大幅削減の鍵
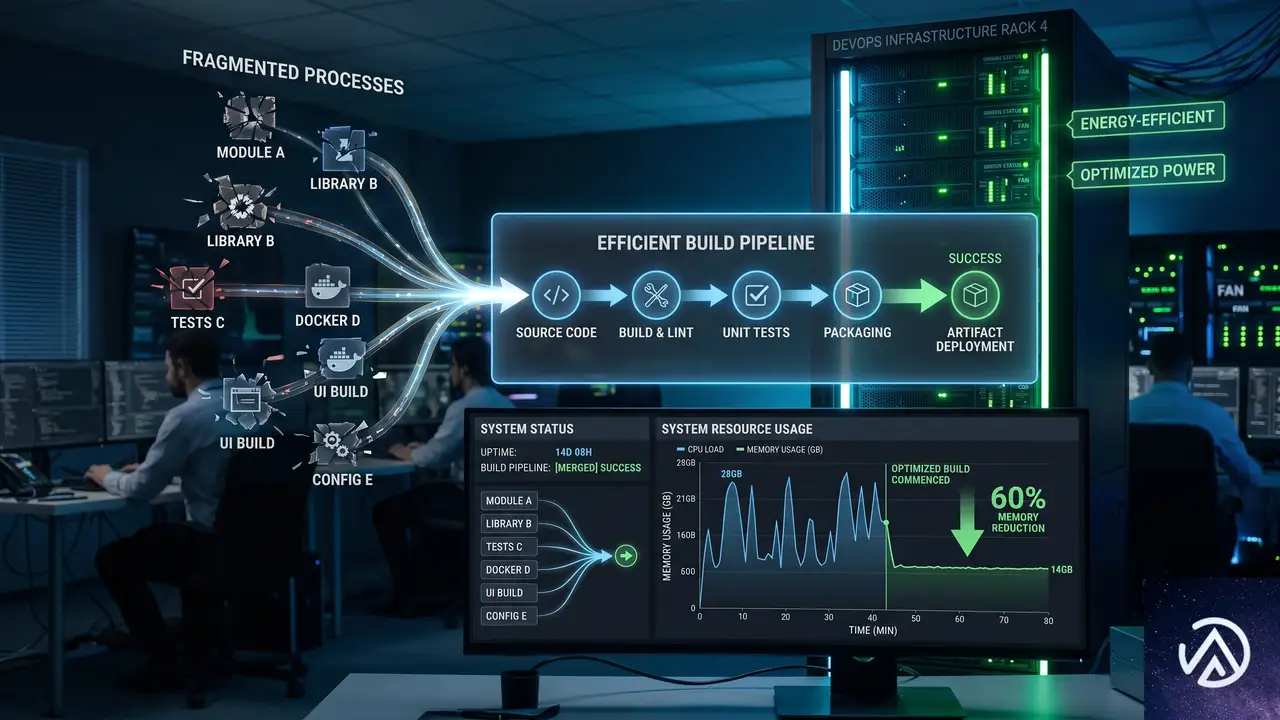
一連の改善の集大成となったのが、PR #65254で実施されたAdminおよびBlocks向けのビルド統合だ。それまでwatch:buildコマンドが128プロセスも必要だった最大の要因は、Admin用webpackとBlocks用webpackがトランスパイル済みESMを外部パッケージとして消費していたことにある。
このPRでは、各パッケージのソースを直接AdminおよびBlocksのwebpackビルドに含める方式へと変更した。その結果、128プロセスが大幅に削減され、メモリ使用量が24.4GBから3.9GBへと激減した。ウォッチ準備時間も132秒から33秒へと4分の1に短縮されている。
トレードオフとして、パッケージのトランスパイルがesbuildではなくBabelで行われるため、コールドビルドの速度が一部でわずかに後退した(38秒)。しかし、webpackのファイルシステムキャッシュによって日常的な開発では体感されず、E2E(End-to-End)テストのCIジョブが約1分長くなる程度にとどまった。全体のメモリ削減と開発体験の向上に比べれば、十分に許容できる交換だったと言える。
次のターゲットはCIスループットの改善
ビルドプロセス自体の最適化が完了した現在、開発チームはCIのスループット向上に注力する方針だ。WooCommerceのCIはジョブをマトリクスシャーディングで分散実行しているが、GitHub Actionsのワーカーが枯渇しやすく、各ジョブの実行時間が短くなってもワーカー獲得に20分以上待たされる局面がある。
この問題を解消するため、同一ワーカー上で複数のタスクを並列実行する方式への移行が計画されている。ワーカー台数に依存しない設計に切り替えることで、CI全体のスループットを大幅に引き上げる狙いだ。さらに、E2Eテストスイートの高速化として、マルチサイト構成などを活用し、単一環境内でテストスイートを並列実行する手法も検討されている。
これらの施策が実装されれば、コードをプッシュしてからCIが完了するまでの時間がさらに短縮され、開発のスピードは一段と加速するだろう。
この記事のポイント
- WooCommerceモノレポの開発ビルドが全面的に見直され、コールドビルド60%減、メモリ使用量84%減を達成
- 重複ビルドの排除と
esbuild移行により、トランスパイル速度が大幅に向上 - Admin/Blocksへのパッケージ統合で128プロセスを一掃し、メモリ消費を劇的に低減
- 今後のCIスループット改善では、ワーカー枯渇問題の解決と並列化が焦点
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
2026年5月ウェブ標準 CSS疑似クラスや遅延読み込み新機能まとめ
2026年5月、Chrome 148、Firefox 151、Safari 26.5が安定版としてリリースされた。CSSの疑似クラスやコンテナクエリ、メディア要素の遅延読み込みといった使い勝手を大きく左右する機能群がBaselineへと加わっている。
具体的な変化点は4つだ。開閉状態にスタイルを当てる :open 疑似クラス、名前だけで親を参照できるコンテナクエリ、カスタムプロパティを条件とするスタイルクエリ、そして <video> および <audio> のネイティブ遅延読み込み。これらはすべて、主要ブラウザの最新版で動作するBaseline Newly availableとなった。
この記事では、それぞれの機能が何を解決し、実際のコードでどう使うのか、概観を交えながら見ていく。リリースノートを追いきれていないフロントエンドエンジニアやWeb制作担当者は、この機会にキャッチアップしてほしい。
:open 疑似クラスが Baseline 入り
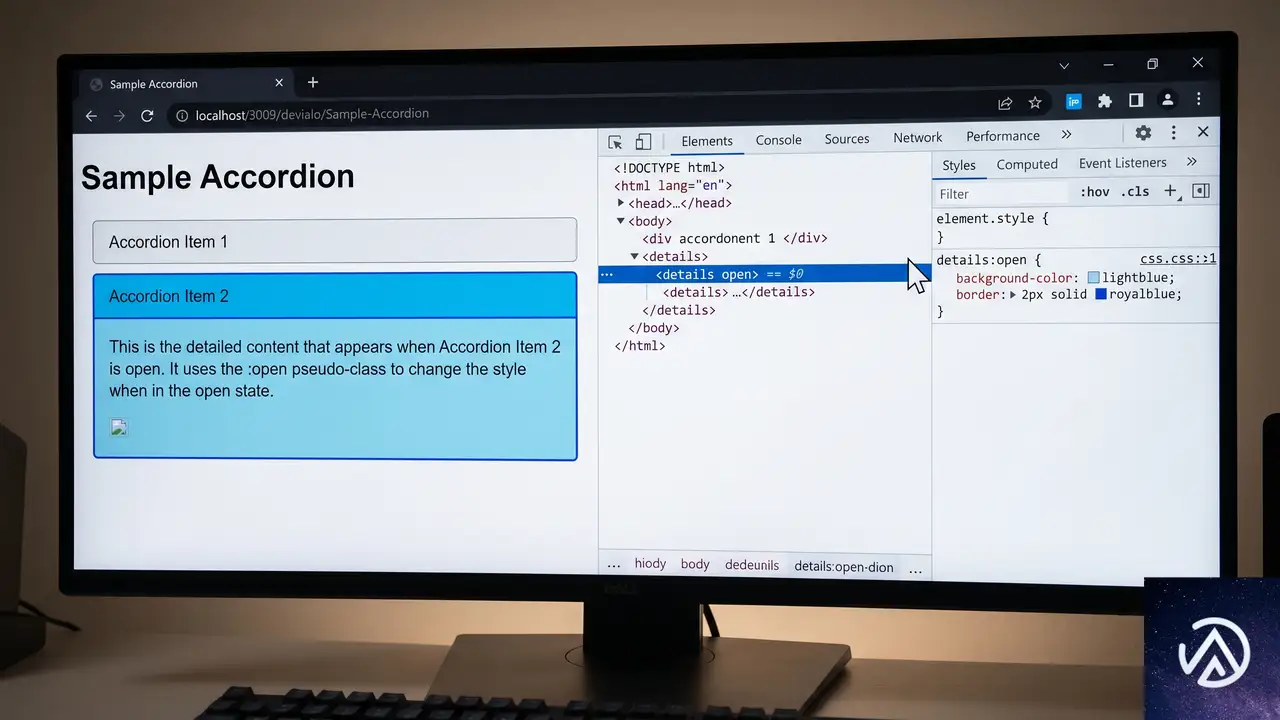
長らくFirefoxとChromeが対応していた :open 疑似クラスが、Safari 26.5のサポートによりBaseline Newly availableとなった。開閉状態を持つHTML要素を、開いているときだけまとめてスタイリングできる疑似クラスだ。
具体的には <details>、<dialog>、<select> といった要素に加え、カラーピッカーや日付ピッカーなどの <input> も対象になる。これまでは details[open] のように属性セレクタで個別に書く必要があったが、より読みやすく一貫性のあるコードにまとめられる。
:open 疑似クラスが解決するもの
従来の手法では、開閉のインタラクションを表現するために要素ごとに異なるセレクタを書く必要があった。たとえば <details> には details[open]、<dialog> には dialog[open] を使う。しかし :open 疑似クラスなら、これらをひとつのセレクタで扱える。
この変化は、コードのメンテナンス性を大きく改善する。とくにデザインシステムを構築するチームでは、コンポーネントの状態管理がシンプルになる利点が大きい。
background: #f0f0f0;
}
dialog[open] {
background: #f0f0f0;
}
background: #f0f0f0;
}
このデモで示したように、:open 疑似クラスを使うと開状態の記述が一箇所に集約される。複数箇所に散らばっていたスタイルを一元管理でき、意図しないスタイル崩れも防ぎやすくなる。
活用シーンと注意点
実務では、FAQのアコーディオンやモーダルダイアログのスタイル定義で即座に役立つ。フォーム部品のピッカーUIにも適用されるため、一貫したブランド表現が可能だ。
ただし、すべての開閉要素が対象になるわけではない。<summary> をクリックして開く <details> のように、ブラウザが開閉状態をネイティブに管理する要素に限定される。JavaScriptで独自に開閉を管理するUI部品には反応しない点に注意が必要だ。
名前のみのコンテナクエリ
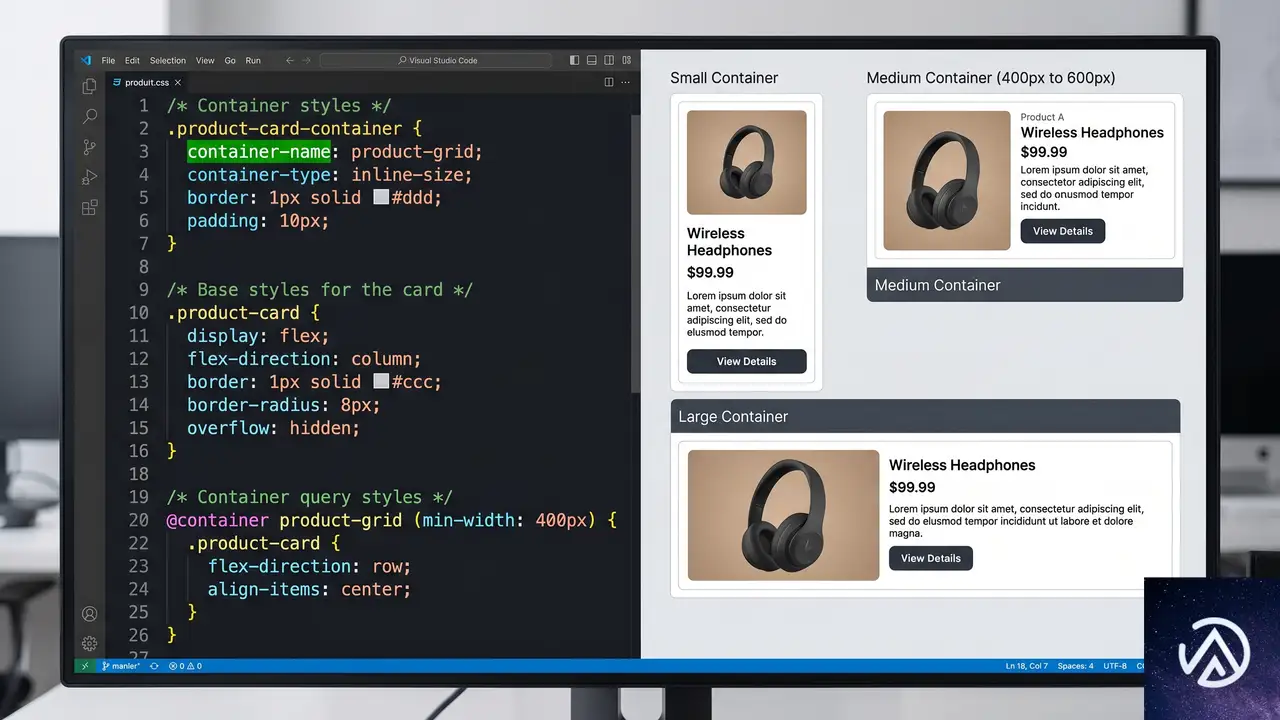
Chrome 148のリリースにより、名前のみのコンテナクエリ(name-only container queries)がBaseline Newly availableになった。コンテナクエリを書く際に、サイズやスタイルの条件を省略してコンテナの「存在」だけを条件にできる。
これまでは container-type プロパティでコンテナの種別を宣言し、かつ @container ルール内でサイズ条件を指定する必要があった。今回の変更で、単に名前でコンテナを参照するだけのクエリが書けるようになり、コードの冗長さが大きく減る。
名前だけでコンテナを参照する仕組み
具体的なコードを見てほしい。従来は「サイドバーという名前のコンテナが、ある幅を超えたら」というクエリが中心だった。新しい構文では「サイドバーという名前のコンテナがあるなら」という条件だけでスタイルを切り替えられる。
/* コンテナの名前を付与 */
#container {
  container-name: --sidebar;
}

/* サイズ条件なしで名前だけで参照 */
@container --sidebar {
  .content {
    padding: 2rem;
  }
}container-name: –sidebar;
@container –sidebar (min-width: 300px) { … }
@container –sidebar { … }
この構文によって、container-type の宣言が不要になるケースが増える。名前の指定だけでコンテナを参照したい場面では、CSSの記述量が減り、可読性も上がる。
実務での活用ポイント
大規模なサイトでは、レイアウトのコンポーネント化が進んでいる。コンテナクエリは「親コンポーネントの状態で子のスタイルを決める」設計と相性が良く、名前のみの参照はこの流れを加速する。
たとえば「サイドバーがDOM上に存在するならカードのパディングを変える」といった、レイアウトの有無に応じた条件分岐が簡潔に書ける。メディアクエリでは制御しきれなかったコンポーネント単位のレスポンシブが、より直感的に扱えるようになる。
コンテナスタイルクエリとカスタムプロパティ
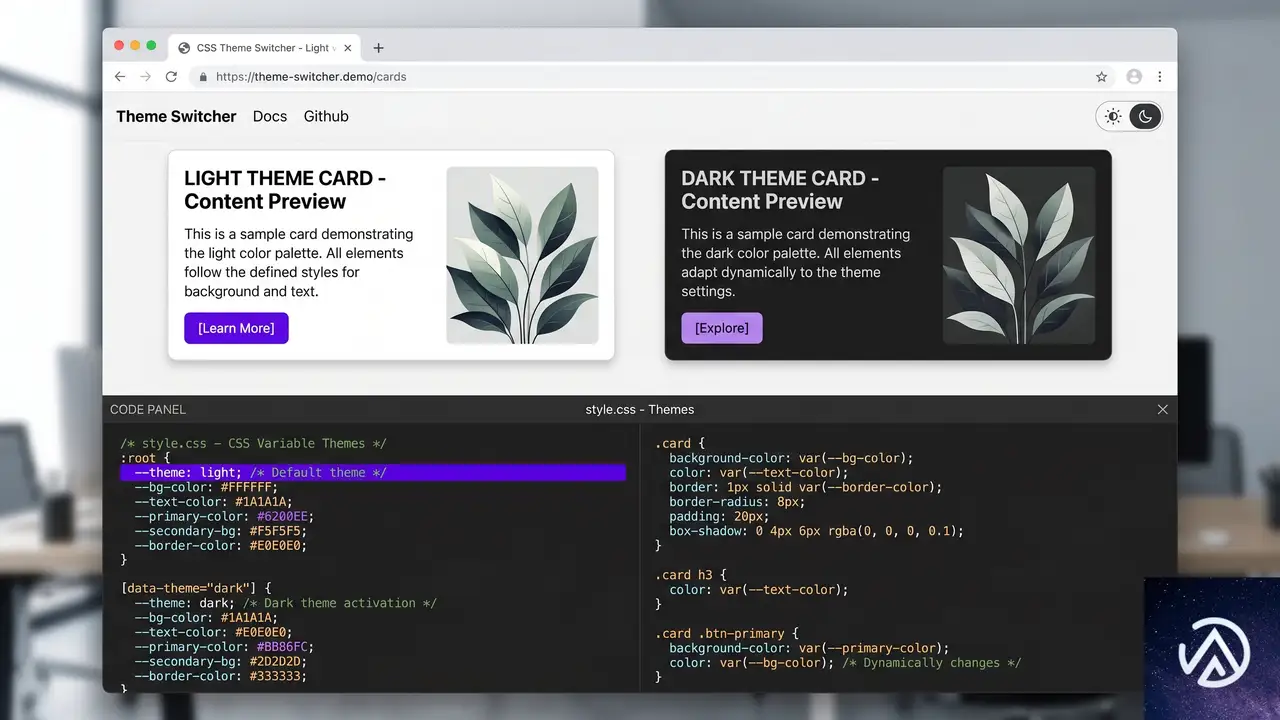
Firefox 151で style() クエリのサポートが加わり、カスタムプロパティを条件とするコンテナスタイルクエリがBaseline Newly availableとなった。これにより、サイズ以外の親コンテナのCSSプロパティを条件にスタイルを切り替えられる。
とりわけ大きな意味を持つのは、カスタムプロパティ(CSS変数)を条件に含められる点だ。たとえば --theme という変数が dark のときに子要素の背景色を変える、といったテーマ切り替えをCSSだけで完結できる。
カスタムプロパティを条件にしたクエリの実例
以下は、親コンテナで定義された --theme: dark というカスタムプロパティを検知し、子の .card にダークモード用のスタイルを適用するコードだ。
@container style(--theme: dark) {
  .card {
    background-color: #1a1a1a;
    color: #fff;
  }
}この仕組みを使えば、JavaScriptに依存せずにテーマの切り替えが可能だ。CSS変数を用いた設計基盤が整っているプロジェクトであれば、追加のスクリプトなしでダークモード対応の精度を上げられる。
サイズクエリとの使い分け
サイズクエリは「コンテナの幅が300pxを超えたら」といったレイアウト制御に強い。一方でスタイルクエリは「テーマ」「状態」「モード」といった意味的な条件に向いている。
両者は競合するものではなく、補完関係にある。たとえば「サイドバーが存在し、かつダークテーマのとき」にスタイルを変える、といった複合的な条件設計も可能になる。コンテナクエリ全体がBaselineへと進んだことで、CSSの表現力は確実に一段階上がったと言える。
video と audio のネイティブ遅延読み込み
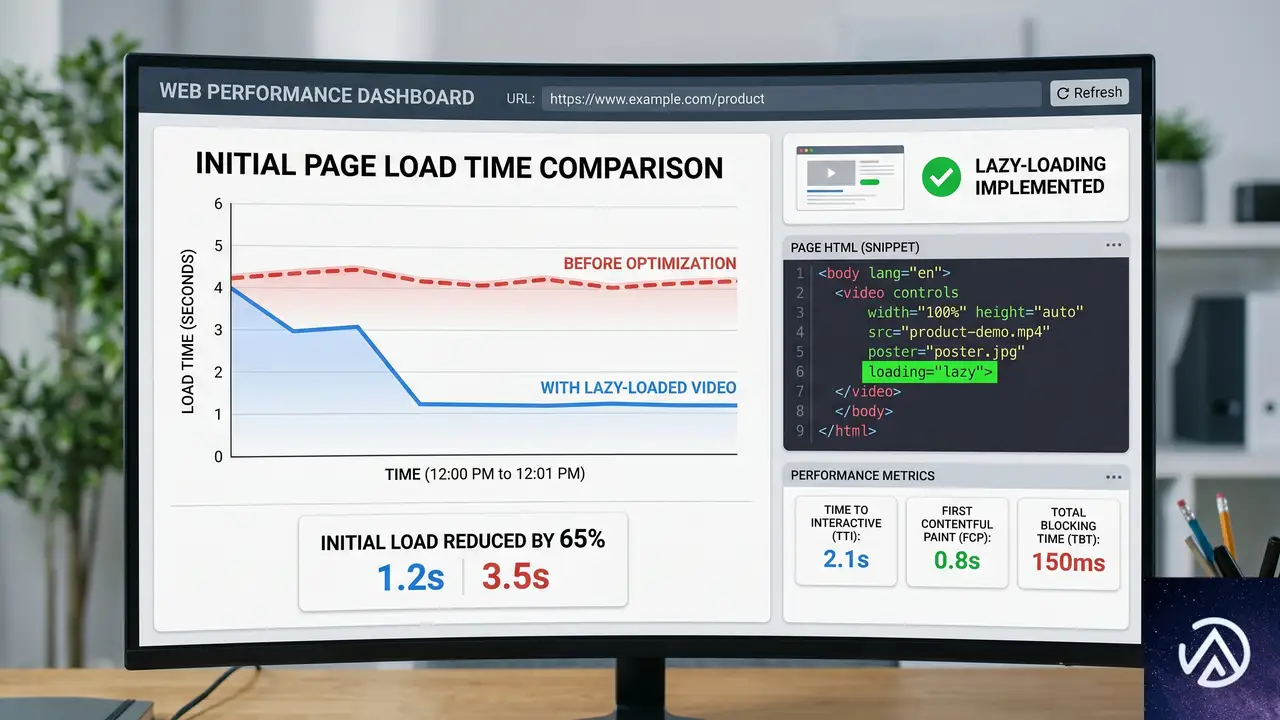
Chrome 148で <video> と <audio> 要素に loading="lazy" 属性が導入された。これにより、画像やiframeと同じく、メディア要素をビューポート付近まで読み込まない動作をブラウザネイティブで制御できる。
サイトのファーストビューに動画を置くケースは増えているが、初期ロードでユーザーの帯域を圧迫する問題は長年の課題だった。この機能はJavaScriptのIntersection Observerを使った手動実装を、宣言的な属性ひとつで置き換える。
実装と効果
実装はきわめてシンプルで、<video> タグに loading="lazy" を追加するだけだ。特別なポリフィルやライブラリは不要で、対応ブラウザであればそのまま動作する。
<video src="hero.mp4" loading="lazy" controls></video>効果は数値にも表れる。Squarespaceのエンジニアリングチームが公開した記事によれば、ネイティブ遅延読み込みによって動画の初期リクエスト数が大幅に減り、LCP(Largest Contentful Paint)の改善に貢献したという。詳細は同チームの技術記事「How To Use Standard HTML Video and Audio Lazy-Loading on the Web Today」を参照してほしい。
対応範囲と今後の展望
Chrome 148でサポートが始まったこの機能は、今後のブラウザ展開によってBaseline化が期待される。FirefoxやSafariの動向はまだこれからだが、loading="lazy" の属性自体は画像やiframeですでに確立された仕組みであり、メディア要素への拡張も自然な流れと言える。
未対応ブラウザでは属性が無視されるだけで壊れないため、今すぐ実装してもリスクは少ない。動画を多用するポートフォリオサイトやLPでは、とくに導入効果が大きい。
Document Picture-in-Picture API とその他のアップデート
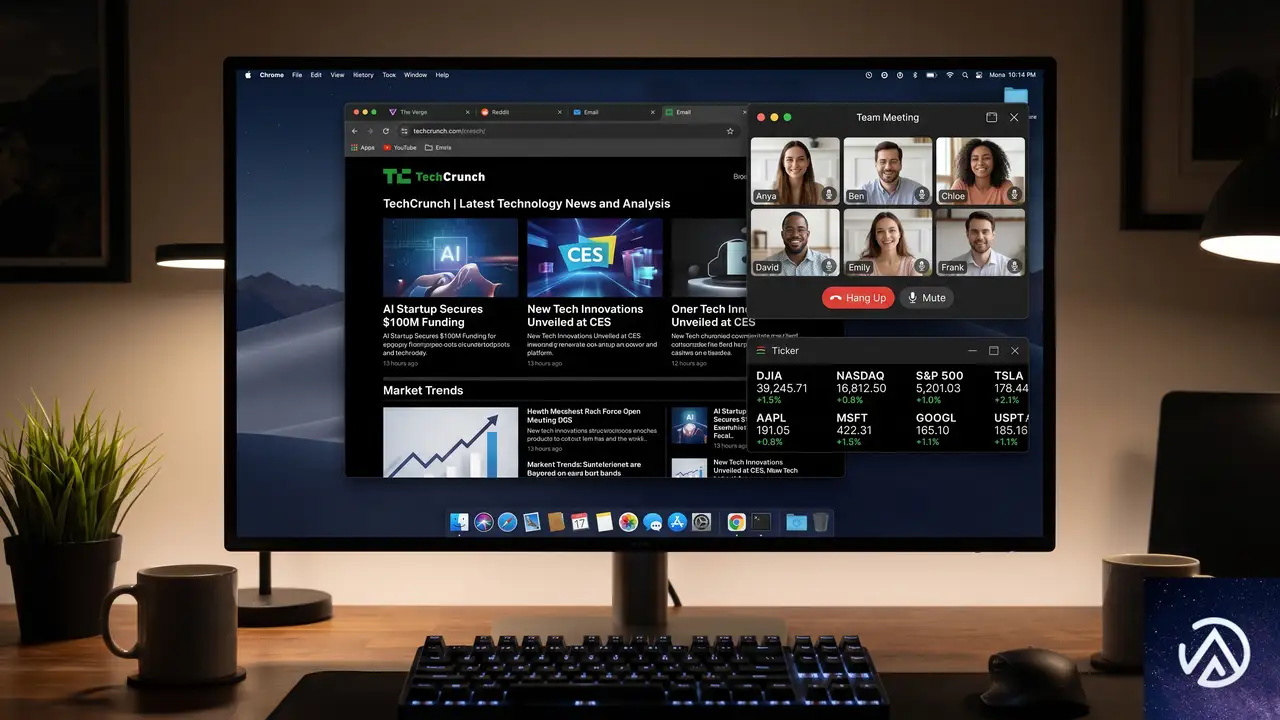
CSS以外でも重要な進展があった。Firefox 151でDocument Picture-in-Picture APIがデスクトップ向けに導入され、Web Serial APIもFirefoxデスクトップとChrome Androidでサポートが拡大されている。
Document Picture-in-Picture API の概要
従来のPicture-in-Picture APIは <video> 要素を常に前面の小窓で表示する機能だった。一方、Document Picture-in-Picture APIは任意のHTMLコンテンツを含むウィンドウを常に最前面に表示できる。
これにより、ビデオ会議の参加者グリッドや株価ティッカー、タイマーといったインタラクティブなオーバーレイを、ページ遷移後も維持できるようになる。デスクトップ向けのプログレッシブウェブアプリ(PWA)でとくに威力を発揮するAPIだ。
Web Serial API のプラットフォーム拡大
Web Serial APIは、マイクロコントローラーや3Dプリンター、開発ボードといったシリアルデバイスとウェブサイトが直接通信するための仕組みだ。Firefoxでは専用のサイト権限アドオンを導入することで安全に管理できる設計になっている。
Chrome 148ではAndroid向けにもサポートが拡大され、モバイルデバイスからシリアル機器を制御するユースケースが現実的になった。IoT分野や教育用途での活用が今後広がると見られている。
この記事のポイント
- 2026年5月のブラウザ安定版で、複数のCSS機能とHTML属性がBaseline Newly availableに到達した
:open疑似クラスで開閉状態のスタイリングが一元的に書けるようになった- 名前のみのコンテナクエリにより、サイズ条件なしで親コンテナの存在を参照できる
style()クエリでカスタムプロパティを条件としたテーマ切り替えがCSSだけで実装可能<video>と<audio>のloading="lazy"でメディアの遅延読み込みがネイティブ化され、初期ロードの負荷が軽減される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WooCommerce 10.8リリース!レビューメール自動化と各種高速化の全容
WooCommerce 10.8が2026年5月26日にリリースされた。今回のアップデートでは購入後のカスタマーレビュー依頼メールの自動化、カスタム配送業者の設定機能、クーポンコードの動的生成、そして管理画面のパフォーマンス改善が盛り込まれている。
動作条件としてWordPress 6.9以上が必要だ。WooCommerceを更新する前にWordPress本体を最新にしておく必要がある。管理画面の一貫性を保つWordPress 7.0への事前適合も含まれており、今後のスムーズな移行に向けた布石となるリリースだ。
WooCommerce 10.8の主な変更点

WordPress 7.0向けの管理画面スタイル調整
WooCommerce 10.8には約15件のプルリクエストが含まれ、WordPress 7.0の新しい管理画面デザインとの整合性を確保した。対象となったのはフォームコントロールのサイズ、Select2ドロップダウン、ボタンの角丸、通知の色、メタボックス周りのスタイルだ。
従来、WooCommerceの一部画面では青系の管理画面用色が直接ハードコーディングされていた。これがテーマカラー変数に置き換えられ、ユーザーが設定した配色スキームに沿って境界線やホバー状態が変化するようになった。WordPressとWooCommerceを同時に更新すれば、管理画面全体の見た目に統一感が出る。
管理画面の色が選んだテーマに合わせて変化するため、複数サイトを運営している場合でもサイトごとに配色を変えられ、管理ミスの防止にもつながる。
オフライン対応の管理画面
WooCommerceの管理画面がオフラインを検知するようになった。ブラウザのネットワーク接続が切れるとバナーが表示され、保存リクエストがネットワーク喪失で失敗した場合には明確な通知が表示される。
これまで接続の不安定な環境では保存失敗に気づかず、注文データや設定の消失につながるケースもあった。モバイル回線やカフェのWi-Fiなど、接続状態が変わりやすい場所で作業するストア運営者にとっては実用的な改善だ。
パフォーマンス改善の詳細

SQLクエリの削減と高速化
WooCommerce 10.7から続くクエリ削減の取り組みがさらに進んだ。取引IDルックアップ用の索引が wc_orders テーブルに追加され、販売ピーク時の在庫予約に使われる wc_reserved_stock テーブルの索引も改善された。
加えてキャッシュプライミングが商品アーカイブ、商品編集画面、クラシックカート、グループ化商品、Store APIの商品スキーマに拡張された。これにより各パスでデータを1行ずつ取得する代わりにバッチロードできるようになり、データベースへの負荷が大きく下がる。
クーポンの _used_by メタデータは遅延読み込み化された。何千回も使われたクーポンをロードする際に全使用履歴をメモリに展開しなくなり、クーポン読み込み時のパフォーマンスが飛躍的に改善する。レイヤードナビゲーションのフィルターキャッシュにはデフォルトで上限が設定され、wp_options テーブルが無制限に肥大化するのを防ぐ。
ベータ版からの修正点
10.8のベータテスト期間中に見つかった問題も解消された。 WC_Order::payment_complete() に追加予定だったチェックアウト証跡のバリデーション機能は最終版から差し戻され、このリリースには含まれない。
また wc_orders_meta テーブルの meta_key_value 索引から meta_value 列が誤って削除されたパフォーマンス回帰も修正された。注文メタデータの検索速度が低下する問題だったが、10.8で索引構成が復元されている。
新機能の詳細

カスタマーレビュー依頼メールの自動化
10.8の目玉機能の一つが、購入者に商品レビューを依頼する自動メール機能だ。WooCommerceの設定の「メール」タブから有効化でき、Action Schedulerを使って注文完了から設定した日数後に送信される仕組みだ。
注文がキャンセル、返金、削除された場合にはメールは自動キャンセルされる。全額返金された商品はレビュー対象から外されるため、購入者と商品の関係が切れた状態でのレビュー投稿を防げる。顧客はトークン付きの専用読み取り専用ページに誘導され、アクセシブルな5つ星評価のコントロールからレビューを投稿する。投稿されたレビューは「確認済み購入者」の商品レビューとして扱われる。
この仕組みで集まったレビューは確認済み購入者の証跡が残るため、レビュー全体の信頼性を高められる。商品ページの社会的証明を強化したいストアには有効な手段だ。
クーポンコードの自動生成機能
メールブロック内で使えるクーポンコード機能が自動生成に対応した。ストア運営者は割引額やクーポンタイプ、有効期限といったルールを設定し、メール送信時に受信者ごとのユニークなコードを動的に発行できる。
パーソナライズされたクーポンキャンペーンの運用が大幅に簡略化される。全員に同じコードを配布して拡散リスクを抱える必要がなくなり、1人1コードの安全な配布が可能だ。
メールテンプレートの同期とリセット
ブロックメールの投稿にバージョン、ソースハッシュ、同期日時といったメタデータが付与されるようになった。テンプレートが元の配布状態からどれだけ変更されたかを自動検知できる。さらに管理画面からワンクリックでメール本文をプラグイン配布時のオリジナル状態に戻せるリセット機能も追加された。
カスタマイズを重ねたメールテンプレートの管理は煩雑になりがちだが、変更箇所の可視化と即時リセットで運用負荷が下がる。
カスタム配送業者の設定
独自の配送業者を定義できるUIが追加された。業者名と追跡URLテンプレートを登録すれば、注文画面で業者ごとのフィルタリングや、カスタマイズされた追跡リンクを使って出荷状況を確認できる。
国内の小規模な配送業者や地域限定の物流サービスを使っているストアでも、統一された画面から追跡情報を管理しやすくなる。
APIの更新

REST APIとGraphQL
注文APIでは shop_order でないレコードの変換が拒否されるようになり、チェックアウトドラフト注文はデフォルトクエリから除外されるようになった。より明示的なデータ操作が求められる変更だが、意図しないデータ混入を防ぐ点でAPIの堅牢性が増した。
注目すべきはGraphQL APIの導入だ。デュアルコードとGraphQL APIがWooCommerceに組み込まれ、管理画面の「詳細設定」タブにGraphQL設定セクションが追加された。GETエンドポイントのトグル操作で有効にできる。ヘッドレス構成やモダンなフロントエンドスタックからWooCommerceのデータを柔軟に取得したい開発者にとって重要な布石となる。
そのほか商品公開時に発火する product.published ウェブフックトピックの追加や、商品管理権限のないユーザーに対する機密フィールド(ダウンロード、売上原価、仕入メモ)の除外など、セキュリティ面の強化も図られている。
データベースの更新と注意点

このリリースにはデータベース更新が含まれている。自動実行されるスケジュール更新の中では、ブロックメール投稿への同期メタデータ付与、WooCommerce 10.5で名称変更された分析データのインポート設定復元、meta_key_value 索引の調整、レビュー依頼用の専用ランディングページ作成などが行われる。
10.8の更新前には必ずサイト全体のバックアップを取得し、ステージング環境での事前テストを推奨する。またWordPress 6.9以上が必須条件となるため、WordPress本体のバージョンも事前に確認しておく必要がある。
この記事のポイント
- WooCommerce 10.8は購入後のレビュー依頼メールを自動化し、確認済み購入者のレビュー収集を効率化する
- 管理画面のオフライン検知機能が追加され、ネットワーク不安定環境でのデータ消失リスクが低減した
- クーポンコードの自動生成やメールテンプレートのリセット機能で運用負荷を下げられる
- SQLクエリの削減とキャッシュプライミングの拡大により、ストアフロントの応答速度が向上する
- GraphQL APIの導入はヘッドレス構成やモダンフロントエンド開発への対応を見据えた布石となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

View Transitions、大量要素スケーリングにview-transition-classが効く
クロスドキュメントビュートランジション(View Transitions)は、ページ間の遷移をアプリのように滑らかにする強力なAPIだ。しかし本番環境で数十、数百の要素を扱おうとすると、途端にスケーリングの問題に直面する。1つのヒーロー画像を動かすデモは簡単だが、48枚の商品カードを個別に遷移させるとなると話が違う。
本記事では、view-transition-classと動的な名前付けの手法を用いて、大量要素を効率よく扱う方法を解説する。CSS-Tricksで公開された連載Part 2の内容を基に、実践的なパターンとアクセシビリティへの配慮までカバーする。
view-transition-classがスケーリングの鍵

多くのチュートリアルでは、1つの要素にview-transition-name: heroを付与し、ページ間でマッチさせる。しかし実際のプロダクトグリッドでは、48枚のカードには48の一意な名前が必要になる。CSSでこれに対応しようとすると、次のような悪夢が待っている。
::view-transition-group(card-1),
::view-transition-group(card-2),
::view-transition-group(card-3),
::view-transition-group(card-4),
::view-transition-group(card-5),
::view-transition-group(card-6),
::view-transition-group(card-7),
::view-transition-group(card-8)
/* ... さらに92個続く */ {
  animation-duration: 0.35s;
  animation-timing-function: ease-out;
}
この方法は、要素数が増えるほど管理不能になる。100個の商品があれば100個のセレクタを書かなければならず、保守は事実上不可能だ。
名前とクラスの決定的な違い
ここで重要になるのが、view-transition-nameとview-transition-classの使い分けだ。両者は似ているようで役割がまったく異なる。
- nameは「同一性」を表す。ページAのサムネールとページBのヒーロー画像が「同じもの」だとブラウザに伝える。nameはページ内で一意でなければならない。重複するとトランジションは破棄される。
- classは「スタイルのフック」だ。50の要素が
view-transition-class: cardを持てば、1つのCSSルールでそれらすべてのアニメーションを制御できる。通常のCSSクラスと同じ考え方で、特定の要素を指すものではなく「こう見せたい」をグループ化する。
データベースにたとえるなら、nameが主キー、classがカテゴリ列に相当する。主キーは一意に1行を特定し、カテゴリ列はまとめてクエリをかけるために使う。
クラスを使った共通スタイルの記述
実際のCSSはこうなる。6枚のカードに6つのユニークなnameを与えつつ、アニメーションのルールはたった3つで済む。
::view-transition-group(*.card) {
  animation-duration: 0.35s;
  animation-timing-function: cubic-bezier(0.25, 0.46, 0.45, 0.94);
}

::view-transition-old(*.card),
::view-transition-new(*.card) {
  object-fit: cover;
}セレクタの*.cardは「view-transition-classがcardであるすべてのビュートランジショングループ」を意味する。アスタリスクはnameのワイルドカードで、classにマッチする。これでカードが60枚でも600枚でもCSSは変わらない。
このように、view-transition-classは大量要素のビュートランジションにおける、スケーリングの本質的な解決策だ。CSSのみで記述する理想形であるident("card-" sibling-index())のような自動生成はまだブラウザに実装されていないが、クラスを使えば十分なスケールを得られる。
動的名前付けでパフォーマンスを最適化

view-transition-classでスタイルのスケーリングは解決した。しかし、nameをページロード時にすべて付与してしまうと、別の問題が発生する。ユーザーが1枚のカードをクリックするだけでも、ページ上の全カード(48枚)のスナップショットが撮られ、疑似要素ツリーが構築されてしまうのだ。これは余計なコストであり、特にミドルレンジのモバイル端末ではトランジションのカクつきやスキップを引き起こす。
pageswapとpagerevealのライフサイクル
正しいアプローチは、nameを「ジャストインタイム」で付与することだ。ユーザーが操作したその瞬間にだけnameを設定し、遷移が終われば削除する。これにより、実際に遷移する要素だけがキャプチャされ、無駄な処理が発生しない。
流れはこうだ。
- ユーザーが一覧ページでカードをクリックする。
- ブラウザがナビゲーションを開始し、旧ページで
pageswapイベントが発火する。 pageswapハンドラがクリックされたカードを特定し、view-transition-name: product-42を動的にセットする。- ブラウザがその要素のスナップショットを撮る。
- 新ページが読み込まれ、
pagerevealイベントが発火する。 pagerevealハンドラがURLからIDを読み取り、ヒーロー要素に一致するnameを割り当てる。- ブラウザが新旧のスナップショットをマッチさせ、モーフィングアニメーションを再生。
- トランジションが完了したら、
viewTransition.finishedのPromise解決後にnameをクリアする。
この一連の流れで、名付けられるのはたった1つの要素だけだ。48枚のカードのうち47枚は何も関与せず、無駄なスナップショットはゼロになる。
このパターンは、Astroのtransition:nameディレクティブやNuxtのビュートランジションサポートが内部的に行っていることと本質的に同じだ。フレームワークが抽象化している処理を、pageswapとpagerevealで直接制御していると考えればよい。
名前のクリーンアップが重要な理由
トランジション完了後にnameを削除するステップは、単なるお片付けではない。もしユーザーが一覧ページに戻り、別のカードをクリックした場合、古いnameが残っていると重複によるエラー(トランジションが即時破棄される)か、誤った要素とのマッチングが起きる。必ずviewTransition.finishedの解決後にnameをクリアすること。
実践的なパターン集

商品グリッド以外にも、いくつかの典型的なパターンが存在する。実際のサイトで遭遇する状況に合わせて応用できる。
アスペクト比混合のフォトギャラリー
サムネールと拡大画像でアスペクト比が異なるギャラリーは、object-fit: coverで歪みを防ぎつつ、クラスで統一的に制御する。ポイントは、view-transition-nameを<img>自身に付与し、カードの枠やキャプションを含めないことだ。画像だけをモーフィングさせ、背景や枠は別のトランジションとして扱う。
::view-transition-group(*.gallery-item) {
  animation-duration: 0.5s;
  animation-timing-function: cubic-bezier(0.2, 0, 0, 1);
}

::view-transition-old(*.gallery-item),
::view-transition-new(*.gallery-item) {
  object-fit: cover;
  overflow: hidden;
}

/* ライトボックス背景は別クラスでフェード */
::view-transition-group(*.lightbox-bg) {
  animation-duration: 0.3s;
}
ライトボックスの暗いオーバーレイには、別のnameとclassを与え、独立したフェードインアニメーションを適用する。画像のモーフィングと背景のフェードが並行して走り、洗練された印象になる。
タブやセクションの切り替え
ダッシュボードタブやマルチステップフォームなど、同一ページ内でのセクション遷移にも同じ手法が使える。固定ヘッダーにはanimation-duration: 0sを指定して「動かない」ようにし、コンテンツだけがスライドする感覚を出す。
::view-transition-group(*.persistent) {
  animation-duration: 0s; /* 動かさない */
}

::view-transition-group(*.tab-content) {
  animation-duration: 0.25s;
}

::view-transition-old(*.tab-content) {
  animation: slide-out-left 0.25s ease-in;
}

::view-transition-new(*.tab-content) {
  animation: slide-in-right 0.25s ease-out;
}
永続的な要素にアニメーションをかけないことで、UI全体に安定感が生まれる。
無限スクロールと動的コンテンツ
無限スクロールで後からDOMに追加された要素にも、特別な対応は不要だ。pageswapハンドラはナビゲーション発生時にDOMをクエリする。要素がその時点で存在していれば、問題なくnameを割り当てられる。唯一注意すべきは、data-idなどマッチングに使う識別子が動的に追加されたバッチ間でも一意であることだ。APIが返すIDを利用していれば問題ない。
アクセシビリティとprefers-reduced-motion

アニメーションは、前庭障害を持つユーザーに吐き気やめまい、片頭痛を引き起こす可能性がある。prefers-reduced-motionメディアクエリは、OSレベルで「動きを減らしてほしい」と設定しているユーザーを検出する。ビュートランジションを導入するなら、この対応は必須だ。
@view-transition {
  navigation: auto;
}

/* アニメーションのカスタマイズはすべてこのメディアクエリ内に */
@media (prefers-reduced-motion: no-preference) {
  ::view-transition-group(*.card) {
    animation-duration: 0.35s;
    animation-timing-function: cubic-bezier(0.4, 0, 0.2, 1);
  }

  ::view-transition-old(*.card),
  ::view-transition-new(*.card) {
    object-fit: cover;
  }

  ::view-transition-old(root) {
    animation: fade-out 0.2s ease-in;
  }

  ::view-transition-new(root) {
    animation: fade-in 0.3s ease-out;
  }
}

/* 動きを減らす設定の場合は0秒で即座に切り替え */
@media (prefers-reduced-motion: reduce) {
  ::view-transition-group(*),
  ::view-transition-old(*),
  ::view-transition-new(*) {
    animation-duration: 0s !important;
  }
}根本的に安全を取るなら、@view-transitionの宣言自体をprefers-reduced-motion: no-preferenceで囲み、トランジションを完全に無効化する方法もある。どちらを選ぶにせよ、アニメーションを無配慮に提供することだけは避けなければならない。
なお、prefers-reduced-motion: reduceのユーザー向けに、完全に0秒にする代わりに短いクロスフェード(0.15秒)を提供する手法もある。動きそのものをゼロにするのが最も安全だが、穏やかなフェードなら許容できるユーザーもいる。ただし、実際にその設定に依存するユーザーでテストするまでは、0秒を選択しておく方が無難だ。
プログレッシブエンハンスメントとブラウザ対応

ビュートランジションは、プログレッシブエンハンスメントの理想的な例だ。ブラウザが@view-transitionルールを理解しなければ、単に無視され、通常のページ遷移が行われる。何も壊れない。エラーもレイアウトシフトも発生しない。Firefoxがまだサポートしていなくても問題はなく、Safari 18.2以降やChrome、Edgeではフル機能が使える。
唯一、@supports (view-transition-name: none)でガードする価値があるのは、トランジション専用のスタイル(スナップショット品質向上のためのcontain: paintなど)を適用する場合だけだ。それ以外は、古いブラウザでも何もせずにそのまま動く。
この記事のポイント
- view-transition-nameは一意の識別子、view-transition-classはスタイルをグループ化するフック。クラスを使えば、数百要素でも数行のCSSでアニメーションを統制できる。
- nameはページロード時に全要素に付与せず、pageswapとpagerevealを使ってクリック時に動的に設定する。これでパフォーマンスが大幅に向上する。
- トランジション完了後は必ずnameをクリアし、古い名前の衝突を防ぐ。
- prefers-reduced-motionの対応は必須。すべてのアニメーションカスタマイズをメディアクエリ内に閉じ込め、設定ユーザーには0秒または短いフェードを提供する。
- ビュートランジションはプログレッシブエンハンスメント。未対応ブラウザでは何も起こらず、通常のページ遷移となる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WooCommerce.comがナイトリーコードで稼働、本番環境で不具合を早期発見
# WooCommerce.comが毎晩の最新コードで稼働開始。本番環境で不具合を早期発見する仕組みとは
2行目
**WooCommerce.comが2026年5月からナイトリー(毎晩)ビルドのWooCommerce Coreで本番稼働を開始した。** 同サイトは商用のWooCommerceストアであり、拡張機能(エクステンション)の販売と実際の決済を処理している。公開から最初の数時間でパフォーマンスの低下を検出し、本流コードに反映される前に修正を提案する成果をすでに上げている。
なぜ本番環境でナイトリービルドを使うのか

通常、ソフトウェア開発では「安定版」以外を本番環境に導入することは避けられる。しかしWooCommerce.comのチームは、WordPress.orgがWordPress trunk(開発のメインブランチ)上で稼働しているのと同じ考え方を採用した。つまり、開発中のコードに近い環境で運用し、問題を早期に発見する手法だ。
このアプローチにより、公開リリース前に実環境での問題を捉えられる。WooCommerce.comは大規模なストアであり、実際のトラフィックと決済が発生するため、机上のテストでは見つけにくいパフォーマンス低下やクエリの問題が浮き彫りになる。
WordPress.orgとの共通点
WordPress.orgは長年にわたり、開発ブランチ(trunk)を本番サイトで稼働させてきた実績がある。WordPress本体の開発チームは、trunkに変更がマージされると即座に本番環境に影響が出る仕組みを意図的に維持している。これにより、問題が発生すれば数時間以内に検出され、修正が迅速に行われる。
WooCommerceのチームも同様に、開発の最前線にコミットし、バグを早期に発見して上流に還元するサイクルを回し始めた。これがWooCommerceエコシステム全体の安定性向上につながる。
構築したパイプラインの全体像

チームが構築したパイプラインは、平日毎日自動実行される一連の処理から成る。開発者ブログの記事に掲載されたフロー図を元に、各ステップを以下に整理する。
AIが担当するのは、紫色で示されたステップ4の一部だ。最終的なマージ判断は依然として人間が行う。チームは今後、デプロイ後のテレメトリ(スロークエリ異常検出、エラー率比較、レイテンシのパーセンタイル計測)が自動判断に耐えうるほど信頼できるものになった段階で、人間の関与を徐々に減らす計画だ。
現時点では平日のみ稼働し、週末は稼働しない。これは十分に監視体制が整っていない段階で、無人運転によるリスクを避けるためだ。
AIが担う3つの重要な工程

このパイプラインで特に注目すべきなのは、従来は人間の開発者が手動で行っていた3つの作業をAIが置き換えた点だ。Developer WooCommerce Blogの記事では、それぞれの詳細が次のように説明されている。
パッチの再適用判断
WooCommerce.comでは、WooCommerce Coreに対して若干のパッチ(修正コード)を適用して運用している。これらのパッチは本来、上流のWooCommerce Core本体やAction Schedulerに取り込まれるべき修正だが、リリースに反映されるまでの暫定対応として独自に適用している。
ナイトリービルドを取り込むたびに、これらのパッチが「まだ必要なのか」「すでに上流に取り込まれたのか」「調整が必要なのか」を判断する必要が生じる。AIはパッチマニフェスト(パッチの一覧と説明)を読み取り、パッチごとに状態を判定し、結果をコミットする。この作業は、最初の稼働時点ですでに高い精度で動作している。
コア差分のコードレビュー
WooCommerce Coreのナイトリービルドは、前日との差分が数千行に及ぶこともある。これを人間がすべてレビューするのは現実的ではない。AIは変更全体をレビューするのではなく、WooCommerce.comの独自コードベースと接する「統合ポイント」に焦点を絞ってレビューを行う。
具体的には、WooCommerce.com側のコードが依存しているフックや関数、データベースクエリパターンに影響しそうな変更をピックアップし、生成された各プルリクエストに対して判定コメントを投稿する。初回の判定は汎用的すぎて実用に耐えなかったが、プロンプトの書き直しと差分の事前絞り込みによって改善されたという。
ステージング環境での探索的テスト
ステージング環境にデプロイした後、AIエージェントが実際のユーザーフローを模して主要な導線を巡回する。たとえば商品購入、アカウント管理、拡張機能の検索といった経路を自動でたどり、異常があればプルリクエストのコメントとして報告する。
この探索的テストは現時点ではv1段階であり、テストチャーター(テストの範囲と観点)のチューニングが必要だ。チームはAIからの報告を「シグナル(兆候)」として扱い、ゲート(通過判定)としては使っていない。
- コードレビューAIは初期には役に立たなかったが、プロンプト改善で実用化
- 探索的テストAIは範囲のチューニングが進行中
- パッチ再適用AIはパッチマニフェストの注釈品質に依存
最初の2週間で何が検出されたか

実際の本番運用開始からわずか2週間で、2件の具体的な問題が検出された。いずれも公開リリース前の時点であり、エコシステム全体への影響を未然に防ぐ成果となった。
1週目:統合テストの破損を検出
最初の実行で、統合テストが壊れていることがAIによってフラグ付けされた。原因は上流の特定の変更にまで追跡可能だった。興味深いのは、この問題に気づいた時点で、すでに上流チームが修正をリバート(巻き戻し)していたことだ。
もし毎日のチェック体制が整っていれば、さらに早い段階で検出できていた可能性が高い。これは、ナイトリービルドを監視することの有効性を示す初期事例となった。
2週目:注文メタデータへのスロークエリを実環境で発見
初の自動生成アップグレードが本番環境に適用されてから数時間後、パフォーマンスへの具体的な影響が観測された。注文メタデータ(order metadata)に対するデータベースクエリが低速化し、チェックアウトの遅延、定期購入(リニューアル)の参照遅延、Webhookの滞留といった二次的な影響が現れた。
原因は、orders metaテーブルに設定されていたデータベースインデックスを簡素化する上流のプルリクエストだった。この変更自体は合理的で、削除されたインデックスは肥大化しており、WooCommerce.comでは約15GBに達していた。しかし、このインデックスに依存していたクエリパターンが複数の拡張機能に存在したことが見落とされていた。WooCommerce Core本体の問題ではなく、その上に構築された拡張機能側の依存だった。
WooCommerce.comのチームは同日中に類似のインデックスを自前で復元して暫定対応し、詳細なスロークエリデータを添えて上流にバグ報告を行った。上流チームはすでに更新版のインデックスをマージしており、WooCommerce 10.8でのリリースが予定されている。
この取り組みがWooCommerceエコシステムに与える影響

WooCommerce.comがナイトリービルドを先行運用することは、拡張機能開発者とコア貢献者の両方にとって意味がある。
拡張機能開発者にとって
WooCommerce.comが本番環境で最新コードを動かし続けることで、WooCommerce Coreのリリースが拡張機能に届く前に、より安定した状態になる。最も有効な対策は、自社の拡張機能をWooCommerce Coreのベータ版やリリース候補版で早期にテストすることだ。
また、Coreの変更によって拡張機能が影響を受ける場合に備えた防御的パターンを構築している開発者からの知見は、コミュニティ全体にとって貴重な資産となる。
WooCommerce Core貢献者にとって
trunkへのマージから1日以内に、実運用している大規模ストアでその変更がテストされる。もしWooCommerce.com側で何かが壊れれば、数時間から数日以内に報告が上がる。公開リリース後に初めて問題が発覚するという従来のパターンと比べて、格段に速いフィードバックループが実現する。
このサイクルは、WordPress.orgが長年実践してきた「自分たちのサイトで自らのソフトウェアを動かす」というドッグフーディング文化の延長にある。WooCommerceエコシステムとしても、同様の姿勢を取ることで開発の健全性を高める狙いだ。
今後の展望。テレメトリと自動化の拡大

チームのロードマップは、より多くの自動化と手動ステップの削減にある。当面の優先課題は、デプロイ後のテレメトリをアップグレードプロセスのコア要素として組み込むことだ。
具体的には以下の3つの指標を自動監視し、異常を検出したら自動的に関係者に通知する仕組みを構築する。
- スロークエリの異常検出(通常と異なる遅いクエリの発生)
- エラー率の比較(デプロイ前後でのエラー発生頻度の変化)
- レイテンシのパーセンタイル計測(P50、P95、P99などの応答時間分布)
これらのデータが十分に信頼できるものになれば、人間によるレビュー工程をさらに省略し、AIがマージ判断まで行う自動化の範囲を広げられる。現時点では平日のみの稼働だが、監視体制が成熟すれば週末も含めた連続運用への移行も視野に入る。
この記事のポイント
- WooCommerce.com本番サイトがナイトリービルドで稼働し、問題の早期発見を実現
- AIがパッチ再適用、コードレビュー、探索的テストを自動化し、従来人手だった工程を連続実行可能に
- 初回稼働から2週間でデータベースインデックス問題を検出し、公開リリース前に対策
- 拡張機能開発者はWooCommerce Coreベータ版での早期テストがこれまで以上に重要に
- テレメトリ自動監視の成熟により、将来的には完全自動化されたデプロイパイプラインを目指す
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
クロスドキュメントビュー遷移の三大落とし穴と回避策
クロスドキュメントビュー遷移(Cross-Document View Transitions)は、MPA(マルチページアプリケーション)でありながらSPAのようなスムーズなページ遷移アニメーションを実現するブラウザAPIだ。ReactやAstroといったフレームワークは不要で、HTMLページ間のリンク遷移にブラウザが自動的にアニメーションを付与する。
しかし、この機能の導入にはいくつかの厄介な落とし穴が潜んでいる。CSS-Tricksの記事によれば、著者は実装に丸一日を費やし、何も動作しない状態からデバッグを繰り返したという。ネット上には古い情報や誤解を招くチュートリアルが溢れており、仕様自体も短期間で変更されている。
本記事では、実際の開発現場で遭遇する3つの主要な問題(非推奨metaタグ、4秒タイムアウト、画像の歪み)とその解決策を解説する。加えて、遷移ライフサイクルを制御する2つのイベントについても触れる。
非推奨となったmetaタグの罠
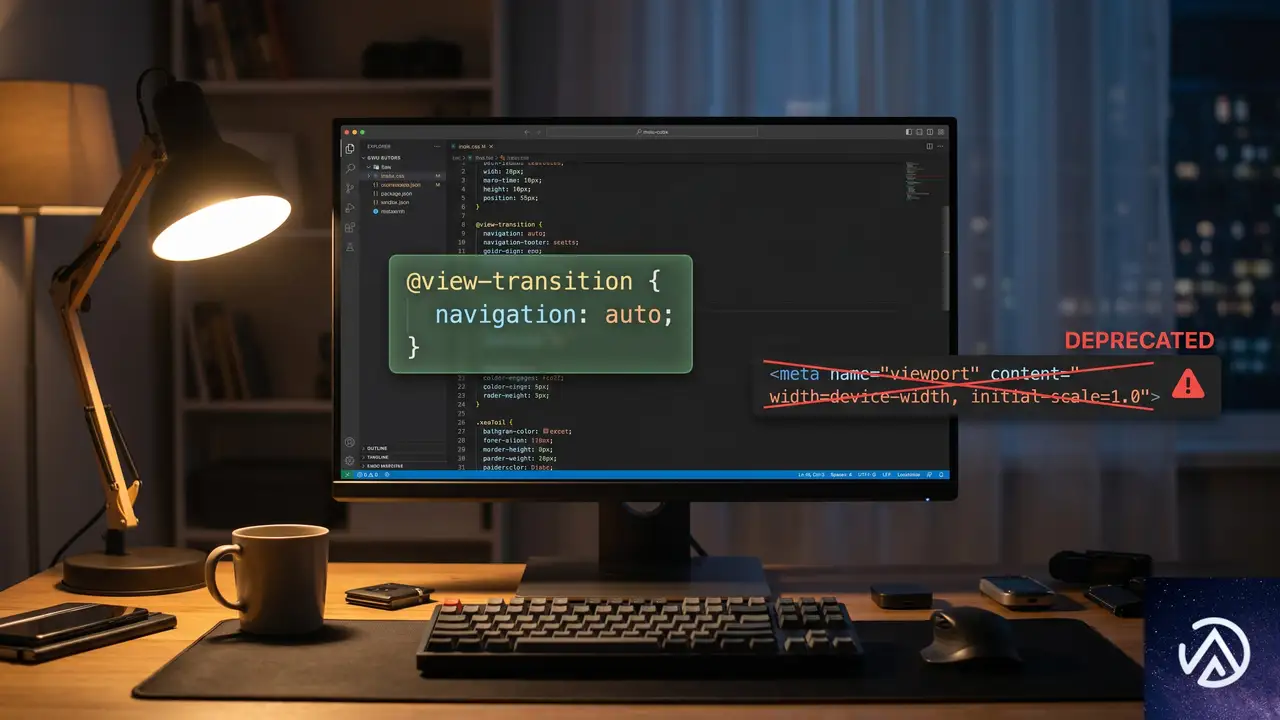
多くの開発者が最初にハマるのが、古いチュートリアルに記載された<meta>タグによるオプトイン方式だ。この方式は既に非推奨であり、現在のブラウザでは完全に無視される。
この比較が示すように、現在の正しい実装方法はCSSの@規則を使用することだ。Chrome 111でmetaタグが導入された後、Chrome 126前後でCSSベースの方式に置き換えられた。非推奨の警告はDevToolsに表示されず、古いコードは静かに動作しなくなる。
なぜCSS方式に移行したのか
metaタグ方式の最大の欠点は、ページ全体でオンかオフかの二択しかできなかったことだ。CSS方式ではメディアクエリや@supportsと組み合わせて、条件付きのオプトインが可能になる。
@media (prefers-reduced-motion: no-preference) {
  @view-transition {
    navigation: auto;
  }
}

@media (min-width: 768px) {
  @view-transition {
    navigation: auto;
  }
}
このアプローチにより、アニメーションに敏感なユーザーへの配慮や、モバイルデバイスでのパフォーマンス最適化が容易になった。CSSにオプトインが統合されたことで、既存のスタイル管理フローと一貫性を持って扱える点も大きい。
両方のページでオプトインが必須
もう一つの重要なポイントは、遷移を機能させるには遷移元と遷移先の両方のページで@view-transitionが宣言されている必要があることだ。片方だけでは何も起きない。これは意図的な設計で、404ページやログインリダイレクトなど遷移をスキップしたいページを柔軟に制御できる。
なお、navigation: autoはユーザーがリンクをクリックするかブラウザの戻るボタンを押した場合のみ発動する。window.location.hrefによるプログラム的な遷移や、クロスオリジンのリンク、POSTリクエストでは動作しない。この保守的な設計は、決済処理などの重要な操作に意図しないアニメーションが混入するのを防ぐためだ。
4秒タイムアウトが遷移を静かに殺す
ビュー遷移の実装で最もデバッグが難しい問題が、ハードコードされた4秒のタイムアウトだ。新しいページが4秒以内にレンダリング可能な状態に達しないと、遷移アニメーションは何の通知もなくキャンセルされ、通常のページ読み込みのように切り替わる。
この問題が厄介なのは、ローカル開発環境ではまず発生しないことだ。devサーバーは80msで応答するため遷移は完璧に動作するが、本番環境でサーバーレス関数のコールドスタートやCDNキャッシュミスが発生すると、最初のクリックで遷移が無効化される。
pagerevealイベントでタイムアウトを捕捉する
タイムアウトの発生を検知するには、pagerevealイベントとviewTransition.finishedプロミスを使用する。以下のコードをページに組み込めば、遷移が失敗した際にコンソールで確認できる。
window.addEventListener("pagereveal", (event) => {
  if (!event.viewTransition) {
    console.log("ビュー遷移なし");
    return;
  }
  event.viewTransition.finished
    .then(() => console.log("遷移完了 ✅"))
    .catch((err) => {
      console.error("遷移中断", err.name, err.message);
    });
});このリスナーを早期にセットアップしておけば、本番環境でのデバッグが格段に容易になる。pageswapイベントでも同様に遷移元ページ側でタイムアウトを捕捉可能だ。
実用的な対策
タイムアウト対策の基本はページの読み込み速度改善だが、より実践的なアプローチとしてrel="expect"属性の活用がある。
<link rel="expect" href="#hero" blocking="render">これはブラウザに「#hero要素がDOMに存在するまでページをレンダリング可能と見なさない」と指示するものだ。一見するとパフォーマンスを悪化させるように思えるが、ビュー遷移においては重要なコンテンツが揃ってからスナップショットを取得するため、中途半端な状態での遷移を防げる。
タイムアウトのクロックはナビゲーション開始時からカウントされるため、サーバー応答時間(TTFB)も含まれる点に注意が必要だ。サーバーが2秒かけて応答し、さらに2.5秒かけてレンダリングする場合、個別には遅く感じなくても合計で4.5秒となりタイムアウトに引っかかる。
画像が歪む根本原因と解決策
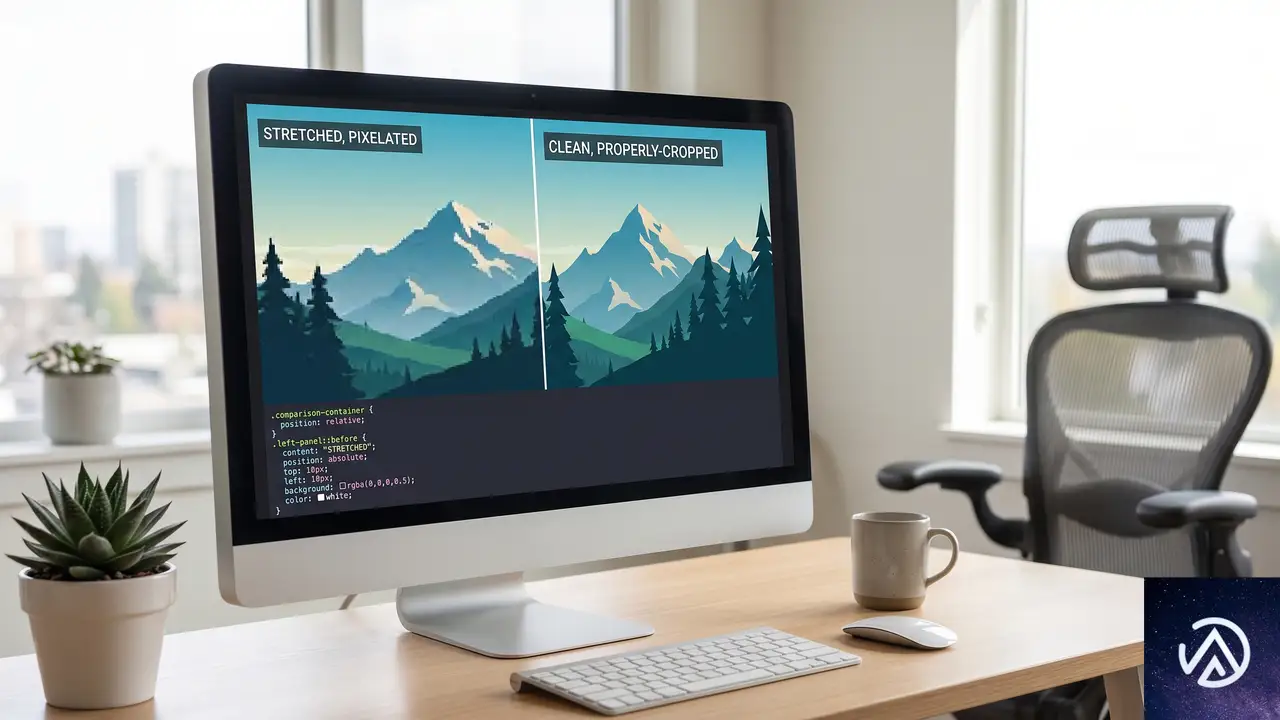
ビュー遷移の実装で視覚的に最も目立つ問題が、アスペクト比の異なる画像間の遷移で発生する歪みだ。サムネイルからヒーロー画像への遷移で、画像が引き伸ばされて見苦しくなる現象は多くの開発者が経験する。
CSS-Tricksの著者は、この問題の原因を特定するのにかなりの時間を費やしたという。根本的な原因は、ブラウザが遷移中に<img>要素そのものをアニメーションさせるのではなく、古い状態と新しい状態のスクリーンショット(ビットマップ)を取得し、それらを変形させることにある。
上記の図が示すように、解決策は疑似要素::view-transition-oldと::view-transition-newに対してobject-fit: coverを適用することだ。これにより、スナップショット画像がアスペクト比を維持したまま切り抜かれるようになる。
疑似要素ツリーの構造を理解する
ビュー遷移が発生すると、ブラウザは内部的に次のような疑似要素ツリーを生成する。
::view-transition
└── ::view-transition-group(hero-img)
    ├── ::view-transition-old(hero-img)
└── ::view-transition-new(hero-img)::view-transition-groupが古い寸法から新しい寸法へアニメーションするコンテナとして機能し、その中のoldとnewが実際のスナップショットを保持する。デフォルトではこれらの疑似要素にobject-fit: fillが適用されており、これが歪みの原因となる。
アスペクト比が大きく異なるケースでは、object-positionで切り抜き位置を調整することも有効だ。
::view-transition-old(hero-img) {
  object-fit: cover;
  object-position: center center;
}
::view-transition-new(hero-img) {
  object-fit: cover;
  object-position: center top;
}このコードでは、新しいヒーロー画像の上部を優先的に表示しつつ、遷移中の歪みを防ぐことができる。CSS-Tricksの著者も指摘するように、object-fit: coverはほぼ全ての画像遷移で必要になる設定であり、デフォルトがfillであることは実用上の大きな障壁となっている。
pageswapとpagerevealによるライフサイクル制御
クロスドキュメントビュー遷移では、遷移元と遷移先のページがJavaScriptで直接通信できないという制約がある。この問題を解決するのがpageswapとpagerevealの2つのイベントだ。
このイベントペアにより、開発者は遷移の両端で状態を制御できる。pageswapは遷移元ページがスナップショットされる直前に発火し、event.activation.entry.urlでユーザーがどこへ向かっているかを知ることができる。
イベントハンドラの実装パターン
これらのイベントを使用する際の重要なポイントは、必ずevent.viewTransitionの存在確認を行うことだ。pagerevealはビュー遷移がない場合も含め、全てのナビゲーションで発火する。
window.addEventListener("pagereveal", (event) => {
  if (!event.viewTransition) return;

  event.viewTransition.finished.then(() => {
    // 遷移完了後のクリーンアップ
  }).catch((err) => {
    // タイムアウト等のエラー処理
  });
});CSS-Tricksの記事では、商品一覧ページから商品詳細ページへの遷移において、pageswapでクリックされた商品カードだけにview-transition-nameを動的に付与するパターンが紹介されている。この動的な名前付けは、数十から数百の要素があるページでのスケーラビリティ問題を解決する重要な手法だ。
この記事のポイント
- metaタグ方式は非推奨。CSSの
@view-transition { navigation: auto; }を使用する - 4秒のタイムアウトはTTFBを含む総時間で判定され、
pagerevealイベントで捕捉可能 - 画像歪みは疑似要素
::view-transition-old/newへのobject-fit: cover適用で解決 pageswapとpagerevealの2つのイベントが遷移全体のライフサイクルを制御する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験