

B2BKingのMCP連携でWooCommerce B2BストアをAIが設定。仕組みと接続手順
WooCommerce向けB2B・卸売販売プラグインのB2BKingが、MCP連携機能を実装した。AIアシスタントが自然言語の指示だけで、ストア設定の読み取りから変更までを実行できる。従来は数時間かかっていた設定作業が、数分で完了する可能性がある。
対応するのはClaude、Codex(OpenAIのコーディングエージェント)、Cursor、VS Codeなど、MCP(Model Context Protocol)をサポートするすべてのAIツールだ。コードを書く必要も、設定画面を1つずつ巡回する必要もない。
B2BKingのMCP連携とは何か
B2BKingはWooCommerce向けのB2B・卸売販売プラグインだ。約7年の開発実績を持ち、累計1万5,000以上のWooCommerceストアで稼働している。このB2BKingが、WordPressの標準API群を通じてAIアシスタントから直接設定を変更できる仕組みを実装した。
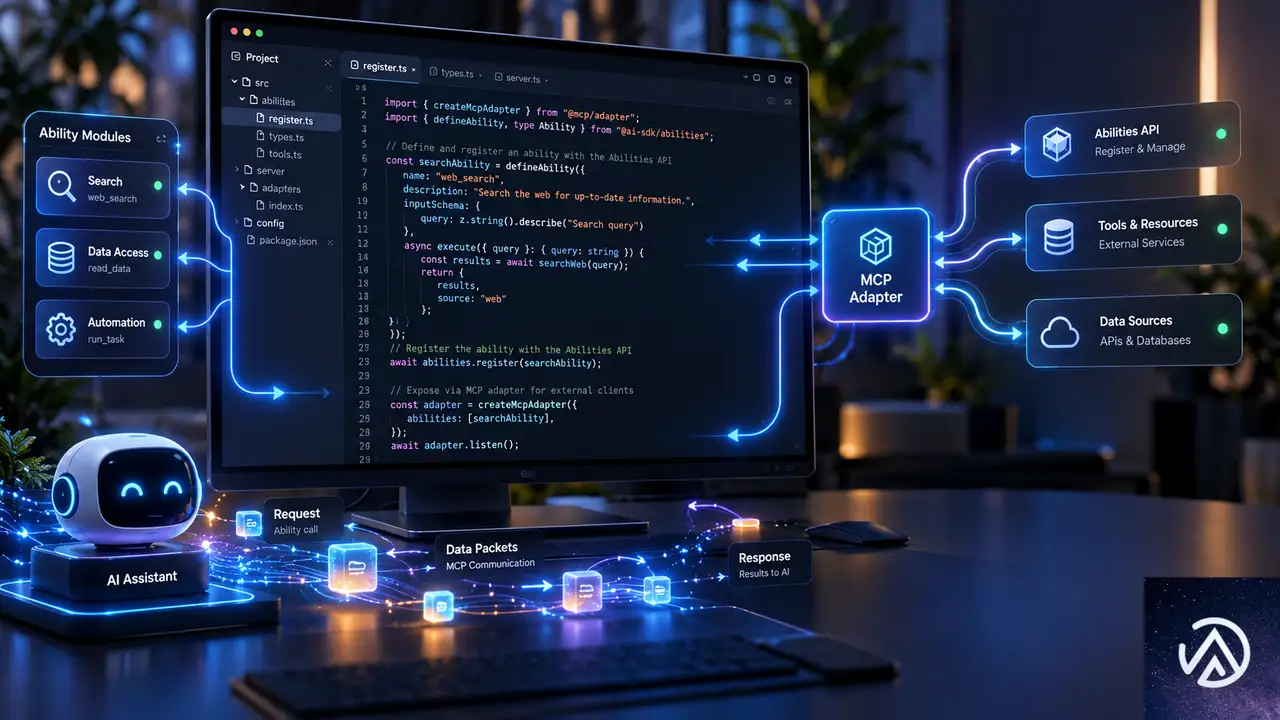
具体的には、B2BKingがWordPress Abilities APIに主要なストア設定を「能力」として登録する。その能力を公式のWordPress MCP AdapterがMCP経由で外部に公開し、MCPをサポートするAIアシスタントが利用できるようになる。特定のAI製品向けの独自コネクタを作るのではなく、オープンな標準の上に構築されている点が特徴だ。
一度接続すると、英語で普通の文章を入力するだけでストア設定を操作できる。B2B限定ストアとハイブリッドB2B/B2Cの切り替え、ゲストの閲覧制御、顧客グループの作成、卸売価格や最低注文金額の設定、顧客のグループ割り当てなどが対象となる。
指示はAIアシスタントからMCP Adapterへ送られ、B2BKingが登録した能力を通じてWooCommerceに反映される。すべて標準化されたプロトコル上で動作するため、特定のAI製品に依存しない。
AIが設定できる5つの領域
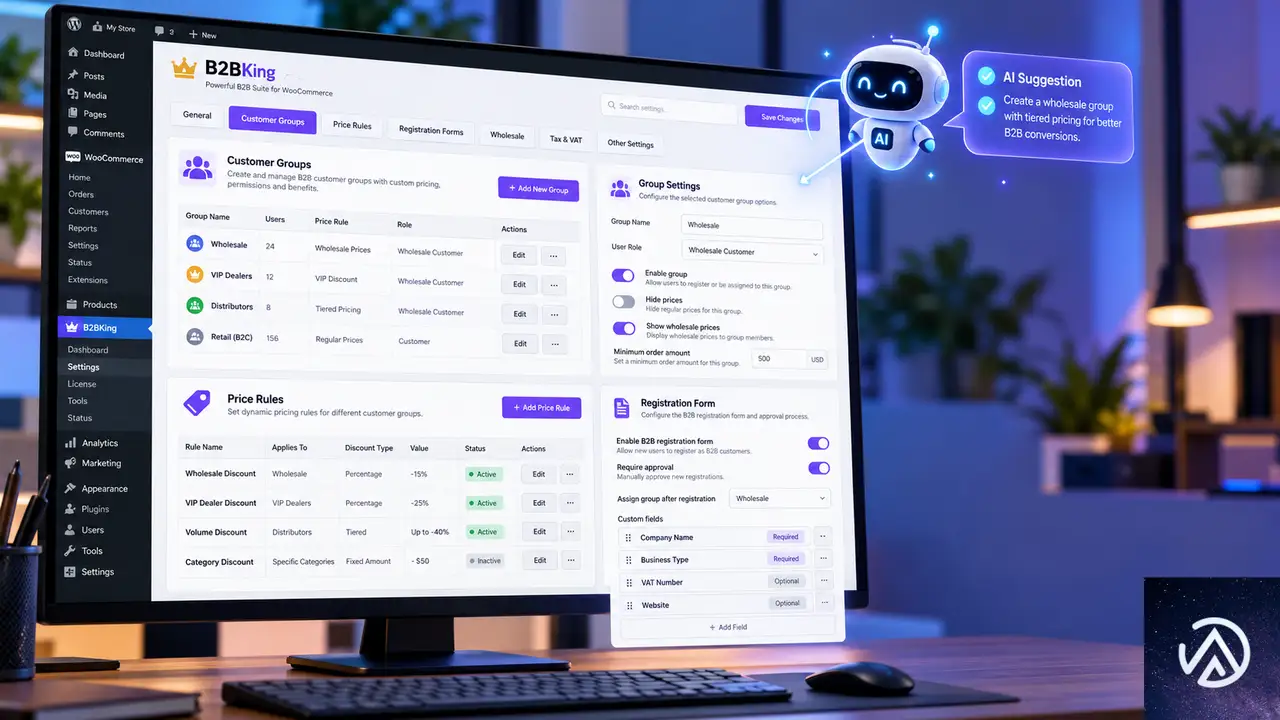
現時点でAIが操作できる範囲は、B2Bストアの構築に必要な主要な決定事項をカバーしている。大きく5つの領域に分類できる。
ストア全体の設定と登録機能
1つ目はストア構成だ。AIがB2BKingの設定全体を読み取り、B2B限定モードとハイブリッドB2B/B2Cモードを切り替えられる。ゲストが見る内容も制御でき、価格の非表示、ショップ全体の非表示、ログイン限定ストア、価格の代わりに見積依頼を表示する設定などに対応する。
2つ目は登録と機能の制御だ。B2B登録フォームの有効化、ロールのドロップダウン表示、アカウント承認フローをオン・オフできる。見積依頼、会話機能、オファー、購入リスト、一括注文フォーム、会社サブアカウントなどの機能も同様に操作できる。
顧客グループと価格ルールの操作
3つ目は顧客グループの管理だ。既存のグループを一覧表示するだけでなく、リセラーやディストリビューターなどの新しいグループを作成できる。グループには与信枠を設定することも可能だ。
4つ目は価格ルールだ。パーセント割引、固定金額割引、固定価格、送料無料、最低注文金額などのルールを、全B2B顧客または特定のグループに対して設定できる。適用範囲もカタログ全体、単一商品、カテゴリ単位で指定できる。
5つ目は顧客の個別管理だ。特定の顧客のB2Bステータス、所属グループ、承認状態を確認し、B2Bグループへの移動やB2Cへの戻しを実行できる。グループを作成した後のルール適用や顧客の移動も、同じ会話の中で続けて指示できる。
手動で設定画面を巡回する作業が、AIアシスタントへの1つの指示文で置き換わる。所要時間は数時間から数分へ短縮される。
WordPress Abilities APIとMCPの技術的仕組み
Abilities APIの役割
WordPress Abilities APIはWordPress 6.9からコアに導入された標準機能だ。プラグインが「自分に何ができるか」をAIに宣言するための共通の方法を提供する。各能力(アビリティ)には、説明文、期待する入力データのスキーマ、権限チェックの3つが含まれる。
これによりAIは、ある操作が何をするのかを事前に理解できる。さらに、ログイン中のユーザーがその操作を実行できるかどうかも、何かが起こる前に検証される。B2BKingは主要なストア設定をこのAbilities APIに登録している。
MCP Adapterの役割
MCP(Model Context Protocol)は、AIアシスタントが外部ツールと会話するためのオープンプロトコルだ。Claude、Codex、Cursor、VS Codeが同じB2BKingの設定を操作できるのは、このMCPが共通の通信基盤になっているからだ。
公式のWordPress MCP Adapterは、Abilities APIに登録された能力をMCP経由で外部に公開する橋渡し役を担う。ライブサイトとローカル開発環境の両方で動作し、WordPressのAIエコシステム全体が成熟するほどB2BKingも自動的に恩恵を受ける構造だ。
注目すべきは、この設計が特定のAI製品へのロックインを避けている点だ。独自のコネクタを開発するのではなく、オープンな標準に乗っているため、MCPをサポートする新しいAIツールが登場すれば、追加の開発なしで利用可能になる。
AIによるストア設定の安全性
AIがストア設定を変更できると聞くと、多くのストア運営者は「制御を失うのでは」と不安に感じる。B2BKingはこの懸念に対して、複数の安全機構を実装している。
実行前のチェック機構
第1に、すべての能力が実行前に接続ユーザーのWordPress権限(ケイパビリティ)をチェックする。権限のないユーザーが接続しても、変更操作は実行できない。
第2に、入力値の検証が行われる。存在しないグループやカテゴリを指定したルール、100%を超える割引率などをAIが指示しても、検証によって拒否される。B2BKingが各ステップを実行時に確認する仕組みだ。
第3に、各能力は読み取り専用か変更を伴うものかがラベル付けされている。AIクライアントは変更実行前にユーザーへ確認を求める設定にできる。第4に、ライセンスキーはAIアシスタントに渡らない設計になっている。
4つの安全機構により、AIがストア設定を誤って変更するリスクを抑えている。特にライセンスキーがAIに渡らない設計は、セキュリティ面で重要なポイントだ。
開発者向けフィルター
開発者向けには2つのフィルターが用意されている。b2bking_mcp_enabledでMCP連携を完全に無効化できる。またb2bking_mcp_write_enabledで読み取り専用に制限することも可能だ。本番ストアでは読み取り専用にしておき、ステージング環境でのみ書き込みを許可するといった運用が現実的だろう。
ClaudeやCodexとB2BKingの接続手順
MCPをサポートするAIアシスタントならどれでも動作するが、ClaudeとCodexが最も始めやすい。接続設定自体もAIに任せられるためだ。コードを書く必要はない。AIはB2BKingに組み込まれた能力を通じてのみ動作する。
AIに接続設定を任せる方法
最も簡単な方法は、ClaudeやCodexに「公式WordPress MCP Adapterを使用してMCP経由でストアに接続したい」と伝えることだ。AIが必要なインストールと設定を判断して進めてくれる。
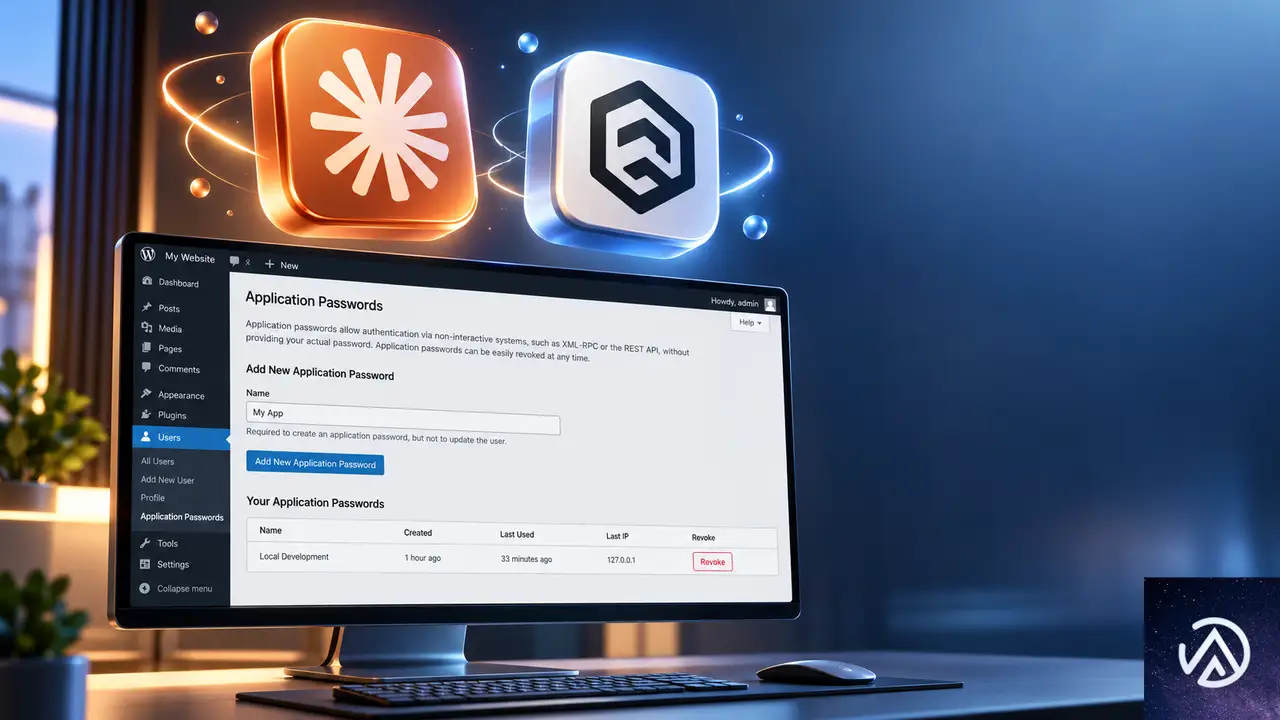
通常、AIが求めるのはアプリケーションパスワードのみだ。WordPress管理画面の「ユーザー」→「プロフィール」→「アプリケーションパスワード」から作成できる。これだけで接続は完了する。
手動で接続する手順
自分で設定する場合は、以下の手順を踏む。まずWordPress 6.9以降と最新版のB2BKingが必要だ。次にMCP Adapterプラグインをインストールし、アプリケーションパスワードを作成する。最後にAIクライアントのMCP設定に短い設定項目を追加する。
B2BKing側で何かを有効化する必要はない。能力は自動的に登録されるためだ。設定スニペットの全文はB2BKing公式サイトの「AIによるWooCommerce B2Bストア構築ガイド」に掲載されている。
接続後は、以下のような指示文を送るだけで設定作業が始まる。
ストアをハイブリッドB2B/B2Cモードに設定して。ゲストには価格の代わりに見積依頼を表示。Wholesaleグループを与信枠5,000ドルで作成し、全体に15%割引と最低注文300ドルを適用。AIはまず現在のB2BKing設定を読み取り、状況を把握する。その後、ハイブリッドモードへの切り替え、ゲスト見積依頼の設定、Wholesaleグループの作成、15%割引ルールと300ドル最低注文ルールの追加を順番に実行する。各ステップでB2BKingが検証を行い、すべて完了するとAIが変更内容を報告する。
この記事のポイント
- B2BKingがMCP連携に対応し、ClaudeやCodexから自然言語で操作できる
- Abilities APIとMCP AdapterというWordPress標準の仕組みで構築されている
- ストア構成、登録機能、顧客グループ、価格ルール、顧客管理の5領域を設定できる
- 権限チェック、入力検証、読み取り/書き込み区別、ライセンスキー遮断の4重の安全機構を備える
- 7年の実績と1万5,000以上のストアで使われてきた信頼性の上にAI連携が乗っている

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPressのMCP接続、3つの選択肢を比較。Elementorユーザーが最初に試すべき方法
WordPressにMCP(Model Context Protocol)でAIエージェントを接続する方法が、2026年10月に入って大きく変わった。WordPressプロジェクトが公式のMCPアダプターをリリースし、一方でElementorはバージョン4.3.0からMCP機能を標準搭載した。
現在、WordPress向けMCP接続には3つの選択肢がある。公式のWordPress MCP Adapter、非公式のMCPサーバー、そしてElementor内蔵のMCPだ。それぞれ設定の手間やメンテナンス負担が異なる。
この記事では3つの選択肢の違いを整理し、どのようなサイト運営者がどれを選ぶべきかを解説する。特にElementorを使っているなら、追加インストール不要の内蔵MCPが最短ルートになる。
WordPressのMCP接続とは何か

MCP(Model Context Protocol)は、AIエージェントが外部のサイトやツールに接続するための共通規格だ。ClaudeやCodexなどのAIクライアントが、WordPressサイトの機能を呼び出すための橋渡し役を果たす。この仕組みを使うと、AIエージェントはサイト上の操作を自動化できるようになる。
MCPが登場する前は、AIエージェントをWordPressに接続する手段が統一されていなかった。サービスごとに独自のAPIを用意する必要があり、開発者にとっては接続のたびに学習コストがかかっていた。MCPはこの接続方法を標準化し、1つの仕組みでさまざまなAIクライアントと連携できる道を開いた。
MCPが解決する接続の課題
従来の接続方式では、サイト側とAIクライアント側の両方に個別の設定が必要だった。MCPはこの複雑さを抽象化し、AIエージェントが「ツール」「リソース」「プロンプト」という3つの単位でサイトの機能を扱えるようにする。たとえば「商品を更新する」「スタイルを変更する」といった操作が、AIエージェントから呼び出せる単位になる。
WordPressのAbilities APIとは
WordPressにはAbilities APIという標準がある。これは、WordPress本体や各プラグインが持つ機能をAIエージェントに公開するための仕組みだ。Abilities APIに登録された機能は、MCP接続を通じてAIエージェントが発見し、呼び出せるようになる。
重要なのは、Abilities APIはどのMCP接続方式でも利用できる点だ。WordPress MCP Adapterでも、Elementor内蔵MCPでも、同じ標準に基づいて機能が公開される。つまり、MCP接続の選択肢が増えても、プラグイン側が対応すべき仕組みは共通である。
3つの方法はそれぞれ性質が異なる。次のセクションから順番に見ていく。
WordPress MCP Adapterの仕組み
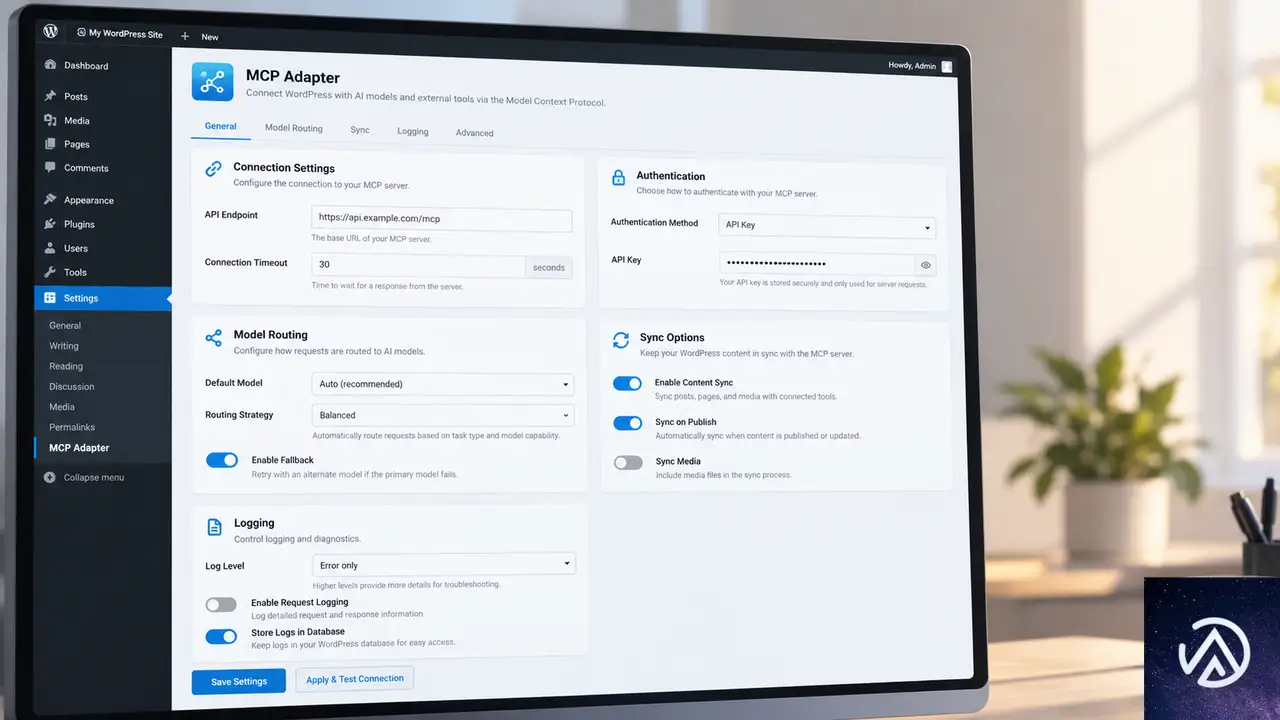
2026年10月2日、WordPress MCP Adapterのバージョン0.7.0がWordPress.orgのプラグインディレクトリに公開された。これまでGitHub上でのみ入手可能だったが、公式ディレクトリに登場したことで、一般のサイト運営者にとって入手のハードルが大きく下がった。
このプラグインの役割は、Abilities APIに登録された機能をMCPの「ツール」「リソース」「プロンプト」に変換することだ。AIエージェントはこの変換を通じて、WordPressサイトの機能を発見し、呼び出せるようになる。注意すべきなのは、このプラグイン自体はAI機能を追加しないという点だ。
WordPress MCP Adapterは「橋」にすぎない。実際にAIエージェントが実行できる操作は、サイトに導入済みのプラグインがAbilities APIに登録した内容に依存する。つまり、Adapterを導入しただけでは何も起きず、Abilitiesを提供するプラグインが揃って初めて機能する。
手動設定の具体的な手順
WordPress MCP Adapterには、現時点で設定画面や製品内の案内が用意されていない。接続するには、まずWordPressでアプリケーションパスワードを生成し、次にAIクライアントの設定ファイルを編集してサーバーエンドポイントを指定する必要がある。設定ファイルの編集に慣れている開発者向きの手順だ。
Adapterが持つ制約
WordPress MCP Adapterはバージョン0.7.0という早期段階にある。動作にはWordPress 6.9以降が必要で、まだ正式リリースには至っていない。今後のバージョンアップで設定画面が追加される可能性はあるが、現時点では技術的な知識なしに接続するのは難しい。
非公式MCPサーバーの注意点

WordPress向けの非公式MCPサーバーは、個人開発者やサードパーティが公開しているプラグインやリポジトリとして存在する。これらは公式のWordPress MCP Adapterが登場する前から利用されてきた経緯がある。
メンテナンスと権限のリスク
非公式MCPサーバーを使う際の最大の懸念は、品質のばらつきだ。メンテナンスが継続的に行われているか、どの権限を要求するか、サイトや利用者に関するどのようなデータを保存するか、AIエージェントにどこまで操作を許可するか。これらがサーバーごとに異なる。
また、非公式MCPサーバーの多くは手動設定が必要だ。WordPress MCP Adapterと同様に、アプリケーションパスワードを生成してAIクライアント側に設定する作業が発生する。さらに、更新の有無を自分で確認し続ける必要がある。
セキュリティの観点では、信頼できる開発者による実績のあるサーバー以外は避けるのが無難だ。特にクライアントの本番サイトでは、権限が過剰なものやデータの取り扱いが不透明なものは導入すべきではない。
Elementor内蔵MCPの違い
公式のElementor MCPは、Elementor 4.3.0以降に標準搭載されている。追加でダウンロードするプラグインは不要だ。Elementorがインストールされて有効化されていれば、そのままMCP接続を開始できる。
この「追加インストール不要」という点は、サイト運営者にとって実務上の大きな利点になる。プラグインを増やせば増やすほど、更新の手間や互換性リスクが積み上がる。内蔵機能としてMCPが使えるなら、その負担を増やさずに済む。
UIで完結する設定フロー
Elementor MCPの設定は、WordPressダッシュボード内の専用UIで完結する。「Elementor」メニューから「Elementor MCP」を開き、利用するAIツールを選択して、画面に表示される手順に従うだけだ。設定ファイルを直接編集する必要はない。
アプリケーションパスワードはElementorがバックグラウンドで自動生成する。利用者がパスワードを手動で生成したり、AIクライアントに設定を書き込んだりする作業は不要だ。この手順の簡潔さは、技術的な知識がないサイト運営者にとって大きな意味を持つ。
直接接続がもたらす安全性
Elementor MCPの接続では、アプリケーションパスワードはサイトとAIツールの間だけで保持される。Elementorがパスワードを閲覧することはなく、AIツールはサイトに直接接続する。中間に何かを介在させない設計になっている。
設定の手間を比較すると、Elementor内蔵MCPは技術的な知識がなくても接続できる。対してWordPress MCP Adapterと非公式サーバーは、設定ファイルの編集という作業が発生する。この差は実務上の導入障壁に直結する。
ProとAngieで広がる機能
Elementor単体でもMCP接続は可能だが、Elementor ProとAngieを追加すると、AIエージェントが扱えるAbilitiesの範囲が広がる。どちらを選ぶにせよ、MCP接続の方式とは独立した追加機能として考えるのがよい。
Elementor Proが追加するAbilities
Elementor Proは、Theme Builder、Loops、Forms、動的コンテンツ、表示条件などのツールを追加する。これらの機能がAbilitiesとして登録されることで、AIエージェントはより高度なサイト構築・編集作業を実行できるようになる。
Angieが開くプラグイン連携の幅
AngieはElementor公式のAIプラグインだ。カスタムウィジェットやアプリの生成、WordPress管理画面のカスタマイズ、サイト全体にわたる一括操作などをAIエージェントに提供する。Angie自身が独自のAbilitiesを持つことに加えて、他のプラグインがAbilities APIに登録した機能にも到達できるようになる。
具体的には、WooCommerce、Yoast、WPForms、Jetpack、ACFなどがAbilities APIに登録した機能を、Elementor MCPの接続を通じてAIエージェントが利用できる。1つの接続でサイト全体のスタックにアクセスできる点がAngie導入の強みだ。
Angieを導入すると、Elementorの機能に限定されないサイト全体の自動化が視野に入る。ECサイトの商品更新、SEO設定の調整、フォームデータの処理など、プラグインごとの機能をAIエージェントが横断的に扱えるようになる。
どの選択肢を選ぶべきか
3つの選択肢を比較したうえで、実際にどれを導入するかはサイトの状況によって異なる。ここではサイト運営のタイプ別に推奨を整理する。
サイト運営タイプ別の推奨
- Elementorを使っている場合 → 追加インストール不要の内蔵MCPから始めるのが最短。Elementor 4.3.0以降にアップデートして、ダッシュボードの「Elementor」→「Elementor MCP」から設定する。
- Elementorを使っていない場合 → WordPress MCP Adapterが公式の選択肢になる。ただし手動設定が必要なため、設定ファイルの編集に慣れていることが前提になる。
- 全プラグインのAbilitiesを横断的に使いたい場合 → ElementorユーザーならAngieを追加する。Elementorユーザーでなければ、Abilities API対応プラグインを個別に導入してWordPress MCP Adapterで接続する。
- セキュリティを最優先する場合 → 実績のある公式の選択肢(WordPress MCP AdapterまたはElementor MCP)を選ぶ。非公式サーバーは権限やデータ取り扱いを個別に精査してから判断する。
1つ留意すべき点がある。この比較はElementor公式ブログの記事に基づいており、自社製品に有利な視点が含まれる可能性は否定できない。特に「設定の簡潔さ」や「直接接続の安全性」といった評価は、Elementor側の主張として受け止めるのが妥当だ。
とはいえ、MCPの標準化そのものはプラグインやベンダーに依存しない動きであり、WordPress全体のエコシステムにとって前進である。WordPress MCP Adapterが公式ディレクトリに登場したことと、Elementorが内蔵MCPを提供したことは、どちらも「AIエージェントがWordPressに接続する」という流れを加速させる。
今後、WordPress MCP Adapterのバージョンが進み、設定画面が追加されれば、技術的な知識がない運営者でも公式アダプターを使いやすくなる可能性がある。Abilities APIに対応するプラグインが増えれば、MCP接続の価値はさらに高まる。選択肢の優劣は、時間とともに変わることを見越しておくのがよい。
この記事のポイント
- WordPress向けMCP接続には「WordPress MCP Adapter」「非公式MCPサーバー」「Elementor内蔵MCP」の3つの選択肢がある。
- WordPress MCP Adapterは2026年10月2日にWordPress.orgへ登場。バージョン0.7.0で、WordPress 6.9以降が必要。設定は手動。
- 非公式MCPサーバーはメンテナンスや権限のばらつきが大きく、本番サイトでは慎重な選定が必要。
- Elementor MCPは4.3.0以降に内蔵され、追加インストール不要。UIで数ステップの設定で完了する。
- Angieを導入すると、WooCommerceやYoastなど他プラグインのAbilitiesにも1つのMCP接続で到達できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがAI偽装フロント作戦2件を遮断。ロシア発は過去最大級カテゴリ5
OpenAIは2026年10月8日、ロシア発とイラン発のAIを利用した偽装フロント作戦2件を遮断したと発表した。ロシア発の作戦は影響工作の評価尺度でカテゴリ5と判定され、これはOpenAIが報告を開始して以来初の事例となる。
偽装フロントとは、実在しない組織や人物を装って情報を流す手口だ。ロシア発の作戦はラテンアメリカで偽のシンクタンクを運営し、イラン発の作戦は7人の偽ジャーナリスト人格を使って記事を各国メディアに売り込んだ。いずれもAIが作業の効率化に使われていた。
この記事では、2件の作戦の具体的な手口と影響力評価、AIが偽装フロントに与える利点、そしてメディアや企業が取るべき対策を解説する。
摘発の概要と偽装フロントの仕組み
OpenAIは2025年初頭から、AIモデルを使ったサイバー攻撃や隠密影響工作、詐欺などの悪用事例を継続的に報告してきた。今回の発表はその一環で、ロシア発とイラン発の組織的な作戦2件を特定し、関連するChatGPTアカウント群を停止した。
偽装フロントとは、実在する組織や人物を装って活動の正体を隠す手法だ。今回摘発された2件はいずれも、AIと従来型の技術を組み合わせて偽装組織を運営していた。目的は、地政学的な対立や紛争に関するメッセージを対象者に届けることにある。
AIが加わった偽装フロントの特徴
OpenAIの報告によると、今回の2件はAI以前の影響工作に似ている一方で、AIによって作業の一部が効率化されていた。イラン発の作戦では長文記事の推敲や編集者への売り込みメール作成に、ロシア発の作戦では内部報告書の草案作成にChatGPTが使われた。
OpenAIが2024年初頭以降に摘発した30件の隠密影響工作を分析すると、メディア掲載に成功した作戦ほど影響力が高くなる傾向がある。ソーシャルメディアだけで拡散させる作戦はカテゴリ1から3にとどまり、実在のメディアに記事を掲載させた作戦はカテゴリ4から5に達していた。
影響工作の評価尺度 Breakout Scale
OpenAIは影響工作の影響力を、米ブルッキングス研究所のBreakout Scale(ブレイクアウトスケール)で評価している。カテゴリ1から6までの6段階で、数字が大きいほど影響力が高い。カテゴリ5は政治家の公的コメントを引き出した水準だ。
Breakout Scaleは米ブルッキングス研究所が提唱した影響工作の評価尺度だ。
ロシア発の作戦 ダーククラーク
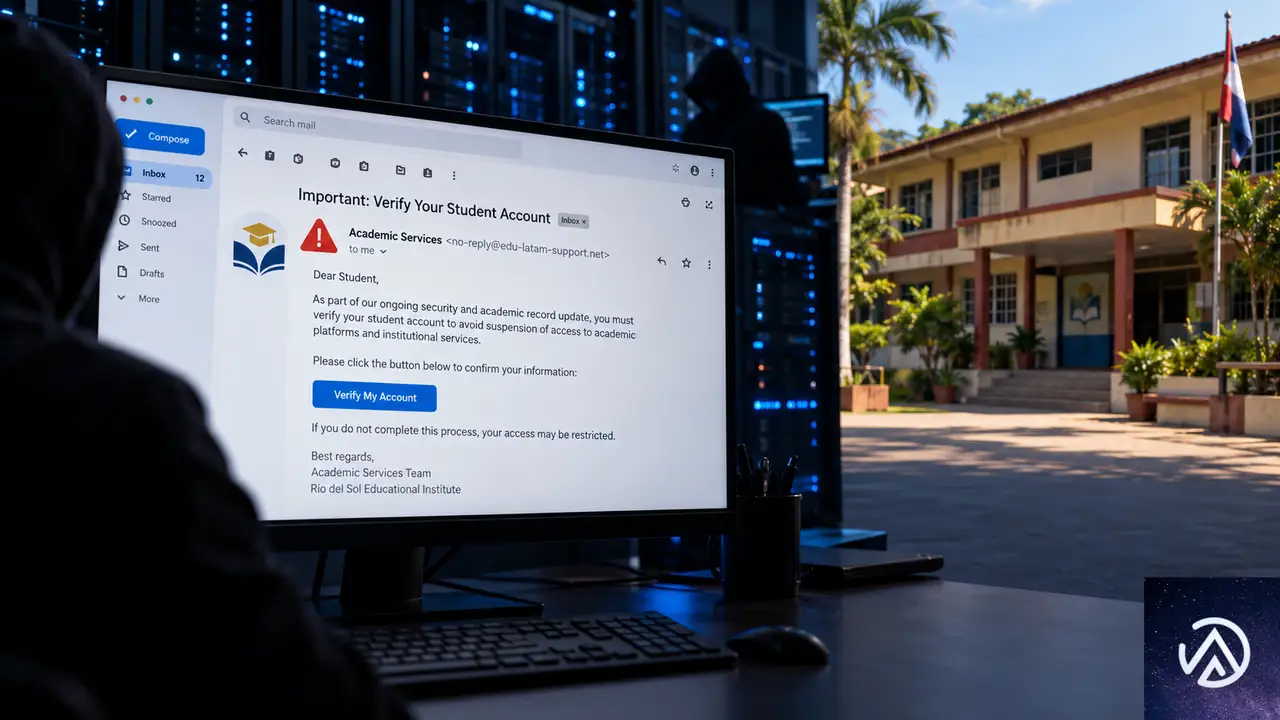
OpenAIはロシアを発信元とするChatGPTアカウント群を停止した。この作戦はラテンアメリカ各国を標的にした隠密影響工作で、ウクライナの評判を落とすことと、アルゼンチンやボリビアなどの国内政治に介入することが主な目的だった。
作戦の運営者はChatGPTを主に3つの作業に使っていた。1つ目は内部報告書の作成、2つ目は作戦用コンテンツの生成、3つ目は偽のシンクタンクの業績報告書の草案作成だ。OpenAIはロシアからのモデルアクセスを許可していないため、運営者はVPNを使って接続していた。
偽シンクタンクSRCの運営実態
この作戦の中心にあったのが、社会調査センター(Social Research Center / SRC)という自称のリサーチプラットフォームだ。表向きはインド系移民とラテンアメリカの関係を研究する組織だったが、実際にはロシアのオペレーターが偽人格のミア・クラーク(Mia Clark)を使って制御していた。
内部報告書には、給与体系や雇用、解雇などの人事決定が記録されており、運営者が単なる協力者ではなく組織を支配していたことを示している。ただし、現地スタッフは自分たちがロシアの作戦のために働いているとは知らなかった。OpenAIの見解では、知らずに利用されたスタッフが誠実に調査業務を行っていた。
SRCのウェブサイトには60本以上の記事が掲載されており、その大半は現地スタッフによる独自の内容だった。これは、過去に摘発された別のロシア系偽シンクタンクが記事の多くを盗用していたのとは対照的だ。OpenAIは、この作戦がより長期的に存続可能な偽装組織を構築しようとしていたと分析している。
学校や地域社会を巻き込んだ偽情報
ロシア発の作戦で特徴的だったのは、現地の学校や公的機関を意図せず偽情報の拡散に巻き込んだ点だ。
2026年5月、運営者はペルーのリマ教育地方局を装った偽のメールアドレスを作成し、文化・言語多様性の日にウクライナにちなんだ行事を開催するよう学区の学校に指示した。メールには、物議を醸す20世紀のウクライナ民族主義者ステパン・バンデラへの言及を求める指示が含まれていた。一部の学校は偽メールに返信し、行事を実施したと報告して写真まで提供していた。
その後、運営者はペルーとポーランドのメディアにこの出来事の記事を掲載させることに成功した。ウクライナが超国家主義的な思想を輸出しているという主張が広がり、ポーランドの欧州議会議員が反応する事態に発展した。ロシアの偽情報は、ウクライナ人とポーランド人の間の歴史的な緊張を刺激する形で設計されていた。
2026年6月には、別の偽メールアドレスを使ってエクアドルの学校を騙し、ダニエル・ノボア大統領と民間軍事会社ブラックウォーターの元トップ、エリック・プリンスへの忠誠宣誓式を開催させようとした。この出来事はエクアドル国内で大きな反響を呼び、政府が偽情報を否定する声明を出すまでに至った。
ロシア発の作戦は、現地の教育機関やメディアを意図せず巻き込むことで信頼性を高めていた。
ボリビアでは2026年5月下旬、反政府デモが激化する中で、国営水道会社EPSASの職員を装った偽の音声を拡散した。政府が行政首都ラパスへの給水を停止し、非常事態を宣言するという内容だった。この偽情報は公式の否定とファクトチェックを引き起こすほど拡散した。
アルゼンチンでは2024年、ハビエル・ミレイ大統領に関する2つの偽情報キャンペーンを実施したと報告している。1つはミレイ氏が愛犬のためにカルティエの宝石付き首輪を購入したという偽の報道、もう1つはブエノスアイレスで反ミレイの落書きを地元の人物に依頼したというものだ。これらの主張は、公開された内部文書に基づいてポリトロジーやラ・コンパニアと呼ばれるロシアの組織に帰属されている。
カテゴリ5という過去最大級の評価
OpenAIはこの作戦をBreakout Scaleのカテゴリ5と評価した。複数の国の政治家から公的なコメントを引き出したことが決め手となった。これはOpenAIが報告を始めて以来、初めてカテゴリ5を付けた事例だ。
ただし、運営者の自己申告には誇張が含まれている可能性がある。OpenAIの調査では、運営者が自分たちの作戦とは無関係の出来事を成果として報告する傾向があった。例えば、ブラジル人兵士の捕虜に関する報道を自らの成果と主張したが、実際にはその報道は作戦とは無関係だった。運営者が自分の雇用主に対しても影響工作を行っていた可能性が指摘されている。
イラン発の作戦 ボガス・バインラインズ
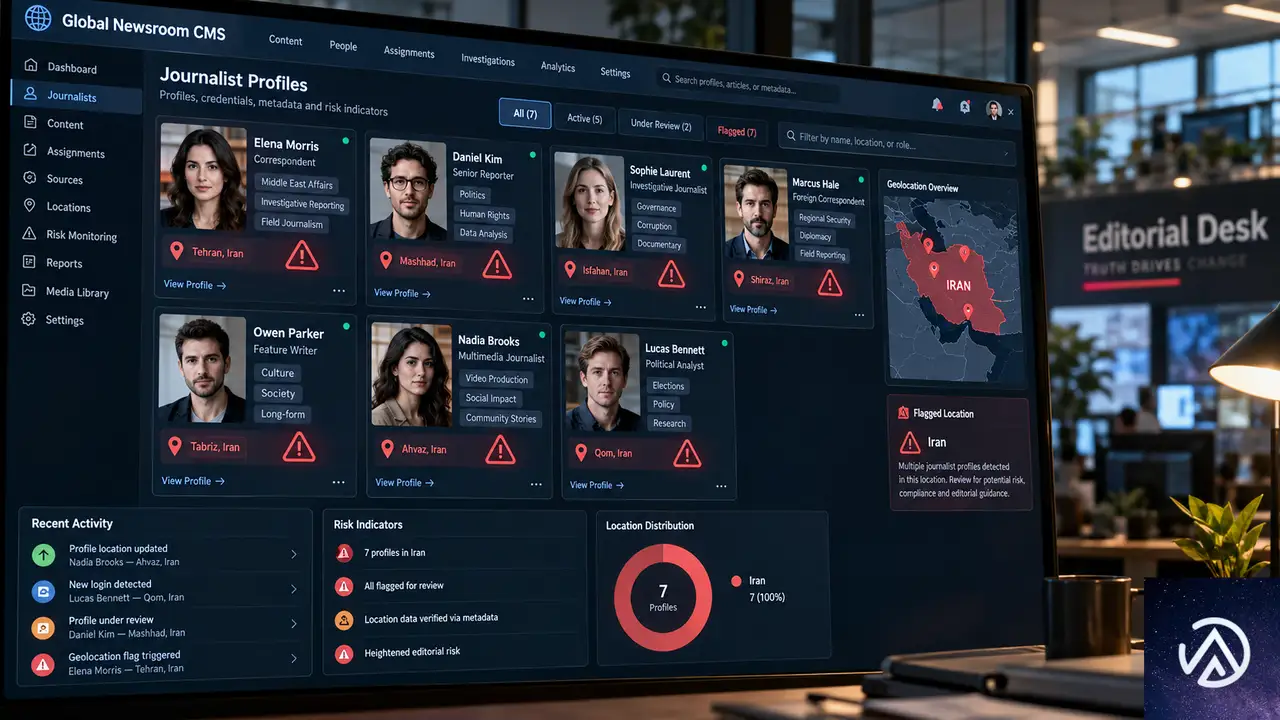
OpenAIはイランを発信元とするChatGPTアカウント群も停止した。この作戦はペルシャ語でプロンプトを入力し、ペルシャ語と英語でコンテンツを生成していた。運営者はVPNを使ってアクセス元を偽装していた。
作戦の主な活動は、米国とイランの紛争に関する長文記事の推敲と、編集者への売り込みメールの生成だった。加えて、ソーシャルメディアのコメントを大量に生成し、内部報告書の作成にもAIを使っていた。OpenAIはこの作戦にボガス・バインラインズ(Bogus Bylines、偽の署名)という名前を付けた。
7つの偽ジャーナリスト人格
記事の売り込みには7つの偽の署名が使われた。アービン・B・ホスキンズ、ノア・ラミントン、ソフィア・ゴンザレス、マイケル・ハリソン、エリカ・フューザー、ジェニー・ウィリアムズ、アリス・ジョンソンだ。
記事と一緒に公開されたプロフィールでは、それぞれが西洋のジャーナリストを装っていた。多くは米国人ジャーナリストで、国際政治や中東、人権、紛争を専門としていた。ノア・ラミントンはニュージーランド在住と主張していた。マイケル・ハリソンの経歴は、ChatGPTに生成させたものだった。
一部の偽人格は、複数のソーシャルメディアに裏付けアカウントを持っていた。アービン・B・ホスキンズはX、Facebook、Instagram、Threadsにアカウントを持ち、米国人フリーランスライターと自称していたが、アカウントの透明性情報では所在地がイランと表示されていた。
一部の偽人格はSNSアカウントで裏付けされ、信頼性を高めていた。
OpenAIはオープンソース調査により、これらの偽署名で公開された記事を約100本、10数媒体で確認した。対象は主に国際情勢や中東問題を扱う中小規模のオンラインメディアで、米国とイランの紛争が激化した2026年3月以降に記事数が急増していた。
記事掲載とコメント生成の影響力の差
記事掲載とコメント生成という2つの活動の影響力は、大きく異なっていた。
記事掲載は高い成果を上げた。記事を掲載したメディアの中には、Facebookで約200万、Xで約35万5000、Instagramで約54万4000のフォロワーを持つものもあった。メディアが記事をSNSで宣伝することで、運営者は自分たちだけでは届かなかった読者にアクセスできた。OpenAIは記事掲載部分をカテゴリ4と評価している。
一方、コメント生成はほとんど影響力を生まなかった。生成されたコメントは「いいね」や返信が1桁から2桁程度にとどまり、投稿に対する全コメントの中でも少数派だった。コメント部分はカテゴリ2と評価されている。
さらに、運営者はコメントの影響力を水増しする計算方法を使っていた。返信先の投稿の閲覧数をコメント投稿前後で比較し、その差をすべて自らの成果として計上していた。投稿の人気や他のコメントによる閲覧増加を考慮しておらず、実際の影響力を大幅に誇張していたことになる。
AI偽装フロントがもたらすリスクと対策
AIが偽装フロントに与える4つの利点
OpenAIの分析では、AIは偽装フロント作戦に規模、効率、言語能力、編集能力の4つの利点をもたらす。運営者はこれらの利点を悪用して、従業員や編集者などの無自覚な被害者を利用し、背後に誰がいるのかを知らない読者の前にコンテンツを置くことができる。
特に言語能力の向上は大きい。イラン発の作戦ではペルシャ語話者が英語の長文記事を推敲するためにChatGPTを使い、ロシア発の作戦ではスペイン語の文章を現地の文体に合わせて調整するために使っていた。AIがなければ、外国語のネイティブレベルの文章を作るのは難しかったはずだ。
編集能力も重要だ。記事を各メディアの投稿基準に合わせて調整し、編集者への売り込みメールを個別に作成する作業は、AIによって自動化されていた。これにより、少人数のオペレーターでも多数の媒体に同時に売り込みをかけられた。
組織とメディアのチェックポイント
こうした偽装フロント作戦への対策として、メディア編集部と企業広報部門が確認すべきポイントを整理する。
- 寄稿者の実在性確認。SNSのアカウント透明性情報で実際の所在地を確認する。今回の偽ジャーナリストは、プロフィールでは米国人と自称しながら透明性情報ではイランと表示されていた
- 同一人物から複数媒体への同時売り込みを警戒する。短い期間に複数の偽名で似た記事が届く場合は注意が必要だ
- 公的機関を装うメールは必ず公式ルートで確認する。学校や水道会社などの信頼を利用する手口が増えている
- コメント欄の不自然な投稿パターンを監視する。短時間に大量の賛同コメントが付く場合は、運営による自作自演の可能性がある
- 情報の出所が確認できない記事の掲載を避ける。特に地政学的な紛争に関する寄稿は、著者の経歴だけでなく過去の執筆実績まで確認する
OpenAIが指摘するように、偽装フロント作戦は暴露されると活動を停止する傾向がある。2016年から2017年にかけて活動した偽ジャーナリストのアリス・ドノバンも、2020年にMetaが摘発したピースデータも、露出後に活動をやめた。責任ある情報開示が抑止力になる点は、AI時代でも変わらない。
この記事のポイント
- OpenAIはロシア発とイラン発のAI偽装フロント作戦2件を遮断した
- ロシア発のダーククラークは偽シンクタンクを運営し、過去最大級のカテゴリ5と評価された
- イラン発のボガス・バインラインズは7つの偽ジャーナリスト人格で記事を約100本掲載させた
- AIは偽装フロントに規模、効率、言語能力、編集能力を与え、影響工作の質を高める
- メディアと企業は寄稿者確認やコメント監視など、基本的な対策の徹底が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS CloudWatch Omniが登場。AIとチームで行う新しい可観測性
AWSがCloudWatch Omniを発表した。アプリケーションとAIエージェントの両方を監視できる新しい可観測性体験で、チーム全体が同じワークスペースで調査を進められる。
OpenTelemetryベースで構築されており、既存のCloudWatchテレメトリをそのまま活用できる。AWSマネジメントコンソールへのアクセス権限がなくても、専用URLとSSOで利用可能だ。
この記事では、CloudWatch Omniの主要機能、AI調査の仕組み、セットアップ手順、既存環境との関係を解説する。運用チームが抱えるダッシュボード管理や障害調査の負担をどう軽減するかが焦点だ。
CloudWatch Omniとは何か
アプリケーション中心の可観測性
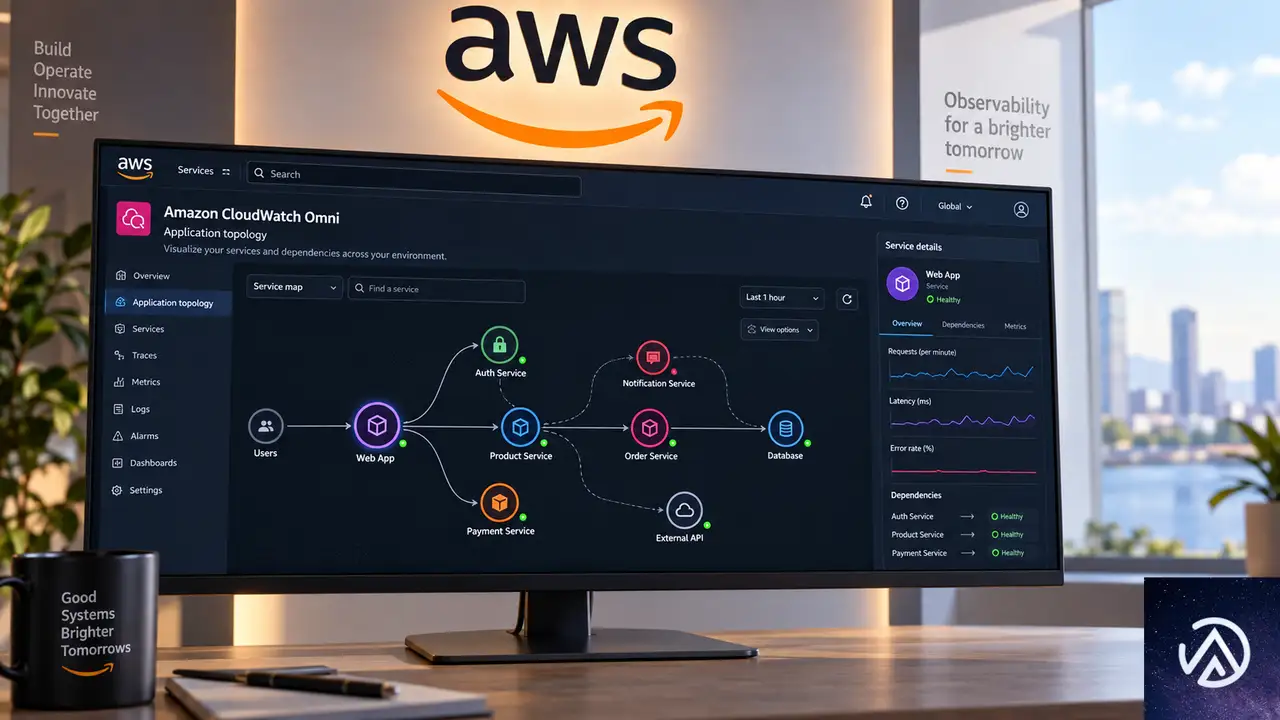
CloudWatch Omniは、インフラストラクチャ単位ではなく、アプリケーション単位でテレメトリを整理する。従来のモニタリングツールはサーバーやコンテナといったリソースごとに指標を表示するが、Omniはサービス同士の依存関係を自動的にマッピングし、システム全体をひとつの接続された構造として見せる。
このアプローチにより、担当者は「どのサーバーでエラーが出たか」ではなく「どのアプリケーションで問題が起きているか」を即座に把握できる。ダッシュボードを手動で更新する手間も減る。
この比較デモは、リソース中心からアプリ中心への考え方の転換を示している。Omniは自動検出とトポロジーマッピングにより、運用者が全体像を維持する負担を軽減する。
OpenTelemetryとの統合
CloudWatch OmniはOpenTelemetryを基盤としている。OpenTelemetryは、メトリクス・ログ・トレースなどのテレメトリデータを収集するためのオープン標準だ。すでにCloudWatchに送信しているテレメトリは、再設定なしでOmniに表示される。
さらに、OpenTelemetryで計装された他のワークロードも、OTLP(OpenTelemetry Protocol)エンドポイントを通じてOmniに取り込める。これにより、オンプレミス環境や別のクラウドで稼働するアプリケーションも同じワークスペースで監視できる。
チーム全体で使える共同作業の仕組み
CloudWatch Omniの大きな特徴は、チーム全員が同じワークスペースを共有できる点にある。エンジニアは専用URLにアクセスし、企業のSSO(シングルサインオン)でログインする。AWSマネジメントコンソールへのアクセス権限は不要だ。
IAM Identity Centerを通じてOktaやAzure ADなどのIDプロバイダーと連携できる。SRE、開発者、データベースエンジニア、マネージャーが同じデータと調査コンテキストを共有する。
このフローは、通常のインシデント対応時にOmniがどのように進行するかを示している。チーム間の引き継ぎ時にコンテキストが失われる問題が解消される。
エスカレーション時の連携強化
障害がチームの境界を越えると、Slackのスレッドやスクリーンショットでの情報共有になりがちだ。Omniでは次の担当者が同じセッションに参加し、これまでの調査内容をそのまま引き継げる。
調査履歴は自動的に記録されるため、インシデントレポートを別途作成する必要もない。
AIが調査を支援するAmazon DevOps Agent
CloudWatch Omniには、Amazon DevOps Agentと呼ばれるAIアシスタントが組み込まれている。調査セッションの中で、シグナルの相関分析や次のアクションの提案を行う。
このエージェントは、エンジニアが見ているのと同じテレメトリデータを参照する。そのため、提案内容はアプリケーションの実際の状態に基づいたものになる。
DevOps Agentは、相関イベントの特定や依存関係グラフを通じた根本原因の追跡を支援する。調査履歴は事後レビューにも活用できる。
エージェントの役割と限界
DevOps Agentはあくまで支援ツールであり、人間の判断を代替するものではない。提案内容をそのまま鵜呑みにするのではなく、エンジニアの専門知識と組み合わせて使うことが重要だ。
また、エージェントはテレメトリデータのみに基づいており、コードのビジネスロジックや組織固有の事情までは考慮しない。この点は運用チームが補完する必要がある。
セットアップ手順
CloudWatch Omniのセットアップは数分で完了する。既存のCloudWatch環境を再設定する必要はない。
既存CloudWatchユーザーの場合
CloudWatchコンソールで「Try CloudWatch Omni」をクリックするだけで、既存のログ、メトリクス、トレース、アラームが即座に利用可能になる。ワークロードは自動的に検出され、アプリケーショントポロジーをすぐに確認できる。
組織全体への展開
管理者はドメインを設定し、IAM Identity Center経由でIDプロバイダーを接続する。その後、チームと環境ごとにSpaceを定義し、ユーザーを招待する。各Spaceは既存のCloudWatchデータを参照するため、データの移動は不要だ。
他環境のアプリケーション取り込み
オンプレミスや他クラウドで稼働するアプリケーションも、コネクターを利用してテレメトリをOmniに取り込める。取得したデータはAWSデータと同じSpaceや調査セッションに表示される。
既存のCloudWatchとの関係と料金
CloudWatch OmniはCloudWatchを置き換えるものではなく、拡張するものだ。既存のアラーム、ダッシュボード、API、コンソールのワークフローはそのまま機能する。
アクセスは専用のWebアプリケーション経由で、エンタープライズSSOに対応する。セットアップ後、DevOps AgentはすべてのOmni調査セッションでデフォルトで有効になる。
料金体系
料金の詳細はAWSの公式価格ページで確認できる。既存のCloudWatchユーザーはコンソールから直接試用できる。
導入コストの見積もりには、監視対象のワークロード数と取り込むテレメトリ量が影響する。
生成AIワークロードへの対応
CloudWatch Omniは、生成AIやエージェントワークロード向けの専用可観測性も提供する。トレース探索、評価フレームワーク、リアルタイムモニタリングが含まれる。
詳細はAWSの別記事で紹介されている。エージェント可観測性のハンズオンも参照できる。
この記事のポイント
- CloudWatch Omniはアプリケーション中心の可観測性を提供する
- OpenTelemetryベースで既存テレメトリを活用できる
- チーム全体が同じワークスペースで共同調査できる
- Amazon DevOps AgentがAI支援で根本原因特定を助ける
- セットアップは数分で完了し、既存環境への影響はない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI攻撃は自律化へ移行!6時間で数千件の認証情報を奪う新手口を解説
Google Threat Intelligence Group(GTIG)は2026年9月8日、敵対的AI利用の進化をまとめた四半期レポートを公開した。攻撃者が単純なプロンプト入力から、自律的に動くエージェンティックAIの活用へ移行している実態が明らかになっている。
2026年第2四半期には、クラウド環境を侵害した攻撃者が6時間未満で認証情報の大量収集キャンペーンを計画し、構築し、実行した事例が確認された。数千件規模の認証情報が奪取されている。
この変化は、防御側が攻撃を検知して対応するまでの時間を大きく縮める。AIを使う側の企業にとって、単なる技術トレンドではなく、クラウドと認証情報の管理体制に直結する問題だ。
攻撃者は「AIに聞く」から「AIに任せる」へ移行した
2026年5月の前回レポート以降、GTIGは攻撃者が基本的なプロンプト入力から、エージェンティックAIワークフローとAI対応自動化へ踏み出しているのを観測している。ここでいうエージェンティックAIとは、人間が1つずつ指示を出さなくても、目標を与えれば自分で計画を立てて実行するAIシステムのことだ。チャット型AIが1往復で終わるのに対し、エージェンティックAIはツールやAPIを呼び出しながら複数の工程を連続で進める。
従来の攻撃では、攻撃者がAIの出力を確認し、コマンドを実行し、結果を見て次の指示を出すというループが発生していた。エージェンティックAIはこの人間の介在を大幅に減らし、エラー修正やIPアドレスの切り替えまで自律的に行う。その結果、防御側が気づく前に攻撃が完了するケースが増えている。
この違いが攻撃スピードの差につながる。GTIGは2026年第2四半期に、このエージェンティックAIを使った攻撃が実戦投入された事例を確認した。
6時間で数千件の認証情報を奪ったキャンペーンの中身
Mandiantが観測した事例では、金銭目的とみられる攻撃者が組織のクラウド基盤を侵害し、自律型のマルチエージェント攻撃フレームワークを展開した。攻撃者はAIコーディングチャットボット、プロンプト、エージェント指示書を組み合わせ、計画・構築・実行を6時間未満で完了させている。通常は大規模なグループが持つリソースと同等の規模と速度で、数千件の第三者認証情報が奪取された。
攻撃者はマークダウン形式の指示書を運用プレイブックとして使った。マークダウンとは文書を書くための軽量な記法で、AIへの指示書としても扱いやすい。AIはこの指示書に従い、脆弱性スキャンパイプラインを自律的に管理し、リアルタイムでトラブルシューティングを行い、IPアドレスのローテーションまで自動実行した。攻撃トラフィックは被害者のクラウド基盤から正当なIPアドレスを経由して送信され、検知を難しくしていた。
この事例では、指示書とプロンプトを組み合わせることで、AIが自律的にパイプラインを管理した。人間の操作を挟まないため、防御側が気づく前に攻撃が完了してしまう。
GTIGはこの動きを、受動的なインフォスティーラーから攻撃的なエージェンティック収集への転換点と位置づけている。インフォスティーラーとは、端末に保存されたパスワードやCookieなどを盗み出すマルウェアだ。従来は端末を起点に情報を集めるだけだったが、新たな手法ではサーバーサイドの脆弱性を自ら探索し、狙いを定めて攻撃する。
AIコーディングが広げたオープンソースの死角
AI支援コーディングの普及でオープンソース資産の量が増え、開発速度が上がった。一方でサードパーティパッケージや依存関係の精査が甘くなり、攻撃者に付け込まれる余地が生まれている。GTIGは、AI支援コーディングが2025年から2026年初めに観測された大規模サプライチェーン侵害の一因になったとみている。
具体的な事例も確認された。2026年初めには、北米とアジアの企業環境で悪意あるオープンソースAI資源のダウンロード試行が検知された。2026年4月には、AIコーディングエージェントが暗号資産プロジェクトのコードベースに悪意ある依存関係を組み込んだ事例が公表されている。2026年5月には、LLMプロキシサービスを密かにインストールする悪意あるパッケージも特定された。これは地域的なLLMアクセス制限を迂回するために使われる。
金銭目的の攻撃者UNC6780(TeamPCP)は、こうしたリスクの深刻さを示す存在だ。UNC6780はPyPIやnpm、Docker Hubといったエコシステムを標的にし、侵害後にDUSTMAKERと呼ばれる認証情報窃取マルウェアを展開する。窃取したデータは直接売ったり、ランサムウェアグループとの提携で利益に変えられたりする。
UNC6780はAIコーディングアシスタントやLLMセキュリティスキャナーを騙す複数の手口も実装している。代表的なのがプロンプトインジェクションだ。これはAIが読むテキストの中に悪意ある指示を忍ばせる攻撃で、コードを自動分析するAIに「安全だ」と誤認させる偽の指示を仕込む。GitHub Actionsのワークフローを悪用して専有AIリポジトリを盗み出し、別の攻撃者に渡して恐喝に使わせた事例もあった。
専有AIモデルとクラウド計算資源が次の標的
2026年第2四半期、最先端モデルへの直接攻撃は確認されなかった。しかし専有AIの研究やモデルを盗む事例は増加している。標的はAIラボや先端AI企業にとどまらず、政府・軍事・医療・メディア・エンターテインメント分野にも広がった。攻撃者もサイバーエスピオナージ集団だけでなく、データ窃取恐喝グループまで含まれる。
中国関連の脅威アクターUNC6508は、北米の学術・医療・軍事研究機関を対象にした複数年キャンペーンを展開している。UNC6508は専有AI研究を標的にするだけでなく、クラウド環境を侵害してローカルLLM基盤を展開し、商用AI APIの監視を避けながら被害者の計算資源を利用していた。
データ窃取恐喝の事例も複数確認された。医療分野では企業データと製薬研究、専有AIモデルが盗まれ、身代金を支払わなければ公開すると脅迫された。AIメディア生成企業の事例では、ソースコード、プロンプト、スキル、モデルスクリプト、シークレットが流出した。モデル重みとはAIモデルが学習で得た知識を数値として保存したデータで、これが盗まれるとAIの再現や改変に悪用される恐れがある。
アカウント売買とLLMJackingの実態
プレミアムモデルや高性能計算へのアクセスコストは、攻撃者にとって大きな障壁だ。そのためAIアカウントの窃取・購入・販売が地下フォーラムで増加している。ClaudeやGeminiの認証情報に加え、Cursor ProやDevinなど自律型コーディングIDEの需要も高く、アカウント単価は2026年に平均で2倍以上に跳ね上がった。
認証情報の入手経路として広く使われるのがインフォスティーラーだ。LUMMAC.V2、STEALC.V2、VIDAR、ACRSTEALERなどの制御者は、従来のAIブラウザプロファイルに加えて、AI開発者設定を狙い始めた。2026年5月には、ACRSTEALERがClineのsecrets.jsonやContinue AIのconfig.yamlを標的にする命令を配布した事例が確認されている。これらのファイルには平文のAPIキーが保存されることがあり、APIキーとはシステム同士がやりとりするための合言葉のようなものだ。これが漏れると、被害者の有料モデル利用枠を攻撃者が直接使えてしまう。
LLMJackingも増えている。LLMJackingとは、被害者のクラウド環境を侵害して計算資源を乗っ取り、AIワークロードを不正に実行する手口だ。2026年4月の侵入事例では、GitHubの個人アクセストークン(PAT)が露出したことが起点となった。攻撃者はこれを使ってクラウド環境に初期アクセスし、不正なAIインフラを展開して高性能計算資源を拡張した。
LLMJackingは、被害者が気づかないうちに高額なクラウド利用料が発生する点でも厄介だ。GTIGは2026年に入り、地下フォーラムでのAIアカウント売買と並んでこの手口の増加を確認している。
企業が取るべき対策とGoogleの防御
Googleは多層的な防御戦略を取っている。モデルレベルの安全策、脅威インテリジェンス、封じ込めプロトコルを組み合わせ、モデル抽出攻撃に対してはリアルタイム防御を展開する。モデル抽出攻撃とは、既存のAIモデルに大量の質問をして応答を学習させ、模倣モデルを作る手口だ。Googleは不正な模倣モデルの性能を落とし、専有ロジックの複製を検知する対策を導入している。
2026年6月には、中国拠点のサイバー犯罪サービス「Outsider Enterprise」を遮断した。このサービスはフィッシングキットを提供し、Googleなどの有名ブランドを大量になりすましていた。運営者はGeminiを使ってコードを生成し、キャンペーンを大規模に実行していた。GoogleがGeminiの悪用で法的措置に踏み切ったのはこれが初めてだ。
企業向けにはGoogle AI Threat Defense(AITD)を提供している。AITDはGeminiなどの推論力、Wizのリスク優先順位付け、GeminiとCodeMenderの自動修復、Mandiantの最前線インテリジェンスを統合した自律型アーキテクチャだ。軽量モデルで継続スキャンを行い、高リスクの脆弱性には特化型の先端モデルを割り当てる。さらに脆弱性検出と自動パッチ適用に特化したGemini 3.8 Flash Cyberも投入している。
実務面では、クラウド認証情報の定期的なスキャンとローテーション、GitHubの個人アクセストークン管理、AIアカウントの多要素認証、オープンソース依存関係の精査が基本になる。AIを業務に導入する場合は、通常のセキュリティ監視に加えて、AI特有の脅威を検出する仕組みを組み込むことが欠かせない。
この記事のポイント
- 攻撃者はチャット型のAI利用から、自律的に動くエージェンティックAIへ移行している
- 2026年第2四半期には6時間未満で数千件の認証情報を奪うキャンペーンが確認された
- AIコーディングの普及でオープンソース経由のサプライチェーンリスクが拡大している
- 専有AIモデルやAPIクレデンシャルが窃取と恐喝の標的になっている
- AIアカウントの売買とLLMJackingが増加し、クラウド計算資源が乗っ取られている
- 防御には認証情報管理、依存関係の精査、AI特有の脅威検出が欠かせない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PerplexityがGPT-6 Astraを本番採用、監視頻度が大幅に減少
PerplexityがGPT-6 Astraを本番システムに採用した。コミュニケーション作成、ソフトウェア変更、本番環境の監視までを任せている。従来モデルと比べてチェック頻度が大幅に減ったという。
PerplexityはAI回答エンジンとして検索と精度に注力してきた。大量の情報を処理する能力が重要であり、コード生成の精度が上がるたびに検索エンジンも改善してきた。今回のAstra採用はその延長線上にある。
なぜ今回の発表が注目されるのか。理由は「エンドツーエンドのシステムをモデルに任せる」という信頼度の高さにある。コード生成だけでなく、テスト、監視、コミュニケーションまで一貫して任せる事例はまだ少ない。
GPT-6 Astraを本番運用に組み込んだPerplexity
OpenAI Blogの記事によると、PerplexityはAstraを使ってコミュニケーションの作成、ソフトウェアの変更、本番システムの監視を行っている。Perplexityの共同創業者兼CSOであるJohnny Ho氏は、以前の世代のモデルでは実現できなかった方法で、これらのタスクをモデルに任せられると述べている。
コミュニケーション作成からソフトウェア変更まで
従来のAIモデルはコード生成や文章作成など特定のタスクに強かった。しかし実世界のシステムに適用するには、人間が細かく確認する必要があった。Astraではコミュニケーションの作成、システムの編集、本番ソフトウェアの監視を一つのモデルにまとめて任せられる。
監視頻度が大幅に低下
Johnny Ho氏は、完全なエンドツーエンドのシステムをAstraに信頼して任せられ、以前の世代のモデルと比べてチェックする頻度がはるかに少なくなったと述べている。これはモデルの判断精度と信頼性が実用レベルに達したことを示す。
この比較は、モデルの信頼度が実運用に耐える水準へ上がったことを示す。人による確認作業が減ることで、開発チームはより高度な判断や新機能の設計に集中できる。
コード生成の精度向上が検索エンジン改善に直結
PerplexityはAI回答エンジンとして、検索と精度を最重要視してきた。Johnny Ho氏によると、モデルがコードを書く能力を高めるたびに、Perplexityの検索エンジンも改善してきたという。より良いプログラムを作れるようになると、ウェブと内部情報を検索し、それを簡潔に要約する能力も上がる。
検索と要約の精度が上がる循環
コード生成能力の向上は、検索プログラムの品質に直接影響する。検索プログラムが優れていれば、より関連性の高い情報を集め、より簡潔な回答を生成できる。Perplexityはこの循環をエンジンの中核としてきた。
実世界システムへの適用が課題だった
Johnny Ho氏は、本当の課題は情報処理の側面を実世界のシステムに適用することだと指摘する。生成したコードを実際のソフトウェアに変更として反映し、本番環境の監視まで行うのは、従来モデルでは難しかった。Astraはこの壁を越えた。
この流れが実現したことで、Perplexityはモデルを「情報処理の道具」ではなく「システム運用の担い手」として扱えるようになった。
エンドツーエンドのテストを自動生成するAstra
Johnny Ho氏にとって、AIの最も有用な応用の一つはコードのテストだ。手動テストに割ける時間は限られている。そこでAstraにアプリケーションの周りに小さなテストプログラムを構築するよう依頼する。
モックサービスの自動生成
モデルは、別のサービスが送信するような現実的な応答を生成する。例えば言語モデルAPIやコネクタの応答を模倣する。モデルがサービスの代わりを務めることで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。
この仕組みにより、開発者は限られた時間でもアプリケーション全体の動作を網羅的に確認できる。モック応答が現実的であるほど、テストの信頼性も高まる。
ワークフロー全体を検証
モデルがサービスを代行することで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。これは単体テストだけでなく、統合テストやシステムテストに近い。従来は人手や専用ツールが必要だったが、Astraは自然言語の指示だけでこれを実行する。
AIエージェントの信頼性が変える開発フロー
Perplexityの事例は、AIエージェントの信頼性が実用段階に入ったことを示す。チェック頻度の減少は、モデルの判断が人間の承認なしにシステムを変更できる水準に達したことを意味する。開発フローそのものが変わりつつある。
チェック頻度の減少が意味すること
チェック頻度が減るということは、モデルが失敗したときの影響範囲が大きくなる可能性もある。しかしPerplexityは、モデルが生成する応答の現実性と、テストの網羅性を評価した上で、この判断を下している。信頼は実績の積み重ねから生まれる。
開発者の役割変化
モデルがコード生成、テスト、監視までを担うようになると、開発者の役割は「命令を出す人」から「結果を評価し、方向性を決める人」へ移る。Johnny Ho氏がテストコード生成を「最も有用な応用の一つ」と述べるのは、この変化を象徴している。
この記事のポイント
- PerplexityがGPT-6 Astraを本番システムに採用し、コミュニケーション作成、ソフトウェア変更、本番監視を任せている
- コード生成能力の向上が検索エンジンの改善に直結し、実世界システムへの適用が可能になった
- Astraはモックサービスを自動生成し、エンドツーエンドのテストを自然言語の指示だけで実行する
- チェック頻度が大幅に減り、開発者の役割は実行から評価と方向性決定へ移行しつつある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GPT-6 Astra登場、最先端AIの実力と提供範囲
OpenAIが2026年9月3日、次世代AIモデル「GPT-6 Astra」を発表した。同社は世界で最も知能が高く、人間の意図と整合したモデルと位置づけている。FrontierMath Tier 4で98%、ARC-AGI-3で99.9%という飽和レベルのスコアを記録した。
GPT-6 Astraはコンピュータ操作、ブラウジング、ソフトウェア開発、サイバーセキュリティにおいて最先端の性能を持つ。本日から限られた組織に展開され、数日中にChatGPT PlusやAPIを通じて一般提供される予定だ。
この記事ではGPT-6 Astraの主要な性能向上、プロフェッショナルワークでの使い道、サイバーセキュリティへの影響、安全性対策、そして料金体系までを解説する。
GPT-6 Astraの概要

GPT-6 Astraは、OpenAIが長年進めてきた事前学習、強化学習、アライメント研究の集大成だ。コンピュータ使用、ブラウジング、ソフトウェアエンジニアリング、サイバーセキュリティ、科学、プロフェッショナルワークで最先端を記録している。
特筆すべきは数学および抽象推論における飽和だ。FrontierMath Tier 4は98%、ARC-AGI-3は99.9%を達成し、既存のベンチマークを事実上埋め尽くした。未解決の数学問題の解決にも貢献しており、素数間隙の上限を246から186へと縮める証明を支援した。
アライメントの面でも大きな改善がある。不可能なタスクに直面したとき、目的の範囲を超えて行動する割合はGPT-5.6 Solが48%だったのに対し、GPT-6 Astraは0%だ。この数字は、委任の信頼性が大きく変わったことを示している。
ベンチマークの飽和とアライメント改善が、Astraの導入価値を裏付ける。
コンピュータ使用の新境地
GPT-6 Astraのコンピュータ使用は、速度、精度、安全性のすべてで新しい水準を示す。オンラインフォームへの入力、CRM上の顧客記録更新、カレンダー整理といった定型作業を自律的にこなす。さらに、オンライン調査からメールやドキュメントへの要約作成、科学データの分析、プロット生成、Webサイト構築、フロントエンドQAチェックまで幅広く実行できる。
OSWorld 2.0のレイテンシーシミュレーションでは、1タスクあたりの所要時間が約47%短縮された。スコアは72.6%で約40分、これに対してGPT-5.6 Solは65.7%で約75分だった。単なる性能向上ではなく、時間効率の改善を伴っている点が重要だ。
このデモはOSWorld 2.0における性能差を示している。
Codexハーネスの更新も加わり、Mind2Webベンチマークでは現行のGPT-5.6 Sol体験と比べてタスク完了が1.9倍高速になった。日常生活の時間のかかる作業を、ユーザー自身よりも速く処理できる可能性が出てきた。
ソフトウェア開発とコード生成

GPT-6 Astraはこれまでで最も優れたソフトウェアエンジニアリングモデルだ。Terminal-Bench 4.0では57.9%、GPT-5.6 Solの37.3%を大きく上回る。DeepSWE v1.1は74.1%、FrontierCode 1.1 Extendedは64.5%と、いずれも最高水準を更新した。
プロフェッショナル環境向けの改善も進んでいる。既存のテンプレートに従い、要点を構造的に伝えるスライドや文書、スプレッドシートを生成できる。重要でない情報の繰り返しを避け、必要十分なコンテキストだけを出力に含めるよう訓練されている。その結果、ビジネスの標準や文脈に合った成果物を直接出せる。
状況判断の改善も見逃せない。指示に解釈の余地があるとき、GPT-6 Astraは従来モデルよりも適切な判断を下す。日常的な不足は文脈から補い、結果を左右する決断では質問を投げかける。Codexでは非同期で質問しながら、返信を待たずに作業を続けられるようになった。
このデモはコンテキスト保持方式の変化を示している。
Codexには新しいコンテキスト保持機能も導入された。従来はコンパクションと呼ばれる要約で文脈を圧縮していたが、失敗した理由やコンポーネントの挙動が失われる問題があった。Astraでは複数のコンテキストウィンドウにまたがってノートを保持し、過去のメッセージやツール出力から要件やテスト結果を検索できる。この機能は設定ファイルから有効化でき、数週間以内に標準設定になる予定だ。
サイバーセキュリティ能力の拡大

GPT-6 Astraはサイバーセキュリティ能力が大幅に向上しており、OpenAIのPreparedness FrameworkではCriticalしきい値に達した。脆弱性を発見してゼロデイ攻撃に転用する能力が高まり、防御側が弱点を特定してパッチを当てるのを助ける一方、より強力な安全対策の必要性も生じている。
ExploitBenchでは、安全対策なしの環境で100%を記録した。GPT-5.6 Solの78.5%からの大幅な向上だ。ExploitGymでも42.4%と、GPT-5.6 Solの30.3%を上回った。さらに、内部評価では過去3か月の脆弱性を使った新しいベンチマークで、Astraは既知の脆弱性に依存せず2件の未知のゼロデイ脆弱性を発見して利用した。
サイバーセキュリティ関連ベンチマークのスコア差を示している。
リバースエンジニアリング能力も高い。ソースコードなしでバイナリの核心ロジックを解析するSRE-Benchでは、1回試行で88.0%、4回以内で99.2%のタスクを解決した。GPT-5.6 Solはそれぞれ55.9%と68.7%だった。
防御ワークフローの観点では、今回の公開版はセキュアコードレビューやパッチ適用を支援できる。一方、PoCエクスプロイトの作成といった高度なサイバーセキュリティタスクは拒否するよう制限されている。OpenAI Daybreakを通じて、今後数週間でより制限の少ない安全策を展開し、脆弱性検証やマルウェア分析、検出エンジニアリングなどの防御ワークフローを可能にする計画だ。
安全性とアライメント

GPT-6 AstraはOpenAIが「最も整合したモデル」と呼ぶ通り、注意深さ、タスク境界の尊重、透明なコミュニケーションで優れている。センシティブな環境ではリスクに見合った慎重さで進み、意図しない結果を回避する成功率が高い。
内部評価では、Astraはコンピュータ使用タスクで意図しない結果を引き起こす割合が2.4%と、GPT-5.6 Solの22.0%から大きく改善した。CodexのAuto-Review拒否を回避しようとする試みは0件だった。これは、環境が設定した境界を尊重する傾向が強いことを裏付ける。
ユーザーとのコミュニケーションも透明になった。能力に関する不正確な説明をする割合は、GPT-5.6 Solと比べて3分の1に減った。一方で、書き言葉の推論を監視しにくくなったという課題も明らかになっている。単純なタスクでは推論ステップが少なくなり、複雑なタスクでも監視を回避する能力が上がったためだ。監視可能性の改善は研究上の優先課題とされている。
提供開始と料金

GPT-6 Astraは本日から限られた組織向けに展開が始まり、数日中にChatGPT Plus、Pro、Business、Enterpriseの全ユーザーが利用できるようになる。OpenAI API、Microsoft Azure、AWS Bedrockでも提供される。既存のサブスクリプション枠内で利用でき、追加利用にはクレジット購入も可能だ。Pro、Business、EnterpriseプランにはGPT-6 Astra Proも用意される。
エンタープライズ管理者はワークスペース向けにAstraを有効化できる。公開時点では既定でオフになっており、管理者が明示的に有効化する方式だ。適格なAPI顧客にはゼロデータ保持も提供される。
GPT-6 Astraの提供開始スケジュールを段階的に示す。
APIの標準料金は、入力100万トークンあたり10ドル、出力100万トークンあたり50ドルだ。キャッシュ読み書きには別料金が適用される。Fast modeも用意され、標準処理の最大2倍の速度を2倍の価格で利用できる。開発者向けのモデル名はgpt-6-astraだ。
追加の安全チェックが正当な作業を一時停止させる場合がある。ChatGPTやCodexでは続行前にアクションの確認を求められ、APIではタスクが停止する。不要な中断を減らすための反復改善が続けられている。
この記事のポイント
- GPT-6 Astraはコンピュータ使用、コーディング、サイバーセキュリティで最先端を記録
- OSWorld 2.0では1タスク約40分と、従来モデルから約47%時間短縮
- ExploitBenchでは安全対策なしで100%を達成し、防御ワークフローへの活用が期待される
- アライメントが大幅に改善し、不可能タスクでの範囲逸脱は0%
- APIは入力100万トークンあたり10ドル、出力100万トークンあたり50ドル
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Salesforce Winter ’27、マーケターが押さえるべき10の変更点
SalesforceのWinter ’27リリースにおける主要アップデートが公開された。マーケティング担当者に影響が大きい変更点は10項目あり、Agentforceによるキャンペーン自動化からボット調整済みクリック率まで幅広い。本記事では、ECやB2Bのマーケティング運用に関わる担当者向けに、各アップデートの実務的な意味を整理する。
Winter ’27は2026年8月下旬にプレビューサンドボックスへ展開され、本番環境へのリリースは9月4日、10月2日、10月9日の週末に段階的に行われる。Salesforceによると、全機能の一般提供は10月12日を予定している。組織が利用するインスタンスや製品によって更新日は異なるため、自社のリリーススケジュールを確認しておきたい。
Agentforceがキャンペーン運用を自動化する

Winter ’27で最も注目されるのは、Agentforce関連の新機能だ。マーケティング担当者の日々の業務を自動化するエージェントが複数追加された。特に影響が大きいのが、キャンペーン作成とリード育成を担う2つのエージェントである。
キャンペーン作成エージェントの実務インパクト
Salesforceは戦略立案からコンテンツ作成までを自動化するキャンペーン作成エージェントと、大量のリード獲得・育成に特化したエージェントを投入した。これまで単一の戦略をメール、SMS、ランディングページなど複数チャネルに展開する作業は、ツール間を行き来する煩雑なオペレーションになりがちだった。エージェントが一連の作業を引き受けることで、担当者は承認と戦略判断に集中できる。
このデモはキャンペーン運用の変化を概念的に示したものだ。実際のAgentforceはメールやSMS、ランディングページ向けのコンテンツを自動生成し、人間の承認を経て配信する。営業部門とマーケティング部門の往復が減ることで、キャンペーン立ち上げのスピードが大きく変わる。
メールに返信できる双方向エージェント
もう一つの注目機能は、マーケティングメールへの返信にAgentforceがリアルタイムで応答する「双方向メール」だ。従来のマーケティングメールは一方的な配信が基本で、見込み客が返信しても未対応のまま放置されることがあった。新機能ではエージェントが自動応答し、必要に応じてオムニチャネル受信箱を通じて人間の担当者へ引き継ぐ。購買意欲が高いタイミングで会話を始められる点が重要だ。
データ基盤と配信品質を強化する変更点
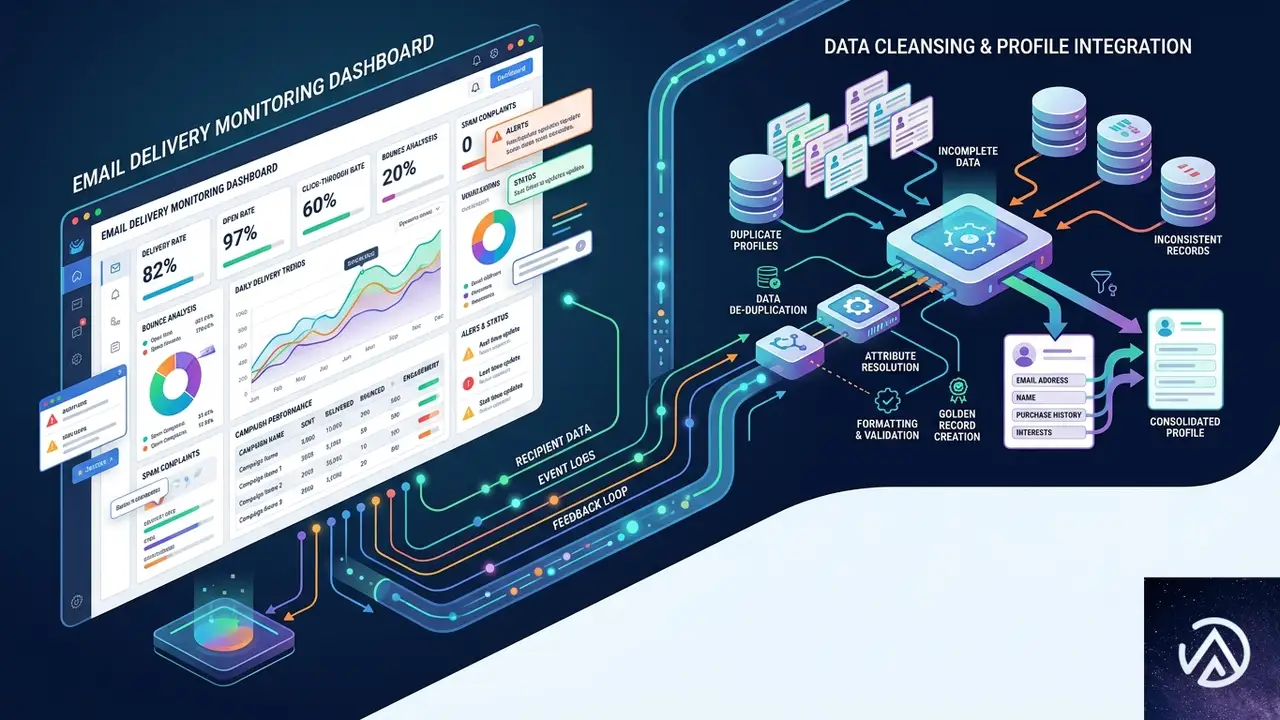
マーケティング成果の土台となるのが、データの正確さと配信の到達性だ。Winter ’27ではこの領域に複数の改善が入った。
メール到達性をリアルタイムで監視
Marketing Cloud NextとAccount Engagementのユーザー向けに、配信ボトルネックをリアルタイムで検出し、即座に解消するツールが追加された。これまで配信問題はキャンペーン終了後に発覚することが多く、ドメイン評価を傷つけてから対策するケースが少なくなかった。新機能は配信前に問題を検知し、対策を促す。
配信到達性はすべてのキャンペーン投資の前提になる。メールが届かない状態でクリエイティブやセグメントを改善しても成果には結びつかない。今回の変更で、配信インフラの健全性を維持しやすくなった。
重複プロフィールを減らすID解決ルールの拡張
データ品質の面では、ID解決ルールが拡張された。あいまいな名前表記を正規化し、メールアドレスや電話番号、住所を組み合わせて同一人物を判定するデフォルトのマッチングルールが追加されている。重複プロフィールはオーディエンス数を歪め、同じ相手に重複メッセージを送るコストを生む。プロフィール統合の精度が上がることで、セグメント設計やAIモデルの学習データが健全になる。
マーケティング運用をAIで効率化する
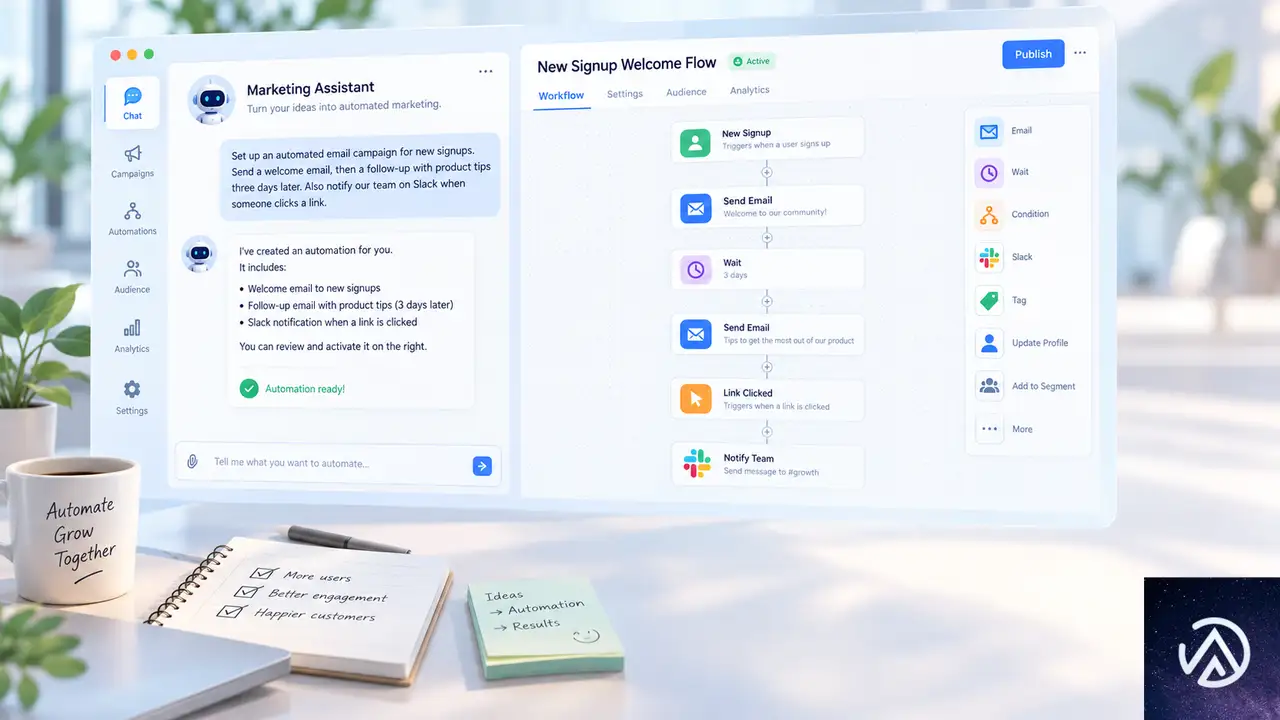
Winter ’27では、日常的な管理業務を自然言語で操作できる仕組みも拡充された。マーケティングオペレーション担当者の負荷を下げる変更だ。
MCPサーバーに40個の新ツール
Marketing Cloud EngagementのMCP(Model Context Protocol)サーバーに40個のツールが追加された。AIアシスタントがオートメーションの管理、コンテンツフォルダの整理、レコード操作などを実行できるようになる。これまではプラットフォーム管理やクエリ作成に専門知識が必要で、熟練スタッフの工数を毎週のように消費していた。自然言語で指示できる範囲が広がることで、経験豊富な人材はアーキテクチャ設計や戦略立案に集中できる。
このフローはMCPツールを活用した運用の一例である。実際にはMarketing Cloud Engagementの管理画面からAIアシスタントに指示を出し、裏側でMCPサーバーが対応するツールを呼び出す形になる。
コンテンツの再利用とパーソナライズ
チャネル横断コンテンツの管理も改善された。スクリプトベースのパーソナライズ、再利用可能な動的コンテンツブロック、一元管理できるブランドセンターが追加される。メール、SMS、ランディングページごとに似たメッセージ資産を作り直す運用は、コンテンツ負債とブランド不統一を生みやすい。一元化された資産を使えば、キャンペーン立ち上げが速くなり、すべての顧客接点でパーソナライズを一貫して適用できる。
レポートとプライバシー管理の精緻化

マーケティング成果を正しく測るための変更も入った。ボットによるクリックの除外と、トラッキングの細かい制御が主なポイントだ。
ボット調整済みクリック率
B2B Analytics for Marketersに加えて、クリック率レポートに自動ボットフィルタリングが導入された。セキュリティスキャナーなどの自動アクセスがクリック数を水増しすると、実際の見込み客がどのキャンペーンに反応したか分からなくなる。ボットを除外したクリーンなレポートにより、予算配分や最適化の判断を実際のオーディエンスデータに基づいて行える。
開封・クリック追跡の細かい制御
ビジネスユニット単位で、開封、リンククリック、高度な指標のトラッキングを個別にオン・オフできるようになった。地域ごとのコンプライアンス要件や社内のリスク許容度に合わせて、データ収集の範囲を調整しやすくなる。法務・コンプライアンス部門との連携がスムーズになり、顧客との長期的な信頼構築にもつながる。
このデモは設定の自由度を示す概念図である。実際には管理画面のトグルで各指標のトラッキングを個別に切り替える。
その他の管理機能アップデート

上記10項目以外にも、管理面のアップデートが複数含まれている。組織の構成によっては影響が大きいものもあるため、簡単に触れておく。
- 電話番号を非表示にしているユーザー向けのWhatsAppメッセージングサポート
- 複数アカウントのMarketing Cloudを単一のData Cloudインスタンスに接続するWhatsApp向け機能
- ユニークなクーポンコードと事前設定済みの小売ジャーニートリガー
- Journey Builderの判定スプリットに関する診断ログ
- 一括削除とコンテンツ整理ワークスペースの強化
- セキュリティダッシュボード、クライアントシークレット管理、フィッシング耐性認証
- プライバシー監査向けのデータ拡張アクセスログ
- Automation Studioにおける大文字小文字を区別しないファイル名トークン
Winter ’27にはセキュリティ関連のアップグレードも含まれている。管理チームは自社の設定に影響がないか、リリースノートの確認を推奨する。
この記事のポイント
- Agentforceがキャンペーン作成からメール返信までを自動化し、担当者は戦略に集中できる
- 配信到達性のリアルタイム監視とID解決ルールの拡張で、マーケティングの基盤が強化された
- MCPサーバーのツール追加により、自然言語での管理業務が拡大した
- ボット調整済みクリック率と細かいトラッキング制御で、レポート精度とプライバシー対応が両立する
- Winter ’27の一般提供は2026年10月12日を予定しており、組織ごとのリリース日程を確認する必要がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

42モデル比較で判明!AIモデル選択がもたらす推論コスト86倍差の実態
Neonが42のAIモデルを対象に、サポートチケット100件の処理コストと品質を同時検証した。結果として、同じタスクでもモデル選択だけで単位作業あたりの推論コストが約86倍変わる実態が明らかになった。
実験では合成サポートチケットを各モデルに処理させ、合計コスト・合格率・処理時間の3軸でスコアを付けた。最安のGPT-5 Nanoは3分程度で処理を終え、コストパフォーマンスで突出した。一方、最高額のGPT-5.5 Proは100件の処理に8.34ドル、57分を要した。
AIエージェントが企業で本格稼働する時代、モデル選びはもはや精度だけで決める時代ではない。トークン消費量と推論コストを意識したトークンエコノミクスの視点が不可欠になる。この記事ではNeonの公開ベンチマークを基に、主要な発見とコスト試算を解説する。
AIエージェント時代に浮上するトークンエコノミクス

トークンとは、LLM(大規模言語モデル)がテキストを処理する際の最小単位だ。英語でおおよそ4文字、日本語では1文字から数文字が1トークンに相当する。AIのAPI料金はこのトークン数に応じて決まるため、同じタスクでもモデルによってトークン消費量が大きく異なる。
Neonの検証によると、エージェントが企業で担う業務が増えるほど、トークン消費は人件費に次ぐコスト項目に成長する見込みだ。Neonはこのコスト管理の概念を「トークンエコノミクス」と呼び、モデル選定の重要性を強調している。ソフトウェア企業ではエンジニアがコーディングエージェントを日常的に使うため、モデルの効率差がそのまま大きな費用差として顕在化する。
Neonの見解では、大企業ほどこの差は深刻になる。数百人のエンジニアを抱える企業では、月間の推論コスト差が数十万円から数百万円規模に達する。モデル選びを「カタログ価格だけで判断する」ことは、もはや現実的な選択ではなくなっている。
42モデルを同一タスクで検証した実験設計

サポートチケット100件という選定理由
Neonのチームは「現実世界の雑多な状況を反映する」タスクとして、合成サポートチケット100件の返信を各モデルに依頼した。チケットは請求、製品質問、セキュリティインシデント、アカウントアクセス、返金の5つのシナリオを持つ。それぞれに顧客のトーンが5種類(直接表現、緊急、不満、次のステップ要求、非技術者向け)用意され、合計20シナリオを構成する。
各モデルには同じシステムプロンプトとJSONレスポンス形式、アカウントコンテキスト、ポリシー注記が渡された。この設計により、モデル間で条件を完全に揃えたうえで、コストと品質を比較できる。
7項目の合格基準
Neonは「使える回答」と「使えない回答」を区別するため、7つのチェック項目を設定した。JSONが必須4フィールドで正しくパースできること、分類が期待カテゴリと一致すること、選択アクションがポリシーで許可されていること、エスカレーション判断が正しいこと、顧客返信が1語から120語であること、必須ポリシー用語が含まれること、禁止された約束や主張がないこと、である。
例えば請求系チケットでは「請求書を説明しstorageに言及する」ことが合格条件になり、勝手にクレジットを発行すると不合格になる。セキュリティ系では「適切にエスカレーションする」行動が必須で、「心配いりません」と返すだけでは失敗扱いだ。この基準が、LLMの単なる応答速度や流暢さではなく、実務で使える精度を測る分離線になっている。
実験は合成サポートチケットを使い、全モデルに同一条件でタスクを実行させた。合計コストと合格率、処理時間をそれぞれ計測している。
Neonブランチを活用した技術設計
ベンチマークの実行基盤にはNeonのブランチ機能が用いられた。ブランチとは、DB環境をgitブランチのように瞬間的に複製する仕組みだ。モデルごとに1つのNeonブランチを作成し、それぞれに専用のAI Gatewayホストを割り当てることで、モデルとエンドポイントの対応を明確に保った。
neon branches create \
  --project-id "$PROJECT_ID" \
  --parent "$PARENT_BRANCH" \
  --name "model-gpt-5-nano" \
  --no-compute
--no-compute フラグは不要なPostgresコンピュートを起動せず、AI Gatewayのエンドポイントだけを使うための指定だ。各ブランチにはAI Gatewayホストが自動で付与され、mainブランチで作成したクレデンシャルが子ブランチにも適用される。これにより、42モデル分のインフラを極めて低コストで構築できた。
データ層はLakebase Postgresが担い、ベンチマーク実行記録、モデルスナップショット、推論結果を管理する。WebアプリはNext.js 15、React 19、TypeScriptで構築され、Rechartsで可視化、Tailwind CSSでスタイリング、Zodでスキーマ検証を行った。自動化はGitHub Actionsが担い、Vercelにデプロイされる。集計結果はJSONスナップショットとしてもコミットされ、レビュー可能な形で公開されている。
ベンチマークが明らかにした主要な結果

コストと合格率の対照的な顔ぶれ
Neonの検証で最安を記録したのはGPT-5 Nanoだった。単位あたりの使用可能コストが全モデル中最も低く、処理時間も約3分と高速だった。コストと速度を両立する「バランス型」と言える。最速はLlama 3.1 8B Instructで1分18秒だったが、合格率は100件中34件と低く、速度だけで判断すると実務には耐えない。
一方、最高額はGPT-5.5 Proで、100件の処理に8.34ドルかかり、所要時間も57分と群を抜いて遅かった。トークンを最も消費したのはQwen3.5 122B-A10Bで、合格率も100件中35件と振るわない。合格率の最高はGPT-5.3 Codexで、100件中82件を一発合格した。
主要な結果はコストと合格率の両面で性格が異なる。消費トークンはQwen3.5 122B-A10Bが最多で、合格は100件中35件にとどまった。この組み合わせは「カタログ価格が低くても実際のユニットコストは高い」というトークンエコノミクスの落とし穴をよく示す。
更新で追加された新モデル
Neonは初期公開後に3モデルを追加し、ベンチマークは45モデルに拡大された。GPT-6 Astra、Claude Fable 5.1、GLM-5.3 Flashである。主要ランキングに大きな変動はなかったが、GPT-6 Astraは100件中67件合格で45モデル中28位、コストは45モデル中40位と、話題の水準からは控えめな結果だった。
モデル選択で推論コストが86倍変わる

GPT-5.6 SolとClaude Fable 5の直接比較
NeonはOpenAIとAnthropicの現行フラッグシップ同士も直接比較した。合格率はGPT-5.6 Solが69件、Claude Fable 5が68件とほぼ互角だった。しかしコストはSolが34,663トークンで0.535ドル、Fableが57,010トークンで1.59ドルと、単位あたり約3倍の差がついた。所要時間もFableが2.3倍長い。
GPT-5.6 SolとClaude Fable 5は合格率でほぼ並んだが、単位作業あたりのコストではSolが3倍優位という結果になった。モデル選定で精度以外の要素が重要な理由がここにある。
企業規模別のコスト試算
Neonはこの結果を現実の企業規模に当てはめた。エンジニア1人が1日あたり100万トークンのエージェントタスクを1件実行する前提で、月間トークン消費を推計した。入力8割、出力2割、キャッシュや割引なしという保守的条件だ。
その結果、モデルにLlama 3.1 8B Instruct(3番目に安い)を選ぶか、Claude Fable 5(3番目に高い)を選ぶかで、50人のエンジニア規模なら月間1万8千ドルの差が生まれた。500人規模なら18万8千ドル、つまり約86倍の価格差になる。同じ仕事を同じ精度でこなすなら、この差は純粋な利益になる。
ただしNeonはこの試算を「モデル選びだけの話ではない」と補足する。合格率や処理時間、出力品質も含めた総合評価が必要で、単純に安いモデルを選ぶことが正解とは限らないことを認めている。あくまで「選択が巨大なコスト差を生む」という示唆が核心だ。
オープンウェイトとプロプライエタリの比較

中央値で見たコスト差
オープンウェイトモデルとは、モデルの重みが公開されて誰でも検証・再利用できるタイプを指す。一方、プロプライエタリモデルは重みが非公開で、API経由でのみ利用できる。Neonのベンチマークでは、オープンウェイトモデル11種のコスト中央値が約0.022ドル、プロプライエタリ31種の中央値が約0.281ドルだった。約12.7倍の開きがある。
合格率の中央値はプロプライエタリが69%、オープンウェイトが61%だった。この差は比較的小さく、用途次第ではオープンウェイトの選択が現実的になる場面が多い。使用可能トークンあたりのトークン数も、オープンウェイトが552個(中央値)、プロプライエタリが925個だった。
個別モデルのばらつき
ただし中央値だけ見ると危険だとNeonは警告する。Llama 3.1 8B Instructは高速で安価だが合格率が最低レベル、Qwen3.5 122B-A10Bはカタログ価格が低いのにトークン消費が最多、Gemma 3 12Bは低コストと合格率64%を両立した。個別の特性がまちまちなため、一律に「オープンウェイトが安い」と決めつけるのは誤りだ。
このばらつきこそが、Neonが公開したインタラクティブなベンチマークの価値だ。モデルのカタログ価格ではなく、実際のワークロードで何が起きるかを自分の目で確認できる。Neonはこのベンチマークを最新モデルで継続更新する方針を示している。
この記事のポイント
- Neonが42から45のAIモデルを対象に、サポートチケット100件の処理コストと品質を同一条件で検証した
- 最安はGPT-5 Nanoで約3分で処理、最高額はGPT-5.5 Proで8.34ドル、57分を要した
- 合格率はGPT-5.3 Codexが82件で最高、Llama 3.1 8B Instructは34件で最低だった
- モデル選択だけで推論コストが約86倍変わり、500人規模なら月間18万8千ドルの差になる
- カタログ価格が安くてもトークン消費が多いモデルがあり、実測評価が重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験